
اگر مجبور شوید در یکی از سرویسهای حیاتی خود تغییراتی ایجاد کنید، چقدر مطمئنید که این تغییر بخش دیگری از نرمافزار شما را خراب نمیکند ؟
و سختتر از آن، اگر برای مطمئن شدن مجبور باشید کل سیستم را دستی تست کنید، چه خواهید کرد ؟
اینجاست که موضوع Automated Tests (تستهای اتوماتیک) اهمیت پیدا میکنند.
تستهای اتوماتیک فقط ابزاری برای پیدا کردن باگ نیستند، بلکه در یک پروژه حرفهای بخش مهم ایمنسازی سیستم هستند. تستها به ما اجازه میدهند کد را Refactor کنیم، Dependencyها را تغییر دهیم، دیتابیس را بهینه کنیم یا حتی معماری یک سرویس را تغییر دهیم، بدون اینکه برای هر تغییر مجبور باشیم کل سیستم را از ابتدا بهصورت دستی بررسی و تست کنیم.
اما همه تستها یکسان نیستند!
تستها انواع مختلفی مانند Unit Test، Integration Test، Feature Test، Contract Test، Fuzz Test و End-to-End Test دارند که هرکدام مساله متفاوتی را حل میکنند. حتی تستی که در یک پروژه بسیار مفید است، ممکن است در پروژهای دیگر فقط هزینه نگهداری ایجاد کند.
به زبان ساده Automated Test برنامهای است که بخشی از نرمافزار را اجرا میکند، نتیجه واقعی را با نتیجه مورد انتظار مقایسه میکند و در صورت وجود اختلاف، Test را Fail میکند.
برای مثال فرض کنید یک سرویس داریم که قیمت نهایی سفارش را محاسبه میکند:
subtotal = 1,000,000 discount = 10% shipping = 50,000
اگر انتظار داریم قیمت نهایی برابر با ۹۵۰,۰۰۰ باشد، میتوانیم این رفتار را به یک تست تبدیل کنیم.
حالا هر بار که منطق محاسبه قیمت تغییر کند، تست میتواند بهصورت خودکار بررسی کند که رفتار مورد انتظار هنوز برقرار است یا نه.
تستهای اتوماتیک میتوانند برای Regression، مستندسازی رفتار سیستم و افزایش اطمینان هنگام تغییر کد بسیار مفید باشند. همچنین میتوان آنها را در فرآیندهای CI/CD اجرا کرد.
هدف این تستها این نیست که همه خطوط کد را تست کنیم؛ هدف این است که با هزینه منطقی، ریسکهای مهم سیستم را پوشش دهیم.
برای درک بهتر انواع تست، باید Scope آن را مشخص کنیم؛ یعنی تست چه بخش مشخصی از سیستم را درگیر میکند. در نتیجه خواهیم داشت:
۱. Unit Test
۲. Integration Test
۳. Feature / Functional Test
۴. Contract Test
۵. End-to-End Test
۶. Characterization Test
در کنار اینها، روشهایی وجود دارند که بیشتر روی نحوه تولید ورودی یا ارزیابی قدرت تستها تمرکز میکنند، مانند:
۷. Property-Based Test
۸. Fuzz Testing
۹. Mutation Testing
و در نهایت تستهایی که عملکرد و کیفیت سیستم را بررسی میکنند، مانند:
۱۰. Performance / Load / Stress Test
۱۱. Smoke Test
۱۲. Regression Test
این دستهبندیها کاملا مستقل از هم نیستند. برای مثال یک Feature Test میتواند همزمان Integration Test هم باشد، یا Fuzzing میتواند روی یک Unit Test هم اعمال شود.
بنابراین مهمتر از اسم تستها، این است که بدانیم تست دقیقا چه ریسکی را پوشش میدهد ؟
Unit Testing کوچکترین و سریعترین سطح تست است. در Unit Test معمولا یک Unit (رفتار) مشخص از کد را جدا میکنیم و بررسی میکنیم که با ورودی مشخص، رفتار مورد انتظار را دارد یا نه.
این Unit میتواند یک:
Function
Method
Class
یا یک بخش کوچک از Domain Logic
باشد. برای مثال:
calculateDiscount(price, customerType)
را در نظر بگیرید. میتوانیم تستهایی مانند این را داشته باشیم:
Customer = Regular
Price = 1,000,000
Expected Discount = 0
و:
Customer = Premium
Price = 1,000,000
Expected Discount = 100,000
در یونیت تست Dependencyهای خارجی مثل Database، File System یا Network را وارد نمیکنیم و آنها را با Test Doubleهایی مثل Mock، Stub یا Fake جایگزین میکنیم (تعریف هر کدام در را در ادامه مقاله خواهیم دید).
در تعریف Microsoft از Unit Test، آن را تست یک Component یا Method مشخص میداند و بخشهای زیرساختی (Infrastructure) مانند Database، File System و Network را خارج از محدوده معمول Unit Test قرار میدهد.
بسیار سریع
هزینه اجرای پایین
مناسب برای CI
پیدا کردن دقیقتر محل باگ
مناسب برای Refactoring
امکان داشتن تعداد زیادی تست
ممکن است همه اجزای سیستم بهصورت جداگانه درست باشند، اما در کنار هم درست کار نکنند.
برای نمونه:
OrderService
      ↓
Repository
      ↓
PostgreSQL
ممکن است منطق OrderService کاملا درست باشد، اما کوئری اشتباه باشد. در نتیجه Unit Test بهتنهایی این مشکل را پیدا نمیکند.
اینجاست که Integration Test وارد میشود.
Integration Testing بررسی میکند که دو یا چند بخش از برنامه شما، یا یک بخش با یک Dependency خارجی، واقعا میتوانند با هم کار کنند یا نه. مثالهای رایج در Backend عبارتاند از:
اپلیکیشن + PostgreSQL
اپلیکیشن + Redis
اپلیکیشن + Message Broker
اپلیکیشن + File System
اپلیکیشن + External API
Repository + Database
فرض کنید Repository شما چنین کاری انجام میدهد:
CreateOrder(order)
در Unit Test ممکن است Database را Mock کنید.
اما Integration Test میتواند:
۱. PostgreSQL را بالا بیاورد
۲. Application را به آن متصل کند
۳. Order را ذخیره کند
۴. دوباره آن را بخواند
۵. نتیجه را بررسی کند
در اینجا دیگر فقط منطق کد را تست نمیکنیم؛ بلکه نحوه تعامل واقعی اجزا را هم بررسی میکنیم. Integration Testها معمولا Scope بزرگتری نسبت به Unit Testها دارند و میتوانند Infrastructure را نیز درگیر کنند.
تست رفتار واقعیتر
پیدا کردن مشکلات Database
پیدا کردن مشکلات Serialization
بررسی کانفیگها
اطمینان بیشتر نسبت به Unit Test بهتنهایی
کندتر است.
Setup پیچیدهتری دارد.
(احتمالا) به Infrastructure نیاز دارد.
Debug کردن آن سختتر است.
Failure آن میتواند دلایل زیادی داشته باشد.
بنابراین منطقی نیست برای تمام Business Logicها، Integration Test بنویسیم.
در Feature Test یک قابلیت کاملتر از سیستم را از دید رفتار مورد انتظار، بررسی میکنیم. در Backend این تست میتواند از API شروع شود. برای نمونه Feature مربوط به ثبت سفارش:
POST /orders
ورودی:
{
  "productId": 123,
  "quantity": 2
}
و انتظار داریم در پاسخ:
201 Created

{
  "orderId": 456,
  "status": "created"
}
را دریافت کنیم. در اینجا دیگر مهم نیست داخل OrderService چند Class وجود دارد.
ما رفتار Feature را بررسی میکنیم: «آیا کاربر میتواند یک سفارش معتبر ایجاد کند ؟»
از این جهت Feature Test با Unit Test تفاوت دارد.
Unit Test میپرسد: آیا این Class یا Function درست کار میکند ؟
Feature Test میپرسد: آیا این قابلیت (Feature) مشخص سیستم طبق انتظار کار میکند ؟
به همین دلیل Feature Test در توسعه API بسیار کاربردی است.
این دو مفهوم ممکن است با هم همپوشانی داشته باشند. برای نمونه یک تست API ممکن است به ترتیب زیر انجام شود:
HTTP Request
   ↓
Controller
   ↓
Service
   ↓
Repository
   ↓
Database
در این حالت هم Feature را تست کردهایم و هم Integration بین اجزای مختلف را.
پس این دو نام الزاما دو لایه کاملا جدا نیستند. یک روش کاربردی این است که بپرسیم:
این تست دقیقا چه ریسکی را پوشش میدهد ؟
اگر هدف تست این است که یک Feature از دید API درست کار میکند، آن را Feature/Functional Test در نظر بگیرید. اگر هدف بررسی اتصال Repository به PostgreSQL است، آن را Integration Test بدانید.
فرض کنید سرویس Order به سرویس Payment درخواست میفرستد:
POST /payments
و انتظار دارد Response این شکل را داشته باشد:
{
  "paymentId": "123",
  "status": "paid"
}
حالا اگر تیم Payment بدون اطلاع شما Response را تغییر دهد:
{
  "id": "123",
  "state": "completed"
}
ممکن است Unit Testهای شما همچنان سبز باشند. اما Integration بین دو سرویس شکسته است.
اینجاست که Contract Testing ارزش پیدا میکند.
Contract Test بررسی میکند که دو طرف یک Integration روی یک قرارداد مشخص توافق داشته باشند. برای ارتباط HTTP، این قرارداد میتواند Request و Response مورد انتظار را مشخص کند؛ همین مفهوم برای Message-based Integration نیز قابل استفاده است.
یکی از رویکردهای شناختهشده، Consumer-Driven Contract Testing است. در این مدل Consumer نیازها و تعاملات مورد انتظار خود را در قالب Contract تعریف میکند و Provider آن Contract را Verify میکند.
Contract Test میتواند بدون اجرای کل سیستم، بخشی از ریسک Integration بین سرویسها را کاهش دهد.
این موضوع مخصوصا زمانی مفید است که:
تیمهای مختلف روی سرویسهای مختلف کار میکنند.
سرویسها مستقل Deploy میشوند.
APIها زیاد تغییر میکنند.
معماری Microservice دارید.
باید به این نکته توجه کرد که Contract Test جای انواع دیگر تستها را بهطور کامل نمیگیرد. در عوض، برای یک مشکل مشخص طراحی شده است:
آیا دو سرویس هنوز روی یک Interface مورد انتظار توافق دارند ؟
End-to-End Test یا E2E کل مسیر یک سناریو را از ابتدا تا انتها بررسی میکند.
برای مثال در یک فروشگاه آنلاین:
Login
 ↓
Add Product
 ↓
Create Order
 ↓
Payment
 ↓
Order Confirmation
تستهای E2E کل این مسیر را اجرا میکنند. در توسعه Backend حتی اگر UI نداشته باشیم، میتوانیم چنین سناریویی را از طریق API اجرا کنیم:
POST /login
POST /cart
POST /orders
POST /payments
GET /orders/{id}
و در نهایت بررسی کنیم:
Order Status = Paid
بیشترین شباهت را به رفتار واقعی سیستم دارد. به همین دلیل برای سناریوهای مهم Business میتواند اطمینان بالایی ایجاد کند.
هزینه آنها بالاست.
E2E Test معمولا:
کندتر است.
Failureهای پیچیدهتری دارد.
Debug کردن آن سختتر است.
به Environment گستردهتری وابسته است.
Maintenance بیشتری نیاز دارد.
به همین دلیل منطقی نیست تمام حالتهای سیستم را E2E تست کنیم.
اینجا به یکی از مهمترین تکنیکها برای پروژههای Legacy میرسیم. فرض کنید وارد پروژهای شدهاید که به مدت ۱۰ سال در Production است، اما وضعیت پروژه به این صورت است:
Test Coverage = پایین
Documentation = ناقص
Code = پیچیده
مدیر پروژه میگوید: فقط یک تغییر کوچک در این بخش بده.
مشکل چیست ؟ شما نمیدانید کدهای موجود واقعا چه کاری انجام میدهند.
ممکن است چیزی که از نظر شما باگ به نظر برسد، در واقع رفتاری باشد که سیستم سالها بر اساس آن کار کرده و Clientها به آن وابسته باشند.
اینجاست که Characterization Test کاربرد پیدا میکند.
Characterization Test قرار نیست بگوید:
این رفتار درست است.
بلکه میگوید:
این رفتار فعلی سیستم است.
این رویکرد برای کار با Legacy Code اهمیت زیادی دارد و در کنار تکنیکهایی مثل ایجاد Seam میتواند امکان تغییر تدریجی سیستمهای قدیمی را فراهم کند.
منظور از Seam نقطهای در کد است که امکان تغییر یا جایگزین کردن یک Dependency را برای تست یا تغییر رفتار فراهم میکند. مثلا اگر یک سرویس مستقیما به دیتابیس وابسته باشد، با قرار دادن یک Interface بین آنها، یک Seam ایجاد میکنیم تا در تست بتوانیم دیتابیس واقعی را با یک Mock یا Fake جایگزین کنیم.
فرض کنید یک تابع قدیمی داریم:
calculateShipping(order)
و هیچ تستی برای آن وجود ندارد. ما نمیدانیم برای این ورودی:
Order = 1,000,000
City = Tehran
Weight = 3kg
Customer = VIP
چه نتیجهای تولید میشود. بهجای اینکه حدس بزنیم نتیجه «باید» چه باشد، تابع را اجرا میکنیم و خروجی واقعی را مشاهده میکنیم. فرض کنید خروجی ۱۲۰,۰۰۰ است. حالا همین رفتار را به تست تبدیل میکنیم:
calculateShipping(order)
Expected = 120,000
از این لحظه به بعد، اگر Refactoring ما باعث شود نتیجه به ۱۵۰,۰۰۰ تغییر کند، تست Fail میشود. این یعنی قبل از اینکه کد را کاملا بفهمیم، رفتار موجود آن را ثبت کردهایم.
اختصاصا در زمانی که:
پروژه Legacy است.
Test Coverage پایین است.
Documentation ناقص است.
قرار است Refactoring بزرگی انجام شود.
قرار است یک سیستم قدیمی Migration شود.
نکته مهم: Characterization Test الزاما نمیگوید رفتار فعلی درست است. ممکن است بعدا بفهمیم رفتار ثبتشده یک باگ است. در آن مرحله میتوانیم:
Current Behavior
      ↓
Characterization Test
      ↓
Understanding
      ↓
Specification
      ↓
     Fix
      ↓
Normal Test
را طی کنیم. بنابراین Characterization Test بیشتر شبیه یک Safety Net برای تغییر سیستم ناشناخته است.
تا اینجا بیشتر تستها به این شکل بودند:
Input → Expected Output
برای نمونه:
Input: 10
Expected: 20
این تستها Example-Based هستند؛ یعنی خودمان ورودیها را مشخص میکنیم. اما گاهی میتوانیم بهجای بررسی Exampleهای مشخص، یک Property از سیستم را تعریف کنیم. فرض کنید چنین تابعی داریم:
sort(items)
بهجای اینکه فقط بنویسیم:
sort([3,1,2]) == [1,2,3]
میتوانیم بگوییم: خروجی باید مرتب باشد و تعداد عناصر آن با ورودی برابر بماند.
حالا یک Property-Based Testing Framework میتواند تعداد زیادی ورودی تولید کند و Property را روی آنها بررسی کند. کتابخانههایی مانند Hypothesis و fast-check برای چنین سناریوهایی طراحی شدهاند.
برای مثال:
[]
[1]
[3,1]
[10,5,8,2]
[random data...]
و برای همه آنها بررسی میکنیم:
isSorted(result) == true
length(result) == length(input)
وقتی:
تعداد حالتهای ورودی زیاد است.
پیدا کردن Edge Caseها دشوار است.
یک Invariant یا Property واضح دارید.
الگوریتم یا Domain Rule پیچیده است.
میخواهید Exampleهای بیشتری را با هزینه کمتر بررسی کنید.
برای نمونه در سیستمهای مالی میتوانیم چنین Propertyهایی داشته باشیم:
را حفظ کند Balance مجموع تراکنشها باید
یا در Serialization:
decode(encode(x)) == x
این نوع Propertyها میتوانند طیف بزرگی از Inputها را بررسی کنند.
تستهای Fuzz Testing یا Fuzzing تکنیکی در تستنویسی هستند که در آن برنامه را با ورودیهای غیرمنتظره، malformed، غیرعادی یا تولیدشده بهصورت خودکار اجرا میکنیم تا باگ، Crash، Vulnerability یا رفتار غیرمنتظره در سیستم پیدا کنیم. OWASP نیز Fuzzing را بهعنوان تکنیکی برای پیدا کردن باگها، آسیبپذیریها و رفتارهای غیرمنتظره از طریق ورودیهای غیرمنتظره یا خرابشده تشریح میکند.
فرض کنید API زیر را داریم:
POST /users
و انتظار داریم با این ورودیها درست کار کند:
{
  "name": "Ali",
  "age": 30,
  "email": "[email protected]"
}
در تست معمولی شاید این موارد را به عنوان ورودی ارسال کنیم:
age = 30
age = 0
age = -1
اما Fuzzing میتواند ورودیهای بسیار متنوعتری تولید کند. مانند:
age = -999999
age = 999999999
name = ""
name = بسیار طولانی
email = ""
email = malformed
غیرمعمول Unicode
ناقص JSON
بسیار بزرگ JSON
null
nested objects
unexpected arrays
هدف این نیست که ثابت کنیم خروجی دقیقا چه باید باشد؛ هدف این است که سیستم در برابر ورودیهای غیرمنتظره بهصورت امن و قابل پیشبینی رفتار کند.
این دو مفهوم به هم نزدیک هستند و در بعضی ابزارها حتی با هم ترکیب میشوند، اما بهتر است آنها را یکی ندانیم.
در Property-Based Testing سوال اصلی این است:
آیا یک Property مشخص برای تعداد زیادی Input برقرار است ؟
مثلا sort(list) باید برای هر List معتبر، همیشه یک List مرتبشده برگرداند.
در Fuzz Testing سوال این است:
اگر تعداد زیادی Input غیرمنتظره و یا malformed به سیستم بدهیم، آیا Crash، Security Issue یا رفتار غیرمنتظرهای رخ میدهد ؟
بهصورت ساده:
Property-Based Testing
        ↓
Generate Inputs
        ↓
Check Properties
در مقابل:
Fuzz Testing
        ↓
Generate Unexpected Inputs
        ↓
Look for Failures / Crashes / Vulnerabilities
البته مرز این دو کاملا ملموس نیست. بعضی ابزارهای Property-Based Testing از تکنیکهای Fuzzing استفاده میکنند و بعضی Fuzzerها نیز روی Inputهای ساختاریافته و Propertyهای مشخص کار میکنند. حتی مستندات Hypothesis نیز به ارتباط نزدیک میان این دو اشاره کرده است.
Fuzzing در توسعه Backend میتواند روی نقاطی مثل اینها بسیار خوب باشد:
API Input:

JSON
Query Parameters
Path Parameters
Headers
Parsers:

JSON Parser
XML Parser
CSV Parser
Custom Protocol
Authentication و Authorization: Token یا Header ,Session ورودیهای غیرمنتظره برای
File Upload:

Empty File
Huge File
Malformed File
Unexpected Format
Search و Filtering:

Very Long Strings
Special Characters
Unicode
Unexpected Combinations
Serialization / Deserialization: رفتار نادرست ،Exception هایی که ممکن است باعث Input برای پیدا کردن یا مصرف غیر عادی منابع شوند
مزایای آن شامل:
پیدا کردن Edge Caseهای غیرمنتظره
کشف Crashها
پیدا کردن رفتارهای ناشناخته
مناسب برای Inputهای پیچیده
قابلیت اجرای طولانیمدت در CI یا محیطهای مخصوص Fuzzing
و معایب آن شامل:
طراحی Fuzzer مناسب ممکن است زمانبر باشد.
همه Inputهای تصادفی ارزش یکسان ندارند.
تحلیل Failureها ممکن است سخت باشد.
برای هر Domain همیشه نمیتوان بهراحتی خروجی درست را مشخص کرد.
اجرای گسترده Fuzzing ممکن است منابع زیادی مصرف کند.
بنابراین Fuzzing معمولا جایگزین Unit Test یا Integration Test نیست؛ بلکه یک لایه مکمل برای پیدا کردن کلاس دیگری از مشکلات است.
اگر همه Testهای شما سبز (موفق) باشند، از کجا مطمئن شویم که خود Testها واقعا توانایی پیدا کردن باگ را دارند ؟
Mutation Testing برای پاسخ به همین سوال است.
در Mutation Testing، ابزار عمدا تغییرات کوچکی در کد اصلی برنامه ایجاد میکند تا ببیند تستها میتوانند این تغییرات را شناسایی کنند یا نه.مثلا:
if price > 100
را به:
if price >= 100
تغییر میدهد. یا:
+
را با:
-
جایگزین میکند. حالا Test Suite (مجموعه تستهایی که نوشتهایم) اجرا میشود.
اگر تستها Fail شوند:
Mutation = Killed
یعنی تستها توانستهاند تغییر را تشخیص دهند.
اگر تستها همچنان سبز باشند:
Mutation = Survived
این میتواند نشانه یک ضعف در Test Suite باشد.
بنابراین Mutation Testing بیشتر از اینکه یک نوع Test برای Production Code (کدهای اصلی برنامه) باشد، روشی برای ارزیابی قدرت Test Suite است.
گاهی سوال ما این است: آیا سیستم با ۱۰ هزار Request در ثانیه همچنان پایدار است ؟
اینجا وارد حوزه Performance Testing میشویم.
بررسی میکند سیستم در یک Load مشخص چه عملکردی دارد. برای مثال:
1,000 concurrent users
100 requests/sec
Response Time < 300ms
هدف Load Test بررسی رفتار سیستم تحت بار مورد انتظار است. Microsoft نیز Load Testing را برای بررسی توانایی سیستم در مدیریت Load مشخص، مانند تعداد کاربران همزمان و پاسخگویی سیستم به آنها، تعریف میکند.
Load را فراتر از ظرفیت مورد انتظار افزایش میدهیم تا ببینیم سیستم چگونه رفتار میکند:
100 req/s
200 req/s
500 req/s
1000 req/s
...
و بررسی میکنیم:
سیستم چه زمانی Degrade میشود ؟
آیا Crash میکند ؟
آیا Recovery دارد ؟
آیا Queue رشد میکند ؟
آیا Error Rate افزایش پیدا میکند ؟
این تستها برای Backendهای پرترافیک اهمیت زیادی دارند.
Smoke Test یک تست سریع و سطح بالا است که بررسی میکند سیستم به درستی اجرا میشود و قابلیتهای اصلی آن درست کار میکنند.
مثلا بعد از Deploy:
GET /health
یا:
POST /login
را اجرا کنیم. اگر همین مسیرهای پایه Fail شوند، احتمالا ادامه به اجرای تستهای پیچیدهتر، ارزشی ندارد.
Smoke Test معمولا کوتاه و سریع است و میتواند بعد از Deployment اجرا شود.
Regression Test یعنی اجرای دوباره تستهای قبلی بعد از تغییرات، برای اینکه مطمئن شویم قابلیتهای موجود همچنان درست کار میکنند. وقتی باگی پیدا میکنیم، میتوانیم یک تست بنویسیم که همان باگ را بازتولید کند.
مثلا باگ:
Order with quantity = 0
قبلا باعث ثبت سفارش میشده است.
بعد از Fix:
quantity = 0 → 400 Bad Request
یک تست برای این رفتار مینویسیم. از این به بعد اگر کسی با تغییر دیگری دوباره همین باگ را ایجاد کند، تست Fail خواهد شد.
تفاوت Regression Test با سایر انواع تستها این است که یک نوع تست مستقل بر اساس Scope نیست و تمرکزش بیشتر در هدف و زمان اجرای تست است. مثلا فرض کنید قبلا قابلیت CreateOrder را تست کردهایم و همهچیز درست بوده. حالا یک تغییر جدید در سیستم انجام میدهیم؛ برای نمونه منطق تخفیف را تغییر میدهیم. اگر دوباره تست CreateOrder را اجرا کنیم تا مطمئن شویم این تغییر جدید، رفتار قبلی را خراب نکرده است، این یک Regression Test محسوب میشود.
نکته مهم این است که یک تست میتواند همزمان چند ویژگی داشته باشد. مثلا یک Unit Test میتواند Regression Test هم باشد، اگر برای جلوگیری از برگشتن یک باگ قدیمی نگه داشته شده باشد.
یک روش ساده برای فکر کردن به تستهای یک پروژه، Test Pyramid است.
ایده اصلی این است که تستها را در چند سطح داشته باشیم:
Unit Test → تستهای کوچک و سریع Integration / Feature Test → تست چند بخش در کنار هم E2E Test → تست کل سیستم از ابتدا تا انتها
معمولا پیشنهاد میشود تعداد تستهای کوچک و سریع، بیشتر باشد و تستهای بزرگتر، کمتر باشند. به این دلیل که برای نمونه یک Unit Test ممکن است در چند میلیثانیه اجرا شود، اما یک E2E Test باید بخشهای مختلف سیستم را اجرا کند و معمولا زمان و هزینه بیشتری دارد.
اما این به این معنی نیست که مثلا ۷۰٪ تستهای پروژه حتما باید Unit Test باشند. مقدار مناسب هر نوع تست به خود پروژه و ریسکهای آن بستگی دارد.
پس به جای اینکه بگوییم: «چند درصد تستها باید Unit Test باشند ؟»
بهتر است بپرسیم: «برای تست کردن این بخش، سادهترین و سریعترین تستی که میتواند از درست بودن آن مطمئنمان کند چیست ؟»
به طور مثال اگر یک محاسبه ساده داریم، احتمالا یک Unit Test کافی است. اما اگر میخواهیم مطمئن شویم API، Database و چند سرویس با هم درست کار میکنند، باید سراغ Integration Test یا E2E Test برویم.
پس Test Pyramid یک قانون ثابت نیست؛ فقط یک راهنمای ساده برای انتخاب و متعادل کردن تستهاست.
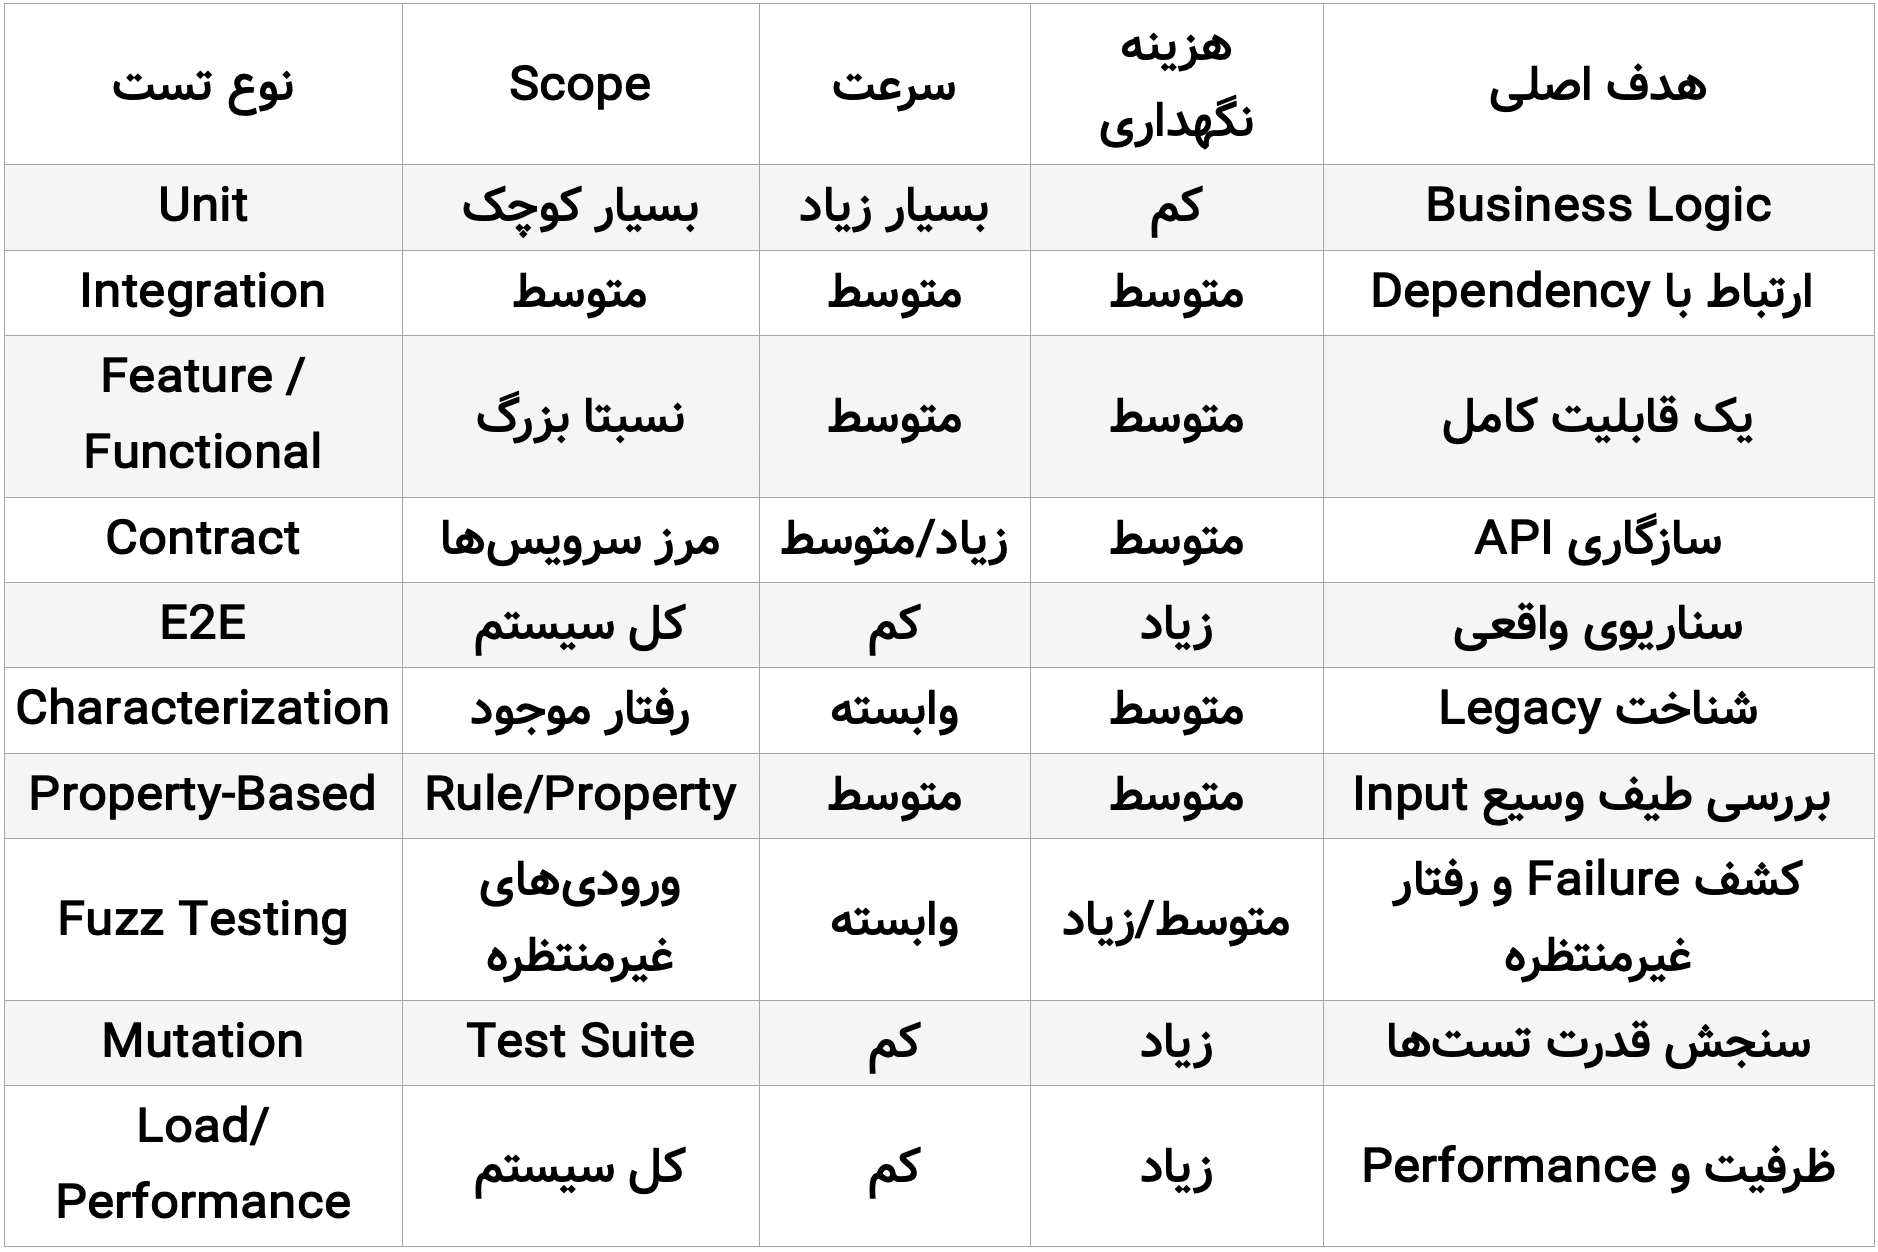
اما مهمترین تفاوت، سوال هر تست است:
Unit: آیا این منطق درست است ؟
Integration: آیا این دو جزء درست با هم کار میکنند ؟
Feature: آیا این قابلیت درست کار میکند ؟
Contract: آیا دو سرویس هنوز قرارداد مشترکشان را رعایت میکنند ؟
E2E: آیا کل سناریوی واقعی از ابتدا تا انتها درست کار میکند ؟
Characterization: سیستم فعلی واقعا چه رفتاری دارد ؟
Property-Based: آیا یک قانون برای طیف بزرگی از ورودیها برقرار است ؟
Fuzz Testing: آیا ورودیهای غیرمنتظره میتوانند سیستم را دچار رفتار مشکلدار کنند ؟
Mutation: آیا تستهای من واقعا میتوانند تغییرات اشتباه را تشخیص دهند ؟
Load Test: سیستم تحت بار چگونه رفتار میکند ؟
فرض کنید در یک فروشگاه آنلاین، کاربران گاهی میتوانند با مقدار منفی سفارش ثبت کنند:
{
  "productId": 10,
  "quantity": -2
}
و سیستم سفارش را ایجاد میکند.
ابتدا یک Test مینویسیم که رفتار مورد انتظار را مشخص کند:
quantity = -2

Expected: 400 Bad Request
Test ابتدا Fail میشود. این خوب است، چون نشان میدهد توانستهایم باگ را با یک تست قابل تکرار ثبت کنیم.
چنین مسیری را بررسی میکنیم:
API
 ↓
Controller
 ↓
OrderService
 ↓
Validator
مشخص میشود Validator مقدار quantity را بررسی نمیکند.
یک تست کوچک برای این Rule مینویسیم:
quantity = -2
Expected = Validation Error
حالا این تست Failure را دقیقتر در سطح Business Rule ثبت میکند.
بعد یک Feature Test مینویسیم:
POST /orders
quantity = -2

Expected: 400
این تست مطمئن میشود که Rule در مسیر واقعی API هم بهدرستی اعمال شده است.
Validator را اصلاح میکنیم:
quantity > 0
حالا:
Unit Tests ✓
Feature Tests ✓
Integration ✓
اگر همه سبز باشند، اطمینان بیشتری داریم که هم Rule و هم مسیر API درست شدهاند.
از این به بعد هر تغییر در Order Validation اگر دوباره اجازه quantity = -2 بدهد، تست Fail خواهد شد.
این دقیقا جایی است که Automated Testing ارزش واقعی خود را نشان میدهد:
تست فقط باگ فعلی را پیدا نکرد؛ هزینه ایجاد دوباره همان باگ را هم کاهش داد.
حالا یک قدم جلوتر برویم. ما باگ مربوط به quantity = -2 را با یک Test مشخص پیدا کردیم.
اما آیا فقط همین حالت مشکلدار است ؟
ممکن است این موارد هم رفتارهای جالبی ایجاد کنند:
quantity = -999999999
quantity = 0
quantity = 2147483647
quantity = null
quantity = "2"
quantity = []
quantity = {}
در Fuzz Test لازم نیست همه حالتهای ورودی را خودمان تعریف کنیم؛ ابزارها میتوانند ورودیهای مختلف و غیرمنتظره را تولید کنند تا بررسی کنیم که سیستم در همه آنها رفتار درستی داشته باشد.برای نمونه:
For every generated request:

System must not crash
AND
invalid quantity must not create an order
حالا اگر Fuzzer ورودی خاصی پیدا کند که باعث Exception یا رفتار غیرمنتظره شود، همان Input میتواند به یک Test ثابت و قابل تکرار تبدیل شود.
این یک Workflow بسیار کاربردی است:
Fuzzing
   ↓
Unexpected Input
   ↓
Bug Found
   ↓
Minimize / Reproduce
   ↓
Regression Test
   ↓
Permanent Safety Net
در Property-Based Testing، وقتی یک ورودی باعث شکست تست میشود، فریمورکهای Property-Based Testing میتوانند آن ورودی را آنقدر ساده کنند تا کوچکترین نمونهای که باعث خطا میشود پیدا شود. به این کار Shrinking میگویند.
نوشتن Test آسان است. نوشتن Test قابل نگهداری سختتر است.
چند اصل مهم:
۱. رفتار را تست کنید، نه Implementation را
به جای اینکه تست به این وابسته باشد که:
OrderService
 → Method A
 → Method B
 → Method C
بهتر است تا حد امکان رفتار قابل مشاهده را بررسی کند. چرا که اگر Implementation را Refactor کنیم، نباید تستها بیدلیل دچار مشکل شوند. Microsoft نیز در توصیههای مربوط به Unit Testing روی خوانایی و مقاومت تستها در برابر تغییرات غیرضروری تاکید میکند.
۲. Test باید خوانا باشد
اگر برای فهمیدن یک Test مجبور شویم Implementation مربوط به آن را بخوانیم، احتمالا Test بیش از حد پیچیده است. این نام:
CreateOrder_WithInvalidQuantity_ReturnsBadRequest
معمولا از نامی مثل:
ShouldCallValidatorThenRepositoryAnd...
معنادارتر است. نام Test باید سناریو را توضیح دهد.
۳. Edge Caseها را جدی بگیرید
تستی که فقط Happy Path را بررسی کند، کافی نیست. برای نمونه:
quantity = 1
را تست کردهایم. اما چه اتفاقی برای اینها میافتد ؟
quantity = 0
quantity = -1
quantity = MAX_INT
quantity = null
Edge Caseها همان جایی هستند که باگها پنهان میشوند.
این یکی از رایجترین سوءبرداشتها در Automated Testing است. فرض کنید:
Code Coverage = 100%
آیا یعنی سیستم بدون باگ است ؟
خیر. Coverage فقط نشان میدهد چه مقدار از کدهایمان هنگام اجرای Testها اجرا شدهاند؛ نه اینکه آیا رفتارهای مهم واقعا درست تست باشند. برای مثال ممکن است تست ما فقط این کار را انجام دهد:
function calculatePrice() {
    ...
}
و صرفا Function را اجرا کند، بدون اینکه نتیجه مهم آن را Assert کنیم. در این مثال Coverage بالا است، اما اطمینان از کارکرد مورد نظر پایین خواهد بود. بنابراین بهتر است Coverage را بهعنوان یک Signal ببینیم، نه هدف نهایی.
سوال مهمتر این است که آیا اصلیترین Business Ruleها و Failure Modeهای سیستم تست شدهاند یا نه.
Test Double یعنی استفاده از یک جایگزین موقت برای Dependency واقعی، که در زمان تست از آن استفاده میکنیم.
انواع رایج آن:
۱. Stub: برای برگرداندن یک داده مشخص:
getUser() → returns User(id=10)
Stub در واقع دادهایست که یک تست بدون آن نمیتواند درست اجرا شود.
۲. Mock: برای بررسی Invocationها. برای نمونه:
PaymentService.charge()
باید دقیقا یک بار فراخوانی شود، در غیر این صورت تست Fail میشود.
۳. Fake: یک پیادهسازی سادهتر اما واقعیتر از Dependency است. مثلا:
InMemoryUserRepository
بهجای Database واقعی.
۴. Spy: اطلاعاتی از رفتار واقعی Dependency در زمان اجرای تست ثبت میکند. برای مثال در زمان تست بگذار EmailService کار خودش را انجام دهد؛ بعد بررسی میکنیم که sendEmail چند بار و با چه پارامترهایی صدا زده شده است.
نکته مهم این است که این اصطلاحات در Frameworkها و منابع مختلف همیشه دقیقا یک معنی ندارند؛ بنابراین مهمتر از نام، این است که بدانیم Test Double چه نقشی در تستها دارد.
برای تصمیمگیری سریع میتوان از این قانون استفاده کرد:
اگر Business Logic سادهای دارید:
Unit Test:

Discount Calculation
Tax Calculation
Permission Rules
Validation Rules
Pricing
اگر با Database یا Infrastructure تعامل دارید:
Integration Test:

Repository
Database
Redis
Message Broker
File System
اگر یک قابلیت API را میخواهید بررسی کنید:
Feature / Functional Test:

POST /orders
POST /login
GET /profile
اگر دو Microservice با هم ارتباط دارند:
Contract Test:

Order Service ↔ Payment Service
اگر کل Business Flow مهم است:
E2E Test:

Login → Order → Payment → Confirmation
اگر با Legacy Code بدون Test روبهرو هستید:
Characterization Test:

Current Behavior → Capture → Refactor Safely
اگر Input Space بسیار بزرگ است:
Property-Based Test:

Generate Many Inputs
        ↓
Check Invariant
اگر ورودیهای غیرمنتظره یا malformed مهم هستند:
Fuzz Testing:

Generate Unexpected Inputs
        ↓
Execute System
        ↓
Find Crash / Failure / Unexpected Behavior
اگر میخواهید ظرفیت سیستم را بدانید:
Load / Performance Test:

100 → 500 → 1000 req/s
یک Backend حرفهای احتمالا چیزی شبیه این دارد:
tests/
│
├── unit/
│   ├── pricing/
│   ├── validation/
│   └── authorization/
│
├── integration/
│   ├── database/
│   ├── redis/
│   └── messaging/
│
├── feature/
│   ├── orders/
│   ├── users/
│   └── payments/
│
├── contract/
│   └── payment-service/
│
├── e2e/
│   └── checkout/
│
├── characterization/
│   └── legacy-order/
│
├── property/
│   └── pricing/
│
└── fuzz/
    ├── api/
    └── parsers/
این ساختار فقط یک مثال است و لازم نیست دقیقا به همین شکل پیادهسازی شود. مهم این است که تیم بداند هر Test برای چه ریسکی وجود دارد.
یکی از اشتباهات رایج این است که موفقیت Test Suite را با تعداد تستها بسنجیم. برای مثال ۵,۰۰۰ تست عدد بزرگی به نظر میرسد. اما اگر اجرای آن ۴۵ دقیقه طول بکشد، توسعهدهنده احتمالا دیگر آن را دائما اجرا نمیکند. در مقابل ۱,۵۰۰ تست که در ۳۰ ثانیه اجرا میشود، ممکن است ارزش بسیار بیشتری در چرخه توسعه داشته باشند. به همین دلیل یکی از مهمترین ویژگیهای Test Suite حرفهای Fast Feedback است.
هرچه بتوانیم Test مناسب را در پایینترین Scope ممکن بنویسیم، معمولا Feedback سریعتر و Failure قابلتشخیصتر خواهد بود.
یک ساختار بسیار رایج برای نوشتن Test، الگوی Arrange/Act/Assert است. این ساختار در تستهای کوچک و حتی تستهای سطح بالاتر نیز به خوانایی کمک میکند. یعنی:
Arrange: آمادهسازی دادهها و Dependencyها
Act: اجرای کدی که میخواهیم تست کنیم
Assert: بررسی نتیجه
برای مثال:
Arrange:

price = 1,000,000
customer = Premium
Act:

result = calculateDiscount(price, customer)
Assert:

result == 100,000
مهمترین چیزی که از این مقاله باید به خاطر بسپاریم این نیست که Unit Test خوب است یا E2E بد است. این نگاه بیش از حد ساده است. سوال درست این نیست که کدام نوع تست بهترین است، بلکه این است که برای یک ریسک مشخص، ارزانترین تستی که اطمینان کافی ایجاد میکند کدام است.
Automated Testing فقط نوشتن چند Unit Test برای افزایش Code Coverage نیست. یک Test Suite حرفهای باید مجموعهای متعادل از تستها باشد که هرکدام ریسک متفاوتی را پوشش میدهند.
Unit Test برای منطقهای کوچک و سریع، Integration Test برای ارتباط بین Unitها، Feature Test برای قابلیتهای سیستم، Contract Test برای مرز Microserviceها، E2E برای سناریوهای مهم واقعی و Characterization Test برای شناخت و ایمنسازی Legacy Code کاربرد دارند.
در کنار اینها، Property-Based Testing و Fuzz Testing میتوانند روشهای متفاوتی برای پیدا کردن Edge Caseها و رفتارهای غیرمنتظره ارایه کنند و Mutation Testing به ما کمک میکند بفهمیم Test Suite خودمان چقدر قدرت تشخیص تغییرات اشتباه را دارد.
تست خوب، تستی نیست که بیشترین حجم از کدها را اجرا میکند؛ بلکه تستی است که با کمترین هزینه، بیشترین ریسک مهم را پوشش دهد.
اگر این نگاه را وارد طراحی Test Suite کنیم، تستها از یک هزینه جانبی به بخشی از معماری و فرآیند توسعه تبدیل میشوند.
اگر فردا قرار باشد یک سرویس Legacy را که تقریبا هیچ Testی ندارد را Refactor کنید، اولین تستی که مینویسید چیست ؟ تجربه شما در پروژههای واقعی چطور است ؟

