
سلام! به دوره «دروازه ورود به یادگیری ماشین» خوش آمدید
در این دوره که شامل هفت فصل میشه ما میخوایم با مفاهیم ابتدایی یادگیری ماشین بیشتر آشنا بشیم. برای اینکه به یک دانشمند داده و مهندس یادگیری ماشین خوب تبدیل شویم باید در یک مسیر مشخص حرکت کنیم,گام اول برای اینکار آشنایی با مفاهیمی چون : هوش مصنوعی و یادگیری ماشین, مفاهیم پایه یادگیری ماشین,موقعیت های شغلی در رابطه با یادگیری ماشین و همچنین چالش های آن است. در گام دوم با ابزارها و مقدمات تحلیل داده آشنا میشویم که نکات مشترک بسیاری با علم داده دارد
پس از آشنایی با مفاهیم یادگیری ماشین و به دست آوردن اطلاعاتی برای تحلیل داده لازم است با تکنیکهای حل مسائل مختلف آشنا شویم.هوش مصنوعی حوزههای بسیاری را شامل میشود و همچنان در حال بزرگتر شدن است. امروزه هر برنامهای که هوشمندی داشته باشد یا به نوعی رفتار انسان را تقلید کند، به عنوان هوش مصنوعی پذیرفته میشود.
یادگیری ماشین بعد از هوش مصنوعی موضوعیت پیدا کرد و آن را میتوان زیر مجموعه هوش مصنوعی در نظر گرفت.
یادگیری ماشین ویژگیهایی دارد که آن را از دیگر روشهای هوش مصنوعی متمایز میکند.یکی از این ویژگی ها یادگیری با استفاده از داده و بدون استفاده از دستورات مستقیم است اما برخی از انواع هوش مصنوعی وجود دارد که در آن شاهد نوعی از هوشمندی هستیم که از داده استفاده نمیکند. ویژگی دیگر یادگیری ماشین، این است که با دیدن داده های جدید تغییر میکند یعنی همانند انسان با کسب تجربیات جدید رفتار خود را تغییر میدهد . قدرت الگوریتم های یادگیری ماشین باعث شده حوزه هایی مانند صنعت, دانشگاه, حوزه سلامت, اقتصاد وتجارت,کسب وکار وبسیاری دیگر از یادگیری ماشین برای پیشبرد اهداف خود استفاده کنند یکی از اولین کاربردهای یادگیری ماشین در تشخیص ایمیل های spam بود.امروزه ماشینهای بدون راننده در سطح شهرها در حال حرکت هستند، صاحبان محصول از سیستمهای پیشنهاد دهنده برای پیشنهاد محصول استفاده میکنند، اقتصاددانان برای پیشبینی روند بازار از آن استفاده میکنند و همچنان کاربردهای بیشتری در حال ایجاد شدن است. از دیگر عواملی که باعث جذاب شدن یادگیری ماشین شده توجه ویژه برنامه نویسان و شرکت های برنامه سازی به آن است .زبان پایتون و R از محبوب ترین زبان های یادگیری ماشین هستند و کتابخانه های بسیار قدرتمندی هم در این زبان ها برای رفع نیازها در این حوزه در حال گسترش است.
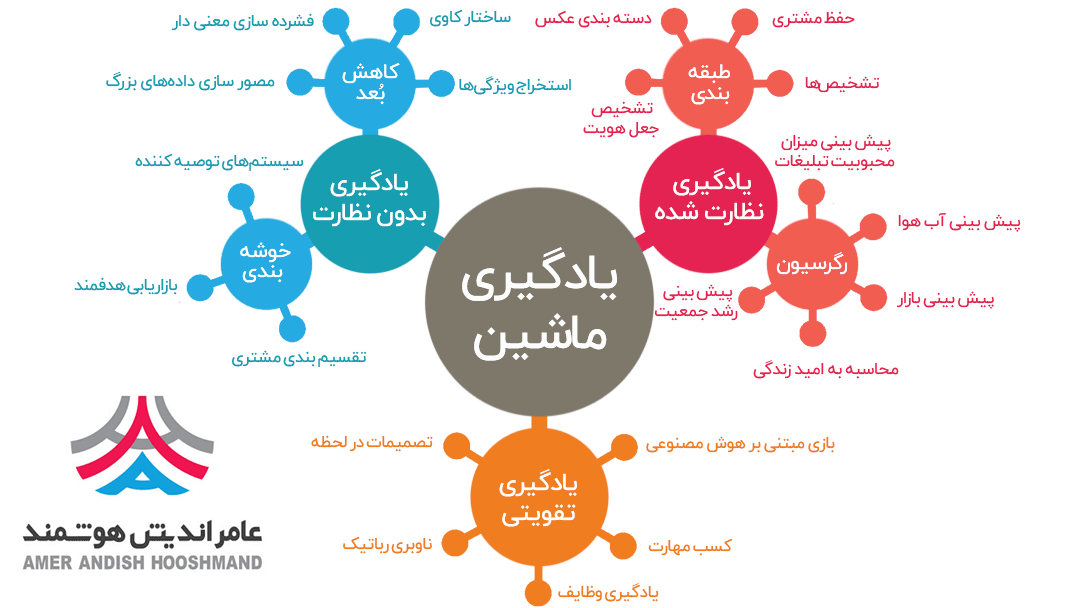
حال که با هوش مصنوعی آشنا شدیم میتوانیم به مفهوم یادگیری ماشین و نحوهی آموزش مدل و بررسی دقت آن بپردازیم.در این فصل دستهبندی کلی روشهای یادگیری ماشین را مورد بررسی قرار میدهیم یادگیری ماشین در اکثر کاربردهای فعلی، یک برنامه کامپیوتری است که به داده دسترسی پیدا میکند و از آن برای آموزش خود استفاده میکند.تعریف یادگیری ماشین از نظر آقای آرتور ساموئل : یادگیری ماشین زمینهای از تحقیقات است که به کامپیوترها توانایی یادگیری بدون برنامهنویسی صریح را میدهد. برنامه نویسی صریح یعنی مثلا یک برنامهای بنویسید که یک ورودی را بگیرد، مقدار آن را به توان ۲ برساند و در خروجی چاپ کند اگر بخواهید برنامه با الگوریتمهای یادگیری ماشین بنویسید، اعداد و مربع آنها را به الگوریتم میدهید و الگوریتم پس از بررسی ورودی و خروجی یاد میگیرد که کار درست، ضرب کردن ورودی در خودش است.
ویژگی اصلی یادگیری ماشین خود آموزشی یا( (Self- learning میباشد که به معنی استفاده از مدلسازی آماری و عدم استفاده از دستورات مستقیم (یا صریح) میباشد. به عقیده بسیاری در آموزش الگوریتم یادگیری ماشین، نیازی به دخالت انسان برای یادگیری نیست. به بیان دیگر، الگوریتم خود، نیازهای خود را تشخیص میدهد و خود را ارتقا میدهد. این نکته را در نظر بگیرید که تعریفی که برای یادگیری ماشین ارائه میشود ممکن است برای همه انواع آن درست نباشد. برای مثال، در یادگیری بانظارت، همانطور که از اسمش پیداست یادگیری با نظارت انسان صورت میگیرد.داده ها و انواع آن : دادهها عنصر محوری یادگیری ماشین هستند و ماشینها از دادهها یاد میگیرند، به این صورت که ما دادهها را به عنوان ورودی به الگوریتم میدهیم تا خروجی مورد نیازمان را دریافت کنیم. داده، در نتیجه مشاهدات و اندازهگیریها شکل میگیرد و توصیف این وضعیت مشاهده شده به شمار میآید:
- کلمات (زبان طبیعی) : استفاده از زبان طبیعی برای نگهداری و تبادل مفاهیم و اطلاعات است.برخی از کاربردهای این حوزه : تشخیص گفتار , دستهبندی نوشتارها یا نظرات , پاسخ دادن به سوالات
- تصویر : بینایی ماشین پیشرفت خیرهکنندهای را در سالهای اخیر داشته و در تکنولوژیهای روزمره به صورت گسترده استفاده میشود دادهای که در این قسمت با آن سر و کار داریم تصاویر ثبت شده توسط دوربینهای مختلف عکسبرداری یا فیلمبرداری هستند. از کابردهای بینایی ماشین میتوان به تشخیص پلاک خودروها توسط پلیس، تشخیص اثر انگشت یا چهره برای باز کردن قفل گوشی یا کامپیوتر، جستجو میان تصاویر بر اساس اجسام موجود در عکس، پردازش تصاویر ماهوارهای برای هواشناسی یا تشخیص وقایع زیستمحیطی و ماشینهای خودران و... اشاره کرد . - جداول : این نوع داده در بسیاری از سیستمهای نرمافزاری یافت میشود مثلا یک سیستم بانکی را در نظر بگیرید بانک میتواند با کمک یادگیری ماشین از روی این دادهها که در جدول نگه داری شده اند پیشبینی کند که درخواست وام یک مشتری را قبول یا رد کند.
- سری زمانی : ماشین میتواند با دیدن تغییرات ویژگی مشخصی از یک داده در طول زمان، الگوی تغییرات آن را یاد بگیرد و به مسائلی که برحسب زماناند، مثل پیشبینی مقدار آن ویژگی در یک زمان مشخص پاسخ دهد مثلا ارزش سهام در بازار بورس در یک بازه زمانی .حال در اینجا میخواهیم بدانیم ماشین چگونه یاد میگیرد؟ الگوریتمهای یادگیری ماشین، مثل انسان با کمک تجربه یاد میگیرند. داده همان تجربهای است که به عنوان ورودی به الگوریتم داده میشود. یادگیری نظارت شده، که یکی از انواع یادگیری ماشین است، بیشترین کاربرد را در امور یادگیری ماشین دارد.
نظر آقای تام میشل درمورد یادگیری ماشین : اگر کارایی برنامه در انجام تکلیف T که با سنجه P ارزیابی میشود، با تجربهE افزایش یابد، میگوییم که برنامه یاد گرفته است از تجربه Eبا توجه به تکلیف T و سنجه P استفاده کند. تکلیف T در واقع همان مسالهای است که ما انتظار داریم بتوانیم با یادگیری ماشین حل کنیم. هر مدل یادگیری ماشینی که طراحی کنیم، به هرحال به طور ۱۰۰ درصدی نتیجه درست و مناسبی را ارائه نمیدهد بنابراین به معیاری برای بررسی و اندازهگیری میزان دقت این الگوریتم نیاز داریم تا در صورت نامناسب بودن دقت آن، با تغییر پارامترهای الگوریتم بتوانیم به دقت بالاتری برسیم. به این معیار سنجهی P میگوییم.
به طور کلی رویکرد انجام یادگیری ماشین، دارای ۴ عنصر اساسی است:یک الگوریتم (مدل) برای تصمیمگیری,یک معیار برای امتیازدهی اینکه عملکرد مدل چقدر خوب بوده,بررسی خودکار کیفیت مدل بر اساس امتیاز,یک روش خودکار برای بهبود امتیاز بر اساس ایجاد تغییرات درمدل.
به طور کلی یادگیری ماشین به سه دسته کلی تقسیمبندی می شود : یادگیری بانظارت ,یادگیری بی نظارت ,یادگیری تقویتی.
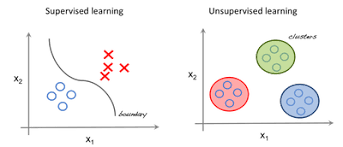
یادگیری بانظارت : در این نوع از یادگیری، نمونههایی که برای آموزش الگوریتم استفاده میشوند، دارای برچسب هستند. به این معنا که مدل یادگیری ماشین با استفاده از دادههایی که از قبل برچسب مشخصی دارند الگوهای اساسی را تا زمانی که به دقت رضایتبخشی برای ما برسد، پیدا میکند.این مدل به دو دسته طبقهبندی و رگرسیون تقسیم میشود. در طبقهبندی، هدف ما پیدا کردن برچسب یا دسته مناسب برای نمونههای بدون برچسب میباشد. برای این کار، ما مدل یادگیری ماشینی را با استفاده از نمونههای برچسبدار، آموزش میدهیم. بر اساس این یادگیری، مدل یادگیریماشین میتواند، مجموعهدادگان را به دستههای مختلف تقسیم کند. مثلا فیلتر کردن ایمیلها به دو دسته اسپم و غیر اسپم . در رگرسیون، هدف ما تخمین مقدار یک ویژگی (این بار مقداری پیوسته) برای یک نمونه میباشد. این الگوریتمها برای پیشبینی روند بازار، قیمت خانه و دیگر مثالها به کار میروند. هر دو دسته یاد میگیرند تا برچسب دادهها را پیشبینی کنند و تنها تفاوت میان این دو دسته، به نوع این برچسب بستگی دارد. در الگوریتمهای طبقهبندی برچسبی که میخواهیم پیشبینی کنیم به صورت متغیری گسسته میباشددر الگوریتمهای رگرسیونی، برخلاف طبقهبندی، برچسبی که میخواهیم پیشبینی کنیم به صورت متغیری پیوسته است.
یادگیری بدون نظارت : تفاوت این نوع از یادگیری با یادگیری نظارتشده، تنها در نبودن برچسبهااست. در این روش یادگیری، مدل به تنهایی و بدون کمک برچسبهایی که در روش نظارت شده دیدیم، باید الگوهای پنهان را پیدا کند.این الگوریتم ها به سه دسته خوشهبندی , کاهش ابعاد و استخراج قانون وابستگی تقسیم میشود. خوشهبندی به معنی دستهبندی اتوماتیک دادهها به خوشههای همگن است، به این صورت که دادههای هر خوشه، ویژگیهای یکسانی داشته باشند. اولین گام برای خوشهبندی دادهها، انتخاب کردن معیاری برای خوشهبندی است؛ به عبارت دیگر در این گام باید معیاری برای سنجش فاصله بین دادهها انتخاب کنیم. روش کاهش ابعاد یعنی کاهش دادن تعداد ویژگیهایی که از آنها برای آموزش مدل یادگیری ماشین خود استفاده میکنیم. به طور مثال، کاهش دادن تعداد ستونهای یک دیتاست جدولی، حالتی از کاهش ابعاد است.
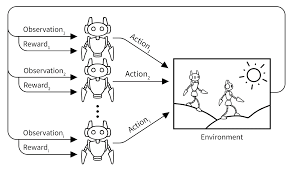
یادگیری تقویتی : یکی از روش های یادگیری ماشین است که با ذهنیت آزمون و خطا کار میکند. عامل هوشمند (agent) طبق حالت جاری (state) ، حرکتی (action) انجام میدهد و بر اساس آن حرکت بازخورد (reward) دریافت میکند؛ این بازخورد ممکن است مثبت یا منفی (پاداش یا تنبیه) باشد و عامل با این بازخورد خط مشی (policy) خود را تغییر میدهد. این روش از یادگیری نزدیکترین حالت به یادگیری انسان است. یادگیری تقویتی برخلاف یادگیری بانظارت و یادگیری بینظارت وابسته به داده نیست، بلکه به واسطه تعامل با محیط میآموزد . سنجش یادگیری : در بخشهای قبلی، با انواع روشهای یادگیری بانظارت آشنا شدیم، اما چطور مطمئن باشیم که مدل روی دادگان جدید نیز نتیجه مناسبی را ارائه میدهد؟ انتظار میرود برای بررسی دقت مدل آموزش داده شده ، باید پاسخهای آن را روی دادهی جدیدی تست کرد. به همین دلیل است که معمولا تعدادی از دادگان برای انجام ارزیابی کنار گذاشته میشوند و از باقی آنها برای آموزش مدل استفاده میشود. اصطلاحا به دادگانی که برای آموزش استفاده میشوند، دادگان آموزش (train) و به دادگانی که برای ارزیابی استفاده میشوند، دادگان آزمایش (test) میگوییم.
پایتون چیست؟یک زبان برنامه نویسی سطح بالا در توسعهی برنامههای وب و موبایل و همچنین در آنالیز داده و محاسبات علمی به کار رفته است. پایتون زبانی به نسبت آسان برای یادگیری است زیرا کدهای آن تمیز و قابل فهم است. پایتون زبانی دارای مفسر است. مفسر برنامه را در محیطی به نام kernel به bytecode ترجمه و آن را به صورت خط به خط اجرا میکند. لذا هر برنامهی پایتون در هر دستگاهی که مفسر پایتون نصب شده باشد، اجرا میشود.پایتون در صنعت خیلی پرکاربرد است به همین دلیل برای علم داده انتخاب شده است. پایتون در همهی حوزههای علم داده دارای کتابخانههای متعددی است که اکثر آنها توسط شرکتهای بزرگ یا دانشگاهها پشتیبانی و دائما بهروزرسانی میشوند.کدهای پایتون قابل فهم هستند.
پرکاربردترین کتابخانه های پایتون :1- نامپای (با استفاده از نامپای، پردازش و محاسبات روی آرایهها سریعتر انجام میشود).2-پانداس (با پانداس میتوان عملیات بسیار بیشتری بر روی داده انجام داد که کاربران پایگاه داده و صفحات گسترده با این عملیات بسیار آشنا هستند) .3-مت پلات لیب (ین کتابخانه بیشتر در ساخت نمودارهای ۲ بعدی کاربرد دارد و رابط کاربری آن بسیار شبیه به متلب است. بسیاری از نمودارهای پرکاربرد را میتوان با متپلاتلیب ایجاد کرد). 4- سایکت لرن (سایکتلرن حاوی ابزارهای متنوعی برای یادگیری ماشین و مدلسازی آماری است).
چرا از یادگیری ماشین استفاده میکنیم؟یادگیریماشین به شرکتها این امکان را میدهد که کارهایی که قبلاً تنها توسط انسانها امکانپذیر بود را با سرعت بالاتر و دقت بیشتر انجام دهند،لازم است بدانیم که استفاده از یادگیریماشین به دلایل زیر خیلی آسانتر و فراگیرتر شده است:افزایش بی حد و حصر دادهها, ذخیره سازی مقرون به صرفه دادهها, افزایش قدرت پردازندهها و کاهش هزینههای آنها. با وجود اینکه امروزه یادگیریماشین نقش به سزایی در زندگی بشر ایفا میکند، اما همچنان چالشهایی برای بهکارگیری این تکنیک حل مسئله وجود دارد؛
که راجع به این چالشها بیشتر خواهیم آموخت. تعداد ناکافی داده : اگر به تعداد کافی داده به الگوریتم تزریق نکنیم، نمیتوانیم انتظار عملکرد خوبی داشته باشیم. داده بی کیفیت : داده بیکیفیت پر است از مقادیر اشتباه و گم شده, این اشتباهات اجازه نمیدهند مدل به عملکرد بالا دست پیدا کند. ویژگی های نامناسب : همواره باید سعی در انتخاب ویژگیهایی داشته باشیم که مدل بتواند از آنها بیاموزد و از دل آنها الگوهایی برای پیشبینی آینده استخراج کند
.پس از آنکه توانستیم چالشهای مربوط به داده را مدیریت کنیم، سراغ الگوریتم و مدل میرویم. بیشبرازش (overfiting)، کمبرازش (under fiting) و زمان نمونهای از چالشهای مربوط به مدلها و الگوریتمهای هوشمصنوعی و یادگیریماشین هستند. مسئله Overfitting : هدف ما در یادگیریماشین این است که با مشاهده و یادگیری از دادههای گذشته، آینده را پیشبینی کنیم. وقتی دچار Overfitting میشویم در حقیقت مدل عمومیت خود را از دست داده است؛ به عبارت بهتر مدل نمیتواند آینده را به درستی پیشبینی کند. علت عدم توانایی در پیشبینی آینده این است که دادههای آموزش را زیاد از حد یاد گرفته است. مسئله Underfitting : این مشکل وقتی بهوجود میآید که مدل نتواند به خوبی از دادگان آموزش، یاد بگیرد.
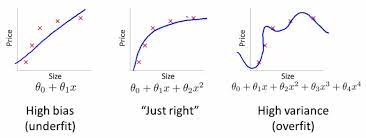
این مسئله میتواند به دلایل مختلفی پیش بیاید. داده نامناسب یکی از چندین دلیل کمبرازش است. مسئله زمان : زمان در یادگیریماشین از دو جهت اهمیت دارد؛ هم مدت زمانی که طول میکشد تا آموزش مدل تمام شود، هم زمانی که مدل برای پیشبینی نمونهها مصرف میکند. مدت زمانی که طول میکشد تا آموزش مدل تمام شود، طول مدت توسعه محصول را تحت تاثیر قرار میدهد و زمان مصرفی توسط مدل برای پیشبینی نمونهها زمانی است که کاربر نهایی تجربه میکند. دانشمند داده همواره سعی میکند هر دو زمان را کمینه کند. هدف از فصل یادگیری ماشین در عمل این است که شما با گامهایی که در یک پروژه یادگیری ماشین طی میشود آشنا شوید.
این گامها به شرح زیر هستند: دریافت و بررسی داده , آمادهسازی داده, انتخاب و آموزش مدل مناسب ,تست و ارزیابی ام! به دوره «دروازه ورود به یادگیری ماشین» خوش آمدید در این دوره که شامل هفت فصل میشه ما میخوایم با مفاهیم ابتدایی یادگیری ماشین بیشتر آشنا بشیم. برای اینکه به یک دانشمند داده و مهندس یادگیری ماشین خوب تبدیل شویم باید در یک مسیر مشخص حرکت کنیم,گام اول برای اینکار آشنایی با مفاهیمی چون : هوش مصنوعی و یادگیری ماشین, مفاهیم پایه یادگیری ماشین,موقعیت های شغلی در رابطه با یادگیری ماشین و همچنین چالش های آن است. در گام دوم با ابزارها و مقدمات تحلیل داده آشنا میشویم که نکات مشترک بسیاری با علم داده دارد پس از آشنایی با مفاهیم یاددگیری ماشین و به دست آوردن اطلاعاتی برای تحلیل داده لازم است با تکنیکهای حل مسائل مختلف آشنا شویم.هوش مصنوعی حوزههای بسیاری را شامل میشود و همچنان در حال بزرگتر شدن است. امروزه هر برنامهای که هوشمندی داشته باشد یا به نوعی رفتار انسان را تقلید کند، به عنوان هوش مصنوعی پذیرفته میشود.
یادگیری ماشین بعد از هوش مصنوعی موضوعیت پیدا کرد و آن را میتوان زیر مجموعه هوش مصنوعی در نظر گرفت.
یادگیری ماشین ویژگیهایی دارد که آن را از دیگر روشهای هوش مصنوعی متمایز میکند.یکی از این ویژگی ها یادگیری با استفاده از داده و بدون استفاده از دستورات مستقیم است اما برخی از انواع هوش مصنوعی وجود دارد که در آن شاهد نوعی از هوشمندی هستیم که از داده استفاده نمیکند. ویژگی دیگر یادگیری ماشین، این است که با دیدن داده های جدید تغییر میکند یعنی همانند انسان با کسب تجربیات جدید رفتار خود را تغییر میدهد . قدرت الگوریتم های یادگیری ماشین باعث شده حوزه هایی مانند صنعت, دانشگاه, حوزه سلامت, اقتصاد وتجارت,کسب وکار وبسیاری دیگر از یادگیری ماشین برای پیشبرد اهداف خود استفاده کنند یکی از اولین کاربردهای یادگیری ماشین در تشخیص ایمیل های spam بود.امروزه ماشینهای بدون راننده در سطح شهرها در حال حرکت هستند، صاحبان محصول از سیستمهای پیشنهاد دهنده برای پیشنهاد محصول استفاده میکنند، اقتصاددانان برای پیشبینی روند بازار از آن استفاده میکنند و همچنان کاربردهای بیشتری در حال ایجاد شدن است. از دیگر عواملی که باعث جذاب شدن یادگیری ماشین شده توجه ویژه برنامه نویسان و شرکت های برنامه سازی به آن است .زبان پایتون و R از محبوب ترین زبان های یادگیری ماشین هستند و کتابخانه های بسیار قدرتمندی هم در این زبان ها برای رفع نیازها در این حوزه در حال گسترش است.
حال که با هوش مصنوعی آشنا شدیم میتوانیم به مفهوم یادگیری ماشین و نحوهی آموزش مدل و بررسی دقت آن بپردازیم.در این فصل دستهبندی کلی روشهای یادگیری ماشین را مورد بررسی قرار میدهیم یادگیری ماشین در اکثر کاربردهای فعلی، یک برنامه کامپیوتری است که به داده دسترسی پیدا میکند و از آن برای آموزش خود استفاده میکند.تعریف یادگیری ماشین از نظر آقای آرتور ساموئل : یادگیری ماشین زمینهای از تحقیقات است که به کامپیوترها توانایی یادگیری بدون برنامهنویسی صریح را میدهد. برنامه نویسی صریح یعنی مثلا یک برنامهای بنویسید که یک ورودی را بگیرد، مقدار آن را به توان ۲ برساند و در خروجی چاپ کند اگر بخواهید برنامه با الگوریتمهای یادگیری ماشین بنویسید، اعداد و مربع آنها را به الگوریتم میدهید و الگوریتم پس از بررسی ورودی و خروجی یاد میگیرد که کار درست، ضرب کردن ورودی در خودش است. ویژگی اصلی یادگیری ماشین خود آموزشی یا( (Self- learning میباشد که به معنی استفاده از مدلسازی آماری و عدم استفاده از دستورات مستقیم (یا صریح) میباشد. به عقیده بسیاری در آموزش الگوریتم یادگیری ماشین، نیازی به دخالت انسان برای یادگیری نیست. به بیان دیگر، الگوریتم خود، نیازهای خود را تشخیص میدهد و خود را ارتقا میدهد. این نکته را در نظر بگیرید که تعریفی که برای یادگیری ماشین ارائه میشود ممکن است برای همه انواع آن درست نباشد. برای مثال، در یادگیری بانظارت، همانطور که از اسمش پیداست یادگیری با نظارت انسان صورت میگیرد.داده ها و انواع آن : دادهها عنصر محوری یادگیری ماشین هستند و ماشینها از دادهها یاد میگیرند، به این صورت که ما دادهها را به عنوان ورودی به الگوریتم میدهیم تا خروجی مورد نیازمان را دریافت کنیم. داده، در نتیجه مشاهدات و اندازهگیریها شکل میگیرد و توصیف این وضعیت مشاهده شده به شمار میآید: - کلمات (زبان طبیعی) : استفاده از زبان طبیعی برای نگهداری و تبادل مفاهیم و اطلاعات است.برخی از کاربردهای این حوزه : تشخیص گفتار , دستهبندی نوشتارها یا نظرات , پاسخ دادن به سوالات - تصویر : بینایی ماشین پیشرفت خیرهکنندهای را در سالهای اخیر داشته و در تکنولوژیهای روزمره به صورت گسترده استفاده میشود دادهای که در این قسمت با آن سر و کار داریم تصاویر ثبت شده توسط دوربینهای مختلف عکسبرداری یا فیلمبرداری هستند. از کابردهای بینایی ماشین میتوان به تشخیص پلاک خودروها توسط پلیس، تشخیص اثر انگشت یا چهره برای باز کردن قفل گوشی یا کامپیوتر، جستجو میان تصاویر بر اساس اجسام موجود در عکس، پردازش تصاویر ماهوارهای برای هواشناسی یا تشخیص وقایع زیستمحیطی و ماشینهای خودران و... اشاره کرد . - جداول : این نوع داده در بسیاری از سیستمهای نرمافزاری یافت میشود مثلا یک سیستم بانکی را در نظر بگیرید بانک میتواند با کمک یادگیری ماشین از روی این دادهها که در جدول نگه داری شده اند پیشبینی کند که درخواست وام یک مشتری را قبول یا رد کند.- سری زمانی : ماشین میتواند با دیدن تغییرات ویژگی مشخصی از یک داده در طول زمان، الگوی تغییرات آن را یاد بگیرد و به مسائلی که برحسب زماناند، مثل پیشبینی مقدار آن ویژگی در یک زمان مشخص پاسخ دهد مثلا ارزش سهام در بازار بورس در یک بازه زمانی .حال در اینجا میخواهیم بدانیم ماشین چگونه یاد میگیرد؟ الگوریتمهای یادگیری ماشین، مثل انسان با کمک تجربه یاد میگیرند. داده همان تجربهای است که به عنوان ورودی به الگوریتم داده میشود. یادگیری نظارت شده، که یکی از انواع یادگیری ماشین است، بیشترین کاربرد را در امور یادگیری ماشین دارد. نظر آقای تام میشل درمورد یادگیری ماشین : اگر کارایی برنامه در انجام تکلیف T که با سنجه P ارزیابی میشود، با تجربهE افزایش یابد، میگوییم که برنامه یاد گرفته است از تجربه Eبا توجه به تکلیف T و سنجه P استفاده کند. تکلیف T در واقع همان مسالهای است که ما انتظار داریم بتوانیم با یادگیری ماشین حل کنیم. هر مدل یادگیری ماشینی که طراحی کنیم، به هرحال به طور ۱۰۰ درصدی نتیجه درست و مناسبی را ارائه نمیدهد بنابراین به معیاری برای بررسی و اندازهگیری میزان دقت این الگوریتم نیاز داریم تا در صورت نامناسب بودن دقت آن، با تغییر پارامترهای الگوریتم بتوانیم به دقت بالاتری برسیم. به این معیار سنجهی P میگوییم. به طور کلی رویکرد انجام یادگیری ماشین، دارای ۴ عنصر اساسی است:یک الگوریتم (مدل) برای تصمیمگیری,یک معیار برای امتیازدهی اینکه عملکرد مدل چقدر خوب بوده,بررسی خودکار کیفیت مدل بر اساس امتیاز,یک روش خودکار برای بهبود امتیاز بر اساس ایجاد تغییرات درمدل. به طور کلی یادگیری ماشین به سه دسته کلی تقسیمبندی می شود : یادگیری بانظارت ,یادگیری بی نظارت ,یادگیری تقویتی.
یادگیری بانظارت : در این نوع از یادگیری، نمونههایی که برای آموزش الگوریتم استفاده میشوند، دارای برچسب هستند. به این معنا که مدل یادگیری ماشین با استفاده از دادههایی که از قبل برچسب مشخصی دارند الگوهای اساسی را تا زمانی که به دقت رضایتبخشی برای ما برسد، پیدا میکند.این مدل به دو دسته طبقهبندی و رگرسیون تقسیم میشود. در طبقهبندی، هدف ما پیدا کردن برچسب یا دسته مناسب برای نمونههای بدون برچسب میباشد. برای این کار، ما مدل یادگیری ماشینی را با استفاده از نمونههای برچسبدار، آموزش میدهیم. بر اساس این یادگیری، مدل یادگیریماشین میتواند، مجموعهدادگان را به دستههای مختلف تقسیم کند. مثلا فیلتر کردن ایمیلها به دو دسته اسپم و غیر اسپم . در رگرسیون، هدف ما تخمین مقدار یک ویژگی (این بار مقداری پیوسته) برای یک نمونه میباشد. این الگوریتمها برای پیشبینی روند بازار، قیمت خانه و دیگر مثالها به کار میروند. هر دو دسته یاد میگیرند تا برچسب دادهها را پیشبینی کنند و تنها تفاوت میان این دو دسته، به نوع این برچسب بستگی دارد. در الگوریتمهای طبقهبندی برچسبی که میخواهیم پیشبینی کنیم به صورت متغیری گسسته میباشددر الگوریتمهای رگرسیونی، برخلاف طبقهبندی، برچسبی که میخواهیم پیشبینی کنیم به صورت متغیری پیوسته است. یادگیری بدون نظارت : تفاوت این نوع از یادگیری با یادگیری نظارتشده، تنها در نبودن برچسبهااست. در این روش یادگیری، مدل به تنهایی و بدون کمک برچسبهایی که در روش نظارت شده دیدیم، باید الگوهای پنهان را پیدا کند.این الگوریتم ها به سه دسته خوشهبندی , کاهش ابعاد و استخراج قانون وابستگی تقسیم میشود. خوشهبندی به معنی دستهبندی اتوماتیک دادهها به خوشههای همگن است، به این صورت که دادههای هر خوشه، ویژگیهای یکسانی داشته باشند. اولین گام برای خوشهبندی دادهها، انتخاب کردن معیاری برای خوشهبندی است؛ به عبارت دیگر در این گام باید معیاری برای سنجش فاصله بین دادهها انتخاب کنیم. روش کاهش ابعاد یعنی کاهش دادن تعداد ویژگیهایی که از آنها برای آموزش مدل یادگیری ماشین خود استفاده میکنیم. به طور مثال، کاهش دادن تعداد ستونهای یک دیتاست جدولی، حالتی از کاهش ابعاد است. یادگیری تقویتی : یکی از روش های یادگیری ماشین است که با ذهنیت آزمون و خطا کار میکند. عامل هوشمند (agent) طبق حالت جاری (state) ، حرکتی (action) انجام میدهد و بر اساس آن حرکت بازخورد (reward) دریافت میکند؛ این بازخورد ممکن است مثبت یا منفی (پاداش یا تنبیه) باشد و عامل با این بازخورد خط مشی (policy) خود را تغییر میدهد. ین روش از یادگیری نزدیکترین حالت به یادگیری انسان است. یادگیری تقویتی برخلاف یادگیری بانظارت و یادگیری بینظارت وابسته به داده نیست، بلکه به واسطه تعامل با محیط میآموزد . سنجش یادگیری : در بخشهای قبلی، با انواع روشهای یادگیری بانظارت آشنا شدیم، اما چطور مطمئن باشیم که مدل روی دادگان جدید نیز نتیجه مناسبی را ارائه میدهد؟ انتظار میرود برای بررسی دقت مدل آموزش داده شده ، باید پاسخهای آن را روی دادهی جدیدی تست کرد. به همین دلیل است که معمولا تعدادی از دادگان برای انجام ارزیابی کنار گذاشته میشوند و از باقی آنها برای آموزش مدل استفاده میشود. اصطلاحا به دادگانی که برای آموزش استفاده میشوند، دادگان آموزش (train) و به دادگانی که برای ارزیابی استفاده میشوند، دادگان آزمایش (test) میگوییم..پایتون چیست؟یک زبان برنامه نویسی سطح بالا در توسعهی برنامههای وب و موبایل و همچنین در آنالیز داده و محاسبات علمی به کار رفته است. پایتون زبانی به نسبت آسان برای یادگیری است زیرا کدهای آن تمیز و قابل فهم است. پایتون زبانی دارای مفسر است. مفسر برنامه را در محیطی به نام kernel به bytecode ترجمه و آن را به صورت خط به خط اجرا میکند. لذا هر برنامهی پایتون در هر دستگاهی که مفسر پایتون نصب شده باشد، اجرا میشود.پایتون در صنعت خیلی پرکاربرد است به همین دلیل برای علم داده انتخاب شده است. پایتون در همهی حوزههای علم داده دارای کتابخانههای متعددی است که اکثر آنها توسط شرکتهای بزرگ یا دانشگاهها پشتیبانی و دائما بهروزرسانی میشوند.کدهای پایتون قابل فهم هستند. پرکاربردترین کتابخانه های پایتون :1- نامپای (با استفاده از نامپای، پردازش و محاسبات روی آرایهها سریعتر انجام میشود).2-پانداس (با پانداس میتوان عملیات بسیار بیشتری بر روی داده انجام داد که کاربران پایگاه داده و صفحات گسترده با این عملیات بسیار آشنا هستند) .3-مت پلات لیب (ین کتابخانه بیشتر در ساخت نمودارهای ۲ بعدی کاربرد دارد و رابط کاربری آن بسیار شبیه به متلب است. بسیاری از نمودارهای پرکاربرد را میتوان با متپلاتلیب ایجاد کرد). 4- سایکت لرن (سایکتلرن حاوی ابزارهای متنوعی برای یادگیری ماشین و مدلسازی آماری است).
چرا از یادگیری ماشین استفاده میکنیم؟یادگیریماشین به شرکتها این امکان را میدهد که کارهایی که قبلاً تنها توسط انسانها امکانپذیر بود را با سرعت بالاتر و دقت بیشتر انجام دهند،لازم است بدانیم که استفاده از یادگیریماشین به دلایل زیر خیلی آسانتر و فراگیرتر شده است:افزایش بی حد و حصر دادهها, ذخیره سازی مقرون به صرفه دادهها, افزایش قدرت پردازندهها و کاهش هزینههای آنها. با وجود اینکه امروزه یادگیریماشین نقش به سزایی در زندگی بشر ایفا میکند، اما همچنان چالشهایی برای بهکارگیری این تکنیک حل مسئله وجود دارد؛
که راجع به این چالشها بیشتر خواهیم آموخت. تعداد ناکافی داده : اگر به تعداد کافی داده به الگوریتم تزریق نکنیم، نمیتوانیم انتظار عملکرد خوبی داشته باشیم. داده بی کیفیت : داده بیکیفیت پر است از مقادیر اشتباه و گم شده, این اشتباهات اجازه نمیدهند مدل به عملکرد بالا دست پیدا کند. ویژگی های نامناسب : همواره باید سعی در انتخاب ویژگیهایی داشته باشیم که مدل بتواند از آنها بیاموزد و از دل آنها الگوهایی برای پیشبینی آینده استخراج کند
.پس از آنکه توانستیم چالشهای مربوط به داده را مدیریت کنیم، سراغ الگوریتم و مدل میرویم. بیشبرازش (overfiting)، کمبرازش (under fiting) و زمان نمونهای از چالشهای مربوط به مدلها و الگوریتمهای هوشمصنوعی و یادگیریماشین هستند. مسئله Overfitting : هدف ما در یادگیریماشین این است که با مشاهده و یادگیری از دادههای گذشته، آینده را پیشبینی کنیم. وقتی دچار Overfitting میشویم در حقیقت مدل عمومیت خود را از دست داده است؛ به عبارت بهتر مدل نمیتواند آینده را به درستی پیشبینی کند. علت عدم توانایی در پیشبینی آینده این است که دادههای آموزش را زیاد از حد یاد گرفته است. مسئله Underfitting : این مشکل وقتی بهوجود میآید که مدل نتواند به خوبی از دادگان آموزش، یاد بگیرد.
این مسئله میتواند به دلایل مختلفی پیش بیاید. داده نامناسب یکی از چندین دلیل کمبرازش است. مسئله زمان : زمان در یادگیریماشین از دو جهت اهمیت دارد؛ هم مدت زمانی که طول میکشد تا آموزش مدل تمام شود، هم زمانی که مدل برای پیشبینی نمونهها مصرف میکند. مدت زمانی که طول میکشد تا آموزش مدل تمام شود، طول مدت توسعه محصول را تحت تاثیر قرار میدهد و زمان مصرفی توسط مدل برای پیشبینی نمونهها زمانی است که کاربر نهایی تجربه میکند. دانشمند داده همواره سعی میکند هر دو زمان را کمینه کند. هدف از فصل یادگیری ماشین در عمل این است که شما با گامهایی که در یک پروژه یادگیری ماشین طی میشود آشنا شوید.
این گامها به شرح زیر هستند: دریافت و بررسی داده , آمادهسازی داده, انتخاب و آموزش مدل مناسب ,تست و ارزیابی

