
تذکر: این یک پست آموزشی برای عموم نیست! بلکه تنها جایی برای یادداشتهای من حین یادگیریه تا بهتر به خاطر بسپارم و در صورت لزوم به اونها مراجعه کنم.
(هر پارت شامل ۲۰ قسمت)
ادامهٔ مبحث Validation:
اگر قرار باشه که یک فیلدی از ۲ منظر Validate بشه، باید از Pipe استفاده کنیم:
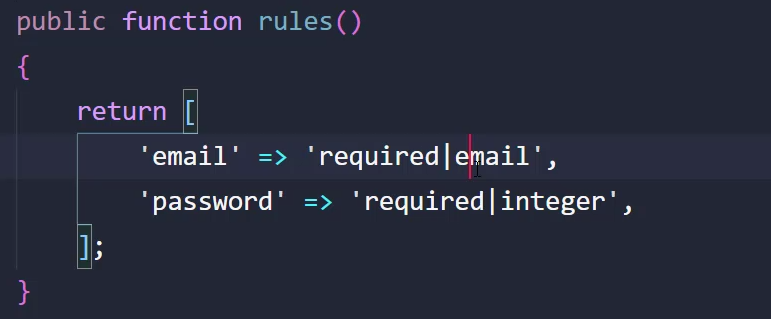
حالا اگر کاربر بیاد و مثلا ایمیل رو نادرست وارد کنه، لاراول یک error برمیگردونه و همچنین مقادیری که توی فیلدهای مختلف وارد کرده بود همگی پاک میشن که این حرکت اصلا کاربرپسند نیست و ما میتونیم با استفاده از یک helper function به اسم old دوباره اون مقدار رو فراخوانی کنیم:
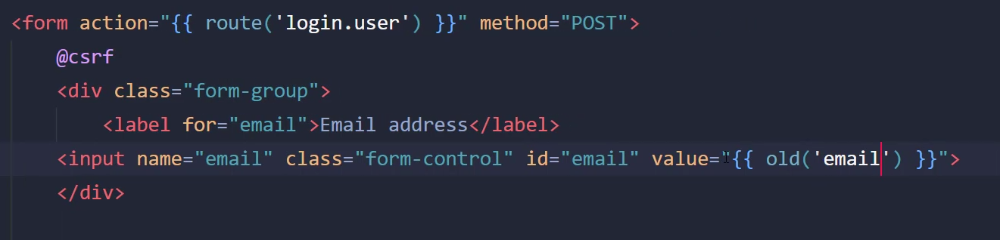
کل این پروسه با flash session هندل میشه و با یک refresh مجدد، حذف میشه.
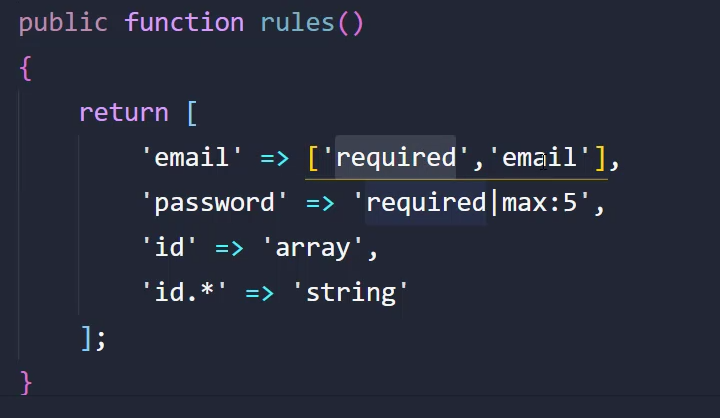
به جای Pipe میتونیم از آرایه هم استفاده کنیم؛ همچنین اگر یک Select Option از نوع multiple داشته باشیم که یک آرایه رو بفرسته سمت سرور، میتونیم با array چک کنیم که مقداری که داره میاد از نوع array هست یا خیر و با استفاده از .* میتونیم Validation رو برای تک تک عناصر آرایه هم انجام بدیم:
توی پوشهٔ resources یک پوشه داریم به اسم lang و یک پوشه به نام en که داخلش فایلهای زیر هست:
auth.php pagination.php passwords.php validation.php
داخل فایل validation، ارورهای ما قرار گرفته، حالا ما کافیه که یک پوشه به اسم زبانی که داریم داخل lang ایجاد کنیم و فایل validation رو توی اون translate کنیم. داخل این پوشه تمامی فایلهای بالا رو قرار میدیم و ترجمه میکنیم. حالا چطور به لاراول بفهمونیم که به جای en از fa استفاده کنه؟
باید بریم داخل پوشهٔ config و فایل app.php و مقدار locale رو به fa تغییر میدیم.
نمونهای از فایل validation.php:
<?php
    'accepted' => 'The :attribute must be accepted.',
    'accepted_if' => 'The :attribute must be accepted when :other is :value.',
    'active_url' => 'The :attribute is not a valid URL.',
    'after' => 'The :attribute must be a date after :date.',
    'after_or_equal' => 'The :attribute must be a date after or equal to :date.',
    'alpha' => 'The :attribute must only contain letters.',
    'alpha_dash' => 'The :attribute must only contain letters, numbers, dashes and underscores.',
    'alpha_num' => 'The :attribute must only contain letters and numbers.',
    'array' => 'The :attribute must be an array.',
    'before' => 'The :attribute must be a date before :date.',
    'before_or_equal' => 'The :attribute must be a date before or equal to :date.',
?>
حالا منظور از این :attribute چیه؟ در واقع نام فیلدی هست که از سمت فرانت اومده به back، حالا کافیه که آرایهٔ attributes رو هم با توجه به نام فیلدهای مختلفی که داریم سفارشی سازی کنیم:
<?php
    'attributes' => [
'email' => 'email_in_your_language'
],
?>
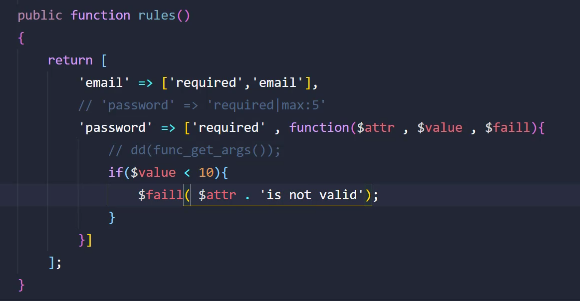
توی پوشهٔ app/Http/Requests و فایل LoginRequest.php اومدیم و توی متد rules، انواع validationها رو، روی فیلدهای مختلف مثل email و password اعمال کردیم؛ برای تعیین validationهای مختلف میتونیم از [] و | استفاده کنیم. اما یکی از مزایای [] اینه که میشه داخلش تابع نوشت.
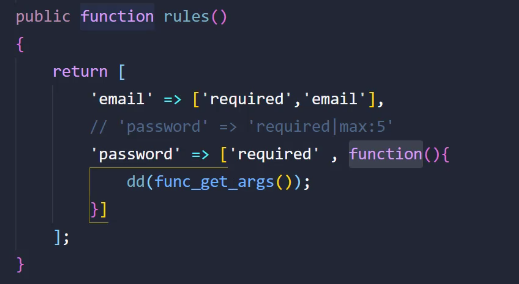
توی تصویر بالا ما اومدیم و یک تابع یا closure برای validation سفارشی خودمون ایجاد کردیم. با استفاده از تابع func_get_args چک کردیم که این تابع چه ورودیهایی داره و این رو توی خروجی داشتیم:
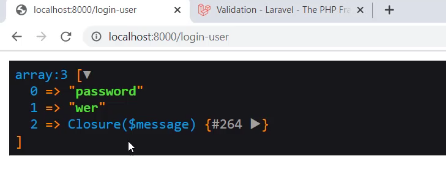
ورودیهای این تابع به ترتیب شامل $attr و $value و Closure هست. مثال:
ما میتونیم validation اختصاصی خودمون رو به Service Provider هم اضافه کنیم و براش یک اسم ساده در نظر بگیریم و فقط داخل rules فراخوانیش کنیم:
'password' => ['required', 'your_chosen_name_for_validation']
برای این کار میتونیم از Service Providerهای از پیش تعریف شده استفاده کنیم و یا اینکه یک Service Provider ایجاد کنیم. اگر قرار باشه از یک Service Provider از پیش تعریف شده مثل AppServiceProvider استفاده کنیم؛ باید تعریف Validation یا همون تابع Validation خودمون رو توی متد boot تعریف کنیم.
داخل متد boot باید بنویسیم Validator و با انتخاب اون و Ctrl Alt I بیاییم و Facade اون رو use کنیم:
<?php

namespace App\Providers;

use Illuminate\Support\ServiceProvider;
use Illuminate\Support\Facades\Validator;
use Illuminate\Validation\Validator as BaseValidator;

class AppServiceProvider extends ServiceProvider
{
    /**
     * Register any application services.
     *
     * @return void
     */
    public function register()
    {
        //
    }

    /**
     * Bootstrap any application services.
     *
     * @return void
     */
    public function boot()
    {
        Validator::extend('your_chosen_name_for_validation', function ($attr, $value, $parameters = [], BaseValidator $validator) {
            if ($value < 10) {
                return false;
            }
            return true;
        }, ':attribute is not valid');
    }
}
وقتی اومدیم Validatorای که use کردیم و اون رو extend کردیم؛ باید بهش یه سری مقادیر رو پاس بدیم؛ مقدار اول، اسم این validator سفارشی هست و دومی، یک تابع که ۴ تا پارامتر داره، اولی همون پارامتری هست که از فرانت بهش پاس داده میشه تا آنالیز بشه، دومی مقدار اون فیلد، سومی پارامترهای مختلف به شکل یک آرایه (اینجا رو باید دوباره توی فیلم نگاه کنم) و در نهایت یک Validator که باید Use بشه و البته چون از قبل یک Validator رو use کردیم باید براش یک alias در نظر بگیریم، در نهایت هم extend یک پارمتر میگیره به عنوان خروجی که برمیگردونه (یک مقدار درهم و برهم شد:) ).
فایل .env
این فایل توی root نرمافزار ما قرار داره که یک سری متغیر محیطی داره توش. متغیرهای تعریف شده توی این فایل به شکل بزرگ هستن و Value اونها هم داخل سینگل یا دابل کوتیشن نیستن.
مقادیری که داخل این فایل تعریف میشن داخل کل پروژه در دسترس هستن. این فایل به ما کمک میتونه تا متغیرهایی که مهم هستن و البته تغییرپذیر داخلش تعریف کنیم و در کل پروژه ازش استفاده کنیم بدون اینکه نیاز باشه توی فایلهای زیادی این مقادیر رو ست کنیم یا تغییر بدیم.
این فایل، جز چیزهایی هست که به وسیله git نادیده گرفته میشه و مثلا موقع آپلود توی github آپلود نمیشه، حالا توی composer.json ما میایم و چک میکنیم که آیا این فایل وجود داره یا خیر و اگر وجود نداشت، فایل .env.example کپی میشه به اسم .env و بهتره که متغیرهایی که ما تعریف میکنیم داخل env توی example هم تعریف کنیم.
نحوه دسترسی به این متغیرهای چطوریه؟
یک helper function وجود داره به اسم env که یک پارامتر میگیره به اسم متغیرهای تعریف شده توی خود فایل .env و اینطوری بهشون دسترسی پیدا میکنیم. این helper function دارای ۲ پارامتر است:
env('VARIABLE_NAME', 'Default Value');
برای کامنت کردن متغیرهای از # استفاده میکنیم.
برای وصل شدن به دیتابیس، باید یک سری مقادیر رو توی فایل env ست کنیم؛ که شامل موارد زیر میشه:
DB_CONNECTION=mysql
DB_HOST=127.0.0.1
DB_PORT=3306
DB_DATABASE=blog
DB_USERNAME=root
DB_PASSWORD=
لاراول از اونجایی که از PDO استفاده میکنه، میتونه به چندین مدل دیتابیس وصل بشه، توی متغیر DB_CONNECTION میتونیم نوع دیتابیس مورد استفاده توی پروژه رو انتخاب کنیم.
این مقادیر میرن توی فایل database.php توی پوشه config و اونجا ست میشن.
توی لاراول میشه به ۲ روش به دیتابیس دسترسی داشت:
DB Class
Eloquent (The ORM of Laravel)
مورد مشترک میان این دو مورد، استفاده از Query Builder هست؛ Eloquent یک سری کلاس به اسم Model ایجاد میکنه و از طریق این مدل ها به دیتابیس و جداول مورد نظر ما وصل میشه. اما DB به شکل مستقیم با دیتابیس ارتباط برقرار میکنه.
خب ما برای استفاده از این کلاس، میایم و از توی یکی از کنترلرهای خودمون فراخوانیش میکنیم؛ برای استفاده از این کلاس میتونیم از Facadeش استفاده کنیم و حواسمون باید باشه که حتما Facade این کلاس رو با Ctrl Alt I فراخوانی یا Use کنیم.
حالا میتونیم به روش زیر یک کوئری به دیتابیس و جدول دلخواه خودمون بزنیم:
$res = DB::connection('mysql')->table('table_name')->get();
$res = DB::table('table_name')->get();
$res = DB::table('table_name')->toSql();
dd($res);
مقداری $res که برگشت داده میشه، در واقع یک Illuminate\Support\Collection هست و یه نوع تایپ جدید هست که به وسیلهٔ لاراول ایجاد شده و امکانات بیشتری رو به آرایهٔ دیفالت php اضافه میکنه. این collection به راحتی قابل iterate کردنه و میتونیم به عناصرش با foreach دسترسی پیدا کنیم.
خب، میتونیم توی کنترلر پاسش بدیم به view:
return view('index', ['the_name_of_array', $res]);
// or using compact:
return view('index', compact('the_name_of_array'));
حالا توی view هم میتونیم به foreach اون رو iterate کنیم:
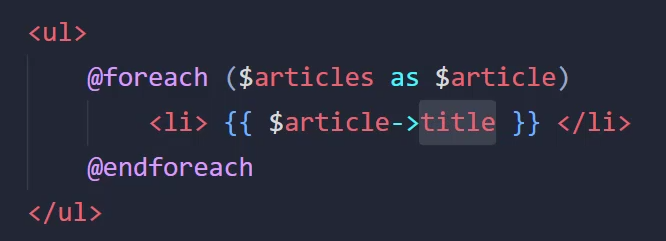
چند متد کاربردی از DB Class:
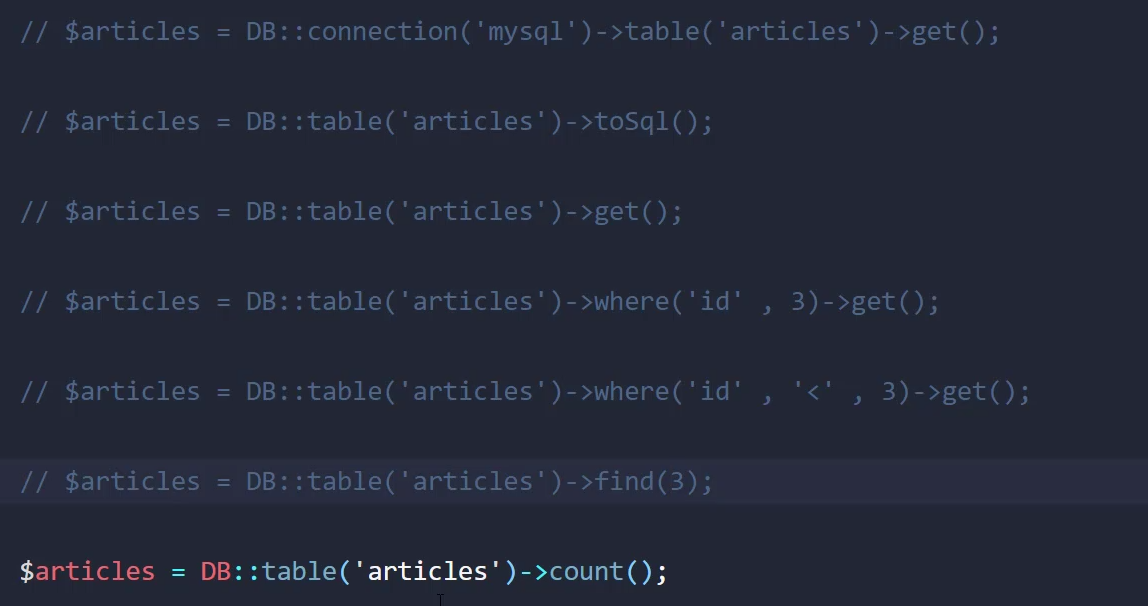
آشنایی با چهار عمل اصلی دیتابیس:
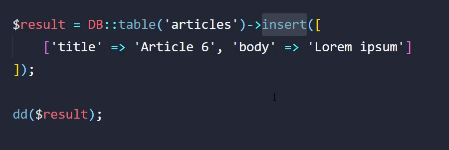
نحوهٔ Insert کردن دیتا به دیتابیس:
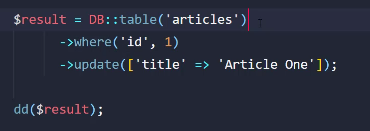
نحوهٔ Update کردن دیتا در جدول:
دستور delete با DB Class:
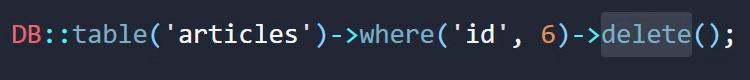
اگر متد Delete رو روی table اجرا کنیم؛ تمام محتویات جدول رو پاک خواهد کرد.
متدی truncate برای این استفاده میشه که کلا table به همراه sequences رو پاک کنه.
خب، Object-relational mapping یک ابزاره که به برنامهنویس کمک میکنه تا بدون نیاز به نوشتن کوئریهای دیتابیس مثل SQL به راحتی دیتای مورد نیازش رو از دیتابیس واکشی کنه، در واقع ORM یک سری کد و توابع داره که واسط بین دیتابیس و کدهای ما میشن و دیتای مورد نیاز ما رو بدون دردسر فراهم میکنند.
در واقع ORM داده های پایگاه داده ما رو به یک سری Object تبدیل میکنه که میتونیم روشون یک سری متد رو ران کنیم.
هر زبانی ممکنه که چندین ORM داشته باشه، خود لاراول یک ORM اختصاصی داره به نام Eloquent که حول محور Modelها میچرخه.
مدلها توی ساختار لاراول توی پوشهٔ app قرار میگیرن، مثلا به طور پیشفرض یک User.php داریم که با جدول کاربران ما ارتباط داره.
چطوری یک مدل اختصاصی ایجاد کنیم؟
php artisan make:model the_name_of_the_model
نحوهٔ نامگذاری مدلهای و جداول در لاراول به این صورته که اسم مدل باید مفرد باشه و با حرف بزرگ شروع بشه و اسم جدول باید جمع باشه و با حرف کوچک شروع بشه:
//Model:
Article
//Database Table:
articles
البته ممکنه اسم مدل یک چیزی باشه و اسم جدول یک چیز دیگر...
خب حالا چطور از این مدلها استفاده کنیم؟
کافیه که برای دسترسی به مدل خودمون توی controller اون مدل رو use کنیم (ctrl alt i):
$articles = Article::all();
return view('index', compact('articles'));
اما اگر بخوایم که مدل ما به یک table خاص وصل بشه، کافیه که توی کلاس Articleای که داریم؛ مقدار زیر رو override کنیم:
protected $table = 'article_blahblah';
اما بهتره که از قواعد و convention های لاراول پایبند باشیم. الان کل این پروسه رو بهش میگن ORM.
متد all کل سطرهای table رو برای ما برمیگردونه و میتونیم روش هر عملیاتی که دلمون میخواد رو بریم.
یک متد دیگهای داریم به نام find که به صورت دیفالت روی id ما ران میشه و سطر متناظر رو برمیگردونه:
Article::find(id_num);
میتونیم به جای یک سینگل int، یک آرایه از intها به find بدیم تا اون سطرها رو برای ما برگردونه.
متد کاربردی بعدی، متد where هست که برای فیلتر کردن خروجیهای table مورد استفاده قرار میگیره:
$articles = Article::where('id', 2)->get();
متد where یک پارامتر میانی هم داره که بین ستون و مقدار قرار میگیره و میتونه <=> باشه.
متد کاربردی بعدی first هست که اولین سطر table رو برای ما برمیگردونه:
$articles = Article::first();
متد findOrFail میاد find میکنه و اگر نبود؛ 404 برمیگردونه.
متد orderBy که یک ستون رو میگیره و آرگومان دومش هم ASC و DESC هست:
$articles = Article::orderBy('title', 'DESC')->get();
و اما متد take که یک int به عنوان تعداد ردیفهای برگشتی میگیره و اونها رو برمیگردونه:
$articles = Article::taker(num)->get();
برای این کار چندین روش وجود داره که به ترتیب همه اونها رو مرور خواهیم کرد:
روش اول اینطوریه که یک شی از مدل ایجاد میکنیم و به روش شیگرایی مقادیری رو به هر ستون نسبت میدیم و در نهایت متد save رو روی شی ایجاد شده از مدل ران میکنیم:
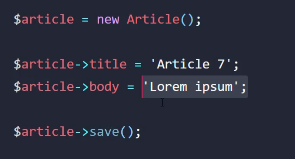
لاراول به صورت پیش فرض دو تا ستون برای هر جدول در نظر میگیره و موقع update و یا insert میاد و مقدار timestamp رو توی اون ها ذخیره میکنه:
updated_at
created_at
بهتره که برای جدول های خودمون این دو تا ستون رو هم بسازیم و تایپ اونها رو هم timestamp ست کنیم و همینطور اونها رو null کنیم.
روش دوم، وارد کردن دیتا با استفاده از یک آرایه هست:
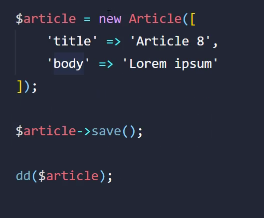
برای اینکه بتونیم mass assign رو اجرا کنیم حتما باید داخل controller خودمون مقدار زیر رو ست کنیم تا به لاراول بگیم که چه ستونهایی اجازهٔ پر شدن دارن و با ارور mass assign روبرو نشیم:
protected $fillable = ['title', 'body'];
یه لیست سیاه هم داریم که اجازهٔ پر شدن به یه سری ستون خاص رو نمیده:
protected $guarded = ['title'];
روش بعدی هم از نوع mass assign هست با این تفاوت که به جای تعریف شی و ران کردن متد save از create استفاده میکنیم:
$articles = Article::create([
    'title' => 'Article #',
    'body' => 'Something...'
]);
روش سوم به نام firstOrCreate شناخته میشه که توی آرگومان اول میاد و یک آرایه از ستون و مقدار متناظر میگیره و چک میکنه که آیا وجود داره یا خیر و اگر وجود نداشت؛ آرگومان دوم که شامل مقادیر ورودی ما هست رو وارد دیتابیس میکنه:
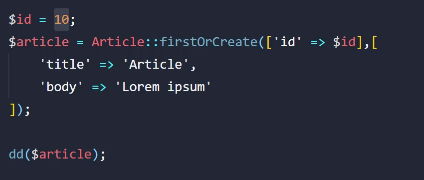
حالا خیلی راحت میتونیم table خودمون رو update کنیم؛ اینجا چند تا مثال مینویسم:
$articles = new Article();
$articles->where('column', 'value')->update(['column' => 'value']);

//example number two:
$articles = Article::find(1)->update(['title' => 'something']);
علاوه بر firstOrCreate یک updateOrCreate هم داریم؛ که میاد و اول چک میکنه که اگر اون مقدار وجود داشت، آپدیت میکنه و اگر نبود؛ ایجاد میکنه:
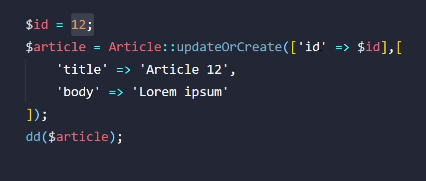
عملیات delete با استفاده از ORM:
یک مثال ساده...
$articles = Article::find(1)->delete();
$articles = Article::where('id', 1)->delete();
دستور دیگری که مشابه با delete هست؛ دستور destroy هست که میاد و اون ریکورد رو برای ما hard delete میکنه:
$article = Article::destroy(id);
به این دستور میتونیم یک آرایه از idها هم بدیم.
حذف نرم در برابر حذف Physical یا hard delete قرار داره و اجازه نمیده که دیتا از table حذف بشه و فقط اون رو غیرقابل نمایش میکنه.
پیادهسازی:
قبلا با فیدهای updated_at و created_at آشنا شده بودیم؛ اما حالا برای درک این مفهوم باید با فیلدی به نام deleted_at آشنا بشیم که میاد و موقع حذف این فیلد رو با timestamp پر میکنه و موقع واکشی دیتا از table، دیگه لاراول اون رو در نظر نمیگیره.
برای soft delete باید داخل کلاس مدل خودمون SofDeletes رو use کنیم و همینطور با ctrl alt i اون namespace رو هم use کنیم:
use SoftDeletes
خب، پس باید این فیلد رو هم به db اضافه کنیم و nullableش کنیم. حالا اگر یک ریکورد رو حذف کنیم؛ دیگه بهش دسترسی نداریم؛ اما این ریکورد به شکل physical هنوز توی دیتابیس و جدول ما وجود داره.
حالا اگر نیاز داشتیم که به اون soft delete شدهها هم دسترسی داشته باشیم چی؟ پایین کدش رو گذاشتم:
$articcles = Article::withTrashed()->find(7);
// check if the returned value is soft deleted:
dd($articles->trashed());
حالا متدی داریم به نام onlyTrashed که فقط soft delete شدهها رو برای ما برمیگردونه، همینطور متدی داریم به اسم restore که اون ریکورد soft delete شده رو دوباره به حالت معمول برمیگردونه و در واقع مقدار deleted_at اون رو null میکنه.
$articles = Article::onlyTrashed()->find(7);
$articles->restore();
dd($articles);
حذف Physical یک ریکورد soft delete شده:
$articles = Article::where('id', 7)->forceDelete();
خب، وقتی ما یک مدل با php artisan make:model model_name ایجاد میکنیم؛ یک سری متد به صورت پیشفرض برای کلاس مدل ما که از کلاس Model ارثبری کرده وجود داره، حالا شاید نیاز باشه که ما خودمون هم یه سری متد به مدل های خودمون اضافه کنیم؛ این متدها دو نوع دسترسی خواهند داشت؛ دسترسی از نوع global و local، که global روی تمامی کوئریها اجرا میشه و روشون اثر میذاره.
خب، برای توضیح این قضیه، باید یک سناریوی فرضی رو در نظر بگیریم؛ فرض کنید یک فیلد داریم به نام status که اگر ۰ باشه، اون کوئری باید فیلتر بشه و نمایش داده نشه و اگر ۱ بود؛ نمایش داده بشه، ما میتونیم یک متد با دسترسی global تعریف کنیم که این rule رو روی تمامی کوئریهای ما اجرا کنه.
برای این کار باید داخل کلاس مدل خودمون یک تابع به نام boot از نوع protected static تعریف کنیم که اولش داخلش متد boot کلاس والد رو فرامیخونیم و یک متد از نوع global اضافه می کنیم:
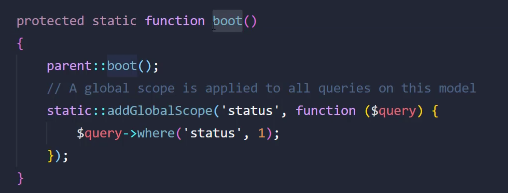
همونطور که در تصویر بالا دیده میشه، هر کوئری که بزنیم؛ یک دور هم این فیلتر روش اعمال میشه و نتیجه برمیگرده. حالا برای اینکه ببینیم که وقتی این متد global رو ست کردیم چه بلایی سر کوئری ما میاد! کافیه که کوئریای که زدیم رو با toSql تبدیل کنیم به رشته کوئری SQL و ببینیم که چه خبره.
اگر خواستیم یه کوئری بزنیم که از گوبال scope استفاده نکنه، چی؟
$articles = Article::withOutGlobalScope('the_name_of_global_scope')->where('id', 10)->get();
نحوهٔ استفاده:
$articles = Article::status();
چطور به کلاس Model اضافهاش کنیم؟
public function scopeStatus($query){
    $query->where('status', 1);
}
خب، اگر دقت کنیم؛ میبینیم که این تابع، اولش یه اسمی داره به نام scope که در واقع یک قانون در لاراول هست برای تعریف توابع Local Scope، اما موقع فراخوانی این متد توی Controller اصلا نیازی نیست که اون قسمت scope رو بنویسیم و خیلی ساده لاراول این رو برای ما هندل میکنه و باید اون Status رو هم با حرف کوچیک بنویسیم:
$articles = Article::status();
خیلی راحت هم میتونیم به این متد پارامتر هم ارسال کنیم:
public function scopeStatus($query, $parameter_1){
    $query->where('status', 1);
}
این موارد به ما کمک میکنن تا مقادیر، ویژگی یا به عبارتی attributeهای Eloquent خودمون که در واقع همون فیلدها یا ستونهای table هستن رو وقت ذخیرهسازی توی دیتابیس به شکل دلخواه فرمتبندی کنیم.
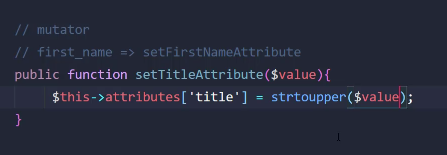
در واقع Accessor برای بازیابی دیتا از table هست (get) و Mutator برای نوشتن (insert) دیتا توی دیتابیس.
یک مثال ساده از کاربرد این موارد اینه، فرض کنیم که ما میخوایم موقع get کردن دیتا، مقادیر timestamp رو به جای اینکه میلادی باشه، تبدیلش کنیم به شمسی، یا مثلا تمامی titleها رو با حروف کوچیک برگردونیم.
حالا، چطور باید این قضیه رو پیادهسازی کنیم؟
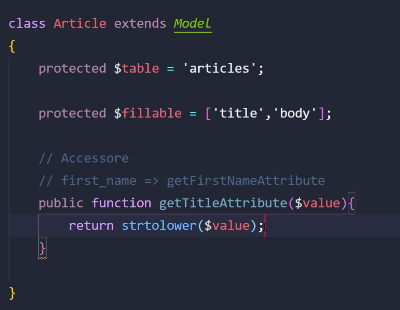
یک پیادهسازی ساده از یک اکسسور برای دستیابی به title جدول پایگاه داده داخل کلاس Article که همون مدل ما باشه، تعریف میکنیم:
فرمول نام این Accessor به این شکله که:
get + capitalized name of the attribute + Attribute
public function getTitleAttribute(){

}
اگر اسم ستون باشه first_name چه کنیم؟ باید بنویسیم getFirstNameAttribute. اینا در واقع همون getter و setter هستن که لاراول اون ها رو سادهسازی کرده.
توی تصویر زیر یک accessor رو میبینیم که میاد روی attribute یا همون فیلد یا ستون یه سری عملیات (اینجا lowercase کردن) انجام میده و اینطوری میتونیم دیتای خودمون رو فرمت کنیم:
فرض کنیم که یک ستون title داریم و میخوایم هر چیزی که توی این ستون ذخیره میشه Capitalize باشه، کافیه که یک mutator به صورت زیر تعریف کنید (شبیه setter هست):
ابزاری برای ایجاد و مدیریت جداول پایگاه داده، معمولا توی یک پروژهٔ نرم افزار و با پیشرفت پروژه ممکنه که یه سری جداول جدید نیاز باشه، یا نیاز باشه فیلدهایی به یک جدول اضافه یا کم بشه، بنابراین نیازه که یه ابزاری داشته باشیم تا این کار رو برای ما راحت کنه و این امکان رو برای ما فراهم کنه تا به راحتی به نسخههای مختلف جداولی که تعریف کردیم سوییچ کنیم (تاریخچه).
توی پوشهٔ روت و داخل پوشهٔ database سه تا پوشه داریم به نامهای factories migrations و seeders که در ادامه در موردشون بیشتر خواهیم خوند.
اگر وارد پوشهٔ migrations بشیم، به صورت پیشفرض لاراول ۳ تا migraton برای ما گذاشته که اسم همهٔ اون ها با تاریخ و زمان شروع میشه و بعد نام تخصصی اون فایل که بیانگر کاری هست که میکنه. علت آوردن تاریخ و زمان در ابتدای نام هر فایل اینه که از ایجاد اسامی تکراری جلوگیری بشه و دوم اینکه اولویت این فایلها بسیار مهمه.
نحوه ایجاد یک migration در لاراول:
php artisan make:migration create_[the_name_of_the_table]_table --create=the_name_of_the_table
خب کلاس migration ما که ایجاد شد، داخلش دو تا متد داریم؛ یکی up و دیگری down که up برای ایجاد جدوله و down برای پاک کردن جدول.
در تصویر زیر میتونیم فایل migration و کلاسی و متد up رو ببینیم که از کلاس پدری Migration اکستند شده:
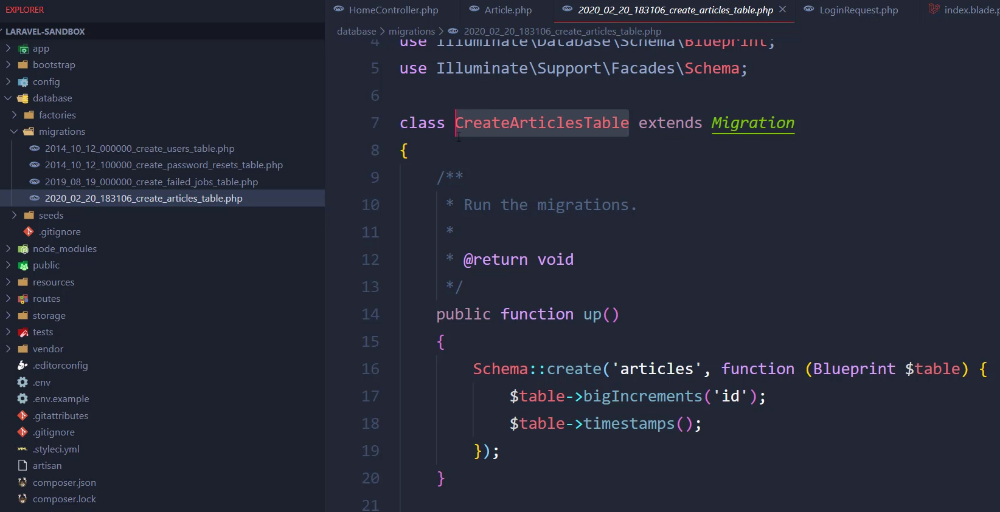
اون متد timestamp برای created_at و updated_at به کار میرن. که جلوتر در مورد این متدها و نحوهٔ ایجاد فیلدهای دیگه توضیح خواهیم داد.
اما روش دیگه ای هم برای ایجاد migration وجود داره و اون هم استفاده از command ساخت مدل هست؛ به این صورت که وقتی داریم یک مدل میسازیم؛ یک migration هم برای اون table ایجاد میکنیم:
php artisan make:model Article -m
که میاد و یه migration هم طبق نامی که بهش دادیم برای ما ایجاد می کنه، مثلا اسمش میشه:
2022_05_10_202020_create_articles_table
توی تصویر زیر، متد up رو داریم که توی بدنهٔ تابع، اومدیم و ستون هایی رو تعریف کردیم؛ شی table متدهایی داره که مقادیری رو به عنوان ورودی میگیره، در واقع این متدها برمیگردن به type های MySQL و اون پارامتر ورودی هم در واقع نام ستون هست:
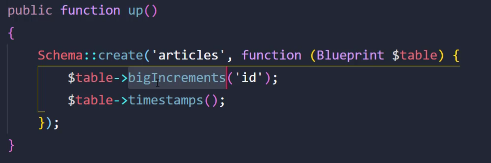
خب این bigIncrements یعنی چی؟ اگر بریم توی داکیومنت لاراول و بخش Migrations و Columns لیست تمامی typeهای جدول میاد.
خب حالا بریم برای اضافه کردن چند تا ستون خوشگل:
$table->string('title', 100);
$table->text('body');
$table->boolean('status')->default(0);
توی کد بالا، default در واقع یک column modifier هست. خب، یک نکتهٔ مهم دیگه هم داریم، اونم اینه که توی لاراول برای varchar از string استفاده میکنیم چون توی پایگاههای داده مختلف دیتا تایپها متفاوته و مثلا ممکنه توی یک پایگاه داده اصلا چیزی به اسم varchar نباشه یا با اسم متفاوتی ارائه بشه، اما استفاده از string به ما کمک میکنه که یک حالت compatibility بین دیتابیسهای مختلف به وجود بیاریم و حتی اگر بعدا مجبور شدیم دیتابیس رو تغییر بدیم، زحمت زیادی برای تغییر کدهای خودمون نکشیم.
خب، خب، خب... حالا که migration رو نوشتیم، باید با کمک atrisan اونو روی دیتابیس هم پیادهسازی کنیم:
php artisan migrate
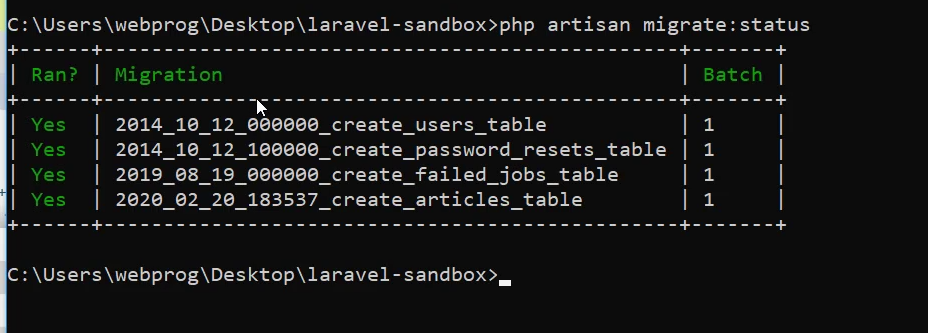
حالا قبل از اینکه مستیم migrate بزنیم؛ میتونیم از دستور status استفاده کنیم که وضعیت migrationهای ما رو نشون خواهد داد:
php artisan migrate:status
اگر حین migrate کردن با error زیر مواجه شدیم؛ باید یک مقداری رو توی متد بوت، AppServiceProvider برای Schema ست کنیم:
// Error:
unique key is too long...

// way to solve:

use Illuminate\Database\Schema\Builder;
public function boot()
{
    Builder::defaultStringLength(191);
}
وقتی دستور migrate رو به صورت خشک و خالی میزنیم؛ تمامی migration ها رو برای ما migrate میکنه و یک table به نام migrations ایجاد میکنه که توی لیست migrationهای ما نیست. در قسمت پایین میتونید یک تصویر از این جدول رو ببینید که سه ستون داره، id migration و batch که دستهٔ migration رو نشون میده:
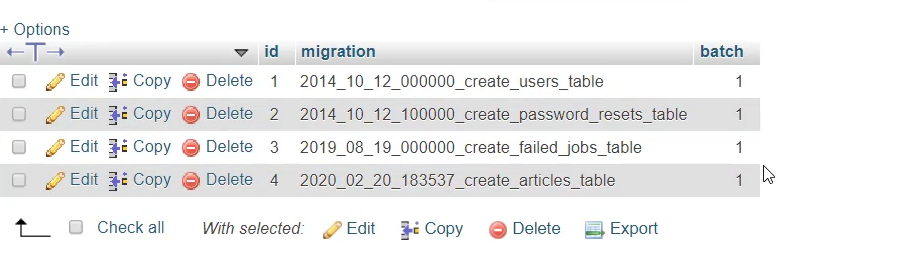
حالا منظور از batch چیست؟ همهٔ جدولها یک بچ نامبر دارن، و این به معنی هست که تمامی این جدولها با هم و در یک زمان ایجاد شدند. حالا اگر بیاییم و یک یا چند migration جدید ایجاد و migrate کنیم؛ اینها در دستهی ۲ قرار میگیرند و الی آخر.
حالا این دستهبندیها به ما کمک میکنه تا عملیات rollback رو با کمترین هزینه و دردسر اعمال کنیم.
توی تصویر زیر نمونهای از خروجی status رو میبینیم:
مجموعه دستورات migrate مربوط به artisan:
 migrate
  migrate:fresh          Drop all tables and re-run all migrations
  migrate:install        Create the migration repository
  migrate:refresh        Reset and re-run all migrations
  migrate:reset          Rollback all database migrations
  migrate:rollback       Rollback the last database migration
  migrate:status         Show the status of each migration
حالا اگر یک مدل و migration جدید ایجاد کنیم و status بگیریم؛ با این جدول روبرو میشیم:
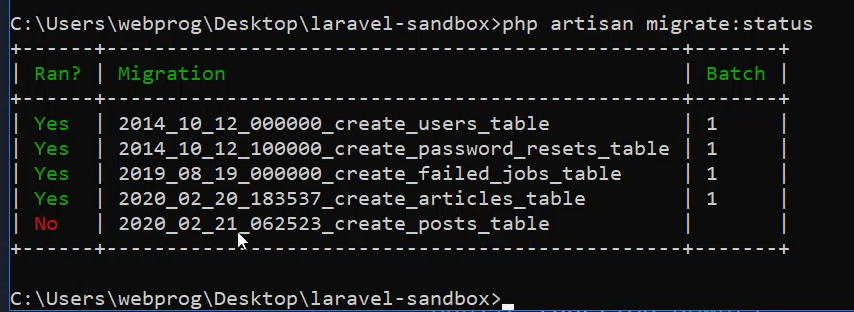
حالا اگر migrate بزنیم؛ تنها همین جدولی که migrate نشده؛ migrate خواهد شد و وضعیت Ran? به Yes تغییر پیدا میکنه و همینطور Batch number هم برابر با ۲ خواهد شد.
نحوهٔ عملکرد دستور rollback به این صورت هست که میاد و آخرین batch number موجود در جدول migrations رو پیدا میکنه و اون(ها) رو drop میکنه. مثلا ما تصمیم گرفتیم که یک فیلدی رو به جدول posts خودمون اضافه کنیم؛ حالا کافیه که یه rollback بریم تا جدول توی دیتابیس drop بشه، بعدش تغییرات رو داخل فایل migration ایجاد کردیم؛ یک migrate میزنیم و جدول دوباره ایجاد میشه.
بعد از دستوراتی مثل refresh fresh reset کل دستهبندیهای یا batch ها حذف میشن و تغییر میکنن.
برای ایجاد تغییرات روی جداول چند راه وجود داره، مثل rollback و یا reset و... که مشکلشون اینه که کل table رو drop میکنن و به خصوص روی سرور پروداکشن دردسرزا هستن، اما با استفاده از خود migration هم میشه این کار رو کرد که در ادامه بررسی خواهیم کرد:
برای جدولی که توی دیتابیس داریم و قراره که با استفاده از migration یک ستون جدید بهش اضافه کنیم بدون اینکه مجبور به استفاده از rollback...migrate و دستورات مشابه که باعث drop شدن و بهم ریختگی batchها میشن میتونیم از --table مربوط به دستور make:migrate استفاده کنیم:
php artisan make:migration add_new_field_to_articles_table --table=articles
خب، حالا یک migration جدید ساخته میشه که به جای Schema::create از Schema::table استفاده میکنه:
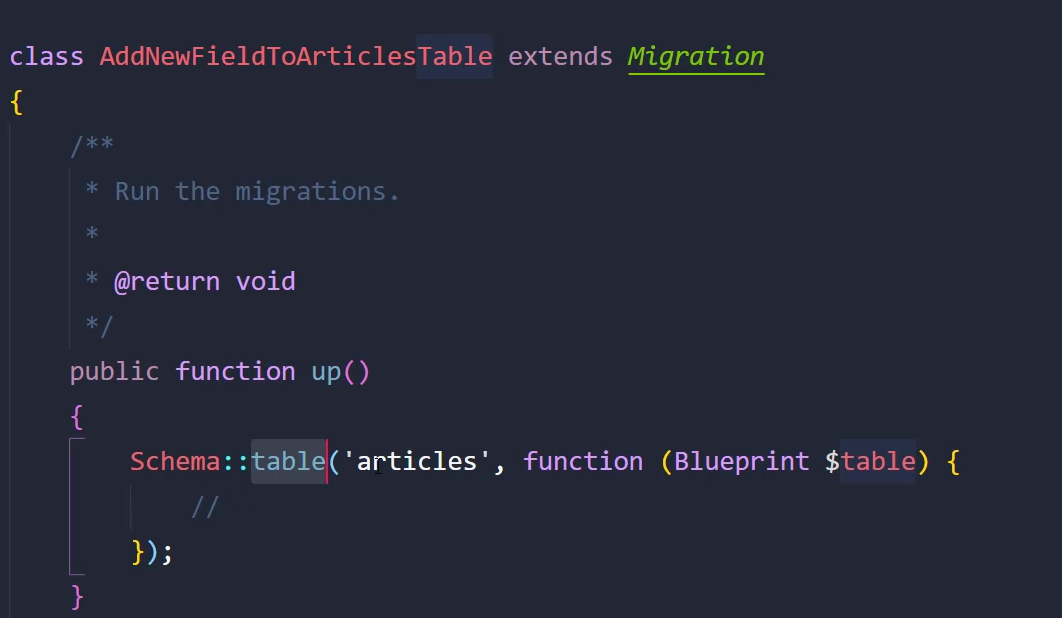
اما باید متد down این migration رو هم اوکی کنیم:
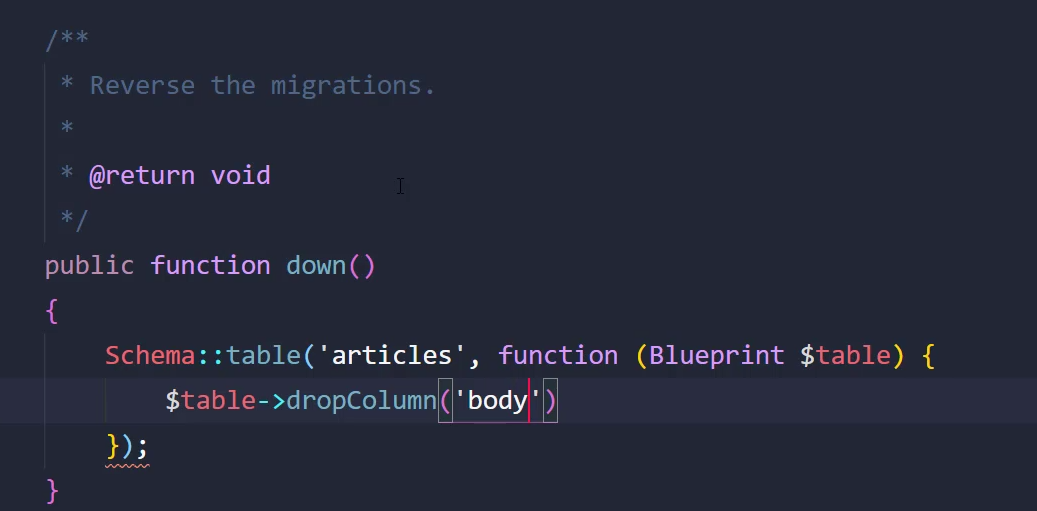
چند تا نکتهٔ ریز و مهم اینجا وجود داره، اول اینکه توی متد up که میاییم و ستون های جدید رو تعریف میکنیم؛ حتما باید اون ستون ها یا nullable باشن و یا اینکه یک مقدار default براشون تعریف کنیم؛ وگرنه دچار مشکل میشیم و دوم اینکه برای دراپ کردن در متد down به جای تعریف چندین دستور dropColumn کافیه که یک آرایه از ستونها رو بهش بدیم.
حالا به راحتی میتونیم rollback بزنیم و فقط همون یک ستونی که اضافه کردیم رو drop کنیم؛ اما برای modification چطور؟ یعنی مثلا مقدار varchar که همون string باشه رو از ۲۰۰ به ۱۰۰ برسونیم و یا حرکاتی مثل این!
برای این کار باید دقیقا مثل روش اضافه کردن ستون یک migration جدید ایجاد کنیم؛ و حالا یک اسمی هم برای migration قرار میدیم که نشون بده قراره توش یک سری column رو تغییر بدیم:
php artisan make:migration change_column_from_articles_table --table=articles
حالا محتویات فایل ما اینطوری میشه:
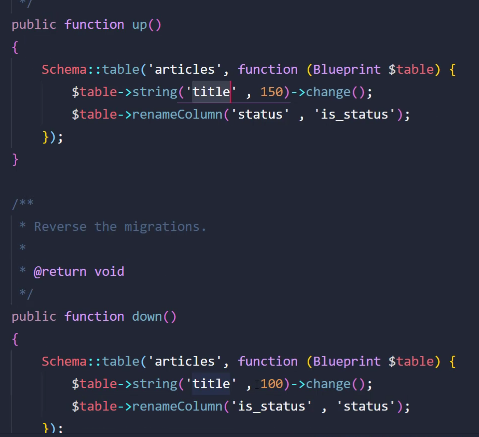
توی متد up در واقع اومدیم و مقدار string ستون title رو از ۱۰۰ به ۱۵۰ افزایش دادیم و اسم ستون status رو به is_status تغییر دادیم. و برعکس این عملیات رو توی down پیادهسازی کردیم.
حالا اگر migrate کنیم؛ ممکنه که با error مواجه بشیم که میگه کتابخونهٔ doctrine/dbal نصب نیست؛ که در واقع یک کتابخونهای هست که برای chnage کردن ستونها مورد استفاده قرار میگیره.
برای نصب کتابخونه کافیه که از composer کمک بگیریم:
composer require doctrine/dbal
از سیدر برای تولید دیتای فیک و ایجاد ریکوردهای فیک به صورت اتوماتیک استفاده میشه. برای این کار اول از همه باید ببینیم که این seederها کجا قرار میگیرن، توی پوشهٔ database گفتیم که ۳ تا پوشه داریم به اسم های seeds factories و migrations که مشخصه seeders توی seeds قرار میگیره.
توی پوشهٔ seeds یک فایل seeder دیفالت به اسم DatabaseSeeder.php داریم که یک متد داره به اسم run که با استفاده از متد run میاد و seederهای مختلفی که ما تعریف میکنیم رو ران میکنه.
حالا چطوری یک seeder برای جدول خودمون بسازیم؟ خیلی ساده با استفاده از artisan میشه این کار رو کرد:
php artisan make:seeder ArticlesTableSeeder
که حالا جای Articles میتونیم هر جدولی که مد نظره رو بذاریم (بدیهیات!)
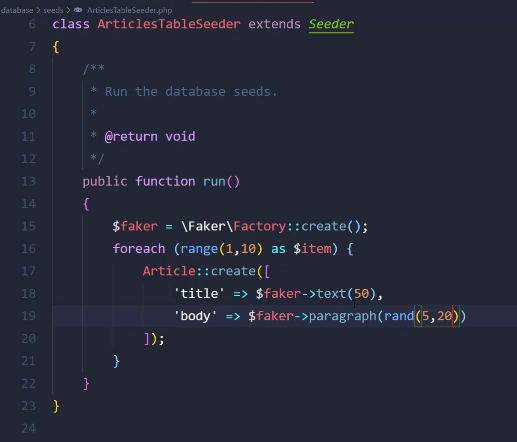
این seederی که ایجاد شده یک متد run داره و توی این ران میاییم و دیتا رو به جدول تزریق میکنیم؛ وقتی که این seeder کال شد، دیتا توی جدول میشینه:
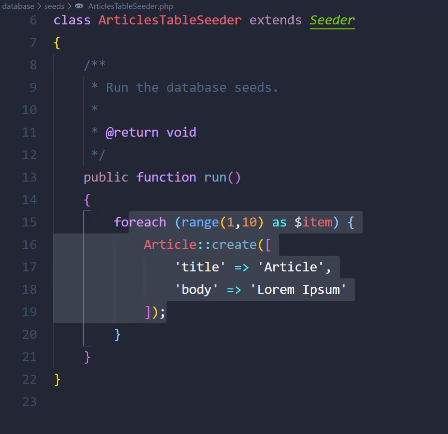
توی روش بالا، وقتی دیتا رو با create داریم وارد دیتابیس میکنیم؛ در واقع داریم از روش mass assign استفاده میکنیم؛ بنابراین باید که متغیر fillable رو توی مدل خودمون که اینجا Article باشه، تعریف کنیم:
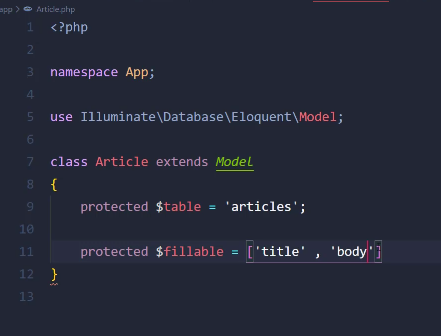
حالا چطوری seeder خودمون رو فراخوانی کنیم؟ باید این seeder رو توی DarabaseSeeder.php کال کنیم:
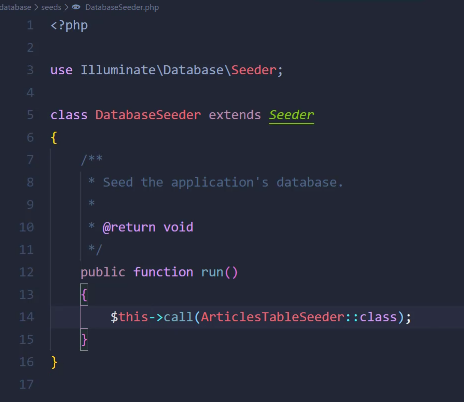
علت این داستان اینه که db:seed به صورت دیفالت، فایل DatabaseSeeder رو فراخوانی میکنه، اگر بخوایم که فقط همون seeder رو ران کنیم؛ باید از آپشن --class استفاده کنیم:
php artisan db:seed --class=ArticleTableSeeder
باید دقت داشته باشیم که اگر چندین seeder داشته باشیم؛ کافیه که یک آرایه از seederها رو به متد call بدیم.
حالا اگر بخوایم یه سری دیتای واقعیتر و ملموستر وارد table کنیم؛ چیکار باید کرد؟
یک کتابخونه وجود داره به اسم Faker که به صورت دیفالت همراه با Laravel نصب میشه، حتی Fakerهای ایرانی هم وجود داره. حالا چطور ازش استفاده کنیم؟
یه نکتهٔ جالب که وجود داره اینه که دستور زیر، که برای drop کردن کلی tableها کاربرد داره، یه آپشن --seed هم میگیره و بعد از پاک کردن جدولها، اونها رو سید هم میکنه و نیازی نیست که دستور seed رو جداگانه بزنیم:
php artisan migrate:fresh --seed
پایان قسمت ۶۰

