
احتمالا اگر به حوزه ماشین لرنینگ علاقهمند بوده باشید، یک بار اسم لجستیک رگرشن (Logistic Regression) به گوشتون خورده. ولی آیا واقعا میدونید چی هست و ریاضیات پشتش، دلیل نامگذاریش و نحوهی کارکردش چطوریه؟
امروز میخوام این الگوریتم ساده اما بنیادی رو کاملا بازش کنم! در آخر هم کدی که زدم رو قرار دادم تا هم کد رو ببینید و هم خروجی نمودارها رو، تا بهتر کمکتون کنه که کامل براتون جا بیفته. بزن بریم!
با مرور فرمول خطی شروع میکنیم:
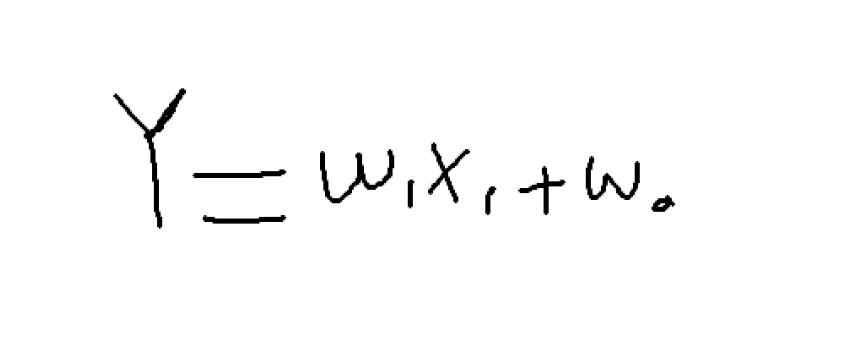
خروجی این تابع میتواند هر مقدار حقیقی از منفی بینهایت تا مثبت بینهایت را بگیرد. در صورتی که ما توی خروجی میخوایم احتمال پیشبینی کنیم و احتمال هم همیشه بین ۰ و ۱ هست.
برای حل این مشکل، مفهوم Odds (شانس) معرفی شد:
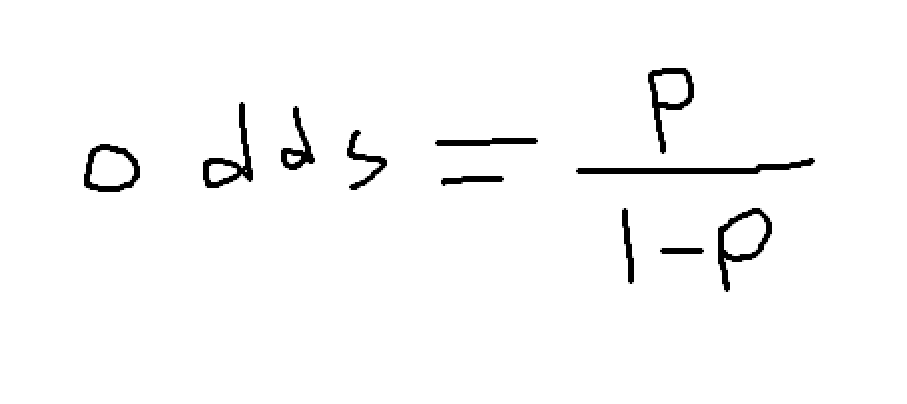
میدونید که توی ریاضی به p میگن احتمال رخ دادن یک رویداد و به 1 - p میگن احتمال رخ ندادنش. اگر p → 0، مقدار Odds به صفر نزدیک میشه و اگر p → 1، مقدارش به بینهایت میل میکنه. پس خروجی بازه (0, +∞) رو پوشش میده، ولی ما هنوز به منفی بینهایت دسترسی نداریم!
حالا اگر از فرمول بالا بیایم لگاریتم طبیعی (ln) بگیریم، خروجیای تولید میکند که تمام اعداد حقیقی را پوشش میدهد (بهش Logit هم میگن):
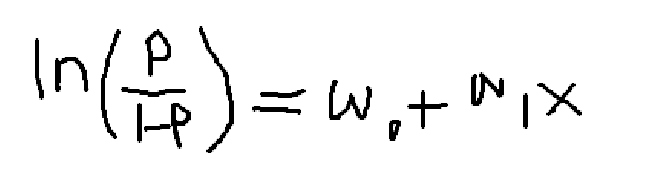
حالا با کمک این فرمول میتونیم p رو ایزوله کنیم (یعنی تنهاش کنیم) و میبینیم که دقیقاً به تابع سیگموید یا همون تابع لجستیک میرسیم:
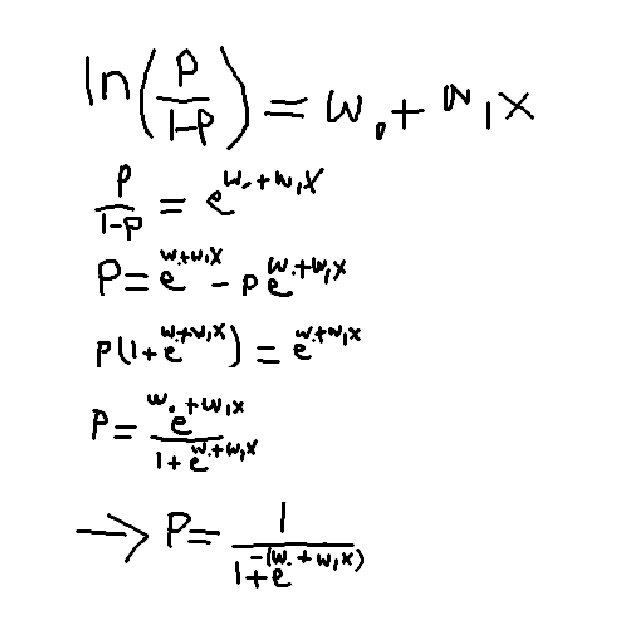
به همین دلیل میتوان خروجی مدل را به صورت یک احتمال نیز تفسیر کرد؛ مثلاً اگر مدل مقدار 0.92 را برگرداند، یعنی بر اساس دادههای آموزشی، احتمال تعلق نمونه به کلاس ۱ حدود ۹۲٪ برآورد شده است.
چرا بهش میگن Logistic Regression؟
نام Logistic از تابع Logistic گرفته شده؛ تابعی S-شکل که خروجی مدل را به احتمال تبدیل میکنه. واژهی Regression به این دلیل به کار رفته که مدل، Log-Odds را بهصورت یک ترکیب خطی از ویژگیها مدلسازی میکنه و پارامترهای این رابطه را با روش بیشینهسازی درستنمایی (Maximum Likelihood Estimation) برآورد میکنه.
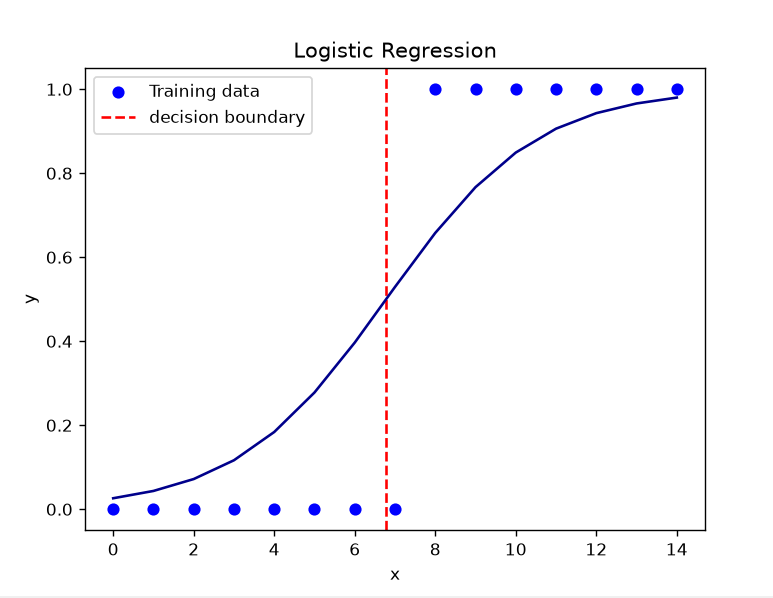
خروجی تابع سیگموید یک عدد پیوسته بین ۰ و ۱ هست. برای اینکه بیایم به طبقهبندی تبدیلش کنیم، فقط کافیه یه Threshold (آستانه) بذاریم؛ مثلا اگر احتمال ما بزرگتر یا مساوی 0.5 بود داده در گروه ۱ قرار داده بشه و اگر کوچکتر بود در گروه ۰.
! یک نکته کاربردی: البته مقدار ۰٫۵ یک قانون ثابت نیست و بسته به مسئله میتوان آستانه را تغییر داد؛ برای مثال در تشخیص بیماریها معمولاً برای کاهش احتمال از دست رفتن بیماران (کاهش False Negative)، آستانه را کمتر از ۰٫۵ انتخاب میکنند.
یه نکتهای که کمتر جایی بهش اشاره میشه، Zero-Centered نبودن تابع سیگموید هست (یعنی خروجی اون همیشه مثبته و بین ۰ و ۱ میمونه).
البته این موضوع بیشتر زمانی اهمیت پیدا میکنه که سیگموید به عنوان تابع فعالساز در شبکههای عصبی استفاده بشه، نه لزوماً خود لجستیک رگرشن تکلایهای.
وقتی از سیگموید در لایههای شبکه استفاده میکنیم، خروجی اون میشه ورودی لایههای بعدی (x_i > 0). حالا اگر بیاین از تابع لاس مشتق بگیرین تا گرادیان وزنها رو حساب کنین:
∂L / ∂wᵢ = δ × xᵢ
چون خروجی سیگموید همواره بین ۰ و ۱ قرار داره، میانگین ورودی لایهی بعد معمولاً حول صفر نیست (Zero-Centered نیست). این موضوع میتونه باعث همبستگی بیشتر گرادیانهای وزنها بشه و در برخی شرایط، روند بهینهسازی را کندتر کنه.
حالا یه سوال پیش میاد: چرا از MSE استفاده نکردیم و رفتیم سراغ Binary Cross Entropy؟
برای فهمیدنش کافیه مشتق MSE رو زمانی که با تابع سیگموید ترکیب میشه بررسی کنیم. در این حالت عبارت σ'(z) ظاهر میشه که در مقادیر خیلی بزرگ یا خیلی کوچک به صفر نزدیک میشه و باعث میشود در نواحی اشباع سیگموید گرادیانها بسیار کوچک بشن و در نتیجه روند یادگیری کندتر بشه.
هنگام مشتقگیری از Binary Cross Entropy نسبت به ورودی مدل، جملهی مربوط به مشتق سیگموید حذف میشه و گرادیان نهایی به فرم سادهی p−y میرسه. این ترکیب نسبت به استفاده از MSE گرادیانهای مناسبتری ایجاد میکنه و بنابراین گرادیانهای حاصل برای آموزش لجستیک رگرشن مناسبتر هستن و بهینهسازی معمولاً سریعتر و پایدارتر انجام میشه.
اینم از کدی که نوشتم:
import numpy as np import matplotlib.pyplot as plt class LogisticRegression: def __init__(self): self.weight= np.random.rand() self.bias= 0 self.loss= None self.prediction= None self.loss_histories=[] def predict_linear(self,x): z =self.weight * x + self.bias return z def sigmoid(self,z): y = 1/(1+np.exp(-z)) return y def predict(self,x): z = self.predict_linear(x) p = self.sigmoid(z) return p def compute_loss(self,x,y): p = self.predict(x) eps = 1e-15 p = np.clip(p, eps, 1 - eps) BCE= -np.mean(y * np.log(p) + (1-y) * np.log(1 - p)) return BCE def grad(self,x,y): n = len (x) p =self.predict(x) error= p - y dw=(1/n)* np.sum(error * x) db=(1/n)* np.sum(error) return dw,db def fit(self,x,y,epochs=4000,learning_rate=0.01): for epoch in range(epochs): loss=self.compute_loss(x,y) self.loss_histories.append(loss) gradient_w,gradient_b=self.grad(x,y) self.weight-= learning_rate * gradient_w self.bias-= learning_rate * gradient_b self.prediction=self.predict(x) self.loss= self.compute_loss(x,y) x = np.arange(15) y = np.array([0] * 8 + [1] * 7) LR = LogisticRegression() LR.fit(x,y) predictions = LR.predict(x) plt.title("Logistic Regression") plt.xlabel("x") plt.ylabel("y") plt.scatter(x,y,color="blue",label = "Training data") boundary = - LR.bias / LR.weight plt.axvline(x=boundary, color="red" , linestyle="--" , label="decision boundary") plt.legend() plt.plot(x , predictions ,color="darkblue" ) plt.figure() plt.plot(LR.loss_histories) plt.ylabel("Binary Cross Entropy") plt.show()
مرز تصمیمگیری در نقطهای قرار داره که مقدار z=wx+b برابر صفر بشه؛ بنابراین در این مثال مرز تصمیم برابر است با x = -b / w.
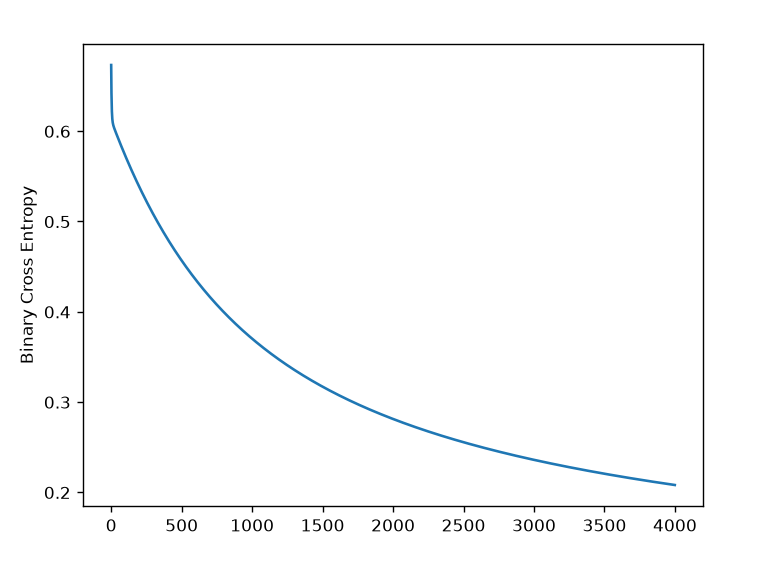
روند نزولی Loss نشان میده که الگوریتم به سمت کمینهی تابع هزینه همگرا شده است.
شاید بپرسید آیا هنوز هم از لجستیک رگرشن استفاده میشه؟
پاسخ کوتاه: بله، خیلی زیاد.
لجستیک رگرشن هنوز هم یکی از مهمترین مدلهای پایه در پزشکی، اقتصاد، بیمه، تشخیص تقلب و .... هست، چون بسیار سریع و سبک بوده و مهمتر از همه تفسیرپذیره.
فرض خطی بودن Log-Odds: این مدل فرض میکنه که رابطهٔ بین ویژگیها و Log-Odds خطی است، بنابراین اگر این فرض برقرار نباشد، عملکرد مدل افت میکند.
مرز تصمیمگیری خطی: به صورت پیشفرض نمیتونه مسائلی مثل XOR یا دادههای پیچیدهای که مرز غیرخطی دارن رو بدون مهندسی ویژگی پردازش کنه.
حساسیت به دادههای پرت (Outliers): از اونجا که تابع زیان برای نمونههایی که با اطمینان بالا اشتباه پیشبینی میشن جریمه بزرگ و سنگینی در نظر میگیره، چند دادهی پرت میتونن روی پارامترهای مدل اثر قابل توجهی بذارن؛ بهخصوص زمانی که دادهها بهخوبی قابل جداسازی خطی نباشن.
محدودیت در مدلسازی روابط پیچیده: برای دادههای غیرساختاریافته مانند تصویر یا متن، اگر ویژگیهای مناسبی استخراج نشوند، معمولاً مدلهای پیچیدهتر عملکرد بهتری خواهند داشت.
برای همین در مسائل پیچیدهتر، بسته به نوع مسئله، ممکن است مدلهایی مانند XGBoost، LightGBM یا شبکههای عصبی عملکرد بهتری داشته باشند.
در بسیاری از پروژهها، Logistic Regression یکی از اولین مدلهاییه که بهعنوان Baseline مورد ارزیابی قرار میگیره.
خوشحال میشم نظراتتون رو بدونم و اگر سوالی درباره ریاضیات یا کد داشتید، حتماً بپرسید!

