
چکیده
در بسیاری از بحث های مربوط به هوش مصنوعی، بیشتر توجه به خود مدل داده می شود؛ مثلا مدلی که متن تولید می کند، تصویر را تشخیص می دهد یا برای انجام یک کار پیشنهاد ارائه می دهد. اما در یک محصول واقعی، مدل فقط یک بخش از سیستم است. داده باید آماده شود، مدل باید نگهداری و نسخه بندی شود، درخواست های کاربران باید کنترل شوند و رویداد های مهم نیز باید ثبت شوند.
در این مقاله مروری، مقالات ضمیمه شده با تمرکز بر معماری نرم افزار در سیستم های مبتنی بر هوش مصنوعی بررسی می شوند. موضوعاتی مانند یادگیری فدرال، برنامه ریزی هوش مصنوعی، الگو های طراحی، ارزیابی معماری، دفاع امنیتی خود تطبیق، عامل های هوشمند و معماری مایکرو سرویسی مورد توجه قرار می گیرند.
نتیجه مشترک مقالات این است که امنیت نباید فقط در پایان کار و به شکل یک فیلتر اضافه شود. امنیت باید در بخش های مختلف معماری دیده شود؛ از داده و مدل تا ابزار، حافظه، ثبت فعالیت ها و کنترل اختیار عامل. در عین حال، هر تصمیم معماری یک هزینه دارد. برای مثال، کنترل امنیتی بیشتر می تواند زمان پاسخ را افزایش دهد و تقسیم زیاد سیستم به سرویس های کوچک نیز می تواند مدیریت سیستم را سخت تر کند.
۱. مقدمه و شفاف سازی مفاهیم پایه
۱-۱. معماری نرم افزار چیست؟
معماری نرم افزار را می توان مانند نقشه یک ساختمان در نظر گرفت. در نقشه ساختمان مشخص می شود هر بخش کجا قرار دارد و مسیر های ارتباطی چگونه هستند. در معماری نرم افزار نیز مشخص می شود سیستم از چه بخش هایی ساخته شود، هر بخش چه کاری انجام دهد و این بخش ها چگونه با هم ارتباط داشته باشند.
در یک سیستم نرم افزاری، موارد زیر در معماری مشخص می شوند:
سیستم از چه بخش هایی تشکیل شود
هر بخش چه مسئولیتی داشته باشد
بخش ها چگونه با یکدیگر ارتباط برقرار کنند
داده و مدل در کجا نگهداری شوند
در صورت خرابی یک قسمت چه اتفاقی رخ دهد
برای مثال کنترل های امنیتی در کدام قسمت ها قرار گیرند
در سیستم های هوش مصنوعی، معماری فقط به کد برنامه محدود نمی شود. داده آموزشی، مدل، حافظه، ابزار های بیرونی، سیاست های امنیتی، استقرار و پایش نیز جزو معماری در نظر گرفته می شوند. در مقالات بررسی شده نشان داده می شود که کیفیت یک سیستم هوشمند فقط به قدرت مدل وابسته نیست و ساختار نرم افزاری اطراف مدل نیز اهمیت زیادی دارد. [1][3][4]
۱-۲. الگوی معماری چیست؟
الگوی معماری یک راه حل کلی و قابل استفاده دوباره برای مسئله ای است که در سیستم های مختلف تکرار می شود.
برای مثال، در یک اداره همه نامه ها می توانند ابتدا وارد دبیرخانه شوند و بعد به بخش مناسب فرستاده شوند. در نرم افزار نیز درخواست ها می توانند ابتدا از یک دروازه مشخص عبور داده شوند تا هویت، مجوز و مقصد آن ها بررسی شود.
الگوی معماری یک برنامه آماده و ثابت نیست. معمولا در هر الگو موارد زیر مشخص می شوند:
مسئله چیست
در چه شرایطی رخ می دهد
راه حل کلی چیست
چه مزایایی دارد استفاده از این الگو
و چه هزینه ها یا پیامدهای منفی ای ایجاد می کند
بنابراین، انتخاب یک الگو به معنی انتخاب قطعی بهترین راه حل نیست. هر الگو باید با نیاز واقعی سیستم مقایسه شود و سپس انتخاب شود. [1][3]
۱-۳. هوش مصنوعی چه تفاوتی با نرم افزار معمولی دارد؟
در نرم افزار معمولی، بیشتر رفتار ها از قبل توسط برنامه نویس مشخص می شوند. برای مثال، می توان یک قانون روشن برای ورود کاربر تعریف کرد:
اگر رمز عبور اشتباه بود ← ورود کاربر رد شود.
در یادگیری ماشین، بخشی از رفتار از روی داده یاد گرفته می شود. برای مثال، همه قوانین تشخیص تصویر به صورت دستی نوشته نمی شوند و مدل با دیدن نمونه های آموزشی، الگو های لازم را یاد می گیرد.
به همین دلیل، نتیجه یک سیستم هوش مصنوعی فقط به کد وابسته نیست. کیفیت داده، نسخه مدل، تنظیمات آموزش و شرایط اجرا نیز روی نتیجه اثر می گذارند. در نتیجه، آزمایش، نگهداری، نسخه بندی و پایش این سیستم ها معمولا سخت تر از نرم افزار های کاملا قاعده محور است. [4]
۱-۴. عامل هوشمند یا Agentic AI چیست؟
بعضی سیستم های جدید فقط به یک سوال پاسخ نمی دهند. در این سیستم ها یک هدف دریافت می شود، برای آن برنامه ساخته می شود، از حافظه استفاده می شود و در صورت نیاز ابزار های بیرونی فراخوانی می شوند. به این نوع سیستم ها عامل هوشمند گفته می شود.
برای مثال، یک مدل زبانی معمولی می تواند درباره رزرو سفر توضیح بدهد. اما یک عامل هوشمند می تواند گزینه ها را بررسی کند، نتیجه را به کاربر نشان دهد و در صورت داشتن مجوز، از ابزار رزرو استفاده کند.
چون عامل می تواند عمل واقعی انجام دهد، کنترل بیشتری در معماری لازم است. نباید اجازه داده شود هر ابزار یا هر عملیات حساسی بدون بررسی مجوز اجرا شود. [6][7]
۱-۵. چرا امنیت در این سیستم ها اهمیت زیادی دارد؟
امنیت در سیستم های مبتنی بر هوش مصنوعی فقط به جلوگیری از ورود افراد غیر مجاز محدود نمی شود. چند موضوع اصلی باید هم زمان بررسی شوند:
محرمانگی: آیا اطلاعات خصوصی کاربران قابل مشاهده یا استخراج است؟
یکپارچگی: آیا داده، مدل یا سیاست های سیستم می توانند به صورت مخرب تغییر داده شوند؟
دسترس پذیری: آیا خرابی یک جزء باعث توقف کل سیستم می شود؟
ایمنی رفتاری: آیا مدل ممکن است پاسخ خطرناک یا نامناسب تولید کند؟
کنترل اختیار: آیا عامل می تواند بدون مجوز، عملیات حساس انجام دهد؟
قابلیت حسابرسی: اگر مشکلی رخ دهد، آیا می توان فهمید کدام مدل، داده، ابزار در ایجاد آن نقش داشته اند؟
در مقالات، تهدید هایی مانند مسموم سازی مدل، استخراج اطلاعات خصوصی، تزریق دستور، استفاده نادرست از ابزار و هماهنگی ناموفق بین عامل ها بررسی می شوند. [1][5][7]
۲. دسته بندی کلی مقالات
مقالات ضمیمه شده از نظر هدف و روش پژوهش یکسان نیستند. در بعضی مقاله ها منابع قبلی مرور می شوند، در بعضی معماری مرجع پیشنهاد می شود، در بعضی نمونه اولیه ساخته می شود و در برخی دیگر آزمایش یا شبیه سازی انجام می شود.
برای منظم شدن مسیر گزارش، مقالات در چهار گروه کلی دسته بندی می شوند:
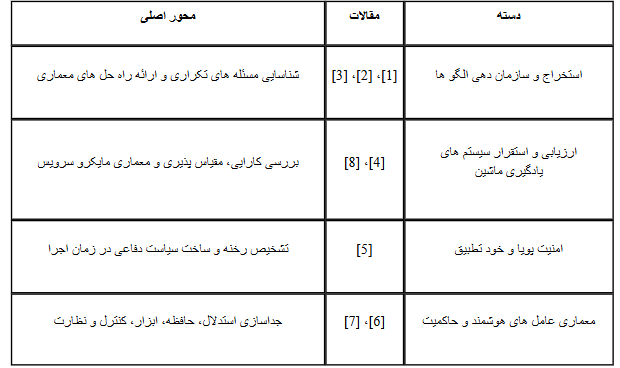
این گروه ها کاملا جدا از هم نیستند. برای مثال، مقاله یادگیری فدرال هم الگو های معماری را بررسی می کند و هم به حریم خصوصی مربوط است. مقاله مایکرو سرویس نیز علاوه بر مقیاس پذیری، به جداسازی و کنترل ارتباط ها توجه دارد.
۳. دسته نخست: استخراج و سازمان دهی الگوهای معماری
۳-۱. مقاله نخست: الگوهای معماری یادگیری فدرال
هدف و مسئله مورد بررسی
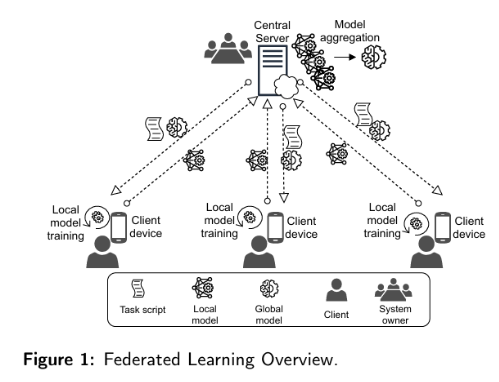
در مقاله نخست، معماری سیستم های یادگیری فدرال بررسی می شود. در این روش، داده خام کاربران به یک مرکز واحد فرستاده نمی شود. هر دستگاه مدل را با داده محلی خود آموزش می دهد و فقط نتیجه آموزش برای ترکیب با نتیجه دستگاه های دیگر ارسال می شود.
برای مثال، مدل پیش بینی کلمه در صفحه کلید گوشی می تواند با داده همان گوشی بهتر شود، بدون این که متن کامل کاربر برای سرور فرستاده شود.
با این روش، بخشی از حریم خصوصی حفظ می شود؛ اما مشکلات جدیدی هم ایجاد می شوند. دستگاه ها توان و کیفیت ارتباط یکسانی ندارند، داده ها با هم متفاوت هستند، بعضی دستگاه ها در میانه کار قطع می شوند و ممکن است یک دستگاه نتیجه نادرست یا مخرب ارسال کند. سرور مرکزی نیز می تواند به یک نقطه مهم برای خرابی یا حمله تبدیل شود. [1]
مراحل و روش انجام پژوهش
در روش پژوهش، ابتدا مطالعات علمی مرتبط به صورت نظام مند بررسی می شوند. سپس منابع جدیدتر و نمونه های واقعی نیز بررسی می شوند. بعد از آن، مراحل زیر انجام می شوند:
مسئله های تکرار شونده در سیستم های یادگیری فدرال استخراج می شوند
راه حل های مشابه در کنار هم قرار داده می شوند
راه حل ها به صورت الگو های معماری نوشته می شوند
هر الگو به بخش مناسب چرخه عمر مدل متصل می شود
برای هر الگو، مسئله، راه حل، مزایا، محدودیت ها و نمونه کاربرد توضیح داده می شود. [1]
رویکردهای اصلی مقاله
الگو های اصلی مقاله در چهار بخش ساده دسته بندی می شوند:
مدیریت دستگاه های مشارکت کننده
در این بخش، اطلاعات دستگاه ها ثبت می شود، دستگاه های مناسب برای هر مرحله آموزش انتخاب می شوند و دستگاه های مشابه می توانند در یک گروه قرار داده شوند.
ثبت اطلاعات کمک می کند دستگاه های قطع شده، ناموفق یا مشکوک شناسایی شوند. با این حال، اگر اطلاعات زیادی از دستگاه نگهداری شود، خود این اطلاعات می توانند برای حریم خصوصی مشکل ایجاد کنند.
انتخاب دستگاه های مناسب می تواند روند آموزش را بهتر کند. اما اگر دستگاه های ضعیف همیشه کنار گذاشته شوند، ممکن است داده بعضی گروه های کاربران کمتر در مدل دیده شود.
مدیریت مدل
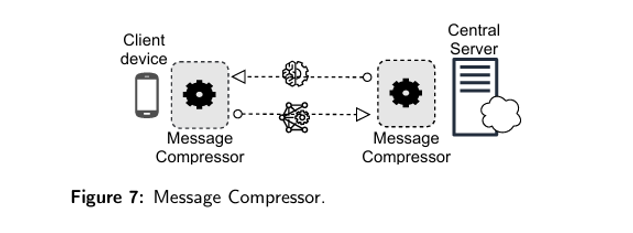
در این بخش، حجم پیام های مدل کاهش داده می شود، نسخه های مختلف مدل ثبت می شوند، افت عملکرد تشخیص داده می شود و مدل مناسب برای استقرار انتخاب می شود.
تصویر زیر یکی از الگو های این بخش را نشان می دهد که در آن حجم پیام مدل پیش از ارسال کاهش داده می شود. ثبت نسخه های مدل نیز مهم است، چون در صورت بروز مشکل باید بتوان مشخص کرد کدام نسخه یا کدام به روز رسانی در ایجاد مشکل نقش داشته است.
مدیریت آموزش
در بخش آموزش، تفاوت بین داده کاربران در نظر گرفته می شود. همچنین روش هایی برای مشارکت بهتر دستگاه ها بررسی می شوند تا آموزش مدل فقط بر اساس داده یک گروه محدود انجام نشود.
در مقاله هشدار داده می شود که سازوکار پاداش هم می تواند مورد سوء استفاده قرار گیرد. ممکن است یک مشارکت کننده برای دریافت پاداش، نتیجه نادرست ارسال کند و روند آموزش مدل جهانی را خراب کند.
مدیریت تجمیع مدل
تجمیع مدل می تواند به شکل نا هم زمان، غیر متمرکز، سلسله مراتبی یا امن انجام شود.
در حالت نا هم زمان، سرور منتظر پاسخ همه دستگاه ها نمی ماند و با رسیدن به روز رسانی های جدید، کار ادامه داده می شود.
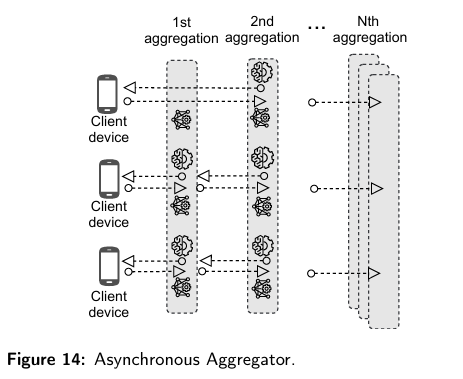
در حالت غیر متمرکز، کار تجمیع فقط بر عهده یک سرور نیست و بین چند گره تقسیم می شود. در این روش خطر خرابی یک نقطه واحد کمتر می شود، اما هماهنگی بین گره ها سخت تر می شود.
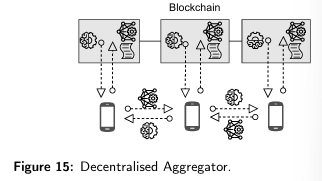
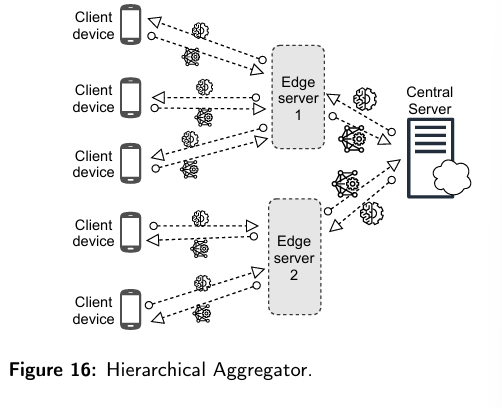
در حالت سلسله مراتبی، یک لایه میانی نزدیک تر به دستگاه ها قرار داده می شود تا بخشی از ترکیب مدل ها را انجام دهد و بعد نتیجه به لایه مرکزی فرستاده شود.
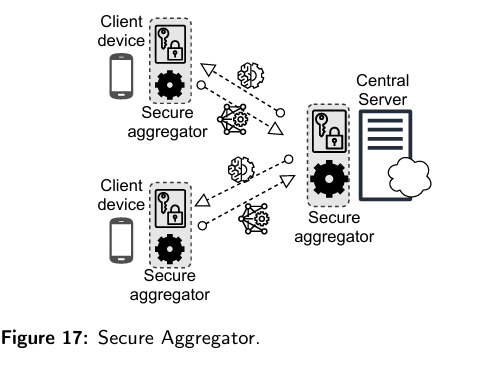
در تجمیع امن، از روش های رمزنگاری و محاسبه محرمانه استفاده می شود تا اطلاعات خصوصی از روی به روز رسانی های مدل تا حد ممکن قابل استخراج نباشد. این روش امنیت را بیشتر می کند، اما پردازش و ارتباط بیشتری لازم دارد. [1]
نتیجه و تحلیل نهایی
در مقاله نشان داده می شود که فقط نفرستادن داده خام برای حفظ حریم خصوصی کافی نیست. اطلاعات دستگاه، نسخه مدل، پارامتر های آموزش و روش تجمیع نیز باید محافظت شوند.
دستاورد اصلی مقاله، ارائه یک نقشه معماری برای چرخه یادگیری فدرال است. البته همه الگو ها در یک سیستم واحد آزمایش نمی شوند؛ بنابراین بیشتر به عنوان راهنمای طراحی قابل استفاده هستند.
۳-۲. مقاله دوم: معماری سرویس گرای برنامه ریزی هوش مصنوعی
هدف و مسئله مورد بررسی
برنامه ریزی هوش مصنوعی یعنی مجموعه اقدام هایی پیدا شود که سیستم را از وضعیت فعلی به یک هدف مشخص برسانند.
برای مثال، اگر یک ربات باید بسته ای را به اتاق دیگری ببرد، وضعیت فعلی، مقصد و کار هایی که قابل انجام هستند بررسی می شوند.
در مقاله توضیح داده می شود که ابزار های برنامه ریزی در محیط پژوهشی می توانند مناسب باشند، اما استفاده از آن ها در نرم افزار های واقعی ساده نیست. دلیل اصلی این است که اجزای این ابزار ها معمولا به هم وابستگی زیادی دارند و به راحتی با سیستم های دیگر ترکیب نمی شوند. [2]
مراحل و روش انجام پژوهش
ابتدا ابزار ها و سامانه های برنامه ریزی موجود بررسی می شوند و قابلیت های تکرار شونده آن ها استخراج می شوند.
سپس مراحل زیر انجام می شوند:
قابلیت ها از نظر کاربرد و نقش فنی دسته بندی می شوند
برای هر قابلیت، یک سرویس جدا در نظر گرفته می شود
ارتباط بین سرویس ها با پیام انجام می شود
یک نمونه اولیه ساخته می شود
معماری از نظر استفاده پذیری، تعامل پذیری و استفاده دوباره به صورت کیفی بررسی می شود
رویکرد پیشنهادی
قابلیت های سیستم در سه گروه کلی قرار داده می شوند:
قابلیت های هسته ای: مدل سازی مسئله، ساخت برنامه و اجرای آن.
قابلیت های پشتیبان: جست و جو، اعتبارسنجی، تبدیل داده، مدیریت و پایش.
قابلیت های تکمیلی: ذخیره سازی، یادگیری، توضیح نتیجه، واکنش به تغییر و نمایش اطلاعات.
در معماری پیشنهادی، این قابلیت ها به صورت سرویس های جدا طراحی می شوند. هر سرویس یک مسئولیت روشن دارد و از طریق پیام با سرویس های دیگر ارتباط برقرار می کند.
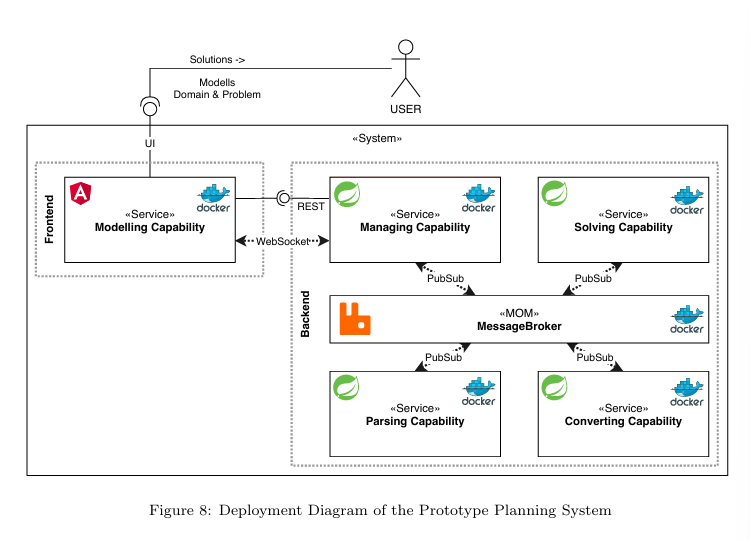
می توان این ساختار را به یک آشپزخانه تشبیه کرد که سفارش گیری، پخت، کنترل کیفیت و تحویل در بخش های جدا انجام می شوند. در این حالت، تغییر یک بخش لزوما باعث تغییر کل سیستم نمی شود.
نتیجه و تحلیل نهایی
در نمونه اولیه نشان داده می شود که معماری سرویس گرا می تواند ترکیب و جایگزینی قابلیت ها را آسان تر کند. رابط های مشخص نیز ارتباط بین بخش های مختلف را ساده تر می کنند.
با این حال، تبدیل ابزار های قدیمی به این ساختار ساده نیست، چون بخش های داخلی آن ها معمولا به هم وابستگی زیادی دارند. ارزیابی مقاله بیشتر کیفی است و امنیت به صورت گسترده آزمایش نمی شود. با این وجود، جداسازی سرویس ها می تواند محدوده خرابی را کوچک تر کند و کنترل هر بخش را آسان تر سازد. [2]
۳-۳. مقاله سوم: مرور الگوهای طراحی سیستم های مبتنی بر هوش مصنوعی
هدف و مسئله مورد بررسی
در مقاله سوم، پراکندگی الگو های طراحی سیستم های هوش مصنوعی بررسی می شود. بعضی الگو ها در مقالات علمی، بعضی در کتاب ها و بعضی در منابع عملی معرفی شده اند. به همین دلیل، پیدا کردن و مقایسه آن ها برای طراح سیستم همیشه ساده نیست.
هدف مقاله این است که این الگو ها در یک مجموعه منظم جمع شوند تا طراحان بتوانند راحت تر الگوی مناسب را پیدا و با گزینه های دیگر مقایسه کنند.
مراحل و روش انجام پژوهش
برای این کار، یک مرور چند جانبه انجام می شود؛ یعنی هم منابع دانشگاهی و هم منابع عملی بررسی می شوند.
فرایند پژوهش به شکل زیر انجام می شود:
منابع علمی و عمومی جست و جو می شوند
منابع نامرتبط حذف می شوند
تصمیم های انتخاب منابع توسط چند پژوهشگر بررسی می شوند
منابع ارجاع داده شده و منابعی که به آن ها استناد شده نیز بررسی می شوند
نام الگو، مسئله، راه حل، پیامد ها و نمونه کاربرد استخراج می شوند
در پایان، الگو ها در یک مخزن وب قرار داده می شوند
برای پذیرفته شدن یک الگو، فقط نام آن کافی نیست و باید مسئله و راه حل آن نیز توضیح داده شود.
نتایج اصلی
در نتیجه، مجموعه بزرگی از الگو های معماری، استقرار، پیاده سازی، امنیت، فرایند و آزمایش شناسایی می شوند.
بخشی از این الگو ها از مهندسی نرم افزار سنتی گرفته و برای سیستم های هوش مصنوعی سازگار می شوند. بخشی دیگر نیز برای نیاز های خاص سیستم های هوشمند پیشنهاد می شوند.
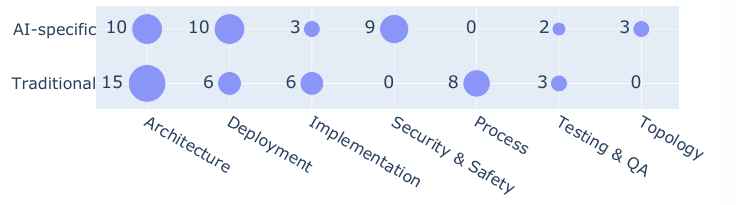
در بخش امنیت، ایده مهم این است که خروجی مدل نباید مستقیما به یک عمل حساس تبدیل شود. بهتر است یک لایه کنترلی بین مدل و عمل واقعی قرار داده شود تا نتیجه قبل از اجرا بررسی شود.
برای مثال، اگر یک مدل پزشکی نتیجه ای تولید کند، بهتر است نتیجه پیش از تبدیل شدن به یک تصمیم درمانی، با قواعد مشخص یا بررسی انسانی کنترل شود.
نتیجه و تحلیل نهایی
دستاورد اصلی مقاله، ارائه یک نمای منظم از فضای الگو های طراحی و ایجاد یک مخزن قابل جست و جو است.که چند نمونه از این وبسایت های مخزن حاصل از مقاله در لیست زیر ذکر شده است:
https://vuejs.org
https://vuetifyjs.com
https://github.com/SWE4AI/ai-patterns
https://swe4ai.github.io/ai-patterns
https://csvjson.com/csv2json
نمونه ای از این مخزن در تصویر زیر دیده می شود.
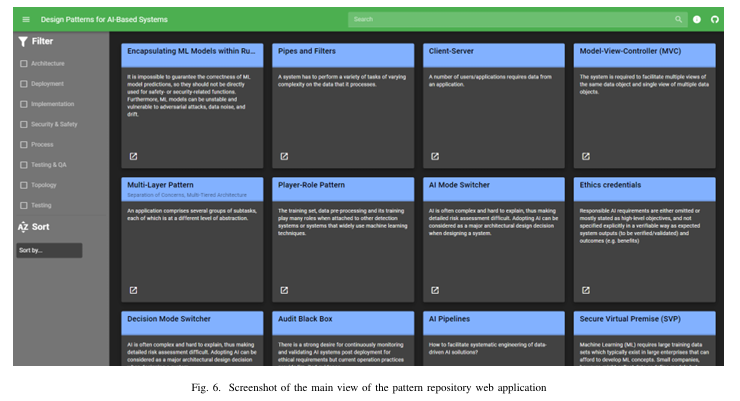
با این حال، همه الگو های جمع آوری شده از نظر شواهد تجربی در یک سطح نیستند. بعضی در چند منبع تکرار می شوند، اما بعضی فقط در منابع محدود دیده می شوند و برای بعضی نیز نمونه پیاده سازی روشنی ارائه نمی شود.
بنابراین، این مخزن بیشتر برای پیدا کردن گزینه های طراحی و شروع بررسی مناسب است. وجود یک الگو در مخزن به معنی برتری قطعی یا امنیت تضمین شده آن نیست. [3]
۴. دسته دوم: ارزیابی و استقرار سیستم های یادگیری ماشین
۴-۱. مقاله چهارم: چارچوب کمی ارزیابی الگوهای معماری
هدف و مسئله مورد بررسی
در بسیاری از پروژه ها گفته می شود یک معماری سریع تر یا مقیاس پذیر تر است، اما این ادعا همیشه با اندازه گیری دقیق همراه نیست.
در مقاله چهارم، روشی پیشنهاد می شود تا اثر الگو های معماری بر کارایی و مقیاس پذیری سیستم یادگیری ماشین با معیار های مشخص بررسی شود. [4]
مراحل و روش انجام پژوهش
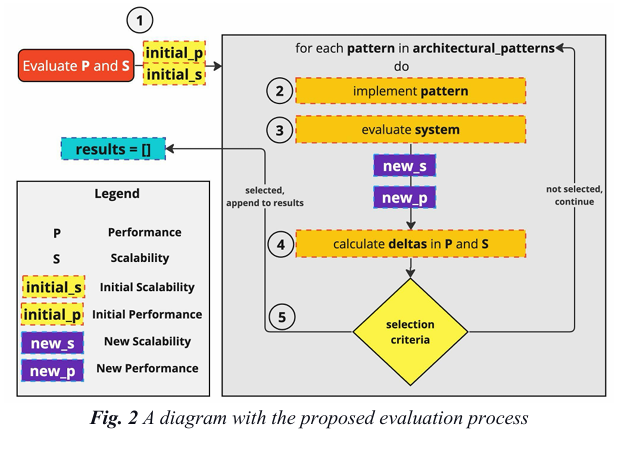
فرایند ارزیابی به صورت زیر انجام می شود:
ابتدا یک سیستم پایه ساخته و اندازه گیری می شود
سپس الگوی معماری مورد نظر روی سیستم اعمال می شود
سیستم جدید در همان شرایط دوباره آزمایش می شود
نتایج قبل و بعد با هم مقایسه می شوند
در صورت مناسب بودن نتیجه، الگو برای آن نیاز پذیرفته می شود
در مقاله، این روش برای مقایسه معماری یکپارچه، معماری مایکرو سرویسی و بهینه سازی مدل به کار برده می شود. روند کلی ارزیابی در شکل زیر نشان داده شده است.
معیارهای اصلی
برای ساده شدن مقایسه، چند معیار در دو شاخص اصلی ترکیب می شوند.
ضریب مقیاس پذیری
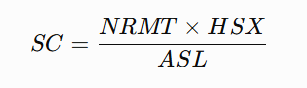
در این رابطه:
SC شاخص کلی مقیاس پذیری است.
NRMT بیشترین تعداد درخواست هم زمان است که سیستم قبل از افت محسوس عملکرد می تواند مدیریت کند.
HSX نشان می دهد اضافه کردن نمونه یا سرور جدید چقدر سریع، ساده و کم هزینه انجام می شود.
ASL میانگین فشار وارد شده به منابعی مانند پردازنده و حافظه است.
برای استفاده از این رابطه، ابتدا تعداد درخواست ها کم کم افزایش داده می شود. نقطه ای که بعد از آن عملکرد سیستم دیگر به شکل عادی رشد نمی کند، به عنوان حد ظرفیت در نظر گرفته می شود.
بعد بررسی می شود که افزایش ظرفیت سیستم چقدر ساده و کم هزینه است. در پایان، ظرفیت سیستم با میزان مصرف منابع مقایسه می شود.
اگر سیستم بتواند درخواست بیشتری را با مصرف منابع مناسب مدیریت کند و راحت تر توسعه داده شود، وضعیت مقیاس پذیری آن بهتر در نظر گرفته می شود. [4]
ضریب کارایی
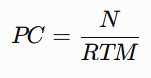
در این رابطه:
PC شاخص کارایی پاسخ گویی است.
N تعداد درخواست های استفاده شده در آزمایش است.
RTM میانه زمان پاسخ درخواست ها است.
برای به دست آوردن میانه، زمان پاسخ ها از سریع ترین تا کند ترین مرتب می شوند و مقدار وسط انتخاب می شود. به این ترتیب، چند پاسخ خیلی کند نتیجه کلی را بیش از حد تغییر نمی دهند.
برای مقایسه منصفانه، تعداد درخواست ها باید در آزمایش های مختلف یکسان نگه داشته شود. هرچه زمان پاسخ کمتر باشد، کارایی بهتر در نظر گرفته می شود. [4]
نتایج و تحلیل نهایی
در مطالعه موردی نشان داده می شود که تقسیم سیستم یکپارچه به سرویس های مستقل، توسعه و مقیاس دادن بخش های مختلف را آسان تر می کند. با این حال، سرعت خود مدل تغییر زیادی نمی کند.
در مقابل، وقتی خود مدل بهینه می شود، زمان پاسخ و مصرف پردازشی بهتر می شوند.
از این نتیجه یک نکته ساده به دست می آید:
تغییر معماری و بهینه سازی مدل، دو مشکل متفاوت را هدف می گیرند.
معماری مایکرو سرویسی بیشتر برای جداسازی، استقرار و رشد بخش ها مفید است، در حالی که بهینه سازی مدل بیشتر روی سرعت محاسبه اثر می گذارد.
همچنین در مقاله تاکید می شود که این معیار ها همه ویژگی های سیستم را پوشش نمی دهند. امنیت، دقت مدل، قابلیت نگهداری و قابلیت اطمینان باید جداگانه بررسی شوند. [4]
۴-۲. مقاله هشتم: معماری مایکرو سرویسی برای سیستم های یادگیری ماشین
هدف و مسئله مورد بررسی
در یک سیستم یکپارچه، دریافت داده، آماده سازی، آموزش مدل، پیش بینی و پایش ممکن است همگی در یک برنامه بزرگ قرار داده شوند. در این حالت، تغییر یا خرابی یک بخش می تواند روی بخش های دیگر نیز اثر بگذارد.
در مقاله هشتم بررسی می شود که آیا تقسیم این چرخه به سرویس های کوچک تر می تواند توسعه، نگهداری و مقیاس پذیری را بهتر کند یا نه. [8]
مراحل و روش انجام پژوهش
روش پژوهش در سه بخش انجام می شود:
نمونه های صنعتی و پژوهشی مرور می شوند
یک چارچوب مایکرو سرویسی برای چرخه یادگیری ماشین پیشنهاد می شود
یک شبیه سازی ساده برای مقایسه معماری یکپارچه و مایکرو سرویسی انجام می شود
همچنین یک سامانه پیشنهاد دهی بزرگ به عنوان مطالعه موردی بررسی می شود تا نقش سرویس های مستقل در پردازش داده، آموزش و ارائه نتیجه بهتر توضیح داده شود.
معماری پیشنهادی
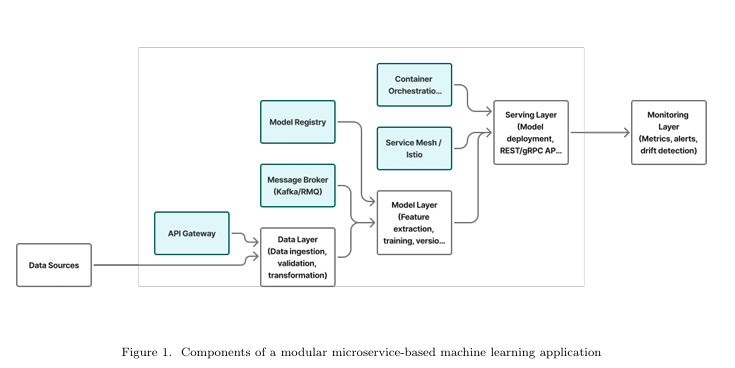
چارچوب پیشنهادی در چند لایه ساده در نظر گرفته می شود:
لایه داده: جمع آوری، پاک سازی و آماده سازی اطلاعات.
لایه مدل: آماده سازی ویژگی ها، آموزش، اعتبارسنجی و نسخه بندی مدل.
لایه ارائه مدل: دریافت درخواست و تولید پیش بینی.
لایه پایش: مشاهده عملکرد، ثبت خطا و تشخیص تغییر رفتار داده یا مدل.
ارتباط بین این بخش ها از طریق رابط های مشخص انجام می شود و هر سرویس می تواند جداگانه توسعه، جایگزین یا مقیاس داده شود.
همچنین یک ورودی کنترل شده برای درخواست ها، ثبت نسخه مدل، ارتباط نا هم زمان و جداسازی کار های امنیتی و پایشی در نظر گرفته می شوند.
نتایج و تحلیل نهایی
در شبیه سازی نشان داده می شود که در معماری یکپارچه، با زیاد شدن درخواست ها فشار بیشتری روی بخش مرکزی وارد می شود. در معماری مایکرو سرویسی، هر بخش می تواند مستقل رشد کند و در نتیجه بعضی گلوگاه ها کمتر می شوند.
با این حال، مدل استفاده شده در شبیه سازی ساده است. در یک سیستم واقعی، هزینه شبکه، هماهنگی سرویس ها، خرابی، امنیت و ناسازگاری نسخه ها نیز باید بررسی شوند.
در مقاله نیز توضیح داده می شود که افزایش تعداد سرویس ها می تواند پیدا کردن خطا، هماهنگ نگه داشتن نسخه ها و کنترل امنیت ارتباط ها را سخت تر کند. [8]
۵. دسته سوم: امنیت پویا و خود تطبیق
۵-۱. مقاله پنجم: معماری خود بهبوددهنده ایمنی مدل های زبانی
هدف و مسئله مورد بررسی
بسیاری از دفاع های امنیتی مدل های زبانی پیش از انتشار طراحی می شوند و تا زمان به روز رسانی بعدی ثابت باقی می مانند.
اگر پس از انتشار، روش حمله جدیدی پیدا شود، ممکن است سیستم تا زمان بررسی و اصلاح انسانی در برابر آن آسیب پذیر بماند.
هدف مقاله پنجم این است که معماری بتواند در زمان اجرا کار های زیر را انجام دهد:
پاسخ خطرناک تشخیص داده شود
نوع شکست بررسی شود
یک سیاست دفاعی جدید ساخته شود
سیاست جدید بدون آموزش دوباره مدل اصلی فعال شود. [5]
مراحل و روش انجام پژوهش
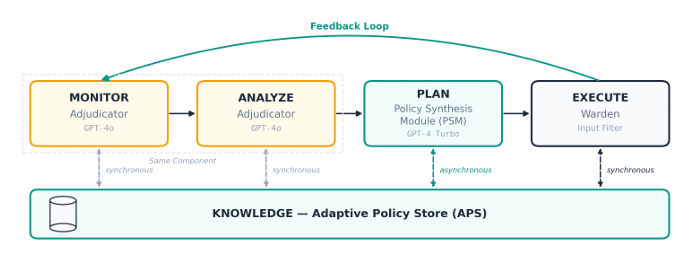
برای این هدف، یک حلقه بازخورد بسته بر اساس مدل MAPE-K طراحی می شود:
پایش: دستور و پاسخ مشاهده می شوند
تحلیل: بررسی می شود که رخنه رخ داده است یا نه
برنامه ریزی: سیاست دفاعی جدید ساخته می شود
اجرا: سیاست روی درخواست های بعدی اعمال می شود
دانش: سیاست های ساخته شده ذخیره می شوند
بعد از طراحی معماری، آن مدل با حملات، درخواست های سالم و چند خانواده مدل آزمایش می شود. بعضی اجزای دفاع نیز جداگانه حذف می شوند تا نقش هر بخش بهتر مشخص شود. [5]
جریان معماری
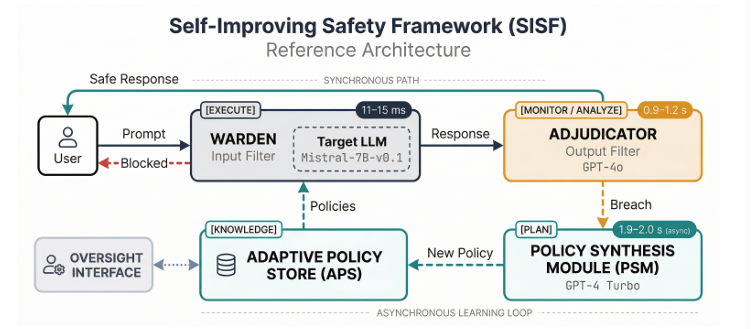
ابتدا ورودی با سیاست های امنیتی محلی بررسی می شود. اگر ورودی مشکوک نباشد، به مدل داده می شود. پاسخ مدل نیز قبل از تحویل به کاربر بررسی می شود.
اگر پاسخ خطرناک تشخیص داده شود، پاسخ مسدود می شود و اطلاعات این شکست برای ساخت یک سیاست جدید فرستاده می شود. سیاست جدید در مخزن دفاعی ذخیره می شود.
به این شکل، تجربه یک حمله برای بهتر شدن دفاع در برابر حملات مشابه بعدی استفاده می شود.
دو نوع سیاست دفاعی- امنیتی
سیاست متنی یا ابتکاری: الگو های مشخص نوشتاری بررسی می شوند. این روش سریع است، اما ممکن است یک درخواست سالم با ظاهر مشابه نیز اشتباه مسدود شود.
سیاست معنایی: معنی کلی درخواست با نمونه های خطرناک مقایسه می شود. این روش برای عبارت های متفاوت با مفهوم مشابه مناسب تر است، اما پردازش بیشتری لازم دارد.
نتایج و تحلیل نهایی
در آزمایش ها نشان داده می شود که معماری خود تطبیق می تواند بیشتر حملات بررسی شده را متوقف کند و بعضی سیاست های ساخته شده روی حملات جدید یا مدل های دیگر نیز قابل استفاده هستند.
همچنین نشان داده می شود که دفاع چند لایه از تکیه بر یک فیلتر ثابت بهتر عمل می کند. با این حال، فیلتر سخت گیر می تواند درخواست سالم را هم اشتباه مسدود کند.
وقتی یکی از دو نوع سیاست حذف می شود، مشخص می شود که هیچ کدام به تنهایی کافی نیستند. سیاست متنی پوشش بیشتری دارد ولی خطای بیشتری هم ایجاد می کند. سیاست معنایی دقیق تر است، اما همه حملات را زود متوقف نمی کند.
چند محدودیت مهم نیز در مقاله مطرح می شوند:
بررسی خروجی می تواند زمان پاسخ را بیشتر کند
ساخت سیاست به مدل های بیرونی وابسته است
همه حملات چند مرحله ای و غیر مستقیم بررسی نمی شوند
تعداد سیاست ها با گذشت زمان می تواند زیاد شود
ممکن است مهاجم تلاش کند سیستم را به ساخت سیاست بیش از حد سخت گیرانه وادار کند
در نتیجه، دفاع خودکار بهتر است همراه با نظارت انسانی استفاده شود. سیاست های ساخته شده باید قابل بازبینی و در صورت نیاز قابل غیرفعال شدن باشند و به صورت دوره ای نیز ارزیابی شوند. [5]
۶. دسته چهارم: معماری عامل های هوشمند و حاکمیت
۶-۱. مقاله ششم: الگو های طراحی عامل محور با رویکرد نظریه سیستم ها
هدف و مسئله مورد بررسی
در بسیاری از عامل های هوشمند، مدل، حافظه و چند ابزار خیلی سریع به هم متصل می شوند. این روش در کار های ساده ممکن است جواب بدهد، اما در وظایف طولانی یا حساس می تواند شکننده باشد.
مشکلاتی مانند توهم، استدلال ضعیف، استفاده اشتباه از ابزار، بازیابی ضعیف از خطا و هماهنگی نامناسب بین عامل ها می توانند اعتماد به سیستم را کم کنند.
هدف مقاله ششم این است که یک ساختار منظم برای تحلیل عامل ارائه شود و الگو های طراحی قابل استفاده دوباره از آن استخراج شوند. [6]
مراحل و روش انجام پژوهش
ابتدا مشکلات عامل ها در چند گروه کلی دسته بندی می شوند:
مشکل در ساخت و نگهداری تصویر درست از محیط
مشکل در استدلال و تصمیم گیری
خطا در اجرای عمل و استفاده از ابزار
مشکل در یادگیری و حاکمیت
مشکل در ارتباط و همکاری
بعد عامل به چند زیر سیستم اصلی تقسیم می شود. بر اساس رابطه این زیر سیستم ها، الگو های طراحی ارائه می شوند. در پایان نیز یک معماری عامل شناخته شده به صورت کیفی بررسی می شود تا ضعف های آن و راه های اصلاح مشخص شوند.
زیرسیستم های اصلی
استدلال و مدل جهان: درک عامل از محیط و تصمیم های اصلی در این بخش نگهداری می شوند.
ادراک و زمینه سازی: ورودی خام بررسی و به اطلاعات قابل استفاده تبدیل می شود.
اجرای عمل: برنامه به عملیات واقعی تبدیل می شود.
یادگیری و سازگاری: از بازخورد استفاده می شود تا رفتار آینده بهتر شود.
ارتباط بین عامل ها: پیام رسانی و همکاری با عامل های دیگر مدیریت می شود.
این ساختار نشان می دهد عامل بهتر است به صورت یک مدل بزرگ و یکپارچه دیده نشود و برای هر مسئولیت مرز مشخصی در نظر گرفته شود.
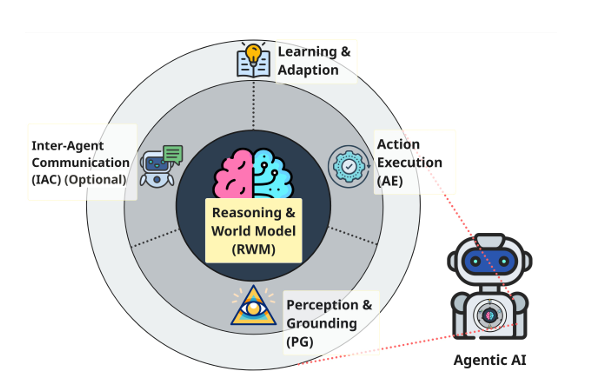
الگو های اصلی
الگو های مقاله را می توان در چند گروه ساده قرار داد:
اعتبارسنجی و حافظه: ورودی پیش از رسیدن به هسته عامل بررسی می شود، وضعیت ثبت می شود و اطلاعات لازم در زمان مناسب بازیابی می شوند.
برنامه ریزی و تصمیم: هدف به بخش های کوچک تر تقسیم می شود و برای هر مرحله اقدام مناسب انتخاب می شود.
اجرا و ابزار: عمل از طریق یک لایه کنترل شده انجام می شود و ابزار های بیرونی با رابط محدود در دسترس قرار می گیرند.
یادگیری و کنترل: نتیجه کار بررسی می شود، تجربه های مفید ذخیره می شوند و رفتار عامل با سیاست ها و محدودیت ها مقایسه می شود.
مطالعه موردی و نتیجه نهایی
در مطالعه کیفی مقاله نشان داده می شود که حلقه ساده «فکر، عمل و مشاهده» می تواند چند مشکل داشته باشد:
مشاهده ها بدون اعتبارسنجی وارد تصمیم گیری می شوند
حافظه و زمینه به صورت منظم مدیریت نمی شوند
برنامه بلند مدت روشنی وجود ندارد
بازیابی از خطای ابزار محدود است
تجربه شکست به دانش پایدار تبدیل نمی شود
برای رفع این مشکلات، استفاده از لایه های اعتبارسنجی، ثبت وضعیت، بازیابی زمینه، اجرای کنترل شده و باز اندیشی پیشنهاد می شود.
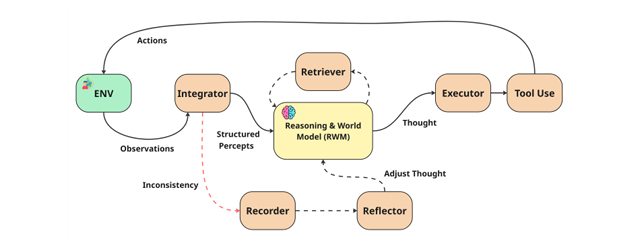
نتیجه اصلی مقاله، ارائه یک زبان مشترک برای طراحی عامل های منظم تر است. با این حال، چارچوب بیشتر مفهومی است و میزان بهبود امنیت یا قابلیت اطمینان آن با آزمایش کمی گسترده نشان داده نمی شود. [6]
۶-۲. مقاله هفتم: گذار از پاسخ گویی ساده به سیستم هدف محور
هدف و مسئله مورد بررسی
در مقاله هفتم توضیح داده می شود که ساختار «یک دستور، یک پاسخ» برای کار های ساده مناسب است، اما برای وظایف طولانی، ابزار محور و حساس کافی نیست.
وقتی سیستم باید چند مرحله تصمیم بگیرد، از حافظه استفاده کند یا روی محیط واقعی اثر بگذارد، لازم است استدلال از اجرا جدا شود و هر عمل زیر نظر سیاست مشخص انجام شود.
هدف مقاله، ارائه یک معماری مرجع برای عامل های قابل استفاده در محیط واقعی، بررسی چند ساختار چند عاملی و ارائه نکات سخت سازی امنیتی است. [7]
مراحل و روش انجام پژوهش
در ابتدا، نظریه های کلاسیک مربوط به عامل های واکنشی، برنامه ریز و ترکیبی بررسی می شوند.
بعد پژوهش های جدید در موضوعات زیر بررسی می شوند:
استفاده از ابزار
حافظه و بازیابی اطلاعات
برنامه ریزی چند مرحله ای
اصلاح تصمیم بر اساس نتیجه
همکاری چند عامل هوشمند
اسناد عملی سامانه های موجود نیز برای شناخت نیاز های زمان استقرار بررسی می شوند، اما از آن ها برای اثبات برتری عملکردی استفاده نمی شود.
معماری مرجع پیشنهادی
معماری مرجع مقاله از چند لایه تشکیل می شود:
رابط عامل: هدف و محدودیت های کاربر دریافت می شوند.
هسته شناختی: استدلال و پیشنهاد توسط مدل زبانی تولید می شوند.
لایه کنترل: برنامه، سیاست، وضعیت، تلاش دوباره، توقف و بازیابی خطا مدیریت می شوند.
لایه حافظه: زمینه کوتاه مدت، تجربه های گذشته و دانش پایدار نگهداری می شوند.
لایه ابزار: ابزار ها ثبت و نسخه بندی می شوند و از طریق رابط مشخص و محیط محدود اجرا می شوند.
حاکمیت و مشاهده پذیری: کنترل دسترسی، ثبت فعالیت، اعمال سیاست، محدودیت هزینه و ارزیابی در کل سیستم در نظر گرفته می شوند. [7]
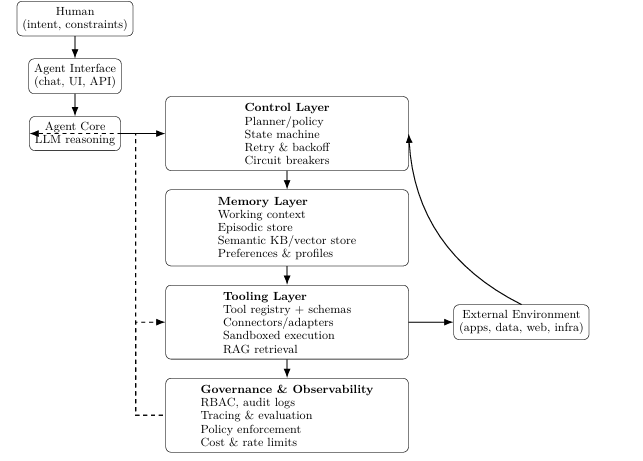
حلقه اجرای عامل
حلقه اجرای عامل به صورت زیر انجام می شود:
هدف کاربر دریافت می شود
وضعیت و حافظه لازم آماده می شوند
گام بعدی توسط مدل پیشنهاد می شود
پیشنهاد با سیاست های سیستم بررسی می شود
اگر مجاز باشد، ابزار در محیط کنترل شده اجرا می شود
نتیجه در وضعیت و حافظه ثبت می شود
این روند تا رسیدن به هدف یا توقف امن ادامه داده می شود
نکته اصلی این است که مدل نباید مستقیما ابزار را اجرا کند. بین مدل و ابزار باید یک لایه مشخص قرار داده شود تا ورودی، مجوز، محدودیت و نتیجه عملیات بررسی شوند.
امنیت و سخت سازی
اصول اصلی امنیتی مقاله در شکل زیر نشان داده می شوند و به صورت خلاصه شامل موارد زیر هستند:
حداقل اختیار: فقط ابزار ها و داده های لازم برای هر وظیفه در دسترس عامل قرار داده می شوند.
قرارداد نوع دار: ورودی، خروجی، پیش شرط و نسخه هر ابزار مشخص می شوند.
اجرای ایزوله: ابزار حساس در محیط محدود اجرا می شود تا خرابی آن به بخش های دیگر سرایت نکند.
دروازه سیاست: هر عمل دارای اثر واقعی پیش از اجرا بررسی می شود.
مدیریت اسرار: کلید ها و اطلاعات دسترسی داخل متن ورودی مدل قرار داده نمی شوند.
محدودیت اختیار: برای زمان، هزینه، تعداد مراحل و فراخوانی ابزار سقف در نظر گرفته می شود.
تایید انسانی: برای عملیات برگشت ناپذیر یا پر ریسک، تایید انسان در نظر گرفته می شود.
ثبت کامل مسیر: مدل، دستور، ابزار، تصمیم سیاستی، عملیات حافظه و نتیجه هر مرحله ثبت می شوند.
معماری چندعاملی
چند ساختار اصلی برای همکاری چند عامل بررسی می شوند:
مدیر و متخصصان: یک عامل، مسئله را تقسیم می کند و کار ها به عامل های تخصصی داده می شوند. ساختار روشن است، اما مدیر می تواند به گلوگاه تبدیل شود.
مسیریاب و حل کننده: ابتدا نوع مسئله تشخیص داده می شود و سپس به متخصص مناسب فرستاده می شود. اگر مسیریابی اشتباه باشد، نتیجه کل مسیر می تواند ضعیف شود.
سلسله مراتبی: چند سطح مدیریت در نظر گرفته می شود. در این حالت باید مراقب تغییر هدف اصلی یا ایجاد حلقه در واگذاری کار بود.
توزیع شده: مسئولیت بین عامل ها تقسیم می شود. انعطاف بیشتر می شود، اما هماهنگی و اعتماد سخت تر می شوند.
نتیجه و تحلیل نهایی
در مقاله نشان داده می شود که بلوغ عامل های هوشمند فقط با قوی تر شدن مدل به دست نمی آید. رابط های روشن، کنترل دسترسی، ثبت فعالیت و حاکمیت چند لایه نیز لازم هستند. همکاری چند عامل نیز زمانی مفید است که نقش ها و محدودیت ها مشخص باشند. این مقاله بیشتر نقش یک راهنمای معماری و چک لیست طراحی را دارد و آزمایش تجربی مستقیمی برای همه پیشنهاد ها ارائه نمی کند. [7]
۷. تحلیل تطبیقی و دسته بندی نهایی الگو ها
با کنار هم قرار دادن یافته های مقالات، الگو ها را می توان در یک ساختار چند لایه خلاصه کرد. این دسته بندی کمک می کند مشخص شود هر گروه از الگو ها کدام بخش از مسئله معماری و امنیت را پوشش می دهند.
۷-۱. لایه ساختار و جداسازی مسئولیت ها
این لایه مشخص می کند سیستم چگونه به بخش های کوچک تر و قابل کنترل تقسیم شود.
در معماری سرویس گرا، مایکرو سرویس، عامل های چند بخشی و سیستم های چند عاملی، یک اصل مشترک دیده می شود: مدل هوش مصنوعی نباید همه مسئولیت ها را به تنهایی انجام دهد.
استدلال، حافظه، اجرای ابزار، کنترل دسترسی، پایش و ذخیره اطلاعات بهتر است تا حد ممکن از هم جدا شوند. با این جداسازی، آزمایش و جایگزینی بخش ها ساده تر می شود و خرابی یک بخش کمتر به کل سیستم سرایت می کند. [2][6][7][8]
البته جداسازی بیش از حد هم مناسب نیست. اگر سیستم بدون نیاز واقعی به بخش های خیلی زیاد تقسیم شود، ارتباط ها، نسخه ها و تنظیمات بیشتر می شوند و مدیریت سیستم سخت تر می شود. بنابراین، جداسازی باید بر اساس مسئولیت واقعی هر بخش انجام شود.
۷-۲. لایه داده، مدل و قابلیت ردیابی
در مقالات تاکید می شود که اطلاعات مهم هر اجرا ثبت شوند. این اطلاعات می توانند شامل موارد زیر باشند:
نسخه داده
نسخه مدل
نسخه دستور
نسخه ابزار
دستگاه یا عامل مشارکت کننده
تصمیم های امنیتی
نتیجه هر مرحله
با ثبت این اطلاعات، پرسش های مهم زیر قابل پاسخ می شوند:
این خروجی با کدام مدل تولید شده است؟
مدل از کدام داده استفاده کرده است؟
چه ابزاری اجرا شده است؟
چه کسی اجازه اجرا داده است؟
و در صورت خرابی، به کدام نسخه باید بازگشت؟
در سیستم هوشمند، نسخه بندی فقط برای کد انجام نمی شود. داده، مدل، دستور، ابزار و تصمیم های امنیتی نیز می توانند رفتار سیستم را تغییر دهند و باید قابل ردیابی باشند. در این صورت، علت خطا بهتر پیدا می شود و بازگشت به نسخه سالم آسان تر خواهد بود. [1][6][7][8]
۷-۳. لایه حریم خصوصی و ارتباط امن
در مقاله یادگیری فدرال نشان داده می شود که داده خام می تواند در محل تولید باقی بماند و فقط نتیجه آموزش جابه جا شود. با این حال، پارامتر های مدل و اطلاعات دستگاه نیز می توانند حساس باشند.
به همین دلیل، برای حفظ حریم خصوصی معمولا چند روش در کنار هم استفاده می شوند:
حداقل سازی اطلاعات جمع آوری شده
کنترل دسترسی
ارتباط رمزگذاری شده
تجمیع امن
محدودیت نگهداری داده
هیچ روش واحدی همه خطر ها را حذف نمی کند. همچنین، افزایش کنترل های محرمانگی می تواند هزینه پردازش را بیشتر کند یا روی سرعت و کیفیت سیستم اثر بگذارد. [1][7]
۷-۴. لایه کنترل ابزار و اختیارات عامل هوشمند
هرچه سیستم از پاسخ ساده به انجام عمل واقعی نزدیک تر شود، کنترل اختیار مهم تر می شود. مدل می تواند اقدام را پیشنهاد دهد، اما اجرای آن باید از یک لایه کنترل عبور داده شود. در این لایه موارد زیر بررسی می شوند:
ابزار مجاز است یا خیر
کاربر یا عامل اجازه استفاده از آن را دارد یا خیر
ورودی ابزار معتبر است یا خیر
عملیات قابل بازگشت است یا خیر
آیا تأیید انسانی لازم است یا خیر
در مجموع، ابزار ها بهتر است از طریق رابط محدود، دروازه سیاست و محیط ایزوله اجرا شوند. برای کار های حساس نیز در صورت نیاز تایید انسانی در نظر گرفته می شود. [3][6][7]
۷-۵. لایه امنیت پویا و سازگاری
بررسی مقالات نشان می دهد امنیت فقط پیش از انتشار کافی نیست. داده و رفتار مدل تغییر می کنند و حملات جدید نیز ممکن است بعد از استقرار دیده شوند.
به همین دلیل، بهتر است سیستم بتواند کار های زیر را انجام دهد:
رفتار خود را پایش کند
افت کیفیت یا رخنه را تشخیص دهد
مدل یا سیاست امنیتی را طبق جدیدترین آسیب پذیری های شناخته شده به روز رسانی کند
در صورت شکست به حالت امن بازگردد
در مقاله امنیت خود بهبود دهنده، این ایده به شکل روشن تری دیده می شود. بعد از شناسایی یک رخنه، یک سیاست دفاعی جدید ساخته و برای درخواست های بعدی استفاده می شود. [1][5][6]
۷-۶. لایه مشاهده پذیری و ارزیابی
بدون مشاهده پذیری، کنترل و بررسی یک سیستم هوشمند سخت می شود.
برای پایش، فقط زمان پاسخ کافی نیست و بهتر است موارد زیر نیز ثبت شوند:
مسیر تصمیم گیری مدل
فراخوانی ابزار
نسخه مدل و دستور اجرا شده
وضعیت حافظه
خطاها
هزینه اجرا
تصمیم های امنیتی در نظر گرفته شده
الگوی مناسب باید بر اساس هدف واقعی سیستم انتخاب شود. ممکن است یک معماری مقیاس پذیری را بهتر کند ولی سرعت مدل را تغییر ندهد. همچنین ممکن است یک دفاع سخت گیرانه حملات بیشتری را متوقف کند ولی درخواست سالم بیشتری را هم رد کند. بنابراین، یک معماری برای همه سیستم ها بهترین گزینه نیست و معیار ها باید با توجه به نیاز همان سامانه انتخاب شوند. [4][5][7]
۷-۷. نقشه و خلاصه مفهومی حاصل از مقالات
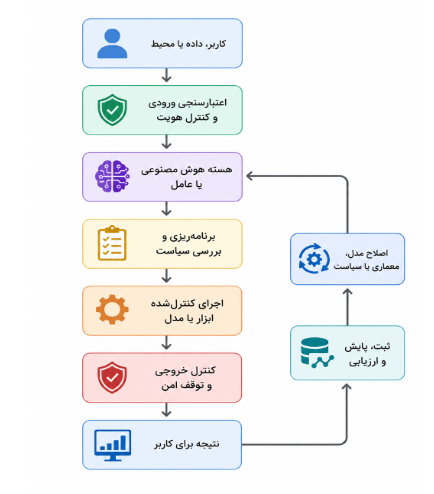
این نمودار، جمع بندی ساده مسیر مشترک مقالات را نشان می دهد. امنیت فقط در یک نقطه قرار داده نمی شود. ورودی، هسته هوش مصنوعی، برنامه ریزی، ابزار، خروجی و مرحله پایش همگی باید کنترل شوند. نتیجه پایش نیز دوباره برای اصلاح مدل، معماری یا سیاست استفاده می شود.
۸. بده بستان یا Trade-Off های اصلی معماری
امنیت در برابر سرعت
کنترل هایی مانند رمزنگاری، بررسی خروجی و اعمال سیاست امنیتی می توانند امنیت را بیشتر کنند، اما معمولا زمان پاسخ و مصرف منابع نیز بیشتر می شوند. [1][5]
امنیت در برابر تجربه کاربر
یک دفاع خیلی سخت گیر می تواند حملات بیشتری را متوقف کند، اما ممکن است درخواست سالم را هم اشتباه خطرناک تشخیص دهد. بنابراین، زیاد شدن تعداد مسدود سازی ها به تنهایی نشانه بهتر شدن امنیت نیست و تجربه کاربر نیز باید در نظر گرفته شود. [5]
مقیاس پذیری در برابر پیچیدگی
مایکرو سرویس ها اجازه می دهند بخش های مختلف جداگانه رشد کنند، اما تعداد ارتباط ها و کار های هماهنگی نیز بیشتر می شوند. پس بهتر است سیستم فقط در جایی به سرویس های کوچک تر تقسیم شود که واقعا نیاز وجود دارد. [4][8]
تمرکز در برابر تاب آوری
وجود یک سرور یا عامل مرکزی، مدیریت را ساده تر می کند اما یک نقطه مهم برای خرابی ایجاد می شود. اگر مسئولیت بین چند بخش توزیع شود، تاب آوری بیشتر می شود ولی هماهنگی سخت تر خواهد بود. [1][7]
خودکارسازی در برابر نظارت انسانی
بعضی تصمیم ها و سیاست ها می توانند به صورت خودکار ساخته شوند، اما خود این فرایند هم ممکن است اشتباه کند. برای عملیات پر ریسک، نظارت و تایید انسانی همچنان مهم در نظر گرفته می شود. [5][7]
حافظه در برابر حریم خصوصی
حافظه به عامل کمک می کند کار های طولانی تر را انجام دهد، اما نگهداری تعاملات و ترجیحات کاربر می تواند خطر حریم خصوصی ایجاد کند. بنابراین، دسترسی و زمان نگهداری اطلاعات باید محدود شوند. [7]
۹. نتیجه گیری کلی
مقالات بررسی شده نشان می دهند که در سیستم های مبتنی بر هوش مصنوعی، فقط خود مدل مهم نیست. برای ساخت یک سیستم قابل اعتماد، باید معماری کامل اطراف مدل نیز طراحی شود.
نتیجه اول، جداسازی مسئولیت ها است. بهتر است استدلال، حافظه، اجرای ابزار، کنترل دسترسی و پایش در بخش های مشخص قرار داده شوند تا هر بخش جداگانه قابل کنترل و بررسی باشد.
نتیجه دوم، اهمیت ردیابی و نسخه بندی است. فقط کد نباید نسخه بندی شود؛ داده، مدل، دستور، ابزار و سیاست های مهم نیز باید ثبت شوند. در این صورت، علت خطا بهتر پیدا می شود و بازگشت به نسخه سالم ساده تر خواهد بود.
نتیجه سوم، پیوسته بودن امنیت است. امنیت نباید فقط در آخر کار اضافه شود. کنترل های امنیتی باید از طراحی و توسعه تا استقرار و نگهداری در نظر گرفته شوند و در زمان اجرا نیز قابل بررسی و به روز رسانی باشند.
نتیجه چهارم، کنترل اختیار عامل هوشمند است. عامل نباید فقط به دلیل توانایی زبانی، دسترسی نامحدود داشته باشد. هر عمل واقعی باید از مسیر احراز هویت، مجوز، سیاست امنیتی و محیط کنترل شده عبور داده شود و برای کار های پر ریسک، تایید انسانی در نظر گرفته شود.
نتیجه پنجم، ارزیابی چند جانبه است. یک معماری فقط با سرعت یا امنیت سنجیده نمی شود. مقیاس پذیری، دقت، هزینه، قابلیت نگهداری، حریم خصوصی و تجربه کاربر نیز باید با توجه به هدف همان سامانه بررسی شوند.
در مجموع، برای یک سیستم امن مبتنی بر هوش مصنوعی ویژگی های زیر در نظر گرفته می شوند:
مدل درون مرزهای معماری مشخص قرار گیرد
داده و نسخه های مدل قابل ردیابی باشند
ابزارها از طریق رابط های محدود و کنترل شده اجرا شوند
تمام فعالیت های مهم ثبت و قابل بازسازی باشند
لایه دفاعی در تمام طول عمر چرخه تولید نرم افزار از طراحی تا استقرار و نگهداری در نظر گرفته شود
سیستم در صورت مواجهه با خطا یا حالت نا امن به حالت امن بازگردد
تصمیم نهایی عملیات های پر ریسک همچنان در یک ساختار با تایید انسانی جلو برود
در نهایت، قابل اعتماد شدن هوش مصنوعی فقط با قوی تر شدن مدل اتفاق نمی افتد. اعتماد زمانی بیشتر می شود که مدل در یک معماری روشن قرار داده شود، اختیار آن محدود باشد، فعالیت ها ثبت شوند و رفتار سیستم به صورت پیوسته بررسی و در صورت نیاز اصلاح شود.
قابل توجه است که اين مطلب، بخشي از تمرينهاي درس معماري نرمافزار در دانشگاه شهيدبهشتي بوده است
منابع
[1] Lo, S. K. , Lu, Q. , Zhu, L. , Paik, H. -Y. , Xu, X. , & Wang, C.
Architectural Patterns for the Design of Federated Learning Systems.
[2] Graef, S. , & Georgievski, I.
Software Architecture for Next-Generation AI Planning Systems.
[3] Heiland, L. , Hauser, M. , & Bogner, J.
Design Patterns for AI-based Systems: A Multivocal Literature Review and Pattern Repository.
[4] Emanuilov, S. , & Dimov, A.
A Quantitative Framework for Evaluating Architectural Patterns in ML Systems.
[5] Slater, T.
A Self-Improving Architecture for Dynamic Safety in Large Language Models.
[6] Dao, M. -D. , Le, Q. M. , Lam, H. T. , Le, D. -T. , Pham, Q. -V. , O’Sullivan, B. , & Nguyen, H. D.
Agentic Design Patterns: A System-Theoretic Framework.
[7] Alenezi, M.
From Prompt–Response to Goal-Directed Systems: The Evolution of Agentic AI Software Architecture.
[8] Karanam, S. , & Bhargav, J.
Microservice Architecture Patterns for Scalable Machine Learning Systems.

