
چکیده
شبکههای اجتماعی مجموعهای از افراد هستند که با هدف خاصی گردهم میآیند. یک شبکه اجتماعی مجموعهای از موجودیت ها که با یکدیگر در ارتباط هستند و با یکدیگر اطلاعاتی را به اشتراک ها میگذارند. با گسترش فضای اجتماعی شبکههای اجتماعی بر خط کاربران زیادی را بهسوی خود جلب کرده است. گرایش به این صنعت از آن جهت است که محدودیتهای جغرافیایی از بین رفته است و کاربران میتوانند با استفاده از آنبراحتی مخاطبانی در سرتاسر جهان و با فرهنگها و ایدههای گوناگون داشته باشند و یا بهسادگی و با کمترین هزینه ملاقاتهای رودررو رسانههای اجتماعی انجام دهند. از سویی روند تجزیه و تحلیل شبکههای اجتماعی با ورود شبکههای اجتماعی بر خط شکل جدیدی به خود گرفته است. این نوع شبکههای اجتماعی با در اختیار داشتن حجم بالایی از اطلاعات سرعت تحقیقات را به نحوی چشمگیر تحت تأثیر قرار داده است همچنین اطلاعات دیدگاهها و چالشهای جدیدی را که مورد توجه بسیاری از زمینهها را بیان میکند. یکی از مهمترین جنبههای تحلیل شبکههای اجتماعی پیش بینی پیوند است. هدف از پیش بینی پیوند، یافتن پیوندهای است که در شبکه مورد مطالعه در دسترس نیست و هنوز مشاهده نشده است در یک شبکه اجتماعی، امکان وجود پیوند بین بسیاری از موجودیتها است که در حال حاضر این پیوندها در دسترس نیستند و ممکن است این پیوندها در آینده به وجود بیاید و یا اینکه بر حسب اتفاقاتی اطلاعات از دست رفته باشد پیش بینی پیوند به خودی خود یک تحلیل شبکه اجتماعی نیست اما از مهمترین کارهایی که در جهت تحلیل شبکه نیاز است تا انجام شود. در این مقاله، به معرفی و کاربردهای پیش بینی لینک و سپس به بررسی روشهای متفاوت پیش بینی لینک میپردازیم و در انتها معیارهای ارزیابی روشهای پیش بینی پیوند را مورد تحلیل و بررسی قرار میدهیم.
کلید واژه: شبکههای اجتماعی، پیش بینی لینک، روش همسایگی مشترک، معیار شباهت، یادگیری خودکار
مقدمه
بسیاری از پدیدههای جهان را میتوان با مجموعههایی از موجودیتها، و مجموعهای از روابط ایستا و پویا بین موجودات نشان داد. چنین روابطی شامل دوستی بین مردم، اقداماتی مانند کلیک کردن بر روی یک تبلیغ آنلاین و تعاملات فیزیکی بین پروتئینها میشود. مجموعهای از چنین روابطی شبکهها را تشکیل میدهند. مسئله پیش بینی ساختار شبکهها را مسئله پیش بینی لینک مینامند که یکی از وظایف مهم لینک کاوی در جامعه داده کاوی است. یک تنظیم معمولی برای مشکل پیشبینی پیوند، پیشبینی بخشهای ناشناخته ساختار یک شبکه (یا ساختار آینده شبکه) از قسمتهای شناخته شده شبکه است. شبکه. پیش بینی لینک در بسیاری از زمینهها مانند تحلیل شبکههای اجتماعی، بازاریابی و بیوانفورماتیک کاربردهای مختلفی دارد. بهعنوان مثال، میتوان از آن برای پیش بینی روابط بین شرکت کنندگان مانند دوستی در شبکههای اجتماعی یا برای پیش بینی رفتارهای آینده کاربران مانند کلیک کردن بر روی تبلیغات برای بازاریابی استفاده کرد. در زمینه بیوانفورماتیک، پیشبینی فعل و انفعالات پروتئین-پروتئین و روابط تنظیمی میتواند راهنمایی برای طراحی آزمایشها برای کشف حقایق بیولوژیکی جدید باشد.
پیش بینی پیوند از جمله مسائل اساسی و پیش نیاز مهم تحلیل شبکههای اجتماعی است. هدف اصلی پیشبینی پیوند، ایجاد یک نمایش کامل علاوه بر پوشش کلیه پیوندهای فعلی در شبکههای اجتماعی شامل کلیه پیوندهای بالقوه (که امکان تحقیق در آینده دارند) و هم کلیه پیوندهای از دست رفته میشوند. در یک شبکه پویا همچنین پیوندهایی که امکان از دست رفتن یا حرفشان در آینده باشد، کشف میشوند و تصویر کاملی از شبکه در آینده را در اختیار قرار میدهند. از سوی دیگر ممکن است در یک شبکه، برخی اطلاعات و پیوندهایی که پیشتر وجود داشتهاند، بر اثر عواملی مانند اختلالات اینترنت و یا عدم ثبت و جمعآوری اطلاعات توسط فرد خبره، از دست رفته باشد و نیاز است تا شبکه بازسازی شود. این حالت نیز نوعی از پیش بینی پیوند با عنوان <<پیش بینی پیوندهای از دست رفته>> مطرح میشود.
در واقع هدف، پیش بینی پیوندهایی است که هم اکنون در شبکه وجود ندارند، اما امکان برقراری آنها آنها در آینده وجود دارد؛ برای مثال در شبکه اجتماعی فیسبوک سعی میشود تا افرادی که بهطور محتمل در آینده به هم پیوند میخورند را پیشتر شناسایی کرده و آنها را به هم معرفی کنند. با این کار نه تنها محبوبیت شبکه اجتماعی بالا میرود، بلکه این پیوند موجب تقویت، گسترش و ماندگاری آن نیز میشود. هرچه تعاملات بین کاربران بیشتر باشد، ماندگاری و پایداری شبکه اجتماعی تثبیت میشود و از طرفی، اطلاعات بهسرعت در شبکه گسترش مییابد. تارنماهای فروش بر خط نیز سعی دارند تا با استفاده از سامانه پیش بینی کننده، رفتارهای کاربر را شناسایی کنند، علایق و سلایق آنها را دریابند و با استفاده از آن، کالاهای مورد نیاز و متناسب با کاربر را توصیه کنم. در نتیجه فروش سیستم خود را افزایش دهند.
پیوندها میتوانند بین دو کاربر در یک شبکه اجتماعی بر خط و یا بین کالا و کاربر باشند. وجود چنین تفاوتهایی سبب میشود تا رویکردهای متفاوتی برای پیش بینی پیوند ارائه شود. برای حل مسئله در شبکههای اجتماعی، به دو جنبه اساسی توجه میکنند: ساختار شبکه اجتماعی و هدف پیش بینی پیوند. جنبه اول بیان میکند با توجه به هدف سامانه پیش بینی کننده، این سامانه قادر است چه نوع ساختارهایی را مورد بررسی قرار دهد چه پیوندهای آن را پیش بینی کند. جنبه دوم (هدف پیش بینی پیوند) در حقیقت به دنبال چیستی مسئله میگردد و این پرسش را مطرح میکند هدف سامانه پیش بینیکننده چیست. چه پیوندهایی را میخواهد پیش بینی کند. این دو جنبه لازم و ملزوم یکدیگرند همواره باید پیش از ارائه هر کاری به این دو پرسش پاسخ داد تا صورت مسئله شفاف گردد. در این مقاله ساختار انواع شبکههای اجتماعی بیان و هدف پیش بینی پیوند، انگیزه و چالشهای روبروی پیش بینی پیوند مطرح میگردد. در ادامه به پژوهشهای مهم و کارهای مرتبط درباره مسائل پیشبینی لینک از اطلاعات ساختاری گراف میپردازیم.
بیان مسئله
در یک شبکه پویا همچنین پیوندهایی که امکان از دست رفتن یا حرفشان در آینده باشد کشف میشوند و تصورت کاملی از شبکه در آینده و در اختیار قرار داده میشود. از سوی دیگر ممکن است در یک شبکه، برخی اطلاعات و پیوندهایی که پیشتر وجود داشتهاند، بر اثر عواملی مانند اختلالات شبکه اینترنت و یا عدم ثبت و جمعآوری اطلاعات توسط خبره، از دست رفته باشد و نیاز است تا شبکه بازسازی شود. این حالت نیز نوعی از پیشبینی پیوند با عنوان «پیشبینی پیوندهای از دست رفته» است. رویه کلی در سامانه پیشبینیکننده پیوند از دو گام تشکیل شده است. گام اول و مهم، یافتن شاخصها و ویژگیهایی است که به شناخت موجودیت ها و پیوندهای موجود در شبکه کمک میکند و با استفاده از ویژگیهای بهدست آمده در گام بعدی پیش بینی صورت میگیرد. در ظاهر به نظر میرسد فرآیند پیشبینی پیوند کار پیچیدهای نیست و فقط از دو گام یافتن ویژگی و پیش بینی کننده تشکیل شده است، اما در واقع هر یک از این دو گام دارای پیچیدگیها و چالشهایی است که تحقق هدف را با چالش روبهرو میکند یکی از بارزترین و آشکار ترین چالشها تنوع و گوناگونی انواع شبکههای اجتماعی چه در ساختار و چه در محتوای آنهاست. از کاربردهای پیش بینی پیوند میتوان به: توصیه در شبکه اجتماعی ،کشف هرزنامه ،یافتن کارشناس خبره در شبکه اجتماعی علمی ،کشف روابط دوستانه و حلقه های خانوادگی ،تشخیص تاثیرگذاری ،تعاملات پروتئین به پروتئین ،تعاملات دارویی، نظارت بر شبکه های کامپیوتری ،مسیریابی در شبکه ،تکمیل و بازسازی پایگاه دانش و تجزیه و تحلیل سهام اشاره کرد.
هدف اصلی پیش بینی لینک این است که با توجه به وضعیت در لحظه فعلی(t) وضعیت شبکه در حالت های بعدی را پیش بینی کند. به عبارت دیگر یالهایی که ممکن است در لحظه بعدی حذف یا اضافه شوند پیش بینی کند.
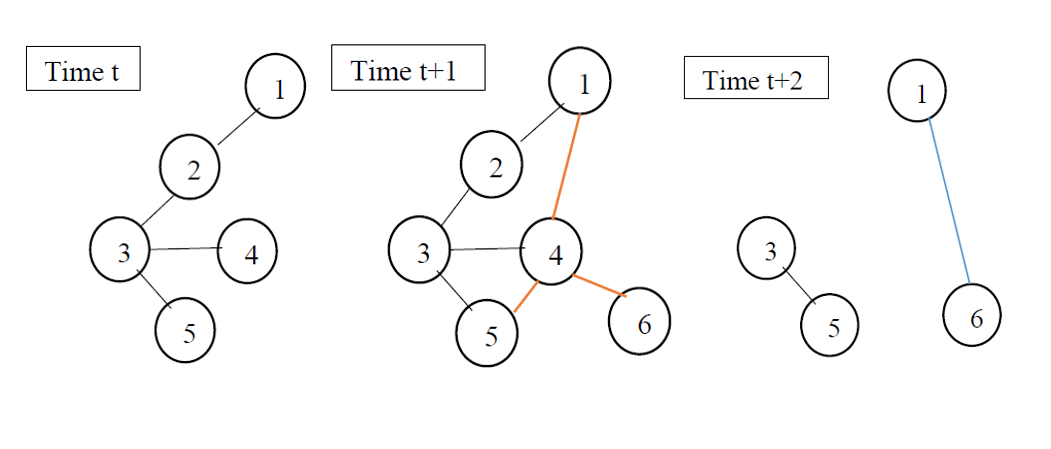
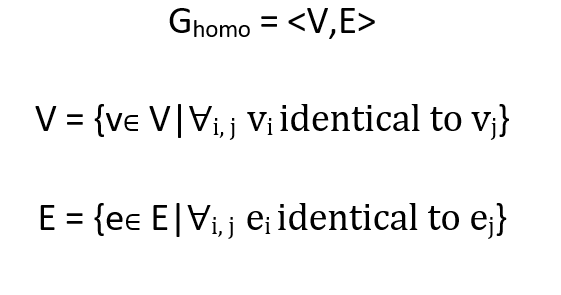
از منظر فرآیند پیشبینی پیوند، دو نوع شبکه با ساختارهای مختلف قابل تعریف است: شبکه همگن و شبکه ناهمگن. پیشبینی پیوند در این دو نوع شبکه با توجه به تفاوت ساختاری آنها به روشهای متفاوتی انجام میشود. در یک شبکه همگن موجودیت ها هم نوع هستند در واقع یک شبکه اجتماعی همگن، گراف سادهای است که بهصورت زیر تعریف میشود:
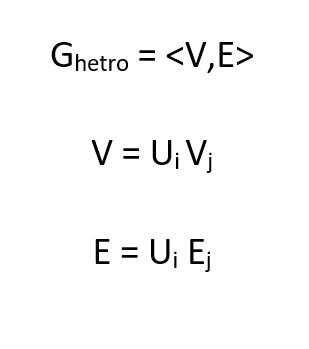
در شبکه اجتماعی ناهمگن انواع گوناگونی از موجودیت ها موجود دارد هر یک از آنها مستقل از نوع شان میتوانند با هم نوع خود و یا با انواع دیگری پیوند داشته باشد؛ شبکه اجتماعی ناهمگن بهصورت ریاضی این گونه بیان میشود:
وجود انواع گرهها و لبهها سبب میشود تا پیچیدگی گراف بیشتر شود و این پیچیدگی با در نظر گرفتن زمان چند برابر میشود. از دیدگاه دیگر میتوان ساختارهای شبکه اجتماعی را به دو دسته ایستا و پویا تفکیک کرد. لازم به ذکر است، که شبکههای اجتماعی به ذات پویا هستند با وجود این میزان پویایی هر یک با دیگری متفاوت است. بر اساس ساختارهای شبکههای اجتماعی از لحاظ پویایی و ناهمگن دارای ۴ حالت کلی دسته بندی میشود.
هدف پیش بینی پیوند نیز بیان صورت مسئله است تا مسیر حل مسئله مشخص شود. با توجه به انواع ساختارهای شبکه اجتماعی، مسئله پیش بینی پیوند دو دسته کلی پیش بینی پیوندهای از دست رفته و پیشبینی پیوندهای آتی تفکیک میشود.
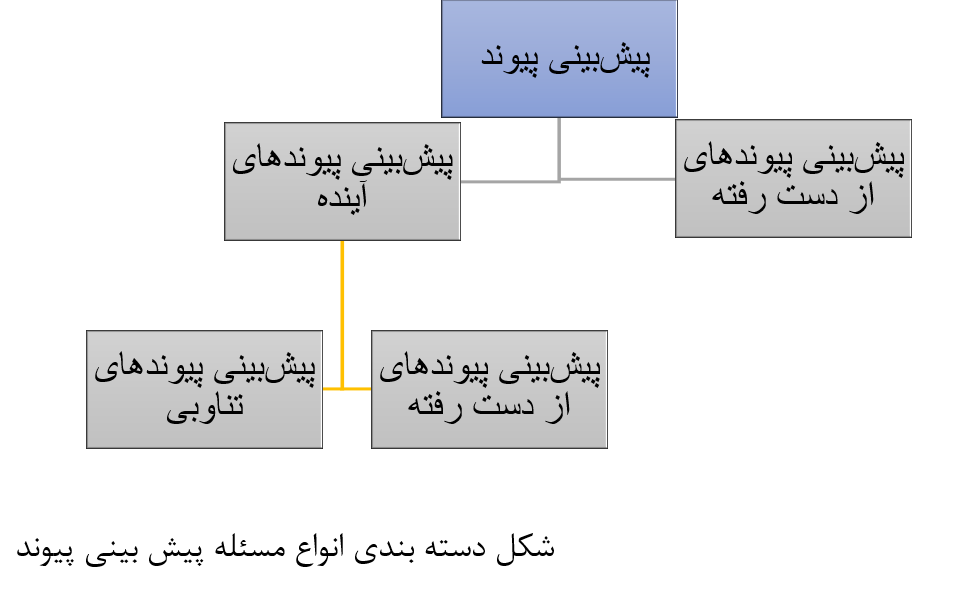
پیش بینی پیوندهای آینده:
پیش بینی پیوند به عنوان یک چالش مستقل اغلب تحت عنوان پیش بینی پیوندهای آتی مطرح میشود. در حقیقت، نیاز است تا پیوند هایی که در آینده امکان تشکیل دارند شناسایی شود. به عبارت دیگر پیش بینی پیوندهای محتمل آتی صورت گیرد نمونه مشهود از کاربرد پیش بینی پیوند های آتی در شبکه اجتماعی همکاری نویسندگان DBLP است. هرساله نویسندگان زیادی با هم همکاری دارند و مقالات علمی جدید تالیف میکنند. در این شبکه اجتماعی با استفاده از پیش بینی پیوند امکان همکاری نویسندگان با توجه به حوزه کاری، منطقه جغرافیایی و نوع همکاری در آینده پیشبینی میشود. با گسترش شبکه های اجتماعی بر خط پیش بینی پیوند نه تنها موجب رشد این شبکهها شده است بلکه نیاز اساسی برای آن ها محسوب می شود. پیشبینی پیوندهای آتی به دو دسته پیشبینی پیوندهای تناوبی و پیشبینی پیوندهای غیر تناوبی دسته بندی می شوند. در دسته اول تمرکز بر روی پیوند هایی که در طول زمان ایجاد و حذف میشود دسته دوم پیش بیشتر در ساختار شبکه تمرکز دارد و این تناوب زمانی در تشکیل پیوند را نادیده میگیرد.
ادبیات موضوع
با گسترش شبکههای اجتماعی بر خط، مطالعات گستردهای بهصورت مستقل روی پیش بینی پیوند بهعنوان یک چالش مهم و اساسی انجام شد و در مدت کوتاه، الگوریتمهای متنوعی با هدف پیش بینی پیوند ابداع گردید. لیون و کلینبرگ در مقاله <<مسئله پیش بینی پیوند در شبکههای اجتماعی>>، برای اولین بار تمامی روشها و الگوریتمهای ارائه شده تا آن زمان را معرفی و مقایسه کردند. آنها همچنین بیان کردند که تمامی روشهای موجود در سه قالب روشهای مبتنی بر همسایگی گره، مجموعه تمامی مسیرها و رویکردهای سطح بالا میگنجد. در همین حین، حسن و همکاران با استفاده از معیارهای شباهت و اطلاعات محتوایی شبکههای اجتماعی سعی کردهاند تا یک بردار ویژگی برای هر گره ایجاد کنند تا بهوسیله روشهای یادگیری ماشین، پیوندهای بالقوه را پیش بینی کنند.
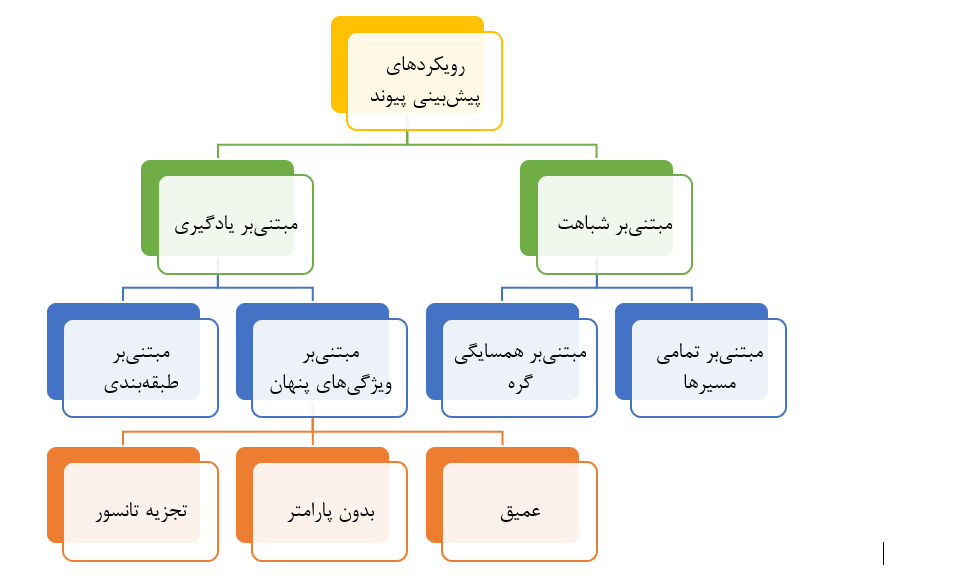
میتوان تمامی روشهای ارائه شده در انتزاعیترین سطح برای پیشبینی پیوند دو دسته کلی رویکرد مبتنی بر شباهت و مبتنی بر یادگیری دسته بندی کرد. رویکردهای مبتنی بر شباهت، شاخصهای را بهعنوان معیار شباهت معرفی میکنند. بر این اساس، هر چه دو گروه شباهت بیشتری به یکدیگر داشته باشند احتمال وجود پیوندی بین آنها نیز بیشتر است. با نگاهی دقیقتر، شاخصههای مبتنی بر شباهت نیز خود در دو دسته مبتنیبر همسایگی گره و مجموعه تمامی مسیرهای قابل دسته بندی هستند. در مقابل، رویکردهای مبتنی بر یادگیری، اقدام به ساختن یک مدل میکنند و سپس پیوندهای بالقوه بهوسیله مدل یادگیری پیشبینی میشوند. مدلهای یادگیری در پیش بینی پیوند که به بردار ویژگی در دو گروه مدل طبقه بندی و رویکرد مبتنی بر ویژگیهای پنهان دسته بندی میشوند. تفاوت بارز این دو رویکرد نحوه تولید بردار ویژگی است. در واقع رویکردهای مبتنی بر ویژگیهای پنهان، اقدام به ایجاد نوعی مدل یادگیری میکنند که در آن، برداری از ویژگیهای نهفته در شبکه اجتماعی تولید میشود. در حالیکه روشهای مبتنی بر طبقه بندی چنین نیستند و بردارهای ویژگی توسط روشهای دیگری مانند شاخصههای شباهت، تولید میشوند و سپس این مدت اقدام به یادگیری میکنند رویکرد به تفکیک در شکل زیر نشان داده شده است.
کارهای مرتبط
رویکرد مبتنی بر شباهت، رویکرد مبتنی بر نزدیکی و یا رویکرد اکتشافی نیز نامیده میشود. روشهای ارائه شده در این گروه با استفاده از اطلاعات اکتشافی اقدام پیش بینی پیوند میکنند. در این روشها ویژگیهایی که گرهها و مسیرها بهعنوان ورودی دریافت میشود سپس در تمامی روشها، به هر پیوند بین دو گره u و v یک امتیاز اختصاص داده میشود. این امتیاز بهوسیله تابع امتیاز score(u,v)و با استفاده از ویژگیهای هر دو گره محاسبه میشود. در نهایت، پیوندهایی که بالاترین امتیاز را داشته باشند بهعنوان پیوندهایی بالقوه و محتمل معرفی میشوند. روشهای مبتنی بر شباهت به شاخصههای توپولوژیک شبکه اجتماعی توجه میکنند. رویکردهای مبتنی بر شباهت با توجه به معیار شباهت و یا ویژگی توپولوژی شبکه که به دو دسته رویکرد مبتنی بر همسایگی و رویکرد مبتنی بر مجموعه تمامی مسیرها تقسیم میشوند. اینکه کدام یک از رویکردها بر دیگری برتری دارد روشن نیست ولی آنچه مشخص است این است که این روشها نسبت به تصادفی پیش بینی کردن، عملکرد بهتری دارند.
رویکرد مبتنی بر همسایگی گره شاخصهای محلی و رویکرد مبتنی بر مجموعه تمامی مسیرها شاخصهای سراسری را در نظر میگیرد با این حال اغلب این روشها با توجه بهسادگیشان در مواجه با شبکههای ناهمگن ناتوان هستند و نیاز است تا در شبکههای اجتماعی بزرگ، در میان شباهت آنها بازنگری صورت پذیرا. رویکرد مبتنی بر شباهت ساختار ساده تری نسبت به رویکردهای مبتنی بر مدل یادگیری دارد. بیشتر این روشها و الگوهای پویا و تکاملی شبکه را نادیده میگیرند و فقط پیش بینی پیوندها بر اساس آخرین تصویر از گراف میپردازند. تعاملات در شبکههای اجتماعی از الگویی با عنوان الگوی هموفیلی تبعیت میکنند. مطابق الگوی هموفیلی موجودیت ها در انجمنهای اجتماعی با موجودیتهای نزدیک به هم ارتباط برقرار میکننویکرد مبتنی بر همسایگی گره در حقیقت به ویژگیهای محلی هر گره توجه دارد. از این رو به شاخصههای آن، شاخصههای محلی نیز گفته میشود. اندیشۀ محلی بودن ویژگیهای پیوند، سبب ابداع شاخصههای همسایگی شده است. بهعبارت دیگر، در این روش تابع امتیاز مبتنی بر شاخصههای همسایگی طراحی شده است. شاخصههای همسایگی، در یک حوزه محلی بهخوبی گرههای مشابه را پیش بینی میکند و الگوی هموفیلی بهراحتی تشخیص داده میشود. هرگره در این شبکه اجتماعی دارای دو ویژگی ساختاری و محتوایی است. ویژگیهای ساختاری وابسته به ساختار گراف و شباهت هر گره به سایر گرهها در آن شبکه است.
در این میان، روشهایی که به ساختار گراف توجه دارند، اهمیت بیشتری در تحلیل شبکههای اجتماعی دارند زیرا همواره نیاز است روشهای ارائه شده که قابلیت عمومیسازی داشته باشند از آنها بهعنوان بتوان در تحلیل انواع شبکه استفاده کرد.
روشهای مبتنی بر همسایگی گره، همگی به ویژگیهای ساختاری گره توجه دارند، اما در عمل و در صورت وجود اطلاعات محتوایی، این روشها میتوانند متناسب با آن شبکه اجتماعی، سفارشی شوند. در ادامه شاخصهای مطرح و مهم ما همسایگی گره مورد بحث و بررسی قرار میگیرند. در تمامی شبکههای مبتنی بر همسایه گره نماد Г(x) مجموعه تمامی همسایههای گره x را نشان میدهد. تمامی گرههایی که بهوسیلۀ یکی لبه با گره مورد نظر پیوند برقرار کردهاند، همسایۀ آن به حساب میآیند.
1.همسایههای مشترک
برای دو گره x و yتابع امتیاز همسایۀ مشترک این گونه تعریف میشود:
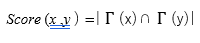
بیان ساده تر هر چه دو گره همسایههای مشترک بیشتری داشته باشند، تابع امتیاز به پیوند بین آن دو امتیاز بهتری تخصیص می دهد و در نهایت پیوند میان آنها شانس بیشتری برای پیش بینی شدن دارد. پیچیدگی زمانی این شاخص برای محاسبۀ تمامی جفت گرهها از مرتبۀ O(vk^3) است. K حداکثر درجۀ گرهدرگراف است و v تعداد کل گرهها در شبکه.
1-1.ضریب جاکارد
ضریب جاکارد همان شاخص همسایه مشترک است که در بازه [0,1] نرمال شده است. نرما شدن در آمار عبارت است از روشی که سبب میشود داده ها در یک دامنۀ مشابه قرار گیرند. بهعبارت دیگر مقادیر بسیار زیاد، اثر انحرافی بیشتری در تابع هزینه دارد و زمانی که نرمال می شود ایراد برطرف میگردد. در همسایۀ مشترک چنین مشکلی دیده میشود و گرههایی وجود دارد که درجۀ آنها بسیار بالاست. درجۀ بالای گره تاثیر زیادی در تابع امتیاز داد. از این رو ضریب جاکارد با نرمال سازی این مشکل را برطرف کرده است. تابع این گونه بیان میشود:
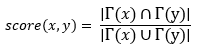
از لحاظ مفهومی تابع امتیاز جاکارد احتمال انتخاب همسایه مشترک دو گره xو y را از میان انتخاب تصادفی تمامی همسایه های xو y بیان میکند. از این رو هرچه تعداد همسایههای مشترک بیشتر باشد امتیاز آن نیز بیشتر میشود. همسایۀ مشترک در شبکههای متراکمتر عملکرد بهتری دارد. پیچیدگی زمانی این شاخص برای محاسبۀ تمامی جفت گرهها از مرتبۀ O(vk^3) است.
1-2.آدامیک آدار
آدمیک و آدار در مقالۀ <<دوستان و همسایگان در وب>> معیار دیگری برای شباهت دو صفحۀ وب معرفی کردهاند. در پیشبینی پیوند، این معیار شباهت بدین گونه تعریف میشود:
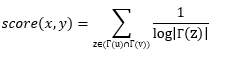
به این ترتیب روش آدمیک /آدار به هر دو جفت گرهای که همسایه های مشترک ان درجۀ گره کمتری داشته باشند و به عبارت دیگر همسایه های مشترک آن، دارای همسایه مشترک کمتری باشند وزن بیشتری اختصاص می دهد. در حقیقت آدمیک /آدار نسخه وزن دار شده همسایۀ مشترک است و پنالتیای برای تمام همسایه های غیر مشترک دارد. در برخی از ارزیابیها نشان داده شده است که این روش عملکردی بهتری از دو روش همسایۀ مشترک و ضریب جاکارت دارد. حتی در شبکه های اجتماعی تنک هم عملکرد آن بهتر از ضریب جاکارد است. این روش نیز مانند هر دو روش قبل ضعف عدم تشخیص الگوهای پیچیده و تکاملی را دارد پیچیدگی زمانی این شاخص از مرتبه زمانی O(vk^3) است.
در یک شبکه اجتماعی مبتنی بر دوستی، وقتی شخصی دوستان زیادی داشته باشد یعنی افراد با سلایق مختلفی با او در ارتباط هستند اگر هم تعداد دوستان محدودی داشته باشد حاکی از آن است که این فرد دارای سلیقه یا گرایش محدودی است در صورتی که این فرد با دو فرد دیگر ارتباط داشته باشد میتوان استنتاج کرد که آن دو نیز دارای گرایش و سلیقه محدود و خاصی هستند از این رو انتظار می رود که بین آنها پیوند های بالقوه وجود داشته باشد که در آینده تشکیل شود.
1-3.پیوست ترجیحی
پیوست ترجیحی بر پایه مدل تئوری از مشاهدات بنا شده است که بیان میکند احتمال تشکیل پیوند بین دو گره با رشد درجه آنها افزایش مییابد. این مدل شکلگیری در حقیقت از مفهوم «غنی، غنیتر میشود» تبعیت میکند. امتیاز پیوند جدید بین گره x و y برابر است با:
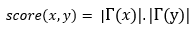
پیوسته ترجیحی نسبت به دیگر روشهای مبتنی بر همسایگی گره، عملکرد بهتری در شبکههای پویا دارد. پیوست ترجیحی در شبکههای پویا به محض ورود یک موجودیت جدید به شبکه اجتماعی سعی دارد تا آن موجودیت را به دیگر موجودیتهای محبوب متصل کند. منظور محبوب بودن گره با درجه بالاست. پیچیدگی زمانی این شاخص از مرتبه زمانی O(vk^2)است.
1-4.شاخص توزیع منابع
شاخص توزیع منابع بهصورت فرایند تخصیص منابع در شبکههای پیچیده کار میکند. این شاخص انتقال واحدهای منابع بین دو گره متصل x و y را از طریق همسایههای گره، مدل میکند. هر گره همسایه یک واحد از منابع را از x دریافت میکند و بهصورت یکسان آن را بین همسایگانش توزیع میکند. میزان منابع بهدست آمده بهوسیله گره y میتواند بهعنوان شباهت بین دو گره در نظر گرفته شود. این تابع شباهت بهصورت:
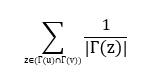
لازم به ذکر است که بهاندازه گیری بشدت به همسایگان مشترک و شاخص آدمیک / دار مرتبط است. این روش نیز مانند همسایه مشترک به آدمیک / آدار، پیچیدگی زمانی از مرتبه O(vk^3) را دارد. بیشتر شاخصهای شباهت تبادل منابع بالقوه این گره را نادیده میگیرد. در دنیای واقعی مانند شبکههای اجتماعی آنلاین، منابع بسیاری مانند موضوعات جنجالی و اخبار بین افراد غریبه از طریق دوستان منتشر میشود و هرچه این اخبار و موضوعات به هم نزدیکیتر باشد، احتمال دوستی بین افراد گوناگون بیشتر است.
2. رویکرد مبتنیبر تمامی مسیر
این واقعیت که دوستان یک دوست میتوانند به یک دوست تبدیل شوند، نشان میدهد مسیر بین گره در یک شبکه اجتماعی میتواند بر تشکیل پیوند بین آنها تأثیر بگذار. مسیر بین دو گره یک ویژگی اکتشافی است که برای محاسبه شباهت بین آن دو استفاده میشود این ویژگی به دنبال یافتن شاخصههای سراسری بین هر دو گره است. کشف اطلاعات بین دو گره از طریق مسیر در عین داشتن نقاط قوت، ضعفهایی هم دارد. کاوش اطلاعات از طریق مسیر در حقیقت یک مدل یادگیری ساده است، اما در شبکههای بزرگ، بسیار پرهزینه و گاه ناکارآمد است. پیچیدگی محاسباتی میتواند آنها را برای شبکههای بزرگ غیرقابل قبول و راه اندازی آنها را بسیار پیچیده سازد؛ بهویژه در محیطهای توزیع شده که در آنها ساختار کامل شبکه ممکن است ناشناخته باشد. در حقیقت این رویکرد همواره با چالش مقیاسپذیری مواجه است. اگرچه روشهای ارائه شده پیچیدگی زمانی متنوعی دارند، پیچیدگی فضایی همگی آنها O(V^2)است؛ زیرا هر یک باید امتیاز را برای هر جفت گره ذخیره کنند. رویکرد مبتنی بر مجموعه تمامی مسیرها بیشتر بهعنوان ایده مکمل روشهای دیگر کاربرد دارد.
رویکرد مبتنیبر تمامی مسیرها در مقابل رویکرد مبتنی بر همسایگی گره، بهراحتی قابل سفارشی شدن در هر شبکه اجتماعی است. در حقیقت اطلاعات محتوایی که مسیرهای بین هر دو گره دارد، مانند لبههای وزن دار و لبههای چندگانه، در قالب ساختار گراف مطرح میشود.
2-1. کاتز
یکی از شناخته شده ترین روشهای مبتنیبر تمامی مسیر هاست. این روش نیز مانند همسایه مشترک بهعنوان مبنای سایر روشها معرفی شده است. کاتز بهصورت تصاعدی به مسیرهای کوتاهتر وزن بیشتری میدهد این شاخصه شباهت بهصورت زیر است:
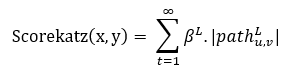
که در آنpathمجموعه تمامی مسیرهای بین هر دو گره است و پارامترهای L و بتا بزرگتر از صفر است و هرچه مقدار بتا کوچکتر باشد این معیار شبیه به معیار همسایه مشترک عمل میکند.پیچیدگی زمانی کاتز از مرتبه O(vk+v^3+v) است.
2-2. گامهای تصادفی
در یک گراف با شروع از یک گره بهصورت تصادفی، یکی از گرههای همسایه انتخاب میشود و این پروسه برای هر گره تکرار شود. در حقیقت این زنجیره مارکوف که بهصورت تصادفی گره را انتخاب میکند، بهعنوان گام تصادفی روی گراف شناخته شده است. اگر بردار px بهعنوان احتمال دستیابی به هر گرهای با شروع گام تصادفی x تعریف شود، احتمال دستیابی به هر گره میتواند بهصورت تکراری از طریق رابطه زیر تخمین زده شود. M ماتریس انتقال است که توسط ماتریس مجاورت را بهصورت زیر تعریف شده است:
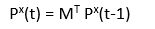
2-3. اصابت زمانی
برای دو گره u و v شاخصه ثابت زمانی Hu,vبرابر است با تمام تعداد قدمهای مورد انتظار برای گام تصادفی از u به v. هرچه Hu,v کوچکتر باشد، آن دو گره به هم شبیهتر هستند و پیوند بین آنها میتواند بهعنوان پیوند بالقوه پیش بینی شود همان طور که بیان شد این تعریف در گراف های شبکه اجتماعی جهتدار صدق میکند. تعمیم آن بگرفت های بدون جهت نیز اینطور بیان میشود:
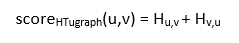
بهدلیل وجود گامهای تصادفی در این روش، هزینه محاسباتی آن در مقایسه با روش کاتز کمتر است از سوی دیگر میتوان به پراکندگی زیاد در این روش اشاره کرد؛ برای مثال، اگر ثابت زمانی بین دو گره u و v متاثر از گره z باشد که اینکه بسیار از آن دو دور باشد، اگر احتمال دستیابی به z زیاد باشد فرار از همسایگی z برای گامهای تصادفی که مبتنی بر احتمال قدم هاست، سخت و یا غیر ممکن میشود پیچیدگی زمانی ثابت زمانی از مرتبهO(v^3)است. جهت مقابله با این رفتار پیشنهاد شده است که این روش بهوسیله زرد در احتمال ثابت نرمال شود رابطه نرمال شده است ثابت زمانی را توصیف میکند.
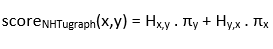
2-4. ریشه رتبه صفحه
شاخص اندازهگیری رتبه صفحه برای رتبه دهی صفحات وب استفاده میشود. این شاخص را پیشتر موتور جستجوی گوگل به کار میگرفت. گوگل تا پیش از آوریل 2016 در نوار ابزار خود رتبه هر صفحه وب را در مقیاس لگاریتمی به کار نشان میداد. با وجود اینکه گوگل شاخصه رتبه صفحه را از ن. ار ابزار برداشته است، همچنان بعد از 18 سال از رتبه صفحه برای رتبه دهی صفحات وب استفاده میکنند، دیگر بهعنوان شاخصی مانند الکسا در اختیار عموم قرار داده نمیشود. رتبه صفحه هر لینک از صفحه دیگری بهعنوان یک رأی محسوب میشود. میزان این امتیاز بستگی به امتیاز صفحاتی دارد که به آن لینک داده شده است و به همین ترتیب امتیاز صفحات محاسبه میشود. بهعبارتی امتیاز هر صفحه به امتیاز صفحاتی که به آن پیوند داده شده است بستگی دارد. ریشه رتبه صفحه عنوان تغییر یافته رتبه صفحه برای مسئله پیشبینی پیوند است امتیاز ریشه رتبه صفحه احتمال یک گام تصادفی از گره x است که با یک احتمال ثابت به گره y میرسد. در حقیقت گره xکه بهعنوان ریشه در نظر گرفته میشود. یک گام تصادفی از x را در نظر بگیرید که به یکی از همسایهها با احتمال آلفا میرود و دوباره x با احتمال آلفا باز میگردد.
ماتریس احتمالی انتقال P
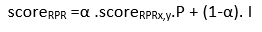
2-5. سیم رنک
معیار سیم رنگ در حالت کلی بیان میکند با گره در صورتی به هم شبیه هستند که به گرههای شبیه به هم متصل باشند. این روش برای شبکههای جهت دار یا ترکیبی توصیه میشود با این حال با افزایش تعداد لبههای ناخواسته غیرعملی است. پیچیدگی الگوریتمی بالای این روش استفاده از روشهای بهینهسازی جهت محاسبات آن را ضروری میسازد پیچیدگی زمانی این الگوریتم از مرتبهO(v^4)است که در آن، v تعداد کل گره در گراف است.
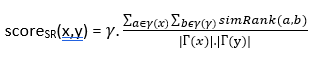
اگر score برابر با یک بود x=y که در آن γ یا 0 و یا 1 است و به آن بردار تجزیه میگویند.
رویکردهای پیشبینی پیوند در شبکه های اجتماعی مبتنی بر یادگیری عمیق
توانایی روشهای مبتنی بر شباهت در یافتن الگوهای تکاملی و ویژگی های غیرخطی سبب شده از مسیر دیگری با عنوان رویکرد مبتنی بر یادگیری در حوزه پیشبینی پیوند مطرح شود. با گذشت زمان محققان به این نتیجه رسیدند که الگوریتم هایی که ساختار رابطه ای شبکه اجتماعی را در نظر میگیرند از کارایی بسیاری در پیشبینی پیوند برخوردارند. از سوی بسیاری از الگوریتم های یادگیری ماشین وابسته به بردار ویژگی در ورودی هستند بر این اساس، محققان به دنبال روش هایی هستند که علاوه بر توجه به ساختار رابطه شبکه اجتماعی قادر به تولید خودکار بردار ویژگی باشند. رویکردهای مبتنی بر یادگیری در پیشبینی پیوند به دو دسته رویکرد در طبقه بندی و رویکرد مبتنی بر ویژگی های پنهان تقسیم می شود. مبنای این دسته بندی نحوه تولید بردار ویژگی است. در رویکرد طبقه بندی بردار ویژگی به صورت مستقل و جداگانه از فرایند یادگیری تولید میشود و به عنوان ورودی و الگوریتم یادگیری داده می شود از سوی دیگر رویکردهای مبتنی بر ویژگی های پنهان به صورت ضمنی و با یک الگوریتم یادگیری بردار ویژگی را تولید میکند. به عبارت دیگر، ایده اصلی این رویکرد یافتن الگوهای است که درون شبکه اجتماعی نهفته است به سادگی نمی توان به آنها دست یافت.
در رویکردهای مبتنی بر یادگیری در پیش بینی پیوند یک مدل ساخته می شود. مدل یادگیری ساخته شده به وسیله بردار ویژگی گره های شبکه آموزش داده میشود. الگوهای مورد نیاز کشف و استخراج می شوند و در نهایت پیش بینی پیوند انجام میشود. از لحاظ مفهومی در این سطح از انتزاع مدل های یادگیری پیوند های دیده نشده را پیش بینی می کند. درپیش بینی پیوند، رویکرد مبتنی بر یادگیری به دو دسته اصلی تقسیم می شود رویکرد مبتنی بر طبقه بندی و رویکرد مبتنی بر ویژگی های پنهان. مبنای این تقسیمبندی نوع مدل یادگیری است رویکرد مبتنی بر طبقه بندی با استفاده از بردار ویژگی ورودی اقدام یاد گرفتن مدل و در نهایت پیش بینی پیوند های از دست رفته و آتی را می کند. این بردار ویژگی از پیش توسط یک مرحله پیش پردازش تهیه شده است در حالی که در رویکرد مبتنی بر ویژگی های پنهان، تهیه این بردار ویژگی در داخل مدل یادگیری انجام می شود. به بیان روشن تر مدل یادگیری اقدام به تولید برداری از ویژگی ها می کند و همزمان با آن مدل آموزش میبیند.
بردار ویژگی: برای هر پیوند مجموعه مرتب از ویژگی های کمی و کیفی آن پیوند را توصیف میکند. یک بردار ویژگی سودمند برداری است که بتواند ویژگی های یک پیوند را به خوبی توصیف کند. این بردار ویژگی علاوه بر اینکه ویژگی های پیوند را توضیح می دهد باید با ساختار طبقه بندی نیز سازگار باشد. ویژگی هایی که برای یک لبه می توان در نظر گرفت به سه نوع ویژگی های گره دو سر آن گره، ویژگی های لبه و ویژگی های مسیر دسته بندی می شود.
ویژگی های گره: اطلاعات مربوط به هر گره شامل اطلاعات محتوایی و ساختاری است. دادههای محتوایی هرگره در شبکه اجتماعی در حقیقت اطلاعات موجود در نمایه کاربر است. وجود این اطلاعات تأثیرات زیادی بر تشخیص پیوندهای بالقوه دارد. این تاثیر از وجود الگوی هموفیلی در شبکه اجتماعی نشأت گرفته است و مطابق آن، افراد را در مورد یک موقعیت جغرافیایی و یا افراد هم سن تمایل بیشتری دارند که با هم ارتباط برقرار کنند.
ویژگیهای یال: هر پیوند نیز مانند گره اطلاعات محتوایی و ساختاری دارد با توجه به ساختار شبکه اجتماعی محتوای هر پیوند نیز تغییر میکند. در برخی شبکههای اجتماعی انواع مختلفی از پیوند وجود دارد. در شبکه اجتماعی خویشاوندی، هر پیوند دارای برچسبی است که نوع ارتباط بین دو موجودیت را مشخص می کند در شبکه اجتماعی همکاری نویسندگان مقالات علمی، تعداد مقالات مشترک بین هر دو نویسنده، وزن بر روی هر پیوند است.
اطلاعات اطلاعات توپولوژیکی هر پیوند در واقع مجموعهای از معیارهای مبتنی بر همسایگی هستند به بیان دیگر معیارهای مبتنی بر همسایه علاوه بر اینکه به طور مستقل قابلیت پیش بینی پیوند را دارند می توانند به عنوان درایهای از بردار ویژگی قرار گیرند. وجود ویژگی های مبتنی بر همسایگی گره، به دلیل تشخیص شباهت بین دو گره، بسیار در تشخیص پیوند موثر است.
رویکرد مبتنی بر طبقه بندی
در یادگیری ماشین و آمار طبقه بندی به عنوان نمونه ای از یادگیری با نظارت شناخته شده است .یادگیری با نظارت، آموزش تابع است که بر اساس نمونه های مشاهده شده یک ورودی و خروجی نگاشت کند. در یادگیری ماشین به نمونه های مشاهده شده، مجموعه آموزش میگوید و بیان ساده در این تابع از نمونههای آموزش به گونهای طراحی شده است که به ازای دیدن نمونه جدید و مشاهده نشده بتواند خروجی مناسب برای آن تعیین کند. این خروجی مناسب همان برچسب یا برچسب نمونه است در یادگیری با نظارت، تمامی نمونه های آموزش دارای برچسب هستند. با توجه به اینکه بر اساس نمونه های مشاهده شده شناسایی انجام می شود انواع دستهها پیشتر مشخص بوده و محدود به نمونه های آموزشی است بنابراین همواره انتخاب نمونه های آموزشی با چالش همراه است و محدود و نمونه های آموزش باید طوری انتخاب شوند که تمامی فضای حالت را در بر گیرد. همواره مسائل طبقه بندی شامل دو و یا بیش از دو دسته هستند در طبقه بندی به دسته ها کلاس می گویند. از سوی دیگر در حوزه های کاربردی واقعی همواره برچسب داده ها موجود نیست و این محدودیتی اساسی برای طرح طبقه بندی است. دنیای اینترنت پراست از داده های خام که نیازمند صرف هزینه زیاد برای برچسب گذاری هستند. الگوریتم نجام طبقه بندی، طبقه بند نامیده می شود. معیارها و متغیر هایی را که به صورت کمی و کیفی نمونه آموزش را توصیف می کنند ویژگی میگویند و به مجموعه ای از ویژگی ها، بردار ویژگی اطلاق می شود آنچه برای یک کار طبقه بندی لایه کار طبقه بندی لازم است وجود مجموعه آموزش برچسب دار، طبقه بند و بردار ویژگی برای هر نمونه آموزش است.
ویژگی های پنهان
فرضیۀ بنیادی در رویکرد مبتنی بر ویژگی های پنهان ارائه مدلی است که بتواند ویژگی های نهفته در ساختار شبکه اجتماعی را استخراج کند. ویژگی هایی که به سادگی و با معیارهای مبتنی بر نزدیکی قابل تشخیص نیستند همانطور که پیشتر اشاره شد، هر گراف شبکه اجتماعی دو منبع اطلاعاتی دارد: ساختار و محتوای شبکه اجتماعی. رویکرد مبتنی بر ویژگیهای پنهان بر این اساس عمل میکند که اطلاعات ساختاری نیز خود به دو دسته ویژگی های صریح و ویژگی های پنهان تقسیم می شوند. ویژگی های پنهان در شبکه پویا و یا ناهمگن به دلیل وجود روابط غیر خطی و پیچیده بارزتر است. ویژگی های صریح در واقع همان اطلاعات اکتشافی و ساختار کلی شبکه اجتماعی را شامل می شود اما ویژگی پنهان به دنبال خصوصیاتی است که به صراحت و با روش ساده قابل دریافت شبکه اجتماعی نیست. هدف اصلی رویکرد مبتنی بر ویژگی پنهان یادگیری مدلی است که بتواند با اطلاعات موجود ویژگیهایی را استخراج کند. هرگره در یک شبکه اجتماعی با برداری به اندازه تعداد گره های شبکه قابل نمایش است. بردار ویژگی در رویکرد مبتنی بر ویژگی های پنهان، در درون خود ارتباطات بین موجودیت ها را کد کرده است هرچه این کدگذاری دقیق تر باشد دقت تشخیص افزایش مییابد. این تعاملات با توجه به نوع شبکه می تواند الگو های تکاملی در شبکه های پویا و یا روابط غیر خطی و سطح بالا در شبکه های چند رابطه های ناهمگن باشد. حائز اهمیت است، نسبت میان بعد بردار ویژگی و هزینه محاسباتی است. در واقع هرچه طول بردار ویژه کمتر باشد هزینه محاسباتی کاهش مییابد و در عین حال دقت تحت تاثیر قرار بگیرد.
روش پیشنهادی:
از مزایای روش آدامیک/آدار درنظر گرفتن ویژگیهای مشترک بین دو گره است. همانطور که میدانیم در شبکه همگن اطلاعات محتوایی شبکه در دسترس نیست و تنهت اطلاعات ساختاری شبکه در دسترس است. به همین دلیل شاخص درجۀ گرهها مورد استفاده قرار میدهد. برای رسیدن به دقت بهتر یک شاخص جدید ارائه میدهیم به صورتیکه تمام همسایههای مشترک اطلاعات آنها اعماز تعداد کل همسایهها، تعداد همسایههای مشترک آن با گره مقصد را مورد توجه قرار دهد. این شاخص به شکل زیر است:
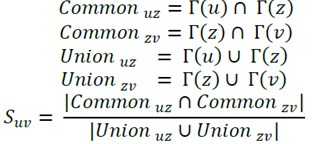
میزان شباهت بین دو گره u و v از ویژگی گرههای مسیر استفاده میکنند در نتیجه اگر دو گره همسایههی مشترک بیشتری داشته به احتمال زاید به عنوان دوست معرفی میشود. از سوی دیگر امکان دارد بین دو گره همسایگان مشترک زیادی وجود نداشته باشد ولی رابطه مستحکمی بین آن دو گره برقرار باشد در نتیجه نسبت تعداد همسایه های مشترک و تعداد کل همسایهها عدد قابل قبولی میشود.این روش دقت مناسبی دارد.
نتیجهگیری
در جدول زیر که براساس دادههای فیسبوک است که دارای 3.7kکاربر و 13.7k یال است (در سال 2009). از معیارMAP برای ارزیابی الگوریتمهای مختلف استفاده شده:
???= 1/|?|Σ1??Σ??????????@????=1|
??: تعداد کاربران مرتبط با کاربر u
??????????@?: مقدار دقت در kامین موقعیت فهرست پیشنهادها برای u
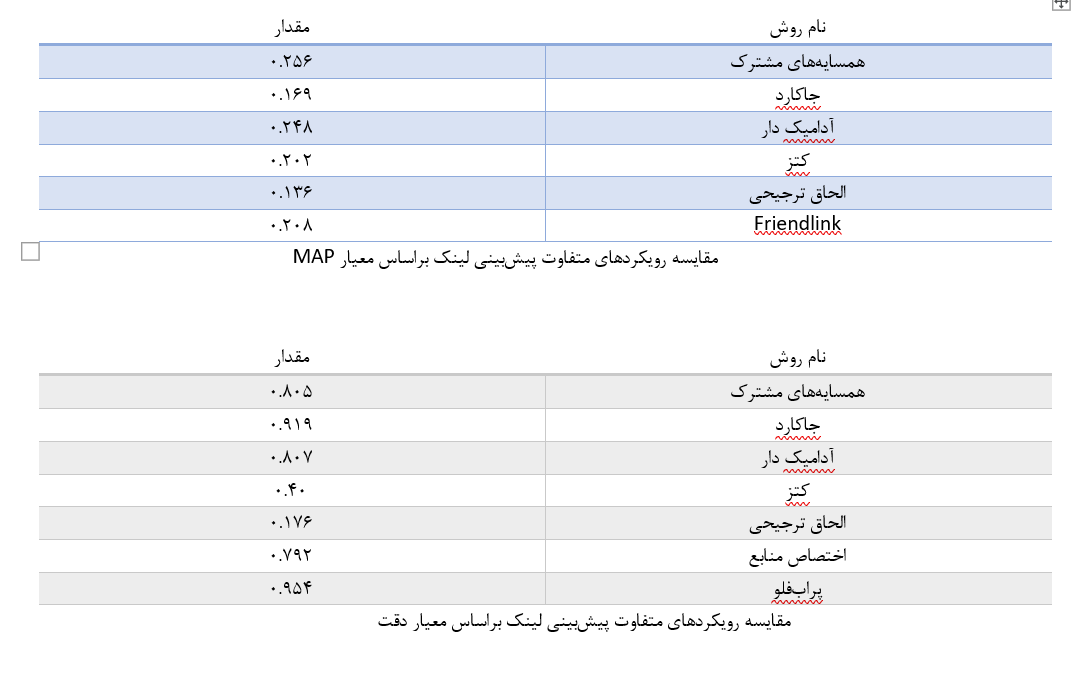
در جدول اول که طبق معیار MAP روش Friendlink (روش نیمه محلی) بهترین بازدهی را بر روی دیتاست
دارد و نیز جدول د. م که بر اساس معیار دقت میباشد روش پرتاب فلو (روش سراسری) دارای بیشترین دقت است.
منابع
[1]L. A. Adamic and E. Adar, “Friends and neighbors on the web,” Social networks, vol. 25, no. 3, pp. 211–230, 2003.
[2] L. Yao, L. Wang, L. Pan, and K. Yao, “Link prediction based on common-neighbors for dynamic social network,” Procedia Computer Science, vol. 83, pp. 82–89, 2016.
[3]P. Xu, W. Hu, J. Wu, and B. Du, “Link prediction with signed latent factors in signed social networks,” in Proceedings of the 25th ACM SIGKDD International Conference on Knowledge Discovery & Data Mining, 2019, pp. 1046–1054.
[4] D. Wang, D. Pedreschi, C. Song, F. Giannotti, and A.-L. Barabasi, “Human mobility, social ties, and link prediction,” in Proceedings of the 17th ACM SIGKDD international conference on Knowledge discovery and data mining, 2011, pp. 1100–1108.
[5] A. Özcan and Ş. G. Öğüdücü, “Multivariate temporal link prediction in evolving social networks,” in 2015 IEEE/ACIS 14th international conference on computer and information science (ICIS), 2015, pp. 185–190.
[6]T. Murata and S. Moriyasu, “Link prediction of social networks based on weighted proximity measures,” in IEEE/WIC/ACM International Conference on Web Intelligence (WI’07), 2007, pp. 85–88.
[7]F. Liu, B. Liu, C. Sun, M. Liu, and X. Wang, “Deep learning approaches for link prediction in social network services,” in International Conference on Neural Information Processing, 2013, pp. 425–432.
[8]A. K. S. Kushwah and A. K. Manjhvar, “A review on link prediction in social network,” International Journal of Grid and Distributed Computing, vol. 9, no. 2, pp. 43–50, 2016.
[9]M. A. Hasan and M. J. Zaki, “A survey of link prediction in social networks,” in Social network data analytics, Springer, 2011, pp. 243–275.
[10]S. Haghani and M. R. Keyvanpour, “A systemic analysis of link prediction in social network,” Artificial Intelligence Review, vol. 52, no. 3, pp. 1961–1995, 2019.
[11]N. N. Daud, S. H. Ab Hamid, M. Saadoon, F. Sahran, and N. B. Anuar, “Applications of link prediction in social networks: A review,” Journal of Network and Computer Applications, vol. 166, p. 102716, 2020.
[12]L. Dong, Y. Li, H. Yin, H. Le, and M. Rui, “The algorithm of link prediction on social network,” Mathematical Problems in Engineering, vol. 2013, 2013.
[13]F. Zhou, B. Wu, Y. Yang, G. Trajcevski, K. Zhang, and T. Zhong, “Vec2Link: Unifying heterogeneous data for social link prediction,” in Proceedings of the 27th ACM International Conference on Information and Knowledge Management, 2018, pp. 1843–1846.
[14] E. Bütün, M. Kaya, and R. Alhajj, “A new topological metric for link prediction in directed, weighted and temporal networks,” in 2016 IEEE/ACM International Conference on Advances in Social Networks Analysis and Mining (ASONAM), 2016, pp. 954–959.
[15] P. Wang, B. Xu, Y. Wu, and X. Zhou, “Link prediction in social networks: the state-of-the-art,” Science China Information Sciences, vol. 58, no. 1, pp. 1–38, 2015.
[16]A. Narayanan, E. Shi, and B. I. Rubinstein, “Link prediction by de-anonymization: How we won the kaggle social network challenge,” in The 2011 International Joint Conference on Neural Networks, 2011, pp. 1825–1834.
[17]D. Liben-Nowell and J. Kleinberg, “The link-prediction problem for social networks,” Journal of the American society for information science and technology, vol. 58, no. 7, pp. 1019–1031, 2007.
[18]C. Lee, B. Nick, U. Brandes, and P. Cunningham, “Link prediction with social vector clocks,” in Proceedings of the 19th ACM SIGKDD international conference on Knowledge discovery and data mining, 2013, pp. 784–792.
[19]C. A. Bliss, M. R. Frank, C. M. Danforth, and P. S. Dodds, “An evolutionary algorithm approach to link prediction in dynamic social networks,” Journal of Computational Science, vol. 5, no. 5, pp. 750–764, 2014.

