
فرآیند اندیشه و تفکر و طرز کار مغز از گذشتههای بسیار دور مورد توجه فیلسوفان و دانشمندان در همه جای جهان بودهاست. یونانیان باستان عقیده داشتند که میتوان در یک بدنه مکانیکی مغزی ساختگی قرار داد. یکی از اسطورههای یونان یک غول آهنی بود که مغزی مکانیکی داشت.آلن تورینگ یکی از تاثیرگذارترین افراد در حوزه هوش مصنوعی است و بسیاری مقالهای که او در سال ۱۹۵۰ منتشر کرد را تولد هوش مصنوعی میدانند. او همچنین تست تورینگ را پیشنهاد داد که معیاری برای تشخیص هوشمندی ماشین است. یکی از اولین پروژههای عملی هوش مصنوعی، ایده گرفتن از مفهوم شبکه عصبی و نورونها بود. دو نفر از دانشجویان دانشگاه هاروارد در سال ۱۹۵۰ اولین شبکه عصبی مصنوعی را که شامل ۴۰ نورون بود ساختند. نورونها واحدهایی یکشکل در مغز هستند که پیامهای عصبی را منتقل میکنند. جالب است بدانید شبکههای عصبی مصنوعی جدید که از آنها برای طبقهبندی تصاویر استفاده میشود دارای هزاران نورون هستند!
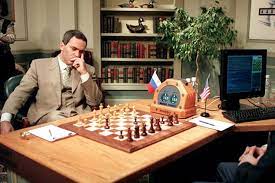
باخت کاسپاروف، قهرمان شطرنج جهان، از سیستم deep blue باعث شد تا هوش مصنوعی در کانون توجه قرار گیرد. این سیستم که توسط IBM طراحی شده بود؛ در اولین مسابقه در سال ۱۹۹۶ کاسپاروف پیروز شد اما در رقابت بعدی که در سال ۱۹۹۷ اتفاق افتاد، deep blue توانست کاسپاروف را شکست دهد. هوشمندیِ ساختگی از گذشته برای نویسندگان و فیلمسازان جذابیت خاصی داشته و به طرق مختلف از آن در آثار خود استفاده کردهاند. هوشمندی را میتوان با اشکال مختلفی تعریف کرد. در کتاب معروف «هوش مصنوعی، یک رویکرد مدرن دیدگاههای مختلف از دو بعد مورد بررسی قرار گرفتهاند. از منظر اول هوشمندی یا در رفتار است یا در تفکر و از منظر دوم هوشمندی در انسانگونه بودن یا در منطقی بودن (rationality) است. فرض کنید هوشمندی مورد نظر خود را انتخاب کردیم. قدم بعدی ساخت عامل هوشمند (intelligent agent) است. عامل میتواند سختافزاری یا نرمافزاری باشد و بر حسب محیطی که عامل قرار است در آن مورد استفاده قرار گیرد، میتواند دارای اجزای مختلفی باشد. برای مثال، عاملی که با انسان در ارتباط است باید توانایی دریافت و درک زبان طبیعی را داشته باشد و عامل فیزیکی ممکن است نیازمند بازوهای حرکتی برای انجام اعمال انتخابی باشد .
هوش مصنوعی سالهای بسیاری مورد توجه محققان و دانشمندان بوده اما در سالهای اخیر به مرحله عملیاتی شدن رسیده و به یکی از جذابترین حوزههای دانش و مهندسی بدل شده است. در آیندهای نه چندان دور، رباتهایی که از انسان، قابل تشخیص نیستند افزایش خواهند یافته هماکنون هوش مصنوعی حوزههای بسیاری را شامل میشود و همچنان در حال بزرگتر شدن است. امروزه هر برنامهای که هوشمندی داشته باشد یا به نوعی رفتار انسان را تقلید کند، به عنوان هوش مصنوعی پذیرفته میشود. یادگیری ماشین بعد از هوش مصنوعی موضوعیت پیدا کرد و آن را میتوان زیر مجموعه هوش مصنوعی در نظر گرفت. یادگیری ماشین ویژگیهایی دارد که آن را از دیگر روشهای هوش مصنوعی متمایز میکند.یکی از مهمترین ویژگیهای یادگیری ماشین، یادگیری با استفاده از داده و بدون استفاده از دستورات مستقیم است. در انواع دیگر هوش مصنوعی ممکن است شاهد نوعی از هوشمندی باشیم که از دادهها استفاده نمیکند. ویژگی دیگر یادگیری ماشین، تغییر خود با دیدن دادههای جدید است؛ یعنی همانند انسان با کسب تجربیات جدید رفتار خود را تغییر میدهد.
قدرت الگوریتمهای یادگیری ماشین امکانات بسیاری را به جامعه عرضه کرده و حوزههای بسیاری به آن وابسته شدهاند. صنعت، دانشگاه، حوزه سلامت، اقتصاد و تجارت، کسب و کارها و بسیاری دیگر، از یادگیری ماشین برای پیشبرد اهداف خود استفاده میکنند. یکی از اولین کاربردهای یادگیری ماشین در تشخیص ایمیل های spam بود. امروزه ماشینهای بدون راننده در سطح شهرها در حال حرکت هستند، صاحبانمحصول از سیستمهای پیشنهاد دهنده برای پیشنهاد محصول استفاده میکنند، اقتصاددانان برای پیشبینی روند بازار از آن استفاده میکنند و همچنان کاربردهای بیشتری در حال ایجاد شدن است.به دلیل اهمیت استفاده از الگوهای داده در تصمیمگیری شرکتها، شغلهای مرتبط با داده به یکی از جذابترین شغلهای حاضر تبدیل شدهاند. یکی دیگر از عوامل جذاب شدن یادگیری ماشین در عصر حاضر، توجه ویژه برنامهنویسان و شرکتهای برنامهسازی به آن است. زبان پایتون و R از محبوبترین زبانهای قابل استفاده برای یادگیری ماشین هستند و کتابخانههای بسیار قدرتمندی در این زبانها برای رفع نیازهای علاقهمندان این حوزه در حال گسترش است. افرادی که قصد ورود به این زمینه را دارند با دریایی از زبانها و کتابخانهها و ابزارها روبرو میشوند و متناسب با نیاز خود میتوانند از آنها بهره ببرند. با درک اهمیت دانش و اطلاعات، بسیاری به فکر استفاده از دادههای موجود افتادند و سعی کردند در تصمیمگیریها از نتایج تحلیل داده استفاده کنند. از گذشته تحلیل و ارزیابی اطلاعات شرکتها از اهمیت فوقالعاده برخوردار بودهاست و همیشه آمار و گزارشهای یک شرکت در تصمیمات آینده آن تاثیرگذار بودهاند. نیاز جامعه به بررسی آمار و دادهها سبب به وجود آمدن تخصصهایی در این زمینه شد. افرادی در سازمانها مشغول به کار شدند تا امور مرتبط با داده را انجام دهند. بسته به نوع فعالیت افراد اسامی مختلفی به آنها نسبت داده میشود. تحلیلگر داده، معماری مناسب برای جمعآوری اطلاعات یک سازمان را طراحی میکند و پایگاه داده مناسب برای این کار را انتخاب میکند؛ دادههای خام را از منابع داخلی و خارجی جمعآوری میکند و پس از آمادهسازی و انتخاب قالب مناسب، آنها را در پایگاه دادهای که طراحی کرده ذخیره میکند.سپس دادهها را مورد بررسی قرار میدهد و از داده اطلاعات مفید استخراج میکند. او برای اینکار باید اطلاعاتی در مورد زمینه فعالیتهای سازمان و اهداف آن داشته باشد. نتیجه فعالیتهای تحلیلگر داده میتواند گزارشهای کلی یا روابط بین دادهها باشد و معمولا در جهت اهداف سازمان است. داشتن مهارتهای برنامهنویسی برای تحلیلگر داده ضروری نمیباشد و میتواند از نرمافزارها یا سرویسهای وب برای انجام کارهای خود استفاده کند. دانشمند داده سطح بالاتری از تحلیلگر داده دارد و نیازمند دانش آماری و ریاضیاتی و برنامهنویسی قویتری نسبت به تحلیلگر داده است. همه اموری که تحلیلگر انجام میدهد، دانشمند هم میتواند انجام دهد و علاوه بر آن باید با مفاهیم یادگیری ماشین و دانش برنامهنویسی آشنا باشد تا بتواند ابزارهایی برای تحلیل عمیقتر داده طراحی کند. مدیریت جریان های داده و یکپارچهسازی آن در شرکتهای بزرگ تبدیل به تکلیف جدیدی شد و به تدریج نیاز به مهندسین داده پررنگ تر شد و شغل جدیدی بهوجود آمد. این جایگاه جدید دادهها را از منابع مختلف و با قالبهای مختلف میگیرد و در اختیار تحلیلگران و توسعهدهندگان و دیگر مصرفکنندگان داده قرار میدهد. مهندس یادگیری ماشین در واقع نقطهی تلاقی مهندسی نرمافزار و علم داده است. این موقعیت هم همانطور که حدس زدید بسیار حرفهای است. مهندس یادگیری ماشین نقاط مشترک فراوانی با مهندس داده دارد. ر دو در فرآیند رسیدن داده از محل تولید تا مدل نقش داشته و با ساختارهای داده و پیچیدگیهای مرتبط با آن آشنایی دارند. مهندس یادگیری ماشین علاوه بر اینکه داده را تا رسیدن به مدل همراهی میکند، مسئول رساندن خروجی به کاربر نهایی نیز هست. وظایف مهندس یادگیری ماشین جنبه نظری و عملیاتی دارند. به این صورت که او باید دانش کاملی از الگوریتمها و روشهای یادگیری ماشین داشته باشد. صنایع معدنی با توجه به عدم قطعیت بالا و حجم بسیار زیاد اطلاعات جزو صنایع پیچیده به حساب می آید. لذا یادگیری ماشین و هوش مصنوعی در این صنایع با پیشرفت تکنولوژی بیش از پیش مورد استفاده قرار گرفته است استفاده از یادگیری ماشین در صنایع معدنی ایران قدمت زیادی ندارد، اما سرعت رشد این تکنولوژی در صنایع با توجه به نتایج قابل قبولِ گرفته شده بالا میباشد.
چهار کاربرد از یادگیری ماشین در معدن :پردازش تصاویر ماهواره ای - پیشبینی متغیرهای ژئومتالورژیکی-آنالیز تصاویر مربوط به جعبه مغزهها-پردازش تصاویر گرفتهشده از پهپاد برای شناسایی هدفهای از پیش تعیین شده
پس از آشنایی با مفاهیم یادگیری ماشین و به دست آوردن اطلاعاتی برای تحلیل داده لازم است با تکنیکهای حل مسائل مخت را برسی میکنیم. انتخاب ویژگیهای مناسب از داده، برای استفاده در مدلسازی - مدلسازی مانند طبقه بندی یا ، تخمین - ارزیابی دقت مدل یادگیری ماشین
درک ریاضیات پشت صحنه مدلهای یادگیری ماشیندر دهههای هفتاد و هشتاد میلادی در خانه هرکسی کامپیوتر نبود و افراد کمی به اینترنت دسترسی داشتند. در آن دوره تکنیکهای یادگیری ماشین در حال ارتقا و گسترش بودند تا الگوهای موجود در داده را بهتر و سریعتر پیدا کنند. با توجه به شرایط آن دوره، این تکنولوژی به شکلی محرمانه توسط مهندسان و دانشمندان حوزه کامپیوتر در حال گسترش بود. به عقبتر برگردیم. فرض کنید دهه پنجاه میلادی است و چیزی به نام یادگیری ماشین وجود ندارد. در آن دوره یکی از مهندسان IBM که نامش آقای آرتور ساموئل بود، برای اولین بار از کلمه یادگیری ماشین استفاده کرد و تعریف زیر را برای آن ارائه دادیادگیری ماشین زمینهای از تحقیقات است که به کامپیوترها توانایی یادگیری بدون برنامهنویسی صریح را میدهد. دادهها عنصر محوری یادگیری ماشین هستند و ماشینها از دادهها یاد میگیرند، به این صورت که ما دادهها را به عنوان ورودی به الگوریتم میدهیم تا خروجی مورد نیازمان را دریافت کنیم. داده، در نتیجه مشاهدات و اندازهگیریها شکل میگیرد و توصیف این وضعیت مشاهده شده به شمار میآید. یکی از شگفتانگیزترین تواناییهای انسان، استفاده از زبان طبیعی برای نگهداری و تبادل مفاهیم و اطلاعات است. تحقق توانایی پردازش زبان طبیعی برای ماشینها میتواند باعث تحول بزرگی شوددادهای که پردازش زبان طبیعی با آن کار میکند، جملات و کلمات تولید شده توسط انسانها هستند.
تشخیص گفتار: تشخیص گفتار، برقراری ارتباط با کامپیوترها را از طریق حرف زدن عادی ممکن میسازد و خود دریچهای به سایر کاربردهای هوش مصنوعی است.
دستهبندی نوشتارها یا نظرات: مثلاً در یک فروشگاه اینترنتی نظرات مثبت و منفی و نقاط قوت و ضعف هر کالا میتواند به این صورت دستهبندی شود.
پاسخ دادن به سوالات: چیزی که گاهی هنگام جستجو در گوگل با آن مواجه میشویم.
از میان حوزههای مختلف یادگیری ماشین، بینایی ماشین پیشرفت خیرهکنندهای را در سالهای اخیر داشته و در تکنولوژیهای روزمره به صورت گسترده استفاده میشود. دادهای که در این قسمت با آن سر و کار داریم تصاویر ثبت شده توسط دوربینهای مختلف عکسبرداری یا فیلمبرداری هستند. در مورد بعضی از انواع داده، تغییرات آن و در نتیجه مقدار آن در طول زمان اهمیت ویژهای دارد. ماشین میتواند با دیدن تغییرات ویژگی مشخصی از یک داده در طول زمان، الگوی تغییرات آن را یاد بگیرد
برای حل مسائل پیچیدهتر نیز باید بتوانیم از مدلها و ابزارهای پیشرفتهتر استفاده کنیم : مدلهای پیشرفته (شبکههای عصبی و …) - ریاضیات کاربردی پیشرفته - کاربردهای پیشرفته یادگیری ماشین (سیستمهای پیشنهاد دهنده، دستهبندی متون و …)
یادگیری ماشین با برنامه نویسی صریح تفاوت دارد. زیرا در برنامه نویسی ساده برنامه نویس باید الگوهای متفاوت را خودش تشخیص داده و به صورت دستی برای آن برنامه نویسی کنیم اما در یادگیری ماشین، ما صرفا مدلی را طراحی میکنیم که این مدل خود قادر به یادگیری و پیدا کردن الگوها به طور اتوماتیک است. در حالاتی که مساله مورد نظر پیچیده میشود، پیدا کردن این الگوها برای انسان اغلب دشوار یا حتی غیر ممکن میشود اما برای ماشینها به دلیل قدرت پردازشی بالا این کار بسیار سادهتر است و این موضوع دلیل اصلی شهرت یادگیری ماشین میباشد. الگوریتمهای یادگیری ماشین، مثل انسان با کمک تجربه یاد میگیرند. داده همان تجربهای است که به عنوان ورودی به الگوریتم داده میشود.
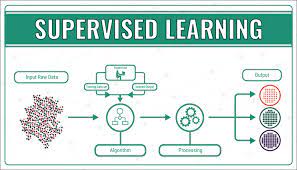
تام میشل یاد گیری ماشین را اینگونه بیان میکند :اگر کارایی برنامه در انجام تکلیف T که با سنجه P ارزیابی میشود، با تجربه E افزایش یابد، میگوییم که برنامه یاد گرفته است از تجربه E با توجه به تکلیف T و سنجه P استفاده کند. تکلیف T در واقع همان مسالهای است که ما انتظار داریم بتوانیم با یادگیری ماشین حل کنیم. تجربه Eبرای انجام فرایند یادگیری، که منجر به حل تکلیف T میشود، ما نیازمند تعدادی نمونه (sample) هستیم که اطلاعات مورد نیاز در مورد مساله را به ما میدهند. سنجه Pهر مدل یادگیری ماشینی که طراحی کنیم، به هرحال به طور ۱۰۰ درصدی نتیجه درست و مناسبی را ارائه نمیدهد بنابراین به معیاری برای بررسی و اندازهگیری میزان دقت این الگوریتم نیاز داریم تا در صورت نامناسب بودن دقت آن، با تغییر پارامترهای الگوریتم بتوانیم به دقت بالاتری برسیم. به طور کلی رویکرد انجام یادگیری ماشین، دارای ۴ عنصر اساسی است: 1-یک الگوریتم (مدل) برای تصمیمگیری 2-یک معیار برای امتیازدهی اینکه عملکرد مدل چقدر خوب بوده 3- بررسی خودکار کیفیت مدل بر اساس امتیاز 4-یک روش خودکار برای بهبود امتیاز بر اساس ایجاد تغییرات در مدل . همان طور که از اسم «یادگیریماشین» مشخص است، تمرکز این حوزه، یادگیری یعنی کسب مهارت یا دانش از طریق تجربه کردن است. به همین دلیل، انواع مختلفی از یادگیری وجود دارد و شما به عنوان فردی که وارد این زمینه شده است، با آنها روبرو خواهید شد. دستهبندیهای متعددی بر اساس معیارهای مختلف ارائه شده است و دانستن آن برای شخصی که به تازگی وارد این حوزه شده است، لازم نیست؛ اما به طور کلی یادگیری ماشین به سه دسته کلی تقسیمبندی می شود : یادگیری بانظارت - یادگیری بینظارت - یادگیری تقویتی.فرض کنید که کامپیوتر یک بچه است و ما ناظر او، به طور مثال والد یا معلم هستیم. ما میخواهیم به این کودک یاد بدهیم که یک خروس چه شکلی است. برای این کار، ما تعدادی عکس که بعضی از آنها عکس خروس، و بعضی حیوانات دیگری هستند به کامپیوتر نشان میدهیم. وقتی که ما عکس خروس را نشان میدهیم، جمله «این خروس است» را صدا میزنیم و وقتی عکسهایی که خروس نیستند را نشان میدهیم، جمله «این خروس نیست» را میگوییم. به این روش یادگیری، یادگیری نظارتشده میگوییم. در این نوع از یادگیری، نمونههایی که برای آموزش الگوریتم استفاده میشوند، دارای برچسب هستند. به این معنا که مدل یادگیریماشین با استفاده از دادههایی که از قبل برچسب مشخصی دارند. در طبقهبندی، هدف ما پیدا کردن برچسب یا دسته مناسب برای نمونههای بدون برچسب میباشد. برای این کار، ما مدل یادگیری ماشینی را با استفاده از نمونههای برچسبدار، آموزش میدهیم. بر اساس این یادگیری، مدل یادگیریماشین میتواند، مجموعهدادگان را به دستههای مختلف تقسیم کند. رگرسیون در رگرسیون، هدف ما تخمین مقدار یک ویژگی (این بار مقداری پیوسته) برای یک نمونه میباشد. این الگوریتمها برای پیشبینی روند بازار، قیمت خانه و دیگر مثالها به کار میروند . تفاوت طبقهبندی و رگرسیون همانطور که دیدید هر دو دسته یاد میگیرند تا برچسب دادهها را پیشبینی کنند و تنها تفاوت میان این دو دسته، به نوع این برچسب بستگی دارد. در الگوریتمهای طبقهبندی برچسبی که میخواهیم پیشبینی کنیم به صورت متغیری گسسته میباشد. یادگیری بینظارت تفاوت این نوع از یادگیری با یادگیری نظارتشده، تنها در نبودن برچسبها است. به عبارت دیگر، هیچ ناظر (برچسب) به کودک (کامپیوتر) نمیگوید که چه زمانی درست پیشبینی کرده است و چه زمانی مرتکب اشتباه شده است. در این روش یادگیری، مدل به تنهایی و بدون کمک برچسبهایی که در روش نظارتشده دیدیم، باید الگوهای پنهان را پیدا کند. الگوریتمهای یادگیری ماشین بینظارت، که در آن مدل بدون دخالت انسان و با دادههای بدون برچسب، الگوهای پنهان بین دادهها را پیدا میکند، به طور کلی به سه دسته خوشهبندی ، کاهش ابعاد و استخراج قانون وابستگی تقسیمبندی میشود. نکته مهم این است که یک دانشمند علم داده، زمینه کاری مسئله (problem domain) خود را به خوبی بشناسد و بتواند الگوریتم درست را انتخاب کند.
خوشهبندی به معنی دستهبندی اتوماتیک دادهها به خوشههای همگن است، به این صورت که دادههای هر خوشه، ویژگیهای یکسانی داشته باشند. اولین گام برای خوشهبندی دادهها، انتخاب کردن معیاری برای خوشهبندی است. در ساده ترین حالت، روش کاهش ابعاد یعنی کاهش دادن تعداد ویژگیهایی که از آنها برای آموزش مدل یادگیری ماشین خود استفاده میکنیم. به طور مثال، کاهش دادن تعداد ستونهای یک دیتاست جدولی، حالتی از کاهش ابعاد است. یادگیری تقویتی، یکی از روش های یادگیری ماشین است که با ذهنیت آزمون و خطا کار میکند. عامل هوشمند طبق حالت جاری ، حرکتی انجام میدهد و بر اساس آن حرکت بازخورد دریافت میکند؛ این بازخورد ممکن است مثبت یا منفی باشد و عامل با این بازخورد خطمشی خود را تغییر میدهد. این روش از یادگیری نزدیکترین حالت به یادگیری انسان است. یادگیری تقویتی برخلاف یادگیری بانظارت و یادگیری بینظارت وابسته به داده نیست، بلکه به واسطه تعامل با محیط میآموزد. برای بررسی دقت مدل آموزش داده شده )یا اصطلاحا سنجه p مدل(، باید پاسخهای آن را روی دادهی جدیدی تست کرد. اما همانند امتحان ممکن است شما برخی سوالات را بهتر بتوانید پاسخ دهید و صرفا استفاده از یک سوال برای تعیین میزان یادگیری شما نادرست باشد پس بهترین روش، استفاده از تعداد زیادی سوال مختلف و سپس محاسبهی دقت مدل روی تمامی آنهاست. به همین دلیل است که معمولا تعدادی از دادگان برای انجام ارزیابی کنار گذاشته میشوند و از باقی آنها برای آموزش مدل استفاده میشود. اصطلاحا به دادگانی که برای آموزش استفاده میشوند، دادگان آموزش (train) و به دادگانی که برای ارزیابی استفاده میشوند، دادگان آزمایش (test) میگوییم.
پایتون یک زبان برنامه نویسی است که در اوایل دههی ۹۰ میلادی، توسط خیدو فان روسوم درهلند اختراع شد. از زمان اختراعش تا امروز پایتون به عنوان یک زبان برنامه نویسی سطح بالا در توسعهی برنامههای وب و موبایل و همچنین در آنالیز داده و محاسبات علمی به کار رفته است. جامعهی بزرگ توسعه دهندگانِ پایتون و ابزارهای متن بازِ(open source) متعدد برای این زبان، میتواند کمک بزرگی برای برنامه نویسان این زبان باشد. در سالهای اخیر ابزارهای زیادی مخصوصا در حوزهی علم داده برای پایتون توسعه داده شده است که آنالیز کردن دادهها را از همیشه آسانتر میسازد. پایتون در همهی حوزههای علم داده دارای کتابخانههای متعددی است که اکثر آنها توسط شرکتهای بزرگ یا دانشگاهها پشتیبانی و دائما بهروزرسانی میشوند. تعدادی از مهمترین کتابخانههای پایتون برای علم داده را در بخش کتابخانههای علم داده در پایتون خواهیم دید. ایتون به نسبت زبانهای دیگر نوشتار سادهتری دارد و به همین دلیل سریع قابل یادگیری است و این باعث میشود کار، به خصوص در پروژههای بزرگ، راحتتر شود.پرکاربردترین کتابخانههای پایتون : نامپای (Jumpy)داده از منابع مختلفی جمعآوری میشود و ممکن است قالبهای مختلفی (عکس، متن، صدا و ...) به خود بگیرد اما در نهایت به شکل آرایهای از اعداد درمیآید. ذخیرهسازی و پردازش بهینه آرایههای عددی از اهمیت بسیاری برخوردار است. پانداس (Pandas)یکی دیگر از کتابخانههای مهم اکوسیستم کار با داده پایتون، پانداس میباشد که از نامپای در بطن خود استفاده میکند. در پانداس ساختار اصلی داده به شکل دیتافریم (data frame) است که در واقع یک آرایه دوبعدی است که در آن سطرها و ستونها عنوان دارند. متپلاتلیب(Matplotlib)ساخت نمودارهایی که بتوانند اطلاعات را به خوبی انتقال دهند یکی از مهمترین کارها در تحلیل داده است. برای مثال، مشاهده روند داده و تشخیص دادههای پرت از روی نمودار به راحتی امکانپذیر است. کتابخانههای بسیاری برای مصورسازی داده در پایتون وجود دارد اما متپلاتلیب از همه پرکاربردتر است. سایکتلرن (scikit-learn)پروژه سایکتلرن در سال ۲۰۰۷ آغاز شد و پس از آن با همکاری برنامهنویسان به شکلی متن باز در حال گسترش است. این کتابخانه معروفترین و پرکاربردترین کتابخانه یادگیری ماشین در پایتون میباشد و از محبوبیت بسیاری برخوردار است.
یادگیریماشین به شرکتها این امکان را میدهد که کارهایی که قبلاً تنها توسط انسانها امکانپذیر بود را با سرعت بالاتر و دقت بیشتر انجام دهند، از یادگیریماشین حتی برای حل کردن مشکلات بزرگتر مانند تشخیص تصاویر در اتومبیلهای خودران، پیشبینی زمان وقایای طبیعی نیز استفاده میشود، به همین دلیل یادگیریماشین اهمیت بسیار بالایی دارد. اکنون دلیل موفقیت بسیاری از صنایع در حال توسعه، مدل های یادگیری ماشین بسیار قوی هستند که قادر به تجزیه و تحلیل دادههای بزرگتر و پیچیدهتر هستند. با داشتن این مدلهای دقیق، یک سازمان شانس بیشتری در شناسایی فرصتهای سودآور یا جلوگیری از خطرات ناشناخته دارد. داده اساس یادگیریماشین است و هیچ الگوریتم و مدلی با داده بد نمیتواند عملکرد خوبی داشته باشد. داده بیکیفیت پر است از مقادیر اشتباه و گمشده. همواره باید سعی در انتخاب ویژگیهایی داشته باشیم که مدل بتواند از آنها بیاموزد و از دل آنها الگوهایی برای پیشبینی آینده استخراج کند. منظور از داده نامناسب آن است که داده به قدری بیکیفیت است که اطلاعات دقیق و جامعی از هدفی که قصد مدل کردن آن را داریم به دست نمیدهد. زمان در یادگیریماشین از دو جهت اهمیت دارد؛ هم مدت زمانی که طول میکشد تا آموزش مدل تمام شود، هم زمانی که مدل برای پیشبینی نمونهها مصرف میکند. مدت زمانی که طول میکشد تا آموزش مدل تمام شود، طول مدت توسعه محصول را تحت تاثیر قرار میدهد و زمان مصرفی توسط مدل برای پیشبینی نمونهها زمانی است که کاربر نهایی تجربه میکند. نحوه حل سوالات در یادگیری ماشین به این صورت است: 1-خواندن داده از فایل csv 2-تغییر واحد دادهها 3-مصورسازی داده 4- ساختن دادگان آموزش وآزمایش 5- انتخاب مدل مناسب وآموزش 6-تخمین مقادیرتست وارزیابی عملکرد مدل
امروزه شاهد پیشرفتهای بزرگی در زمینهٔ هوش مصنوعی هستیم اما همچنان با آنچه در فیلمها و داستانها از یک عامل هوشمند متصوریم که در انجام کارهای گوناگون از توانایی مشابه انسان برخوردار است فاصله داریم. عاملهای هوشمندی که امروزه ساخته میشوند معمولا در حل یک مسئله خاص به هوشمندی رسیدهاند. مثل تشخیص انسانهای داخل تصویر یا انجام بازی شطرنج. به این نوع از هوش مصنوعی، هوش مصنوعی محدود یا ضعیف اطلاق میشود. در مقابل، آنچه هوش مصنوعی عمومی (artificial general intelligence) و یا قوی نامیده میشود، عبارت است از ساختن عامل هوشمندی که مانند انسان از هوشی عمومی برخوردار باشد که توانایی آموختن در مواجهه با هر مسئله جدیدی را داشته باشد و محدود به یک زمینه یا مسئله خاص نباشد. دستیابی هوش مصنوعی عمومی، آرزوی بلندپروازانهایست اما به طور جدی مورد توجه قرار دارد. در ادامه تحولات شگفتی که برای هوش مصنوعی پیشبینی میشود، از نقطهای نام برده میشود که هم با شکوه و هم دلهره برانگیز است و آن نقطه تکینگی فناوری (technological singularity) است. زمانی که پیشرفت تکنولوژی به نقطهای غیرقابل کنترل و برگشتناپذیر برسد که تمدن انسانی را تحت تاثیر قرار دهد. از مثالهای چنین پیشرفتی که میتواند شگفت انگیز یا خطرناک باشد، ادامه دار بودن افزایش قدرت پردازشی و تحقق هوش مصنوعی عمومی است. اگر انسان بتواند یک موجود هوشمندتر از خود پدید آوردچه کسی میداند تا کجا پیش میرودچنین اتفاقی میتواند تبدیل به یک انفجار هوش شود و به یک عامل فراهوشمند بیانجامد که هوش تمام بشریت را پشت سر میگذارد. بسیاری از صاحب نظران معتقدند تا سالهای دهه ۲۰۴۰-۲۰۵۰ شاهد چنین تحولات شگرفی خواهیم بود. کتابهای بسیاری برای آموزش یادگیری ماشین منتشر شدهاند که هر کدام رویکرد خاص خود را به این موضوع دارند. از زمان پیدایش یادگیری ماشین تا سالهای اخیر اکثر کتابها جنبه آکادمیک داشتند و بیشتر در صدد شفافسازی الگوریتمها و آموزش ریاضیات و آمار مورد نیاز برای استفاده از روشها بودند. پس از گسترش ابزارهای نرم افزاری یادگیری ماشین که به نوعی دید جعبه سیاه به الگوریتمهای یادگیری ماشین داشتند، کتابهایی با هدف آموزش استفاده از این ابزارها منتشر شد و در آنها دیگر خبری از ریاضیات و آموزش مفاهیم پیشرفته نبود.
منبع (https://quera.ir/college/land/college/8522/)

