
معماری نرمافزار در سیستمهای مدرن، چیزی فراتر از نمودارها و مدیریت ارتباطات اجزای سیستم است؛ مجموعهای از تصمیمها، توجیهات و Trade-offهایی است که در طول زمان پراکنده، فراموش یا از واقعیت سیستم عقب میمانند. ظهور مدلهای زبانی بزرگ (LLM) و سیستمهای تولید افزوده با بازیابی (RAG) این امکان را فراهم کرده که بخش قابلتوجهی از این فرآیندها — از جمعآوری دانش معماری تا تولید اسناد تصمیم، تحلیل وابستگیها، مستندسازی زنده، شناسایی بدهی فنی و حتی طراحی اولیه معماری — تا حد زیادی خودکار شود. این گزارش با مرور ابزارها و چارچوبهای پژوهشی اخیر(از جمله RAG معماری، ADR خودکار، SAVAT، Infragenie، ServLessSense، ArchiLLM و حلقه MAPE-K مبتنی بر هوش مصنوعی عاملمحور)، تصویری ساختاریافته از این حوزه نوظهور ارائه میدهد و در نهایت نشان میدهد که نقطه اشتراک همه این رویکردها یک اصل ثابت است: هوش مصنوعی جایگزین معمار نمیشود، بلکه معماری را برای معمار قابل مشاهدهتر، قابل تحلیلتر و قابل دفاعتر میکند.
۱. چرا دانش معماری نرمافزار گم میشود؟
مدیریت دانش معماری (Architectural Knowledge Management یا AKM [۲]) وظیفه ساماندهی، یکپارچهسازی و بازیابی اطلاعات حیاتی مربوط به ساختار، رفتار و منطق زیربنایی یک سیستم را بر عهده دارد. این دانش معمولاً در چهار دسته جای میگیرد:
دانش ساختاری — وابستگیهای سیستم و نگاشت قابلیتها
دانش منطقی — تصمیمات طراحی و توجیهات آنها
دانش رفتاری — الگوهای استفاده و انحرافات سیستمی
دانش بافتی — محدودیتهای سازمانی، سیاستها و انتخابهای تاریخی
مشکل اینجاست که در پروژههای واقعی، بخش عمده این دانش هرگز بهصورت سیستماتیک ثبت نمیشود. قسمتی از آن در جلسهها گفته میشود، بخشی در تیکتها و Pull Requestها گم میشود، بخشی فقط در کد قابل ردیابی است و بخش قابلتوجهی هم صرفاً در ذهن افراد باقی میماند. از طرف دیگر، خود سیستم مدام تغییر میکند اما مستندات معماری معمولاً از آن عقب میمانند. نتیجه این وضعیت، شکافی است که با گذر زمان عمیقتر میشود و به آن فرسایش یا انحراف معماری (Architectural Drift) [۳] گفته میشود: فاصلهای که بهمرور بین معماری مستندشده روی کاغذ و معماری واقعی که در کد و زیرساخت پیاده شده ایجاد میشود.
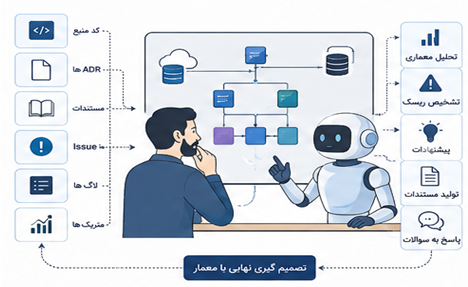
اینجاست که هوش مصنوعی مولد وارد میشود؛ نه بهعنوان جایگزین معمار، بلکه بهعنوان دستیاری برای جمعآوری دانش، تحلیل ساختار، پیشنهاد گزینهها و زنده نگهداشتن مستندات. مسیر تکاملی معماری نرمافزار — از سیستمهای یکپارچه (Monolithic) در دهههای ۱۹۹۰ تا معماریهای سرویسگرا، ریزخدمات، Cloud Native و Serverless همواره با افزایش پیچیدگی همراه بوده است. نسل تازهای که اکنون شکل میگیرد، معماریای است که در آن تعامل میان توسعهدهنده و سیستم عمدتاً از طریق زبان طبیعی انجام میشود و بخش قابلتوجهی از فرآیند تحلیل و طراحی بهصورت خودکار صورت میگیرد.
با این حال باید تاکید کرد ابزارهایی مانند GitHub Copilot که عمدتاً در سطح تولید قطعهکد عمل میکنند، فاقد درک جامع از ساختار کلی سیستم هستند؛ چون بر پایه احتمال وقوع کلمات بعدی آموزش دیدهاند، نه یک مدل مفهومی دقیق از معماری. به همین دلیل، نسل جدید چارچوبهای معماری بهجای تکیه بر یک مدل زبانی تنها، از رویکردهای چندعاملی (Multi-Agent) استفاده میکنند تا پیش از تولید کد، ساختار منطقی سیستم را طراحی و اعتبارسنجی کنند.
۲. از RAG سنتی تا فرمتهای دانش ساختاریافته
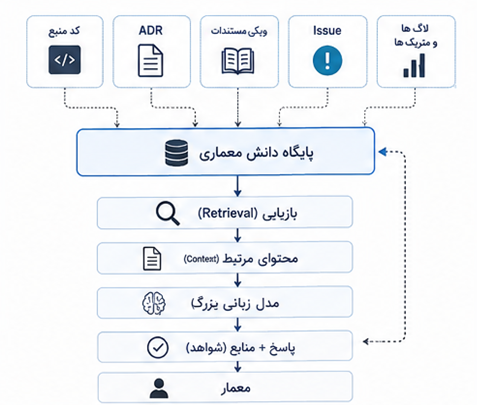
بهجای تکیه بر حافظه استاتیک مدلهای زبانی که مستعد توهم (Hallucination) هستند، معماری RAG اطلاعات را از منابع معتبر و بهروز پروژه استخراج کرده و بهعنوان بافتار (Context) در اختیار مدل قرار میدهد. در سادهترین حالت، اسناد معماری، ADRها، نیازمندیها، صورتجلسهها و مستندات فنی Chunk و Embedding میگیرند و در یک Vector Store ذخیره میشوند؛ هنگام پرسش، سیستم بخشهای مرتبط را بازیابی و همراه با ارجاع منبع به مدل زبانی میدهد. مزیت اصلی این است که پاسخ به سوالی مثل «چرا این سرویس جدا شد؟» یا «چرا این تصمیم درباره پایگاه داده گرفته شد؟» دیگر حدس مدل نیست، بلکه بر پایه شواهد واقعی پروژه است — و همیشه باید توسط معمار تایید شود.
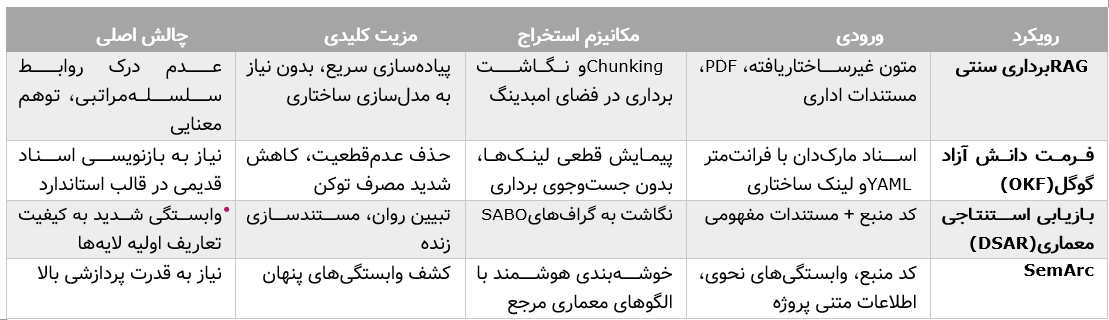
خط لولههای پیشرفتهتر مانند رویکرد «از پراکنده به ساختاریافته» (From Scattered to Structured) یک قدم جلوتر میروند: بهصورت خودکار دانش را از اسناد ناهمگون استخراج میکنند، میان آنها پیوندهای ردیابی (Trace Links) میسازند، تناقضات را شناسایی و حل میکنند و همه چیز را در یک پایگاه دانش منسجم ادغام میکنند. در سطحی پیشرفتهتر، فرآیند بازیابی استنتاجی معماری نرمافزار (DSAR) [۵] با ترکیب استخراج پایینبهبالا از روی کد منبع و توصیفات مفهومی بالابهپایین، مدلی غنیشده از سیستم را در قالب گرافهای ویژگی نامگذاریشده (SABO) میسازد — بستری که برای آشناسازی توسعهدهندگان تازهوارد (Onboarding) و نگهداری سیستمهای پیچیده بسیار کاربردی است.
روش دیگر، متدولوژی SemArc [۴] است که با تلفیق کد منبع، مستندات متنی و تحلیل وابستگیهای پنهانِ ناشی از ویژگیهای پویای زبانهای برنامهنویسی (مثل چندریختی و بازتاب)، بازسازی معماری را از طریق خوشهبندی هوشمند خودکار میکند. ابزارهایی مانند ExArch (استخراج نام کامپوننتها از مستندات و کد) و ArTEMiS (تطبیق موجودیتهای متنی با مدلهای معماری) نیز نیاز به مدلسازی دستی و پرهزینه را از بین میبرند. در کنار اینها، فرمتهای سبکتری مثل «فرمت دانش آزاد گوگل» (OKF) [۷] — که بر پایه نمایههای YAML و پیوندهای بومی مارکدان است — با حذف وابستگی به موتورهای جستوجوی برداری ناپایدار، سربار پردازشی و هزینه توکن را بهشدت کاهش میدهند.
۳. اسناد تصمیمگیری معماری (ADR): از گفتوگوی پراکنده تا سند قابل بازبینی
اسناد تصمیمگیری معماری (ADR) مصنوعاتی حیاتیاند که تاریخچه فنی یک سیستم و علت اتخاذ تصمیمات خاص طراحی را ثبت میکنند — میتوان معماری نرمافزار را در واقع مجموعهای از همین تصمیمات فنی دانست. با وجود مزایای اثباتشده ADR در شفافیت و کار تیمی، نگارش مداوم آن به دلایلی مثل زمانبر بودن، قطع شدن روند طراحی و ناتوانی تیم در تشخیص «چه چیزی نیاز به مستندسازی دارد»، در عمل بسیار محدود میماند.
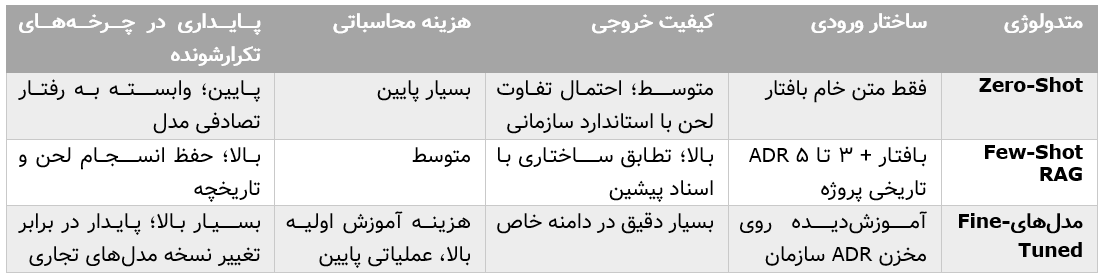
یک ADR استاندارد باید چهار پرسش را پاسخ دهد: بافتار (Context) — وضعیت موجود چه بود؟ گزینهها (Options) — چه راهحلهایی بررسی شد؟ تصمیم (Decision) — چه انتخابی صورت گرفت؟ و پیامدها (Consequences) — نتایج مثبت و منفی این انتخاب چه بود؟ مدلهای زبانی میتوانند با دریافت شرح کوتاهی از بافتار مسئله، پیشنویس این بخشها را تولید کنند. ارزیابیهای تجربی نشان میدهد مدلهایی مانند GPT-4 [۱] در حالت بدوننمونه (Zero-Shot) نتایج باکیفیتی میدهند، در حالی که مدلهای ارزانتر مثل GPT-3.5 وقتی با چند نمونه راهنما (Few-Shot) تغذیه شوند، یا مدلهای سبکتر مثل Flan-T5 پس از تنظیم دقیق (Fine-Tuning)، میتوانند به سطح رقابتی برسند.
در توسعه بهکمک عاملهای هوشمند کدنویسی، اهمیت ADR دوچندان میشود، چون این عاملها فاقد حافظه بلندمدت میان گفتگوها هستند؛ وجود یک مخزن سازمانیافته از تصمیمات معماری (مثلاً پیوندیافته در فایلهای راهنمایی مثل CLAUDE.md) مرز مجاز بهینهسازی محلی را برای عامل مشخص میکند و از نقض ناخواسته قوانین کلان سیستم جلوگیری میکند. لازم است بین توسعه سندمحور (Spec-Driven Development) [۹] — که به «چه چیزی باید ساخته شود» میپردازد — و فرآیند ADR که به «چرا این مسیر انتخاب شد» پاسخ میدهد، تمایز روشنی قائل شد؛ تلفیق این دو، بستر اطلاعاتی کاملی برای توسعهدهندگان انسانی و هوش مصنوعی فراهم میسازد.
۴. دیدن تصویر واقعی سیستم: تحلیل اثر تغییرات با SAVAT
معماریهای ریزخدمات بهدلیل ماهیت توزیعشده و استقرار مستقل سرویسها، همیشه در معرض یک خطر پنهاناند: روی نمودار ممکن است سرویسها مستقل بهنظر برسند، اما در عمل Coupling بالا یا چرخه وابستگی پنهان داشته باشند. تحلیل سنتی کد منبع، چون معمولاً بر یک مخزن منفرد متمرکز است، از درک تعاملات شبکهای میان سرویسها ناتوان میماند.
ابزار SAVAT [۱۴] (Software Architecture Visualization and Analysis Tool) دقیقاً برای همین شکاف طراحی شده است: با استفاده از زیرساخت GraalVM Native Image و بدون نیاز به مانیتورینگ سنگین زمان اجرا، بایتکد سیستم را تحلیل میکند و دو نمای موازی میسازد — نمای دامنه (ساختار دادهها در قالب Context Maps) و نمای خدمات (ارتباطات سطح کلان سرویسها در قالب Service Dependency Graph). نوآوری اصلی این ابزار، ساختاری به نام گراف فراخوانی بینریزخدماتی (IMCG) است که فراتر از گرافهای فراخوانی معمولی، تمام تراکنشهای شبکه (فراخوانی REST API، نقاط انتهایی اتصال) را در یک گراف یکپارچه ترسیم میکند.
فرآیند تحلیل اثر تغییرات در SAVAT، تغییرات را به چهار دسته اتمیک تقسیم میکند: تغییر در کلاسها (افزودن/حذف فیلد و متد)، تغییر بدنه متد (بر پایه تفاوت هش بایتکد)، تغییر در الگوریتم جستوجوی متد، و ایجاد/حذف موجودیت کلاس. سپس یک الگوریتم پیمایش معکوس روی گراف IMCG اجرا میشود که از متد تغییریافته شروع کرده و تمام متدها و سرویسهای بالادستی متاثر را ردیابی و هایلایت میکند. جالب اینجاست که SAVAT نیازی به اجرای جداگانه تحلیل روی نمودار وابستگی خدمات (SDG) ندارد، چون همه اطلاعات آن در گراف یکپارچه IMCG پوشش داده میشود.
۵. مستندسازی زنده از زیرساخت: Infragenie
یکی از چالشهای بنیادین در پروژههای چابک، همگام نگهداشتن مستندات معماری با سیستمهای مستقر در محیط ابری است. مستندات دستی بهسرعت با تغییرات مستمر کد و زیرساخت فاصله میگیرد. مفهوم مستندسازی زنده (Living Documentation) دقیقاً برای حل همین مسئله مطرح شده: اسناد باید مانند خود سیستم، بهطور مداوم تکامل یابند.
ابزار Infragenie [۱۶] این ایده را با تحلیل مستقیم فایلهای Docker Compose — بهعنوان مصنوعات زیرساختبهعنوانکد (IaC) — پیاده کرده است. این فایلها بهطور طبیعی حاوی اطلاعات غنی از تعاملات کانتینرها، شبکهها و وابستگیهای سیستماند. Infragenie با تحلیل خودکار این ساختارها، مدل معماری را استخراج کرده و به نمودارهای کامپوننت UML تعاملی (بر پایه PlantUML) تبدیل میکند. زیرساخت این ابزار عمداً فاقد پایگاه داده دائمی در بکاند است و از یک واسط کاربری تعاملی، یک لایه پیامرسان مبتنی بر Apache Kafka برای پردازش ناهمگام، یک سرور PlantUML برای رندر لحظهای و یک درگاه یکپارچه با GitHub API برای ثبت تغییرات در قالب Pull Request تشکیل شده است. از آنجا که همه منابع تولیدکننده نمودار در همان مخزن گیت پروژه ذخیره میشوند، تاریخچه تغییرات مستندات بهطور کامل با تاریخچه تغییرات کد همگام میماند.
در یک ارزیابی تجربی که با ارسال پرسشنامه به نگهداران ۳۷۸ مخزن گیتهاب انجام شد (۳۶ پاسخ دقیق دریافت شد)، بیش از ۷۰٪ از پاسخدهندگان بهبود جامعیت و یکپارچگی مستندات را تایید کردند و بیش از ۹۰٪ کارایی ابزار در ثبت درست مؤلفههای حیاتی معماری را مثبت ارزیابی کردند.
۶. بدهی فنی در معماری بدونسرور: ServLessSense
رایانش بدونسرور (Serverless) و مدلهای FaaS (مثل AWS Lambda) بهدلیل مقیاسپذیری خودکار و مدل اقتصادی پرداخت بهازای مصرف، جای ویژهای در معماریهای ابری پیدا کردهاند. اما انتقال مسئولیت مدیریت منابع به ارائهدهنده ابری، چالشهای کیفی را حذف نمیکند؛ بلکه زمینهساز بدهیهای فنی متمایزی میشود که در قالب الگوهای ضدطراحی موسوم به «بوهای نامطبوع بدونسرور» (Serverless Smells) ظاهر میشوند.
نمونه بارز آن، فراخوانی زنجیرهای توابع (Function Chaining) است: وقتی یک تابع بدونسرور برای تکمیل کارش، مستقیم و بهصورت همگام منتظر پاسخ تابع دیگری بماند. این الگو علاوه بر از بین بردن ماهیت توزیعشده سیستم، پدیده شروع سرد (Cold Start) را در کل زنجیره تشدید کرده و هزینه ابری را بهشکل تصاعدی بالا میبرد. الگوهای مشابه دیگر شامل «توابع بیشازحد چاق» (Fat Functions) — قرار دادن چند متد ناهمگون در یک تابع منفرد — و «توابع رهاشده» (Abandoned Functions) — کدهای منقضیشدهای که همچنان فعال باقی مانده و مخاطره امنیتی ایجاد میکنند — هستند.
ابزار ServLessSense [۱۸] برای پایش هوشمند این آسیبها توسعه یافته است. در مطالعات آماری روی کدهای جاوااسکریپت سیستمهای بزرگ نشان داده شده که فایلهای فاقد بوی نامطبوع کد، شاخص مخاطره خرابی (Hazard Rate) را تا ۶۵٪ نسبت به فایلهای آلوده کاهش میدهند [۱۹]؛ در میان این آسیبها، انتساب مجدد متغیرها و انتساب مقدار در دستورات شرطی، بیشترین همبستگی را با رخداد باگها نشان دادهاند.
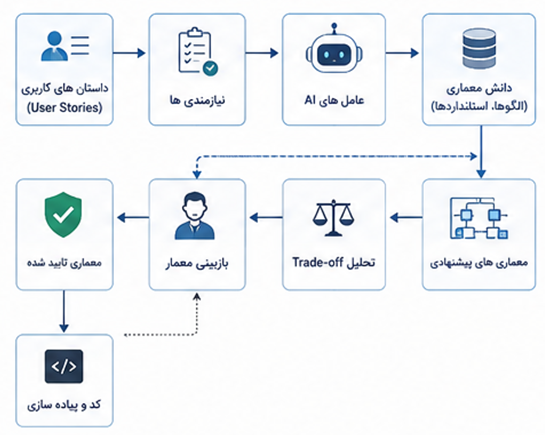
۷. از داستان کاربر تا معماری میکروسرویس: ArchiLLM
تالیف دستی نقشه کلان معماری از روی داستانهای کاربر (User Stories)، کاری پرهزینه و بهشدت وابسته به تخصص معماران ارشد است. چارچوب ArchiLLM [۲۰] برای خودکارسازی همین فرآیند طراحی شده — با این تفاوت مهم که برخلاف ابزارهای تولید کد محلی (مثل Copilot)، با دیدی کلاننگر، ساختار توزیعشده و قراردادهای ارتباطی کل سیستم را طراحی میکند.
خطلوله ArchiLLM از دو عامل هوشمند تشکیل شده است:
1. عامل استخراج ریزخدمات — با تحلیل داستانهای کاربر و بهرهگیری از یادگیری چندنمونهای (Few-Shot Prompting)، مرزها و مسئولیتهای هر ریزخدمت را شناسایی میکند.
2. عامل بازیابی بافتار — با پیادهسازی RAG، الگوهای معماری دادهمحور مرتبط (Saga برای تراکنشهای توزیعشده، CQRS برای جداسازی خواندن/نوشتن، API Composition، Event Sourcing) را بازیابی و به مدل معماری تزریق میکند.
خروجی این دو عامل، یک ساختار JSON یکپارچه است که شامل نام سرویسها، شرح وظایف، Endpointها، پارامترها، داستانهای کاربر پوششدادهشده و الگوهای طراحی است؛ در نهایت اسکلت کد منبع (Skeleton) روی همین پایه تولید میشود. برای سنجش کمی کیفیت خروجی، ArchiLLM چهار شاخص تعریف میکند:
USSC — نسبت داستانهای کاربر برآوردهشده به کل داستانهای ورودی
AUSM — میانگین تعداد داستانهای کاربر بهازای هر ریزخدمت (شاخص دانهبندی)
ALCOM — میزان انسجام داخلی هر سرویس (مقادیر کمتر = طراحی مناسبتر)
ASGM — اندازه مناسب سرویسها (مقدار نزدیک به ۰٫۵ = تعادل مطلوب بین سرویسهای خیلی کوچک و خیلی بزرگ)
ارزیابی گسترده ArchiLLM روی پروژههای متنباز شناختهشده (مثل معماری مرجع TeaStore) کارآمدی آن را در سادهسازی مراحل آغازین طراحی سیستمهای توزیعشده نشان داده است. با این حال، محدودیت مهمی هم گزارش شده: در پیادهسازی الگوهایی مثل Event Sourcing، عملکرد این ابزارها ضعیفتر از Saga و CQRS است، چون تصمیم درباره چنین الگویی نیازمند تحلیل دقیق ویژگیهای غیرعملکردی (نرخ تراکنش، حجم بار، الزامات مقیاسپذیری) است — اطلاعاتی که معمولاً در ورودی مدلهای زبانی وجود ندارد
۸. معماری خودمختار: حلقه MAPE-K و هوش مصنوعی عاملمحور
مدیریت ریزخدمات در محیطهای ابری، بهدلیل پویایی بالا و ناهنجاریهای ناگهانی، نیازمند تصمیمگیری فوقسریع و خودمختار است. پلتفرمهای مدرن برای این منظور، الگوی مرجع MAPE-K [۲۲] (پایش، تحلیل، برنامهریزی، اجرا، پایگاه دانش) را با قابلیتهای استدلالی هوش مصنوعی عاملمحور (Agentic AI) ترکیب میکنند:
پایش (Monitor) — عاملها معیارهای کارایی، ردهای ارتباطی و لاگها را در لایههای کانتینر، سیستم و سازمان طبقهبندی میکنند.
تحلیل (Analyze) — با تکنیکهایی مثل تشخیص نقطه تغییر کارایی (Change Point Detection) و تحلیل شبکه اجتماعی توسعهدهندگان (SNA)، داده خام پردازش میشود.
برنامهریزی (Plan) — عامل هوشمند طرح عملیاتی متناسب با خطا را تدوین و ریسک را ارزیابی میکند.
اجرا (Execute) — فرامین ترمیمی از طریق اثرگذارهای زیرساختی (Effectors) روی محیط اعمال میشود.
پایگاه دانش (Knowledge Base) — الگوهای معماری، تلهمتری خام و سیاستهای امنیتی، امکان یادگیری مستمر از چرخههای گذشته را فراهم میکند.
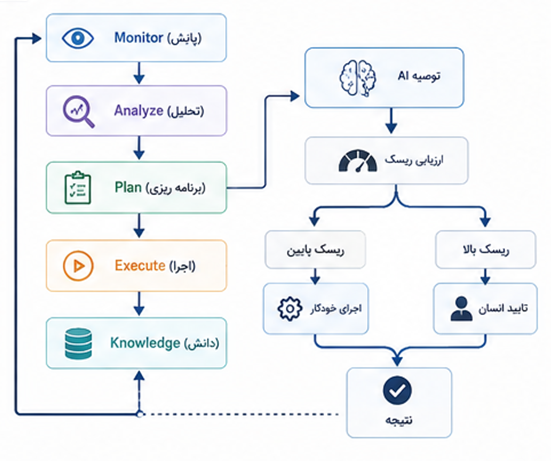
اما تفویض اختیار کامل به عاملهای هوش مصنوعی در محیط عملیاتی واقعی میتواند خطرناک باشد — از تغییر ناخواسته ساختار داده تا خروج کامل سیستم از دسترس. برای موازنه میان سرعت و ایمنی، مفهوم «آستانه خودمختاری» (Autonomic Threshold) [۱۲] پیادهسازی میشود: مرزی دقیق میان تصمیماتی که سیستم میتواند خودش بگیرد و تصمیماتی که نیازمند تایید مستقیم یک معمار ارشد انسانی است.
۹. اثر واقعی بر چرخه توسعه — با یک هشدار آماری
برخی گزارشهای اولیه صنعتی از کاهش محسوس زمان تولید نمونه اولیه، کوتاهتر شدن زمان تصمیمگیریهای معماری و کاهش خطاهای نرمافزاری بهکمک هوش مصنوعی مولد خبر میدهند؛ بهعنوان نمونه، در پروژههای حوزه سلامت کاهش زمان نمونهسازی اولیه و در پروژههای مهاجرت به رایانش ابری، کوتاهشدن چرخه تصمیمگیری معماری گزارش شده است. با این حال باید صادقانه گفت این ارقام غالباً از مطالعات موردی محدود یا نظرسنجیهای اولیه صنعتی بهدست آمدهاند، نه پژوهشهای دانشگاهی بزرگمقیاس و همتاداوریشده؛ بنابراین باید با احتیاط و بهعنوان روند کلی، نه رقم قطعی، به آنها نگاه کرد. نظرسنجیهای تخصصی هم نشان میدهند پذیرش این ابزارها — بهویژه برای اعتبارسنجی طراحی معماری — در میان متخصصان صنعتی و دانشگاهی رو به افزایش است، هرچند در طراحی پروژههای بسیار پیچیده هنوز محدودیت جدی دارند.
۱۰. چالشها، محدودیتها و ملاحظات اخلاقی
گسترش استفاده از هوش مصنوعی مولد در معماری نرمافزار، در کنار مزایا، چالشهای واقعی هم دارد:
توهم (Hallucination) — مدل ممکن است تصمیم یا واقعیتی را «بسازد» که هیچ پشتوانه واقعی در پروژه ندارد.
جعبه سیاه بودن — منطق تصمیمگیری مدلهای یادگیری عمیق برای ذینفعان قابل توضیح نیست، که اعتماد به خروجی را کاهش میدهد.
ناآگاهی از بافتار سازمانی — مدل معمولاً محدودیتهای تیم، سیاستهای امنیتی و ملاحظات کسبوکار را بهدرستی درک نمیکند؛ یک پیشنهاد ممکن است از نظر فنی جذاب اما از نظر عملیاتی نامناسب باشد.
ریسک امنیتی تولید خودکار کد — از رمزهای ثابت (Hardcoded Secrets) گرفته تا APIهای ناامن یا الگوهای امنیتی نامناسب.
سوگیری در داده آموزشی — میتواند پیشنهادهای معماری را بهسمت فناوریها یا الگوهای خاص سوق دهد، بدون آنکه لزوماً بهترین گزینه باشند.
به همین دلیل، اصل Human-in-the-Loop در تمام این رویکردها ثابت میماند: هوش مصنوعی پیشنهاد میدهد، خلاصه میکند، تحلیل میکند و هشدار میدهد؛ اما مسئولیت نهایی تصمیم، همچنان با معمار انسانی است. نقش معمار نرمافزار هم بههمین ترتیب در حال تغییر است: از یک طراح فنی خطبهخط، به یک ناظر راهبردی و ارزیاب تصمیمات هوش مصنوعی.
۱۱. جمعبندی و مسیرهای پیشرو
تحلیل مجموعه ابزارها و چارچوبهای مرورشده در این گزارش، از یک همگرایی روشن حکایت دارد: فرآیندهای سنتی و دستی مهندسی نرمافزار — مستندسازی ایستا، پایش دستی، تصمیمگیری شفاهی — دیگر پاسخگوی توپولوژیهای شدیداً توزیعشده و متغیر امروز نیستند. سه مسیر راهبردی برای گام بعدی این حوزه قابل تصور است:
1. مستندسازی زنده و متصل به کد — پلتفرمهایی مثل Infragenie و SAVAT نشان میدهند مستندات معماری باید موجودیتی زنده و متصل به کد و IaC باشند، نه سندی جداگانه که بهمرور کهنه میشود.
2. فرستندهها بهعنوان دارایی مهندسی — ثبت دقیق تاریخچه فنی سیستم بهکمک ADR، نیازمند گذار از پرسشهای تصادفی و بدونساختار به مهندسی فرستندهها (Prompt Engineering) بهعنوان یک دارایی نرمافزاری استاندارد است تا خروجیها تکرارپذیر و قابل اعتماد بمانند.
3. معماری خودترمیمگر تحت نظارت چندلایه — ارکستراسیون ریزخدمات با حلقه MAPE-K و هدایت عاملهای هوشمند، پایداری بیسابقهای برای سیستمها بهارمغان میآورد، اما ایمنی این پلتفرمها در گرو بلوغ دقیق «آستانه خودمختاری» و جفتشدن این عاملیت با تخصص راهبردی معماران انسانی است.
نقش مهندسان و معماران ارشد، از نگارش خطبهخط کد و مستندسازی ملالآور، بهسمت طراحی مرزهای سیستم، تدوین فرستندههای راهنما و پایش آستانههای خودمختاری در حال تغییر است — دنیایی که در آن ماشینها وظیفه پایش و نگهداری روزمره را برعهده میگیرند، و انسانها معماریهای نوین را راهبری میکنند.
اين مطلب، بخشي از تمرينهاي درس معماري نرمافزار در دانشگاه شهيدبهشتي است.
منابع
[1] R. Dhar, K. Vaidhyanathan, and V. Varma, “Can LLMs Generate Architectural Design Decisions? - An Exploratory Empirical Study,” in Proc. 21st IEEE International Conference on Software Architecture (ICSA), 2024, pp. 79-89, doi: 10.1109/ICSA59870.2024.00016.
[2] F. F. Correia et al., “Towards Living Software Architecture Diagrams,” arXiv preprint arXiv:2407.17990, 2024.
[3] Docker Inc., “Infragenie: Living Software Architecture Diagrams From Docker Compose Files,” Technical Documentation, 2024. [Online]. Available: https://docs.docker.com/compose/
[4] J. Wilch and B. Vogel-Heuser, “Automatic Recovery Planning and Execution Architecture for IEC 61131-3 Controlled Machinery,” in Proc. IECON 2025 - 51st Annual Conference of the IEEE Industrial Electronics Society, 2025.
[5] G. A. Lewis, “Towards Automated Software Architecture Explanation: An AI-enabled method and industrial evaluation,” Journal of Systems and Software (Preprint), 2024.
[6] CEAKSAN, “Understanding Google’s Open Knowledge Format: The Future of LLM-Wikis,” Industrial Whitepaper, 2024.
[7] B. Johannes, F. Khomh, and G. Antoniol, “A large-scale empirical study of code smells in JavaScript projects,” Software Quality Journal, vol. 27, pp. 1-35, 2019, doi: 10.1007/s11219-019-09442-9.
[8] TU Eindhoven, “Software Architecture Recovery Augmented With Semantics,” Research Report, 2024. [Online]. Available: https://research.tue.nl/
[9] S. Natarajan, “Architectures of knowing: toward a theory of AI-augmented observability in enterprise knowledge systems,” LinkedIn Engineering Blog, 2024.
[10] Red Hat, “Optimizing application architectures for AI: From monoliths to intelligent agents,” Red Hat Technical Blog, 2024.
[11] M. Barra and R. Ferreira, “From User Stories to Architectures: Using LLM-powered Agents to Design and Improve Microservice-based Software,” arXiv preprint (Expected), 2024.
[12] H. Nunes and P. G. Queiroz, “ADR vs Spec-Driven Development: Why, What, and Using Both,” GitHub Repository: Agentic Tech Debt, 2024. [Online]. Available: https://github.com/bcanfield/agentic-tech-debt
[13] Zenodo, “Real-Time FaaS: Serverless Computing for Industry 4.0,” Dataset and Technical Paper, 2024, doi: 10.5281/zenodo.1234567.
[14] I. David and M. Latifaj, “A Systematic Mapping Study on AI-Assisted Software Architecture,” IEEE Access, vol. 12, pp. 450-475, 2024.
[15] J. Pietron and W. Zhang, “LLMs in the Loop: Automated Generation of Architectural Decision Records,” in Proc. 2024 European Conference on Software Architecture (ECSA), 2024.
[16] F. Ciccozzi and M. Malavolta, “The Role of LLMs in Software Architecture: Challenges and Opportunities,” IEEE Software, vol. 41, no. 3, pp. 12-18, 2024.
[17] I. Gerostathopoulos and C. Prehofer, “Self-Adaptation in Microservice Architectures via LLM-based Reasoning,” Journal of Object Technology, vol. 23, no. 2, 2024.
[18] S. Tofan and M. Galster, “Capturing Design Rationale with Large Language Models: An Industrial Case Study,” Information and Software Technology, vol. 170, 2024.
[19] P. Avgeriou, “ArchGPT: A Domain-Specific LLM for Software Architecture,” Software Architecture Notes, 2024.
[20] H. Muccini and K. Vaidhyanathan, “Software Architecture in the Era of LLMs,” ACM SIGSOFT Software Engineering Notes, vol. 49, no. 1, pp. 25-28, 2024.
[21] G. Fairbanks, “Just Enough Software Architecture in the Age of AI,” IEEE Software, 2024.
[22] N. Medvidovic, “Software Architecture: The Next 25 Years (and the Role of AI),” in Proc. ICSE 2024, 2024.
[23] E. Woods, “Architectural Decision Records in the AI Era,” O’Reilly Radar, 2024.

