
بسم الله الرحمن الرحیم
بخش اول(مقدمه)
سرگذشت هوش مصنوعي : دانشمندان در گذشته در تلاش بودند تا به فرايند مغز انسان و نحوه ي عملکرد ان اگاهي يابند تا بتواند يک عامل هوشمندي مثل انسان را بوجود اوردند در همين راستا آلن تورینگ در سال 1950 مقاله هايي در اين حوزه منتشر کرد و هم چنين يک معياري براي هوشمند بودن يک عامل که به تست تورينگ مهشور است ارائه کرد و در ادامه تورینگ در زمینه یادگیری تقویتی و الگوریتم های ژنتیک گام های مهمی برداشت. در سال ۱۹۵۰ یکی از اولین پروژههای عملی هوش مصنوعی در دانشگاه هاروارد اتفاق افتاد که ايده آن مفهوم شبکه عصبی و نورونها بود. 4 تا تعريف يا ديدگاه براي هوش مصنوعي يا هوشمند بودن عامل وجود دارد:
1- عامل ما منطقی فکر کند. 2- عامل ما منطقی رفتار کند.3- عامل ما مانند انسان فکر کند.4- عامل ما مانند انسان رفتار کند.
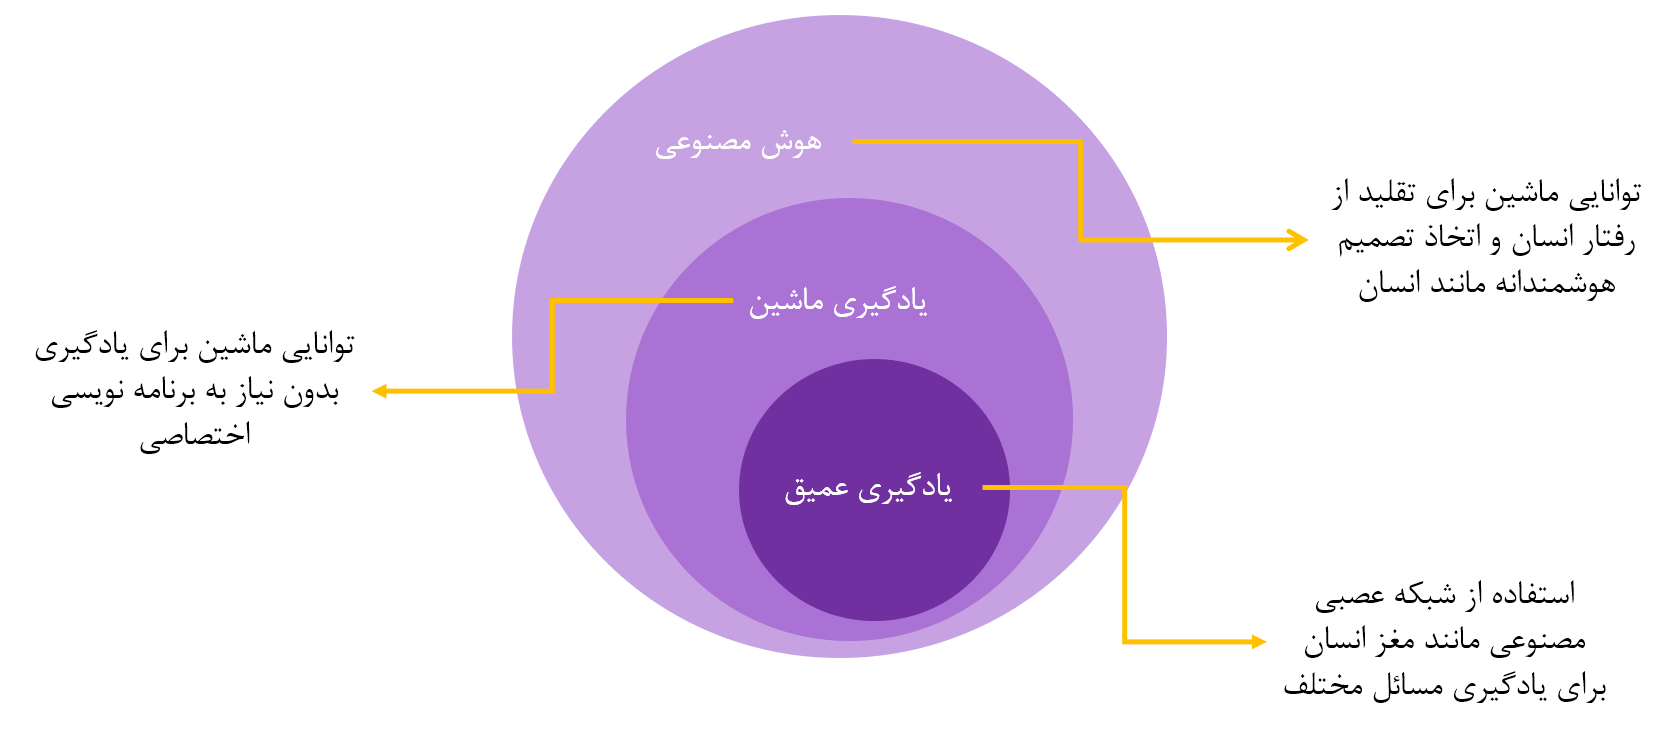
يکي از تفکرات اشتباه اين است که فکر کنيم هوش مصنوعي همان ماشين لرنيگ است در حالي که هوش مصنوعی حوزههای بسیاری را شامل میشود و همچنان در حال بزرگتر شدن است. امروزه هر برنامهای که هوشمندی داشته باشد یا به نوعی رفتار انسان را تقلید کند، به عنوان هوش مصنوعی پذیرفته میشود. هم چنين درباره ي ماشين لرنيگ يکي از ويژگي هاي مهم اين است که عامل همانند انسان با کسب تجربیات جدید رفتار خود را تغییر میدهد. يکي از موضوعات مهم استفاده از شبکههای عصبی مصنوعی به عنوان یکی از انواع روشهای یادگیری ماشین است که از سالها پیش در حال گسترش است این شبکهها از ساختار ذهن انسان الگوبرداری شدهاند و ساختاری لایه لایه دارند. با پیشرفت تکنولوژی و افزایش توان محاسباتی کامپیوترها، مهندسان توانستند تعداد لایههای این شبکهها را افزایش دهند و این شروعی برای یادگیری عمیق بود.
بخش دوم (کاربرد ها)
از کاربرد های هوش مصنوعی میتوان به ماشین های خودران و تشخیص ایمیل های اسپم و سیستم های توصیه گر و تجزیه تحلیل بازار های سهام اشاره کرد. بطور کلی در حوزه ی صنعت و کار یک متخصص هوش مصنوعی میتواند در حوزه های تحلیلگر داده ، دانشمند داده ، مهندس داده و مهندس یادگیری ماشین فعالیت خود را داشته باشد. در حال حاضر اهمیت اطلاعات در حال افزایش است و عصر جدید عصر اطلاعات نامیده میشود اما داده خام قبل از تبدیل شدن به دانش نیازمند ذخیره سازی مناسب و آمادهسازیهایی میباشد. متخصصان تحلیلگر داده ، معماری مناسب برای جمعآوری اطلاعات یک سازمان را طراحی میکنند و پایگاه داده مناسبی را انتخاب کرده و دادههای خام را از منابع داخلی و خارجی جمعآوری میکنند و پس از آمادهسازی و انتخاب قالب مناسب، آنها را در پایگاه دادهای که طراحی کرده ذخیره میکنند. سپس دادهها را مورد بررسی قرار میدهند و از داده اطلاعات مفید استخراج میکند.
دانشمند داده سطح بالاتری از تحلیلگر داده دارد و نیازمند دانش آماری و ریاضیاتی و برنامهنویسی قویتری نسبت به تحلیلگر داده است. همه اموری که تحلیلگر انجام میدهد، دانشمند هم میتواند انجام دهد و علاوه بر آن باید با مفاهیم یادگیری ماشین و دانش برنامهنویسی آشنا باشد تا بتواند ابزارهایی برای تحلیل عمیقتر داده طراحی کند. مهندس داده بیشتر روی داده بزرگ و نحوه ی ذخیره سازی بهینه ان مثل استفاده از Cloud computing
اشاره دارد. مهندس یادگیری ماشین در واقع نقطه تلاقی مهندسی نرمافزار و علم داده است و بیشتر جنبه نظری و عملیاتی دارد. به این صورت که یک مهندس یادگیری ماشین باید دانش کاملی از الگوریتمها و روشهای یادگیری ماشین داشته باشد و هم قبل از استقرار مدل، آن را مورد بررسی و تحلیل قرار دهد و همچنین بر فرآیند عملیاتی ساختن آن و محاسبه پیچیدگیها نظارت داشته باشد و سپس بعد از از استقرار، مسئول نظارت و رسیدگی به آن خواهد بود.
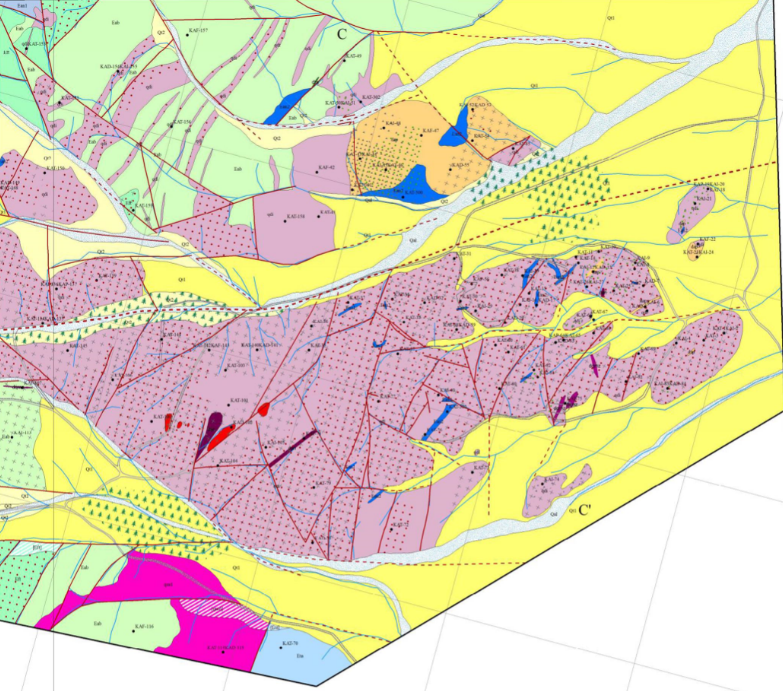
یادگیری ماشین و صنعت معدن : صنایع معدنی با توجه به عدم قطعیت بالا و حجم بسیار زیاد اطلاعات جزو صنایع پیچیده به حساب می آید بنابراین در این حوزه با داده های بزرگ و تجزیه تحلیل این داده های بزرگ سرکار داریم . لذا یادگیری ماشین و هوش مصنوعی در این صنایع با پیشرفت تکنولوژی بیش از پیش مورد استفاده قرار گرفته است به عنوان پروژه های کاربردی از یادگیری ماشین در معدن می توانیم به پردازش تصاویر ماهواره ای ، پیشبینی متغیرهای ژئومتالورژیکی ، آنالیز تصاویر مربوط به جعبه مغزه ها و پردازش تصاویر گرفته شده از پهپاد برای شناسایی هدفهای از پیش تعیین شده اشاره کنیم.
بخش سوم (مفاهیم پایه)
یادگیری ماشین : یادگیری ماشین در اکثر کاربردهای فعلی، یک برنامه کامپیوتری است که به داده دسترسی پیدا میکند و از آن برای آموزش خود استفاده میکند بنابراین ویژگی اصلی ان خود آموزشی یا (Self-learning) میباشد که به معنی استفاده از مدلسازی آماری و عدم استفاده از دستورات مستقیم (یا صریح) میباشد. برای یادگیری ماشین در ابتدا آرتور ساموئل یک تعریف ارائه کرد به این صورت که یادگیری ماشین زمینهای از تحقیقات است که به کامپیوترها توانایی یادگیری بدون برنامهنویسی صریح را میدهد. سپس آقای تام میشل یادگیری ماشین را از دید مهندسی به این صورت بیان کرد که اگر کارایی برنامه در انجام تکلیف Tکه با سنجه P ارزیابی میشود، با تجربه Eافزایش یابد، میگوییم که برنامه یاد گرفته است از تجربه Eبا توجه به تکلیف T و سنجه Pاستفاده کند.
تعریف داده ها : داده ها نتیجه مشاهدات و اندازهگیری شکل ها می باشند و همچنین عنصر محوری یادگیری ماشین هستند و ماشینها از دادهها یاد میگیرند داده ها توضیفی از نتیجه ی مشاهدات می باشند به عنوان مثال دمایی که یک دماسنج نشان میدهد، توصیفی از گرمای هوا ارائه میدهد.
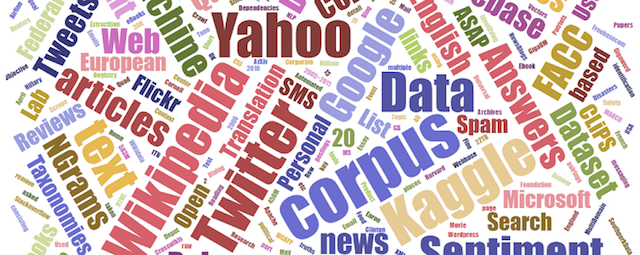
انواع داده ها : کلمات (زبان طبیعی) : می دانیم nlpیکی از مهم ترین بحث های هوش موصنوعی می باشد توان پردازش زبان طبیعی باعث می شود ماشین ها به اطلاعات بسیار بزرگی از انسانها که زبان طبیعی را تولید می کنند دست یابند و هم چنین ماشین ها میتوانند به دانستههای انسان مجهز شوند و با انسان ها ارتباط برقرار کنند.
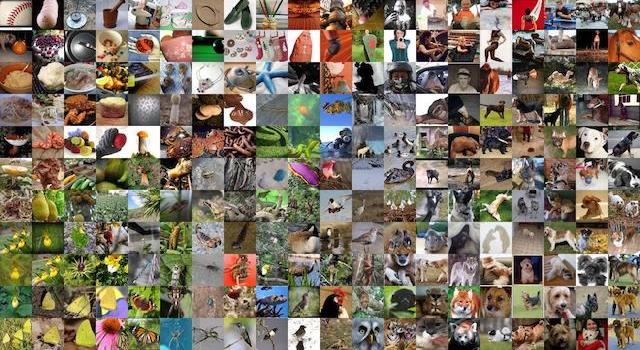
نوع دیگر داده ها تصویر می باشند از کاربر های تجزیه تحلیل تصویر و بینایی ماشین میتوان به تشخیص پلاک خودروها توسط پلیس، تشخیص اثر انگشت یا چهره برای باز کردن قفل گوشی یا کامپیوتر، جستجو میان تصاویر بر اساس اجسام موجود در عکس، پردازش تصاویر ماهوارهای برای هواشناسی یا تشخیص وقایع زیستمحیطی و ماشینهای خودران اشاره کرد.
داد های ما میتوانند بصورت جدول و سری زمانی (تجزیه تحلیل بازار سهام) نیز باشند.
رویکرد یادگیری ماشین و انواع ان : رویکرد انجام یادگیری ماشین، دارای ۴ عنصر اساسی است 1- یک الگوریتم (مدل) برای تصمیمگیری 2- یک معیار برای امتیازدهی اینکه عملکرد مدل چقدر خوب بوده 3- بررسی خودکار کیفیت مدل بر اساس امتیاز 4- یک روش خودکار برای بهبود امتیاز بر اساس ایجاد تغییرات در مدل.
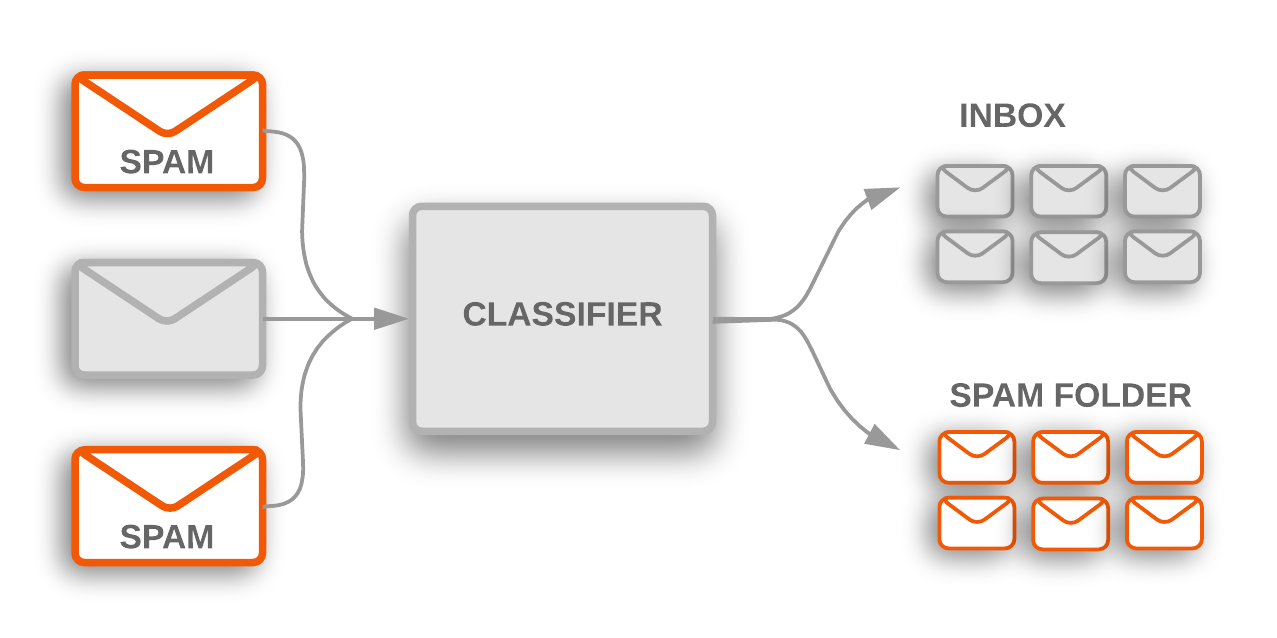
انواع یادگیری ماشین : 1- supervised learning : داده های ما دارای Label می باشند در این نوع الگوریتم ها به دو دسته طبقه بندی (classification) و رگرسیون (regression) دستهبندی میشوند. در classification هدف ما پیدا کردن برچسب یا دسته مناسب برای نمونههای بدون برچسب میباشد. برای این کار، ما مدل یادگیری ماشینی را با استفاده از نمونههای برچسبدار، آموزش میدهیم. بر اساس این یادگیری، مدل یادگیریماشین میتواند، مجموعهدادگان را به دستههای مختلف تقسیم کند و برچسبی که میخواهیم پیشبینی کنیم به صورت متغیری گسسته میباشد. مثل تشخیص ایمیل های spam.
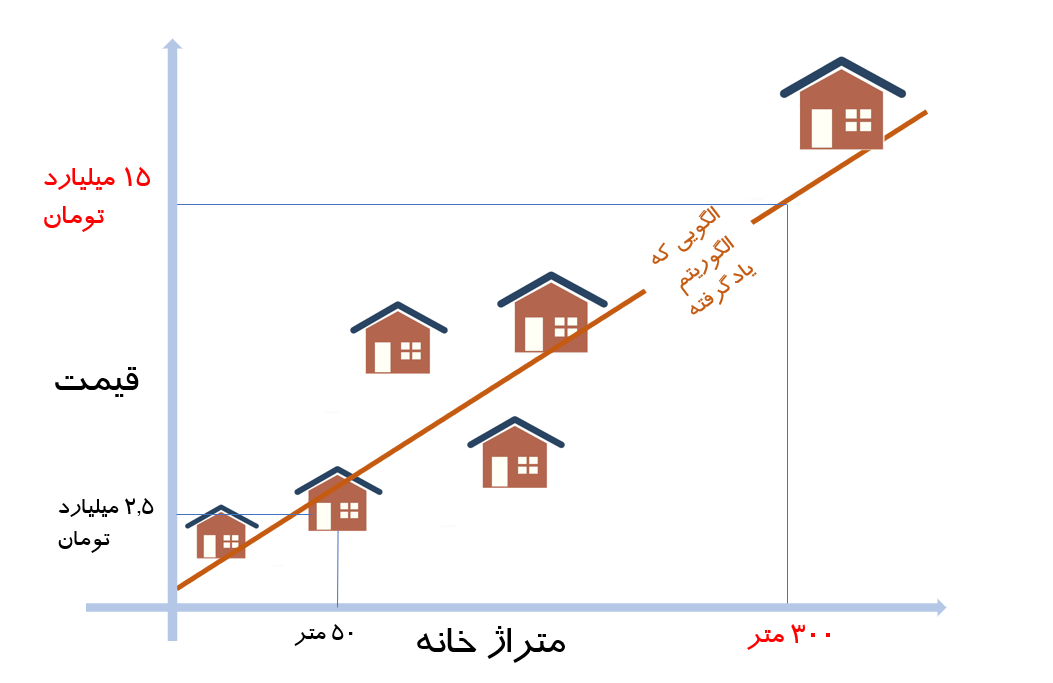
در regression در رگرسیون، هدف ما تخمین مقدار یک ویژگی (این بار مقداری پیوسته) برای یک نمونه میباشد. این الگوریتمها برای پیشبینی روند بازار، قیمت خانه و دیگر مثالها به کار میروند. در الگوریتمهای رگرسیونی، برخلاف طبقهبندی، برچسبی که میخواهیم پیشبینی کنیم به صورت متغیری پیوسته است.
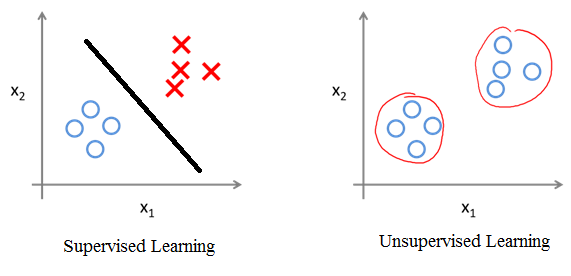
2- یادگیری بدون نظارت : تفاوت این نوع از یادگیری با یادگیری نظارتشده، تنها در نبودن برچسبها است. طور کلی به سه دسته خوشهبندی (clustering)، کاهش ابعاد (dimensionality reduction) و استخراج قانون وابستگی (association rule mining) تقسیمبندی میشود.
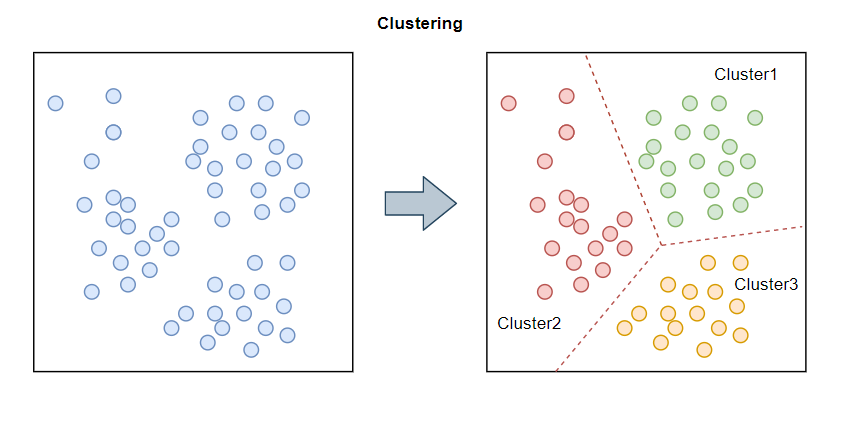
خوشهبندی : خوشهبندی به معنی دستهبندی اتوماتیک دادهها به خوشههای همگن است، به این صورت که دادههای هر خوشه، ویژگیهای یکسانی داشته باشند. اولین گام برای خوشهبندی دادهها، انتخاب کردن معیاری برای خوشهبندی است.
کاهش ابعاد : روش کاهش ابعاد یعنی کاهش دادن تعداد ویژگیهایی که از آنها برای آموزش مدل یادگیری ماشین خود استفاده میکنیم. مسائل و مشکلاتی که به هنگام کار با دادههای دارای ابعاد زیاد مطرح میشود تحت عنوان the curse of dimensionality شناخته میشود. به عنوان یک واقعیت، زمانی که تعداد ویژگیهای مسئله مورد نظر ما زیاد میشود، به طبع نیاز داریم دادههای بیشتری داشته باشیم. در نتیجه، زمانی که ابعاد بیشتری داریم، مدل یادگیری ماشین پیچیده شده و این باعث بهوجود آمدن بیشبرازش overfittingمیشود. بیشبرازش باعث میشود که مدل یادگیری ماشین به دادههایی که روی آن آموزش دیده وابسته شود و روی دادههایی تست عملکرد مطلوبی نداشته باشد.
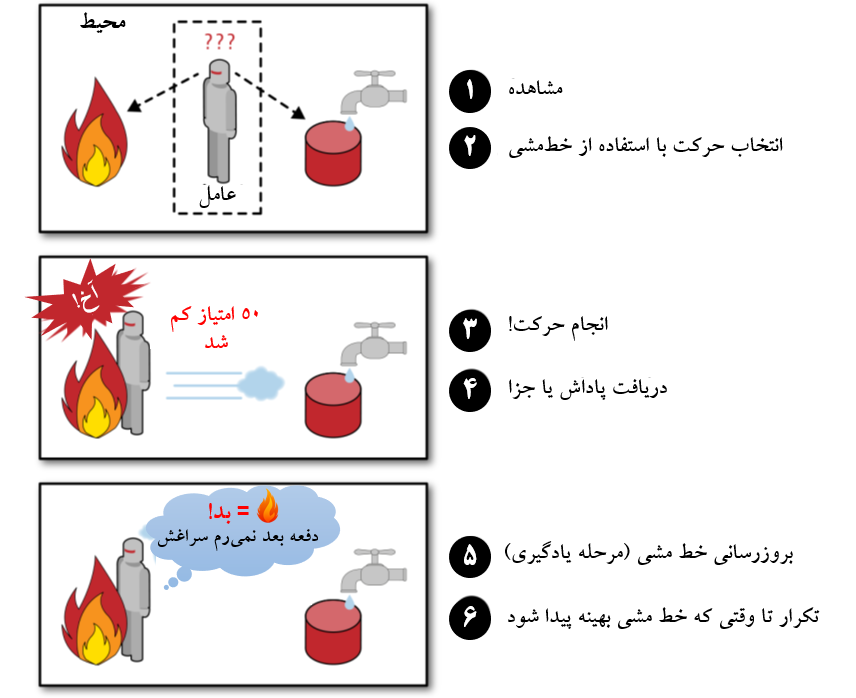
یادگیری تقویتی : یادگیری تقویتی، یکی از روش های یادگیری ماشین است که با ذهنیت آزمون و خطا کار میکند. عامل هوشمند (agent) طبق حالت جاری (state) ، حرکتی (action) انجام میدهد و بر اساس آن حرکت بازخورد (reward) دریافت میکند؛ این بازخورد ممکن است مثبت یا منفی (پاداش یا تنبیه) باشد و عامل با این بازخورد خطمشی (policy) خود را تغییر میدهد.
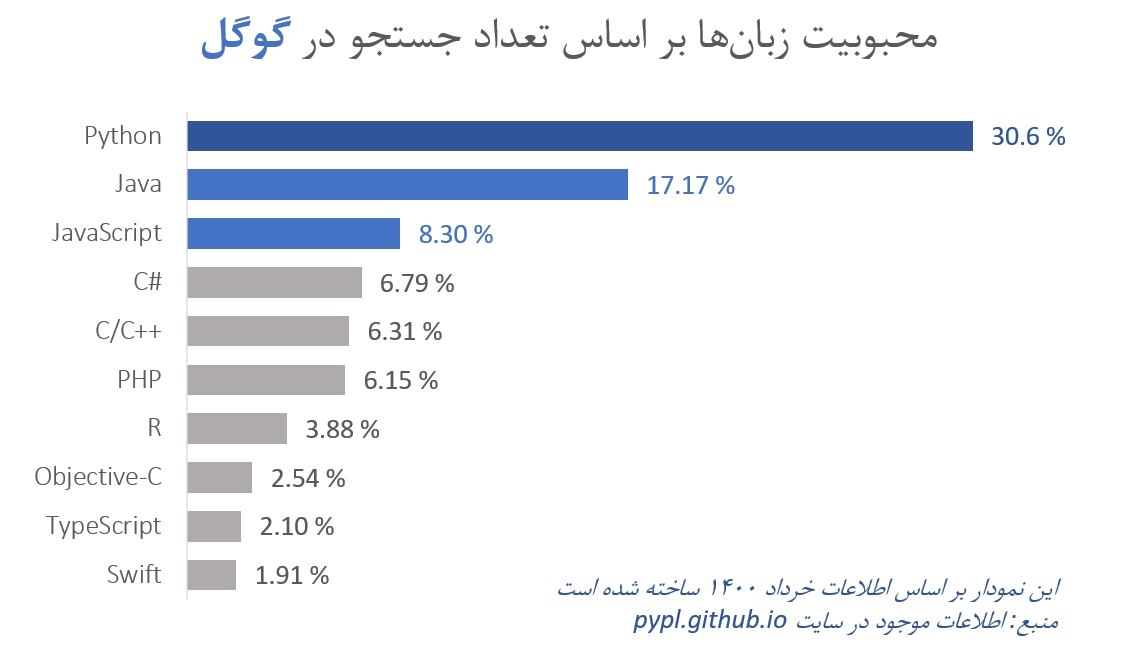
بخش چهارم (زبانها و ابزارها) : در این فصل به یادگیری ابزارهای هوش مصنوعی و کتابخانه های های محبوب هوش مصنوعی میپردازیم.پایتون : زبان برنامه نویسی سطح بالا متن باز است که برای آنالیز داده به کار میرود.
زبان پایتون دارای مفسر است که مفسر برنامه را در کرنل به بایت کد تبدیل کرده و خط به خط اجرا میکند.
پایتون نسبت به زبان های دیگر نوشتار ساده تر و به همین دلیل سریع قابل یادگیری است. و از functional programming، oop، structured programming،procedural programming پشتیبانی میکند.
اکثر شرکت ها برای بخش تولید از پایتون استفاده میکنند ولی زبان برنامه نویسی R که زبان دیگر پرطرفدار در حوزه ی علم داده است بیشتر به صورت دانشگاهی و آکادمیک استفاده میشود.
کتابخانه های پرکاربرد در علم داده در پایتون:
نامپای: نامپای داده ها را به صورت آرایه ای از اعداد دخیره کرده و پردازش و محاسبات روی آن ها را سریعتر انجام میدهد. توابع زیادی بروی این آرایه ها از طریق numpy برای اجرای سریعتر روی این ها نسبت به پایتون انجام میدهد.
پانداس: در این کتابخانه عملیات تحلیل و پاکسازی و آماده سازی داده در پایتون سریعتر انجام میشود. ساختار اصلی داده به صورت یک آرایه دوبعدی است. مثلا کار با دادهای فایل execl که میتوان با بارگزاری داده ها از این فایل ها در پانداس استفاده کرد.
Matplotlib : این کتابخانه بیشتر در ساخت نمودارهای ۲ بعدی کاربرد دارد و رابط کاربری آن بسیار شبیه به متلب است. بسیاری از نمودارهای پرکاربرد را میتوان با متپلاتلیب ایجاد کرد و امکانات بسیاری برای شخصیسازی در آن گنجانده شده، اما با توجه به گسترش کتابخانههای جدیدتر که ظاهر مدرنتری دارند و میتوان از طریق وب با آنها در تعامل بود، کمکم استفاده از این کتابخانه در حال کاهش است.
بخش پنجم (چالشها و محدودیتها) :
دلیل استفاده از ماشین لرنیگ : یادگیریماشین به سازمان ها این امکان را میدهد که کارهایی که قبلاً تنها توسط انسانها امکانپذیر بود را با سرعت بالاتر و دقت بیشتر انجام دهند و همچنین افزایش بی حد و حصر دادهها ذخیره سازی مقرون به صرفه دادهها افزایش قدرت پردازندهها و کاهش هزینههای آنها اهمیت استفاده از ماشین لرنیگ را نشان می دهد. ولی استفاده از ماشین لرنیگ یکسری چالش ها دارد که به انها میپردازیم :
چالش های مربوط به داده ها : به اهمیت داده ها در ماشین لرنیگ پی بردیم ولی ممکن است موقع استفاده از داده ها با چالش هایی از جمله 1- تعداد ناکافی داده 2- داده بیکیفیت منظور داده ای اشتباه و گم شده است
3- ویژگیهای مناسب
چالشهای الگوریتمی : 1- مسئله Overfitting : یعنی مدل ما برای داده های اموزشی درست پیش بینی کند ولی برای داده های تست نتیجه مطلوب را نداشته باشد.2- Underfitting : این مشکل وقتی بهوجود میآید که مدل نتواند به خوبی از دادگان آموزش، یاد بگیرد. این مسئله میتواند به دلایل مختلفی پیش بیاید. داده نامناسب یکی از چندین دلیل کمبرازش است 3- مسئله زمان : فرایند آموزش مدل به زمانبر بودن معروف است. الگوریتمها برای یادگیری زمان زیادی مصرف میکنند؛ بنابراین باید مدلی انتخاب کنیم که پیچیدگی زمانی خوبی داشته باشد. الگوریتمهایی هستند که پس از پایان آموزش معمولا به دقت خوبی میرسند ولی چون فرایند یادگیری زمانبری دارند در عمل از آنها زیاد استفاده نمیشود.
بخش ششم ( یادگیریماشین در عمل ) : در این بخش میخواهیم بطور عملی مسئله ی را مورد بررسی قرار دهیم. در این مسئله با در اختیار داشتن قد و جنسیت افراد باید وزن آنها را پیشبینی کنیم. ابتدا با دیتا های خود را از فایل مورده نظر برداشته و سپس داخل یک متغییر در زبان برنامه نویسی خود ریخته مرحله بعدی پاکسازی دیتا ها است میتوانیم داده های اضافی را حذف یا واحد های ان ها را تغییر دهیم یا بطور کلی تغییراتی رو دیتا
برای ساده سازی ان انجام دهیم مرحله بعد ساختن دیتا های اموزشی و تست است سپس مدل خود را اموزش میدهیم که از برای مدل کردن داده از XGBRegressor استفاده کردیم. سپس MAE یا Mean Absolute Error (میانگین خطای مطلق) که میانگین قدر مطلق تفاضل مقدار واقعی با مقداری که مدل پیشبینی کرده را نشان میدهد را بدست می اوریم. که میزان خوب بودن مدل ما را نشان می دهد.
بخش هفتم (بیشتر بدانید) : هدف ما ساخت عامل هاي هوشمند است عاملهای هوشمندی که امروزه ساخته میشوند معمولا در حل یک مسئله خاص به هوشمندی رسیدهاند. مثل تشخیص انسانهای داخل تصویر یا انجام بازی شطرنج. به این نوع از هوش مصنوعی، هوش مصنوعی محدود یا ضعیف اطلاق میشود. در مقابل، آنچه هوش مصنوعی عمومی (artificial general intelligence) و یا قوی نامیده میشود، عبارت است از ساختن عامل هوشمندی که مانند انسان از هوشی عمومی برخوردار باشد که توانایی آموختن در مواجهه با هر مسئله جدیدی را داشته باشد و محدود به یک زمینه یا مسئله خاص نباشد.
معرفي چند شرکت مهم در حوزه هوش مصنوعي : 1- شرکت DeepMind : اين شرکت در لندن مي باشد و در سال 2014 توسط گوگل خريداري شد از محصولات اين شرکت ميتوان به عامل هوشمند معروف AlphaGo که موفق به شکست قهرمان جهان در بازی Go که پیچیدگی خیلی بیشتری از شطرنج دارد. يکی دیگر از محصولات این شرکت، AlphaFold است که پیشبینی دقیقی از ساختار سه بعدی پروتئینها ارائه میدهد.
2- شرکت OpenAI : شرکت OpenAI ، که مقر اصلی آن در سانفرانسیسکوی آمریکا قرار دارد، در سال ۲۰۱۵ تاسیس شد. این شرکت هم هدف خود را ساختن هوش مصنوعی عمومیای میداند که برای بشریت مفید واقع شود 3- گروه AI شرکت Facebook : زمینههای تحقیقاتی این شرکت شامل ابعاد مختلف یادگیری ماشین از جمله بینایی ماشین و پردازش زبان طبیعی میشود اما معروفترین محصول آن یک کتابخانه متنباز یادگیری ماشین به نام PyTorch است که محبوبیت بسیاری پیدا کرده است. 4- گروه AI شرکت Google
منبع : https://quera.ir/college/land/college/8522/

