
در سالهای اخیر، پیشرفت هوش مصنوعی تا حد زیادی حول یک الگوی مشخص شکل گرفته است:
مدل بزرگتر + دادهی بیشتر + محاسبات بیشتر + Training بهتر = قابلیت بیشتر
از مدلهای زبانی بزرگ گرفته تا مدلهای بینایی و سیستمهای چندوجهی، بخش بزرگی از پیشرفت AI از طریق افزایش مقیاس، بهبود داده و روشهای آموزش به دست آمده است.
اما یک سؤال بنیادیتر وجود دارد که کمتر دربارهی آن صحبت میکنیم:
آیا هر قابلیتی که میخواهیم یک سیستم هوشمند داشته باشد، الزاماً باید از طریق Training یاد گرفته شود؟
یا اینکه ممکن است بخشی از قابلیتهای یک سیستم، از نحوهی طراحی خود سیستم ناشی شود؟
این سؤال با پیشرفت پژوهشهایی که به سمت شبیهسازی سیستمهای عصبی و استفاده از Connectome حرکت میکنند، جالبتر شده است.
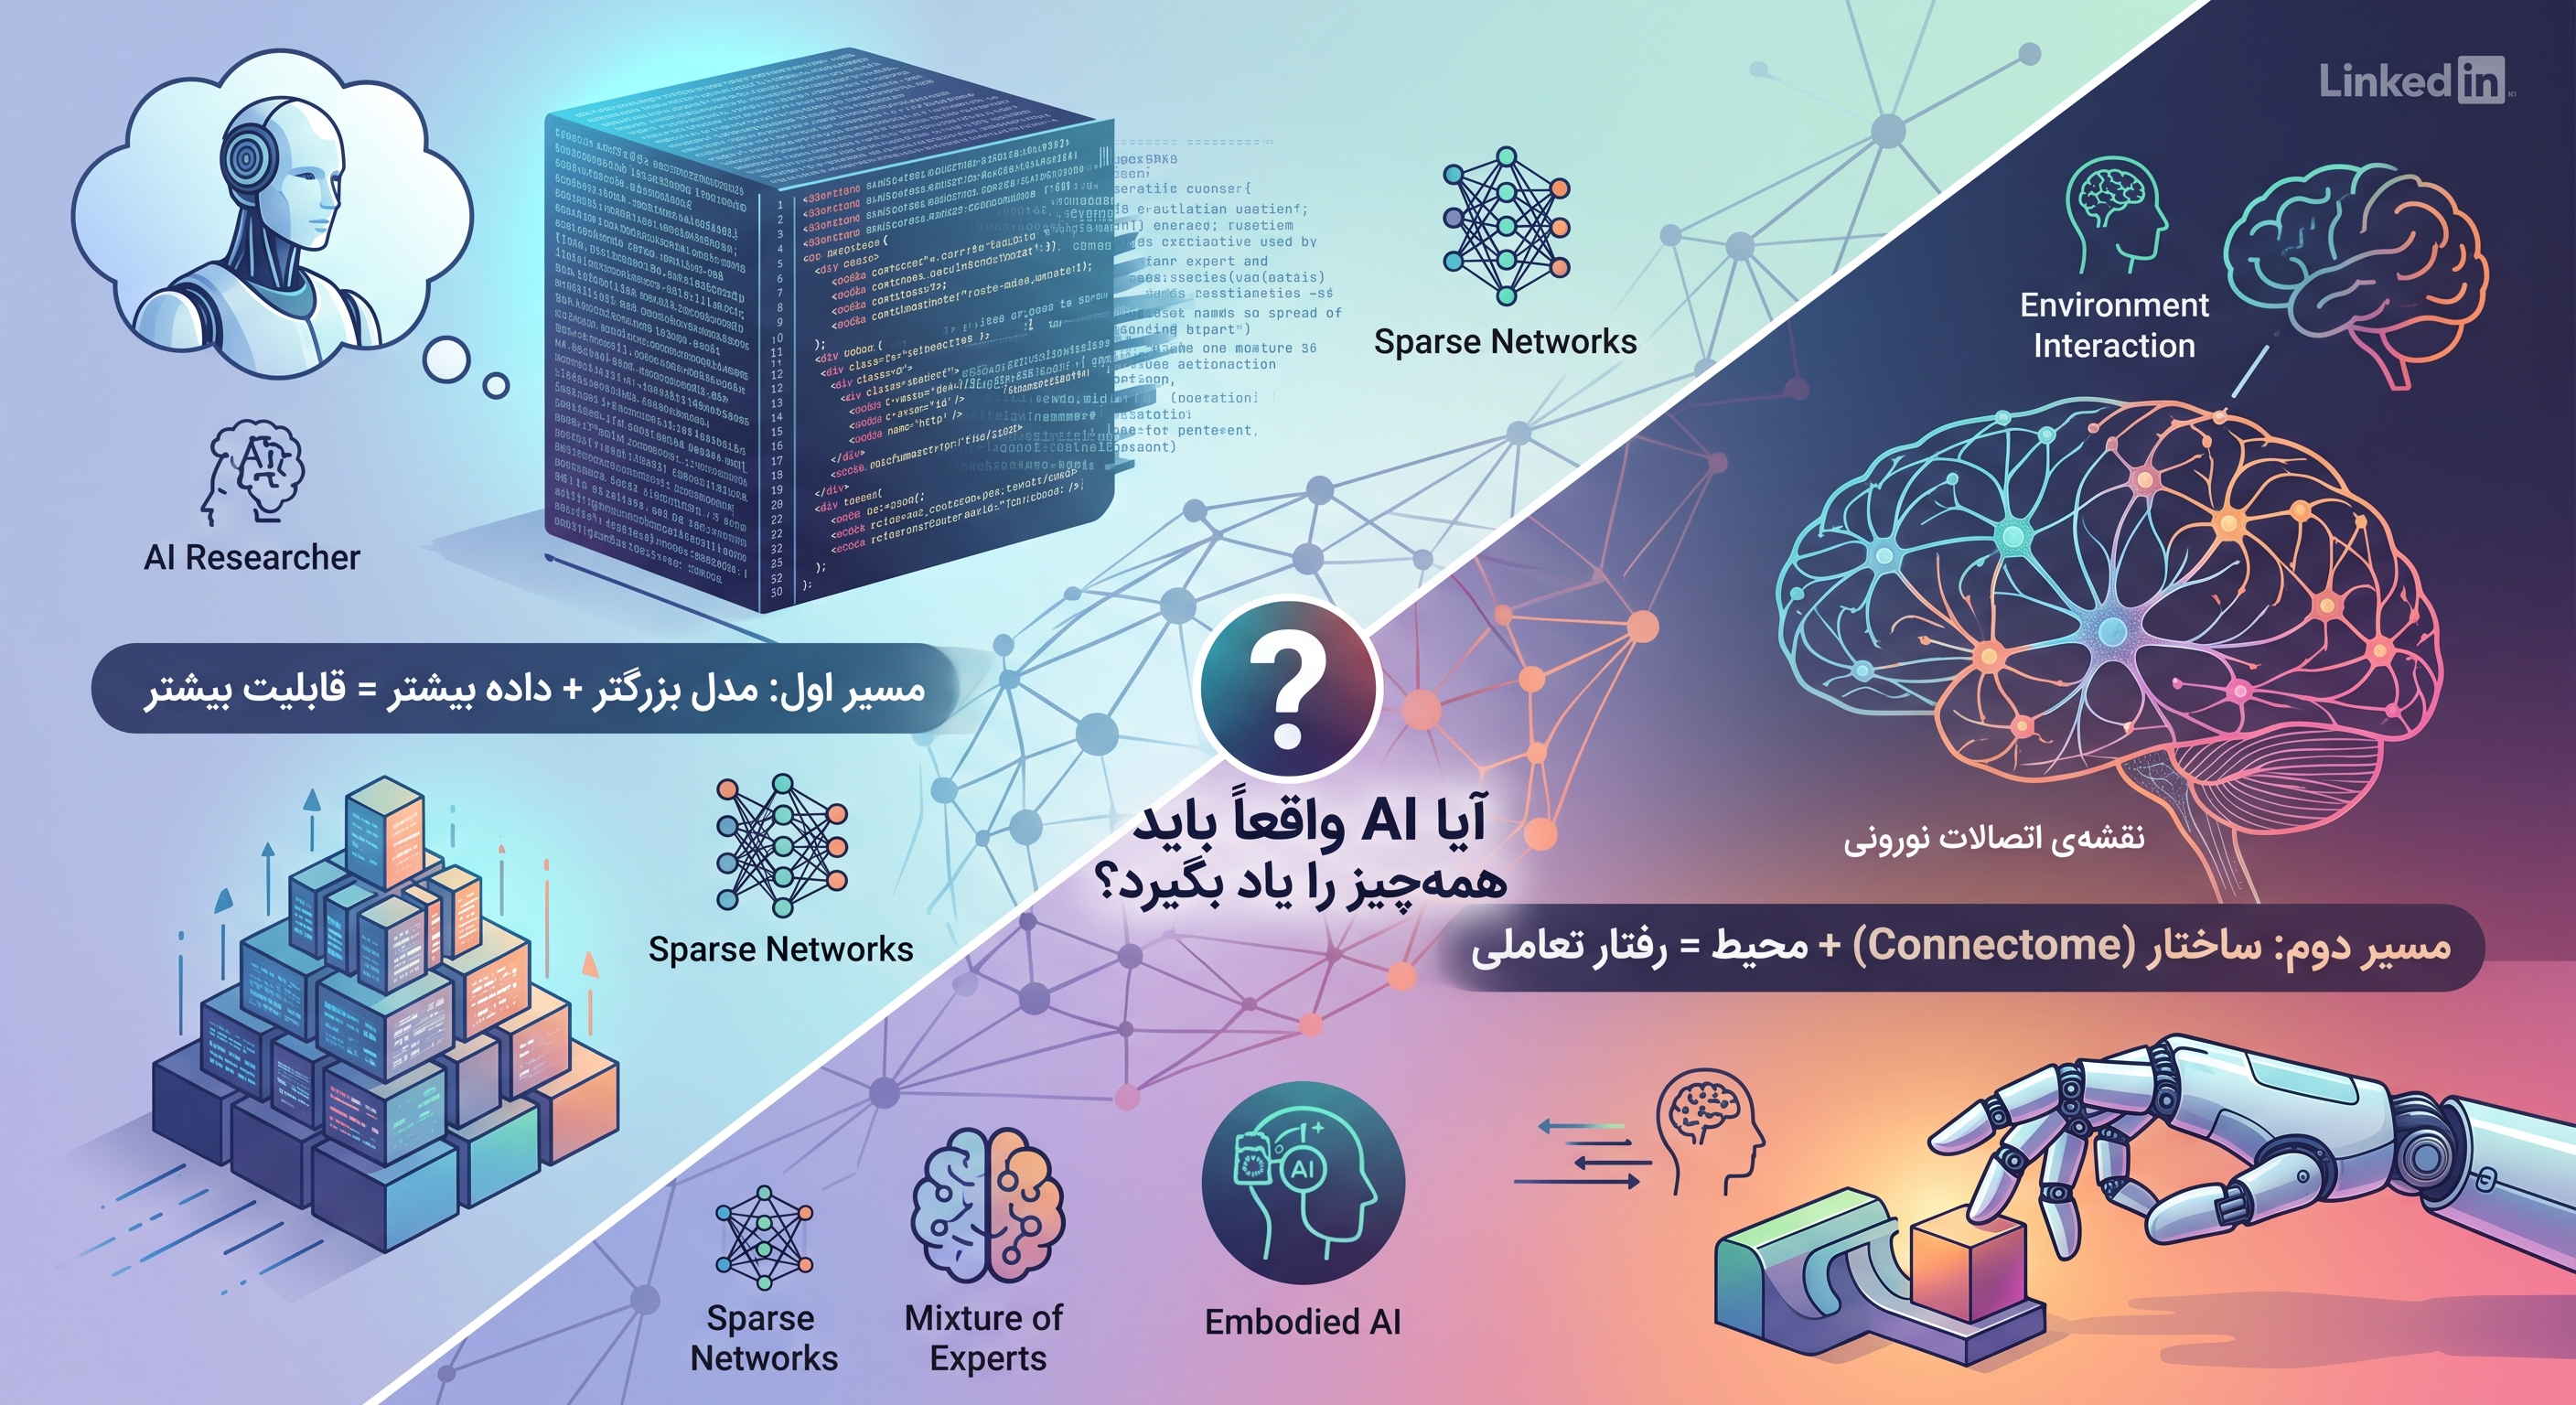
اگر مغز را بهعنوان یک سیستم محاسباتی در نظر بگیریم، فقط دانستن اینکه «چند نورون وجود دارد» کافی نیست.
باید بدانیم این نورونها چگونه به یکدیگر متصل شدهاند.
Connectome در سادهترین تعریف، نقشهای از اتصالات موجود در یک سیستم عصبی است.
در واقع، میتوان آن را تا حدی شبیه به یک نقشهی معماری برای سیستم عصبی در نظر گرفت:
چه واحدهایی به هم متصل هستند؟
اطلاعات از چه مسیرهایی عبور میکند؟
کدام بخشها ورودی دریافت میکنند؟
کدام بخشها خروجی تولید میکنند؟
و ساختار کلی شبکه چگونه سازماندهی شده است؟
پژوهشهای اخیر روی مغز مگس میوه و تلاش برای تبدیل این اطلاعات به مدلهای محاسباتی، یک نکتهی جالب را برجسته میکنند:
گاهی خودِ ساختار شبکه میتواند اطلاعات مهمی دربارهی نحوهی پردازش اطلاعات در اختیار ما قرار دهد.
اینجا بحث فقط «تعداد پارامترها» نیست.
بحث دربارهی Architecture است.
وقتی دربارهی Architecture یک Neural Network صحبت میکنیم، معمولاً دربارهی چیزهایی مثل تعداد لایهها، نوع لایهها، نحوهی اتصال آنها و مسیر جریان اطلاعات صحبت میکنیم.
اما Architecture یک نقش عمیقتر هم دارد.
Architecture میتواند یک Inductive Bias ایجاد کند.
Inductive Bias یعنی مجموعهای از فرضها یا محدودیتهایی که مدل از قبل دربارهی ساختار مسئله دارد.
برای مثال، یک CNN را در نظر بگیرید.
CNN بهصورت طبیعی برای دادههای تصویری مناسبتر است، چون Architecture آن بر اساس ویژگیهایی مثل Locality و Shared Weights طراحی شده است.
یعنی مدل لازم نیست همهی روابط ممکن بین تمام پیکسلها را از صفر یاد بگیرد.
بخشی از ساختار مسئله از قبل در Architecture قرار گرفته است.
در نتیجه میتوانیم این دو حالت را با هم مقایسه کنیم:
Architecture عمومی → Training بیشتر → کشف ساختار مسئله
Architecture مناسب → Inductive Bias → Training برای یادگیری جزئیات
در حالت دوم، ما بخشی از مسئله را قبل از Training حل کردهایم.
اینجاست که موضوع جالبتر میشود.
مغز یک Neural Network ساده با Weightهای قابل آموزش نیست.
ساختار مغز حاصل فرآیندهای زیستی، ژنتیکی و رشدی است و در طول زمان با یادگیری و تعامل با محیط تغییر میکند.
بنابراین وقتی دربارهی شبیهسازی مغز صحبت میکنیم، نباید به یک نتیجهی ساده برسیم که:
«مغز فقط Architecture است و دیگر به Training نیاز ندارد.»
این برداشت درست نیست.
در عوض، میتوانیم سؤال دقیقتری بپرسیم:
چه مقدار از قابلیت یک سیستم هوشمند از ساختار اولیهی آن میآید و چه مقدار از Learning؟
این تفاوت بسیار مهم است.
میتوانیم بهصورت ساده دو رویکرد را تصور کنیم.
Architecture ↓ Training ↓ Learned Parameters ↓ Behavior
در اینجا Architecture بیشتر چارچوبی برای یادگیری فراهم میکند و بخش زیادی از رفتار نهایی از طریق پارامترهایی که در Training به دست آمدهاند شکل میگیرد.
اما در یک سیستم Brain-inspired میتوانیم تصور دیگری داشته باشیم:
Architecture
      ↓
Inductive Bias
      ↓
Dynamics + Learning
      ↓
Behavior
در این حالت، Architecture فقط یک ظرف برای پارامترها نیست.
خودِ ارتباطات، توپولوژی و محدودیتهای سیستم میتوانند تعیین کنند که چه نوع پردازشهایی در سیستم طبیعیتر یا سادهتر باشند.
این شاید یکی از مهمترین نکات این بحث باشد.
اگر Architecture مناسب باشد، ممکن است بخشی از Complexity از Training به Design منتقل شود.
یعنی بهجای اینکه به مدل بگوییم:
«این حجم عظیم از داده را ببین و خودت روابط مهم را پیدا کن.»
بخشی از ساختار مسئله را از قبل در Architecture قرار دهیم.
برای مثال:
CNN برای Spatial Structure یک Inductive Bias دارد.
GNN ساختار Graph و روابط بین Nodeها را مستقیماً وارد مدل میکند.
Mixture of Experts به مدل اجازه میدهد بخشی از ظرفیت خود را بهصورت تخصصیتر و Sparse فعال کند.
Sparse Neural Networks همهی ارتباطات ممکن را ضروری نمیدانند.
و در Neuromorphic Computing حتی مدل محاسباتی میتواند بیشتر از معماری سنتی Neural Network فاصله بگیرد و از ویژگیهای سیستمهای عصبی الهام بگیرد.
در تمام این موارد، یک ایدهی مشترک وجود دارد:
همهچیز را مجبور نیستیم بهصورت یک مسئلهی کاملاً عمومی به Training بسپاریم.
نه.
این بحث قرار نیست Training را در برابر Architecture قرار دهد.
در واقع، احتمالاً آیندهی AI بیشتر شبیه ترکیب این دو خواهد بود:
Architecture + Learning + Environment
Architecture میتواند ساختار و محدودیتهای مناسب را فراهم کند.
Training میتواند پارامترها و رفتارهای موردنیاز را یاد بگیرد.
و Environment میتواند اطلاعاتی را فراهم کند که در هیچ Architecture ثابتی نمیتوان بهطور کامل از قبل تعریف کرد.
این مسئله بهخصوص برای Embodied AI اهمیت پیدا میکند.
یک سیستم هوشمند وقتی در محیط قرار میگیرد، دیگر فقط با یک Dataset سروکار ندارد.
میتواند:
محیط را مشاهده کند
عمل انجام دهد
نتیجهی عمل را دریافت کند
از خطا یاد بگیرد
و رفتار خود را بر اساس Feedback تغییر دهد.
در اینجا Intelligence فقط در Model ذخیره نشده است.
بخشی از آن در تعامل بین Model، Body و Environment شکل میگیرد.
این بحث حتی میتواند به LLMها و Agentها هم مرتبط شود.
امروز وقتی یک Agent عملکرد خوبی ندارد، اولین راهحلهایی که به ذهنمان میرسند معمولاً اینها هستند:
مدل قویتر؟
Prompt بهتر؟
Training بیشتر؟
Dataset بزرگتر؟
اما شاید همیشه مشکل در Model نباشد.
گاهی مشکل از Architecture سیستم است.
مثلاً:
Toolها چگونه انتخاب میشوند؟
Memory چگونه طراحی شده؟
اطلاعات چگونه وارد Context میشوند؟
Agent چه زمانی باید تصمیم بگیرد؟
چه زمانی باید Retrieval انجام شود؟
چه زمانی باید از یک مدل دیگر استفاده شود؟
Failure Recovery چگونه اتفاق میافتد؟
چه چیزی باید توسط Model یاد گرفته شود و چه چیزی باید در سیستم Hard-code شود؟
اینجا دوباره به همان سؤال اولیه برمیگردیم:
آیا لازم است همهی Intelligence را داخل Model قرار دهیم؟
شاید نه.
ممکن است بخشی از Intelligence یک سیستم از Architecture کل سیستم ناشی شود.
شاید یکی از تغییرات مهم در مهندسی AI این باشد که از نگاه صرفاً Model-centric به سمت نگاه System-centric حرکت کنیم.
در نگاه Model-centric:
مدل را بهتر کنیم.
در نگاه System-centric:
کل سیستم را بهتر طراحی کنیم.
در یک سیستم واقعی، Model فقط یکی از اجزاست.
ممکن است Architecture شامل این اجزا باشد:
User
  ↓
Orchestrator
  ↓
LLM
 ↙ ↓ ↘
Tools  Memory  Retrieval
  ↓
Environment
  ↓
Feedback
  ↓
Evaluation
در چنین سیستمی، افزایش Intelligence لزوماً فقط با افزایش تعداد پارامترهای LLM اتفاق نمیافتد.
ممکن است یک Router بهتر، Retrieval بهتر، Memory مناسبتر، Tool Selection بهتر یا Evaluation دقیقتر، عملکرد سیستم را بیشتر از تغییر Model بهبود دهد.
این دقیقاً همان جایی است که AI Engineering از صرفاً استفاده از یک مدل فاصله میگیرد و به سمت طراحی سیستمهای هوشمند حرکت میکند.
هنوز برای چنین نتیجهای زود است.
اما یک سؤال ارزشمند وجود دارد:
اگر بتوانیم بخشی از قابلیت یک سیستم را با Architecture مناسب ایجاد کنیم، چرا باید تمام آن را با Training و میلیاردها پارامتر یاد بگیریم؟
شاید آیندهی AI صرفاً دربارهی ساخت مدلهای بزرگتر نباشد.
شاید بخشی از پیشرفت بعدی از طراحی بهتر خودِ سیستم بیاید.
سیستمهایی که در آنها:
Architecture مشخص میکند چه چیزی آسان است.
Learning مشخص میکند چه چیزی باید آموخته شود.
Environment مشخص میکند سیستم چگونه با جهان تعامل کند.
و در نهایت:
Behavior از تعامل این اجزا شکل میگیرد.
بنابراین شاید سؤال آینده فقط این نباشد:
«چطور مدلهای بزرگتر و قدرتمندتری بسازیم؟»
بلکه این باشد:
«چطور سیستمهایی طراحی کنیم که مجبور نباشند همهچیز را یاد بگیرند؟»
و شاید همین سؤال، ما را یک قدم به سمت ساخت سیستمهای AI کارآمدتر، تخصصیتر و قابلکنترلتر ببرد.

