چالشهای بنیادین پردازش زبان فارسی در سامانههای نوین هوش مصنوعی: از متن تا گفتار
در اکوسیستم هوش مصنوعی محاورهای (Conversational AI)، دو ستون اصلی پردازش صدا یعنی تبدیل گفتار به متن (ASR) و تبدیل متن به گفتار (TTS)، نقش دروازههای ورودی و خروجی تعامل انسان و ماشین را ایفا میکنند؛ سامانه ASR با تحلیل سیگنال آکوستیک، واجها را به کد متنی ترجمه میکند و سیستم TTS در جهت معکوس، توالی نویسهها را به سیگنالی باکیفیت و سرشار از اطلاعات نوایی و لحنی بدل میسازد. با این حال، زبان فارسی به دلیل ساختارهای منحصربهفرد خط و دستور—از جمله فقدان مصوتهای کوتاه در نگارش، پدیده گسترده کلمات همنویسه (Homographs)، نقشآفرینی سازه اضافه و ناهمگونیهای املا—این سامانهها را با موانع جدی ابهامزدایی فونتیک و آکوستیک مواجه کرده است.
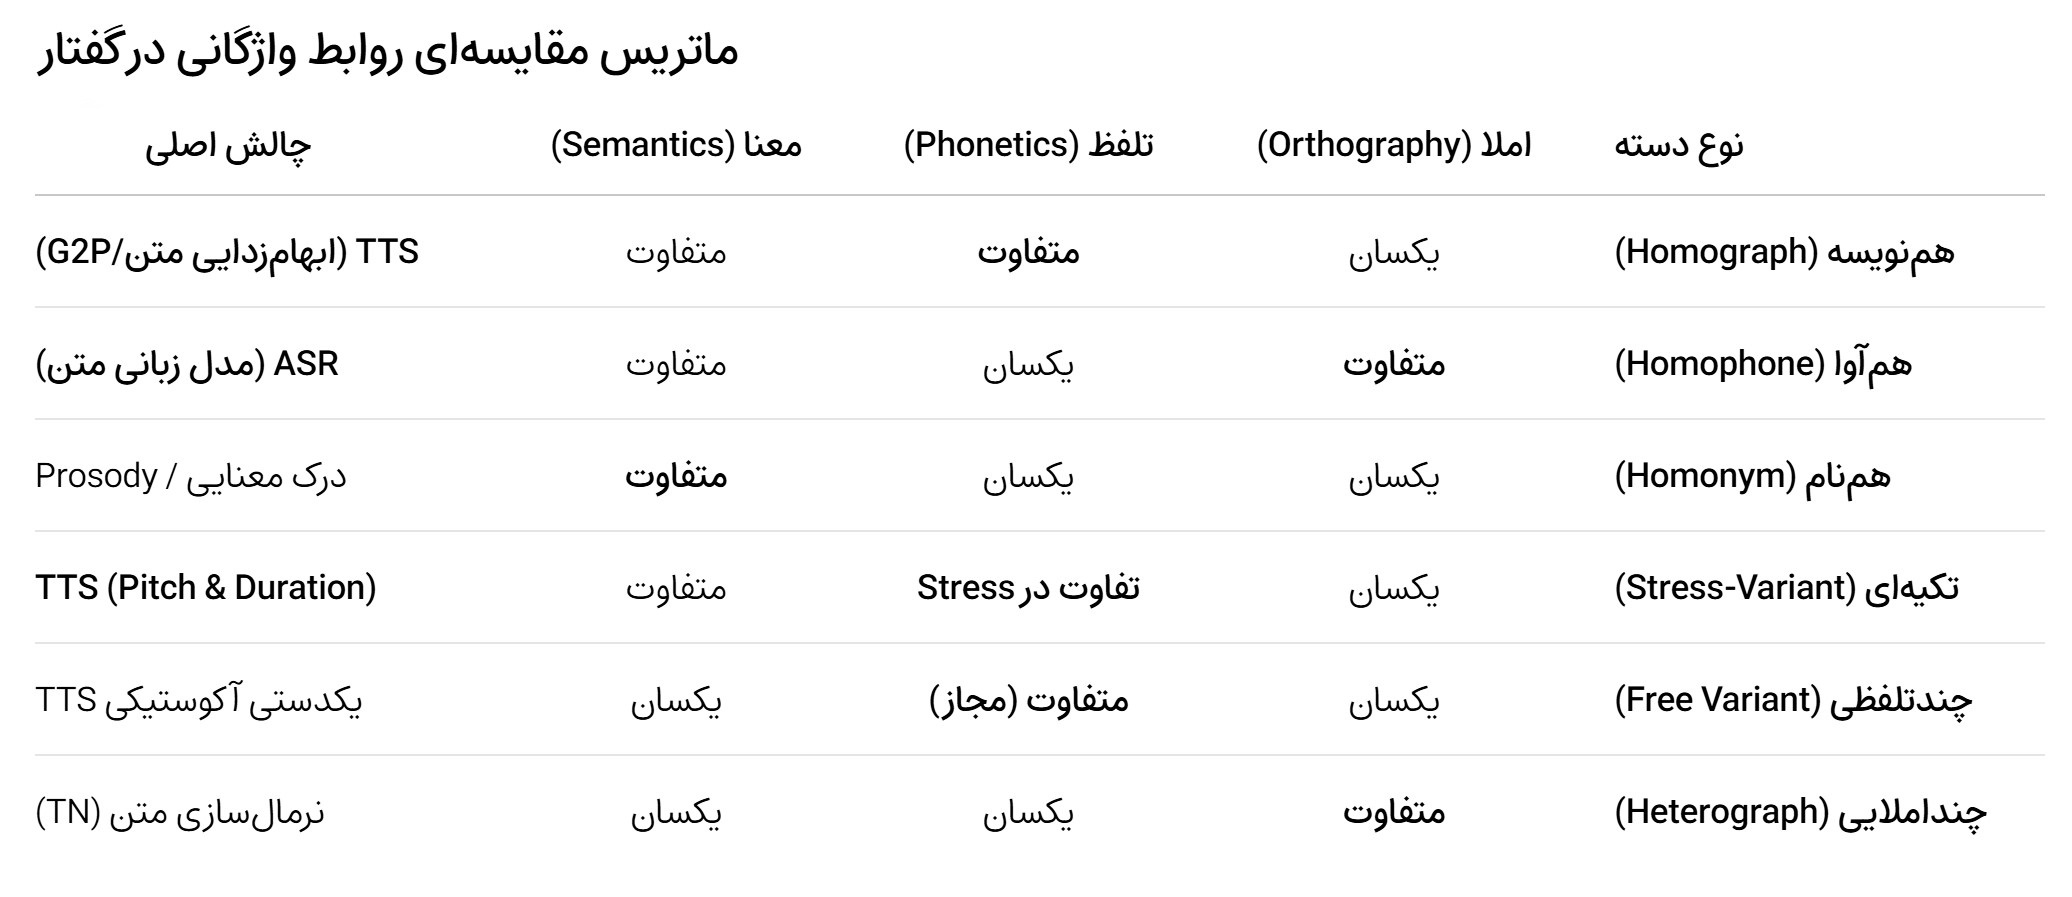
در زبانشناسی، پردازش زبان طبیعی (NLP) و پردازش گفتار، روابط واژگانی بر اساس ۳ مؤلفه اصلی سنجیده میشوند: املا (نوشتار)، آوا (تلفظ) و معنا. در کنار کلمات همنویسه (Homographs) که در آنها املا یکسان، اما تلفظ و معنا متفاوت است، دستهبندیهای موازی و مرتبط دیگری در زبان فارسی وجود دارند که هرکدام چالشهای خاصی برای سیستمهای TTS و ASR ایجاد میکنند:
۱. کلمات همآوا یا متشابه (Homophones)
کلماتی که تلفظ یکسان دارند، اما املا و معنای آنها متفاوت است.
* ریشه زبانی در فارسی: وجود چند حرف الفبا برای یک واج یکسان (مانند «ت/ط»، «ث/س/ص»، «ح/ه»، «ز/ض/ظ/ذ»، «غ/ق»).
* مثالها:
* خوار (ذلیل) / خار (تیغ) $\rightarrow$ [/xâr/]
* حیاط (محوطه) / حیات (زندگی) $\rightarrow$ [/hayât/]
* سد (مانع آب) / صد (عدد ۱۰۰) $\rightarrow$ [/sad/]
* غریب (ناآشنا) / قریب (نزدیک) $\rightarrow$ [/ğarib/]
* چالش: چالش اصلی این دسته در سامانههای بازشناسی گفتار (ASR) و غلطیابهای املایی است؛ زیرا مدل صوتی خروجی یکسانی میشنود و مدل زبانی باید بر اساس بافتار متن املای صحیح را انتخاب کند.
۲. کلمات همنام یا مشترک لفظی (Homonyms / Polysemy)
کلماتی که هم املا و هم تلفظ یکسان دارند، اما معنای متفاوتی دارند.
* همنامی محض (Absolute Homonyms): دو ریشه کاملاً مجزا که تصادفاً همشکل شدهاند:
* شیر (حیوان درنده) / شیر (شیر خوراکی) / شیر (شیر آب) $\rightarrow$ [/šir/]
* سیر (گیاه بدبو) / سیر (متضاد گرسنه) $\rightarrow$ [/sir/]
* گور (قبر) / گور (گورخر) $\rightarrow$ [/gur/]
* چندمعنایی (Polysemy): یک واژه با معانی وابسته یا استعاری چندگانه:
* پا (عضو بدن) / پای کوه (دامنه) / پای حرف ایستادن (استعاره از تعهد).
* چالش در TTS: در سطح تلفظ واژگانی مشکلی ندارند، اما در نوای گفتار (Prosody)، لحن و تأکید جملهای اهمیت دارند؛ چرا که تغییر معنا ممکن است احساس و وزن کلام را در خوانش تغییر دهد.
۳. کلمات همنویسه و متجانسِ تکیهای (Heterophonic / Stress-differentiated Words)
کلماتی که املا و حتی واجهای یکسانی دارند، اما محل تکیه واژگانی (Lexical Stress) در آنها متفاوت است و همین تفاوت تکیه، معنا و نقش دستوری را دگرگون میکند:
* مثالها:
* ماهی: [/mâ-hí/] (جانور آبزی - تکیه روی هجای دوم) در برابر [/mấ-hi/] (یک ماه / ماه بودن - تکیه روی هجای اول).
* روزی: [/ru-zí/] (رزق و روزی) در برابر [/rú-zi/] (یک روز).
* بُردی: [/bor-dí/] (فعل گذشته: تو بردی) در برابر [/bór-di/] (اسم مصدر: برد بودن/دامنه).
* ایرانی: [/i-râ-ní/] (اهل ایران - صفت نسبی) در برابر [/i-rấ-ni/] (یک ایران - اسم نکره).
* چالش در TTS: ماژول G2P معمولاً واجها را درست تشخیص میدهد اما اگر برچسب تکیه (Stress Marker) را درست اعمال نکند، لحن جمله غیرطبیعی و گاهی نامفهوم میشود.
۴. کلمات چندتلفظی مجاز (Free Variants / Pronunciation Variants)
واژگانی که دارای یک املا و یک معنای واحد هستند، اما در جامعه زبانی با چند تلفظ استاندارد یا محاورهای معتبر ادا میشوند:
* مثالها:
* شنبه: [sham-be] (با فرایند ابدال ن به م) در برابر [shan-be].
* مهربان: [meh-ra-bân] در برابر [meh-re-bân].
* پژمردن: [pezh-mor-dan] در برابر [pezh-mar-dan].
* اشک: [ashk] در برابر [eshk] (در برخی گویشها/سبکهای کهن).
* چالش در TTS: مدل برای حفظ یکدستی صدا (Voice Consistency) باید بداند در چه سبکی (رسمی، کلاسیک، عامیانه) از کدام تلفظ استفاده کند.
۵. کلمات چنداملایی / دونویسهها (Heterographic Variants)
واژگانی با تلفظ و معنای یکسان که به دلیل قواعد متغیر فرهنگستان یا سنتهای نگارشی، به چندین شیوه نوشته میشوند:
* مثالها:
* اتاق / اطاق $\rightarrow$ [/otâğ/]
* تهران / طهران $\rightarrow$ [/tehrân/]
* مسئول / مسئول / مسئولین / مسوول $\rightarrow$ [/mas'ul/]
* جرأت / جرات $\rightarrow$ [/jor'at/]
* چالش در TTS: اگر تمام گونههای املایی در فرهنگ واژگان تلفظی (Lexicon) نگاشت نشده باشند، مدل در مواجهه با املای غیررایج دچار شکستِ خارج از واژگان (OOV) میشود.