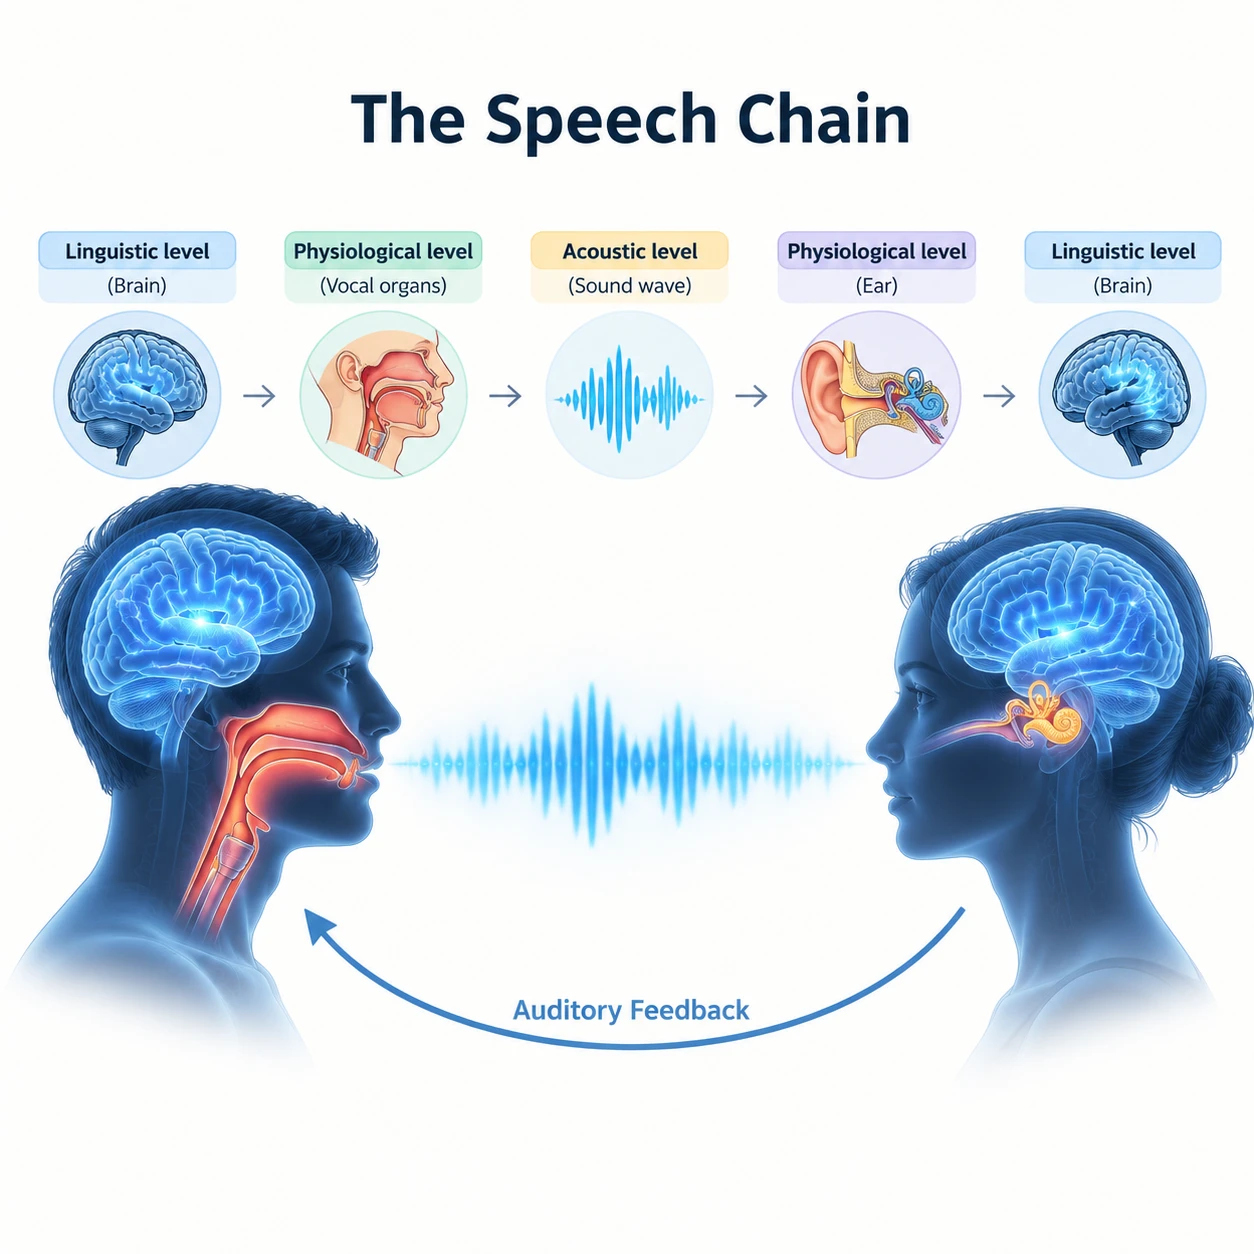
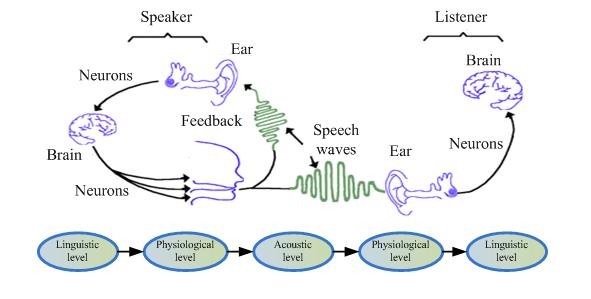
زنجیره گفتار (The Speech Chain) چارچوبی بنیادین است که توسط پیتر دِنِش (Peter Denes) و الیوت پینسون (Elliot Pinson) در سال ۱۹۶۳ تدوین شد. این مدل، فرآیند کامل ارتباط کلامی را بهصورت یک توالی پیوسته از رویدادها — از لحظهای که یک ایده در مغز گوینده شکل میگیرد تا لحظهای که آن پیام در مغز شنونده رمزگشایی و درک میشود — توصیف میکند.
این زنجیره دارای سه سطح ساختاری و یک حلقه بازخورد است:
سطح زبانی (Linguistic Level):
در سمت گوینده: انتزاعیترین لایه؛ شامل مفهومسازی (Conceptualization)، بازیابی واژگان (Lexical Selection) و قالبریزی قواعد دستوری و واجشناختی (Phonological Encoding).
در سمت شنونده: تبدیل رشته واجهای دریافتی به کلمات، تحلیل نحوی و استخراج پیام معنایی نهایی.
سطح فیزیولوژیکی / اندامهای گویایی و شنوایی (Physiological Level):
در سمت گوینده (تولید گفتار - Speech Production): صدور سیگنالهای الکتروفیزیولوژیک عصبی از قشر حرکتی مغز و هدایت ماهیچههای تنفسی، حنجره، زبان، لبها و کام نرم جهت تولید صدا.
در سمت شنونده (دریافت و درک گفتار - Speech Perception): دریافت موج صوتی توسط لاله و مجرای گوش، نوسان پرده صماخ، تبدیل مکانیکی در استخوانچهها، و در نهایت تبدیل به پالسهای عصبی در سلولهای مویی حلزون گوش (Cochlea).
سطح آکوستیکی (Acoustic Level):
پل فیزیکی میان گوینده و شنونده؛ ارتعاش مولکولهای هوا بهصورت امواج فشار طولی پیوسته که با کمیتهای فیزیکی مانند بسامد، دامنه، طیف، انرژی و زمان توصیف میشود.
حلقه بازخورد شنیداری (Auditory Feedback Loop):
گوینده همزمان با تولید صوت، صدای خود را از طریق مسیر هدایت هوایی و استخوانی میشنود و پارامترهای بلندی، آهنگ) و صحت کلمات را بهصورت بلادرنگ پایش و اصلاح میکند.
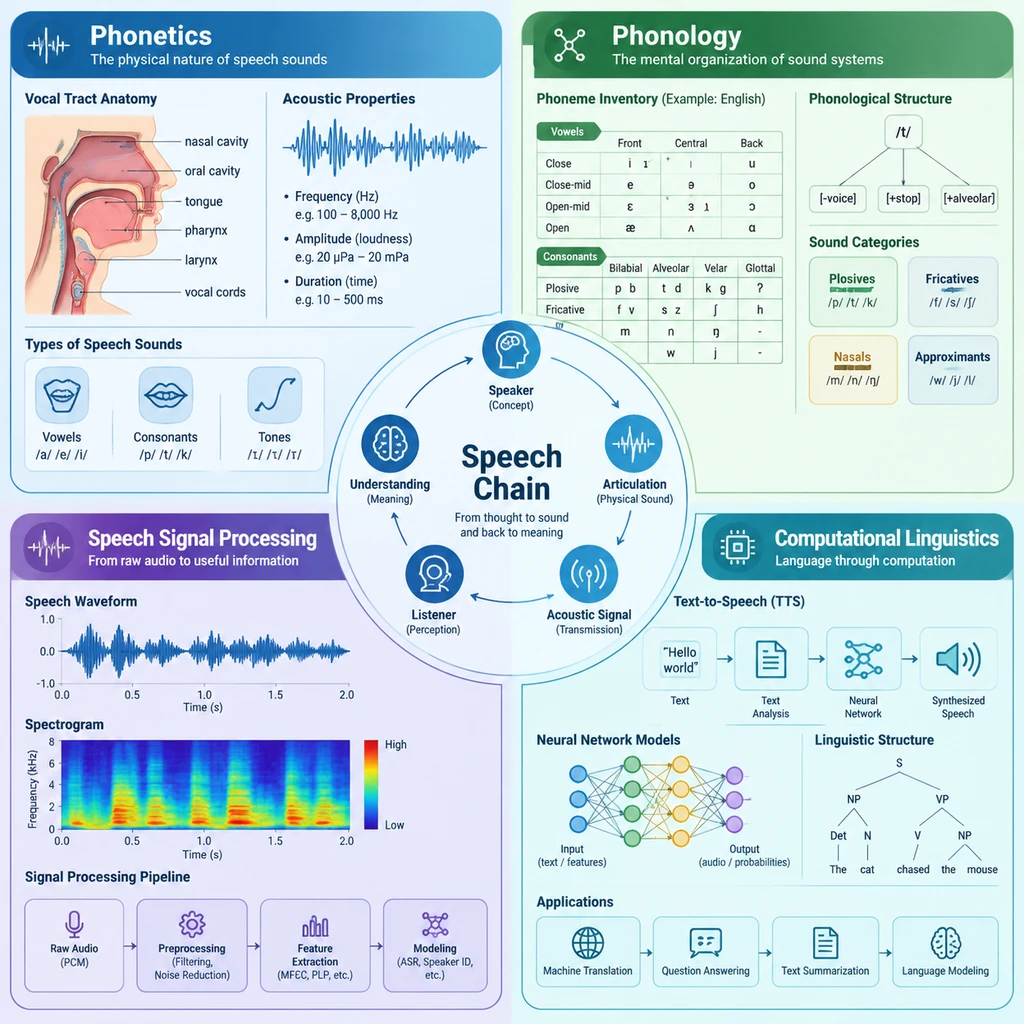
آواشناسی مطالعه ویژگیهای فیزیکی، فیزیولوژیکی و ادراکی صداهای گفتار مستقل از نقش دستوری آنهاست. سه شاخه کلاسیک آواشناسی دقیقاً بر سه سطح زنجیره گفتار منطبق هستند:
1. آواشناسی تولیدی (Articulatory Phonetics) سطح فیزیولوژیک گوینده:
* بررسی نحوه شکلگیری صداها بهوسیله اندامهای گفتار (جایگاه و شیوه تولید، وضعیت چاکنای).
تفکیک اصوات واکدار (Voiced) از بیواک (Voiceless) و تحلیل پدیده همتولیدی (Coarticulation) که در آن حرکات اندامهای گویایی برای تولید واجهای پیاپی روی یکدیگر همپوشانی مکانیکی پیدا میکنند.
2. آواشناسی آکوستیک (Acoustic Phonetics) سطح آکوستیک:
* تحلیل شکلموج گفتار بدون دخالت گوینده یا شنونده.
استخراج فرکانسهای تشدید مجرای گفتار (فرمانتها یا همان سازه ها) که شاخص واکهها هستند، زمان آغاز واکداری (VOT - Voice Onset Time) برای تفکیک صامتهای انسدادی، و طیف نوفه برای سایشیها.
3. آواشناسی ادراکی/شنیداری (Auditory/Perceptual Phonetics) سطح فیزیولوژیک شنونده:
* تبدیل مکانیکی-عصبی امواج در گوش درونی (تبدیل فرکانسی بر اساس غشای پایهای حلزون گوش) و ادراک بلندی (Loudness)، زیروبمی (Pitch) و طنین صدا.
اگر آواشناسی به بررسی «ماده خام فیزیکی» صوت بپردازد، واجشناسی به مطالعه «نظام انتزاعی و کارکردی اصوات در یک زبان خاص» اختصاص دارد. زنجیره گفتار مرز و پل میان امر انتزاعی و امر فیزیکی را روشن میکند:
1. تفکیک واج (Phoneme) از تکواژآوا (Allophone):
* سطح زبانی: واج یک واحد ذهنی، گسسته و انتزاعی است (مانند واج /k/).
* سطح فیزیولوژیک و آکوستیک: این واج بسته به بافت مجاور، بهصورتهای متفاوتی در جهان واقعی ادا میشود (مثلاً [kʰ] در «کارد» در مقایسه با [c] در «کاردستی»). زنجیره گفتار توضیح میدهد که چگونه مغز شنونده علیرغم تنوع آکوستیکی، این تغییرات پیوسته را به یک دسته واجی یکسان نگاشت میدهد (ادراک مقولهای / Categorical Perception).
2. بررسی قواعد واجشناختی و محدودیتهای فیزیکی:
پدیدههایی مانند همگونسازی (Assimilation)، حذف (Deletion) و اضافه (Epenthesis) در سطح زبانی، ریشه در اصل کمترین تلاش حرکتی (Economy of Effort) در سطح فیزیولوژیک زنجیره دارند.
3. واجشناسی زبربسامدی (Suprasegmental Phonology):
* تکیه، تکیه وزنی، درنگ و آهنگ کلام (Intonation) ساختارهای انتزاعی زبانی هستند که از طریق پارامترهای آکوستیکی (f0، دیرش، دامنه انرژی) در زنجیره رمزگذاری و ارسال میشوند.
در مهندسی برق و کامپیوتر و هوش مصنوعی، زنجیره گفتار پایه ساخت سیستمهای مدلسازی، فشردهسازی و سنتز سیگنال است:
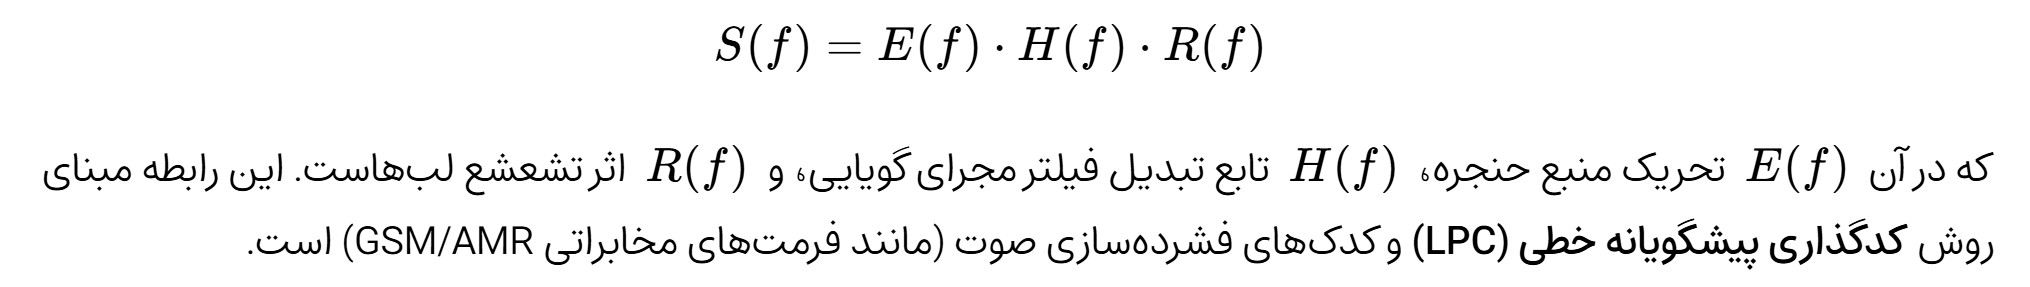
1. نظریه منبع-مجرا (Source-Filter Model):
* برآمده از تفکیک لایه فیزیولوژیک و آکوستیک:
2. استخراج ویژگی با الهام از شنوایی (Auditory Feature Extraction):
طراحی ویژگیهای هوشمندانه و کاربردی MFCC (ضرایب کپسترال بر مقیاس مل) و فیلتربانکهای Gammatone بر اساس پردازش مکانیکی صوت در حلزون شنوایی (سطح فیزیولوژیک شنونده) انجام شده است، زیرا گوش انسان فیلتری با حساسیت لگاریتمی نسبت به فرکانس است.
3. بازشناسی خودکار گفتار (ASR) و سنتز گفتار (TTS):
* ASR: معکوسسازی زنجیره گفتار؛ تبدیل دادههای عددی سیگنال رقمی گفتار از دامنه لرزش هوا (آکوستیک) به برچسبهای آوایی و سپس جملات زبانی.
* TTS: حرکت در جهت مستقیم زنجیره؛ تبدیل متن (زبانی) به مشخصات واجی، تبدیل آن به پارامترهای فیزیکی/اسپکتروگرام و در نهایت تولید شکلموج صوتی توسط Vocoderها.
زبانشناسی رایانهای و پردازش زبان طبیعی (NLP) پیوند میان قواعد نمادین/آماری زبان و تحقق فیزیکی آن را مدلسازی میکنند:
1. مدلسازی سلسلهمراتبی زبان:
* زنجیره گفتار جریان انتقال داده را گامبهگام تفکیک میکند:
معناشناسی (Semantics)⟶نحو (Syntax)⟶صرف (Morphology)⟶واجشناسی (Phonology)⟶آکوستیک (Acoustics)
* این تفکیک به مدلهای هوش مصنوعی امکان میدهد تا مدل آکوستیک را از مدل زبان تفکیک کرده یا در سیستمهای انتها-به-انتها (End-to-End) نگاشت این سطوح را در فضاهای نهفته (Latent Spaces) بهینهسازی کنند.
2. ترازسازی اجباری واجی (Forced Alignment):
* ابزارهای محاسباتی (نظیر Montreal Forced Aligner) برای هماهنگکردن دقیق مرزهای واجی متن با فریمهای زمانی میلیثانیهای سیگنال صوتی، به تئوری پیوند لایه زبانی و آکوستیکی متکی هستند.
3. منظورشناسی و لحنشناسی محاسباتی (Computational Pragmatics):
* درک لحن طعنهآمیز، احساسات گوینده، و تفکیک انواع جملات، صرفاً با تحلیل متن نوشتاری (لایه زبانی) ممکن نیست؛ زبانشناسی رایانهای با ادغام متغیرهای زبربسامدی لایه آکوستیک، لایههای شناختی عمیقتر را تحلیل میکند.
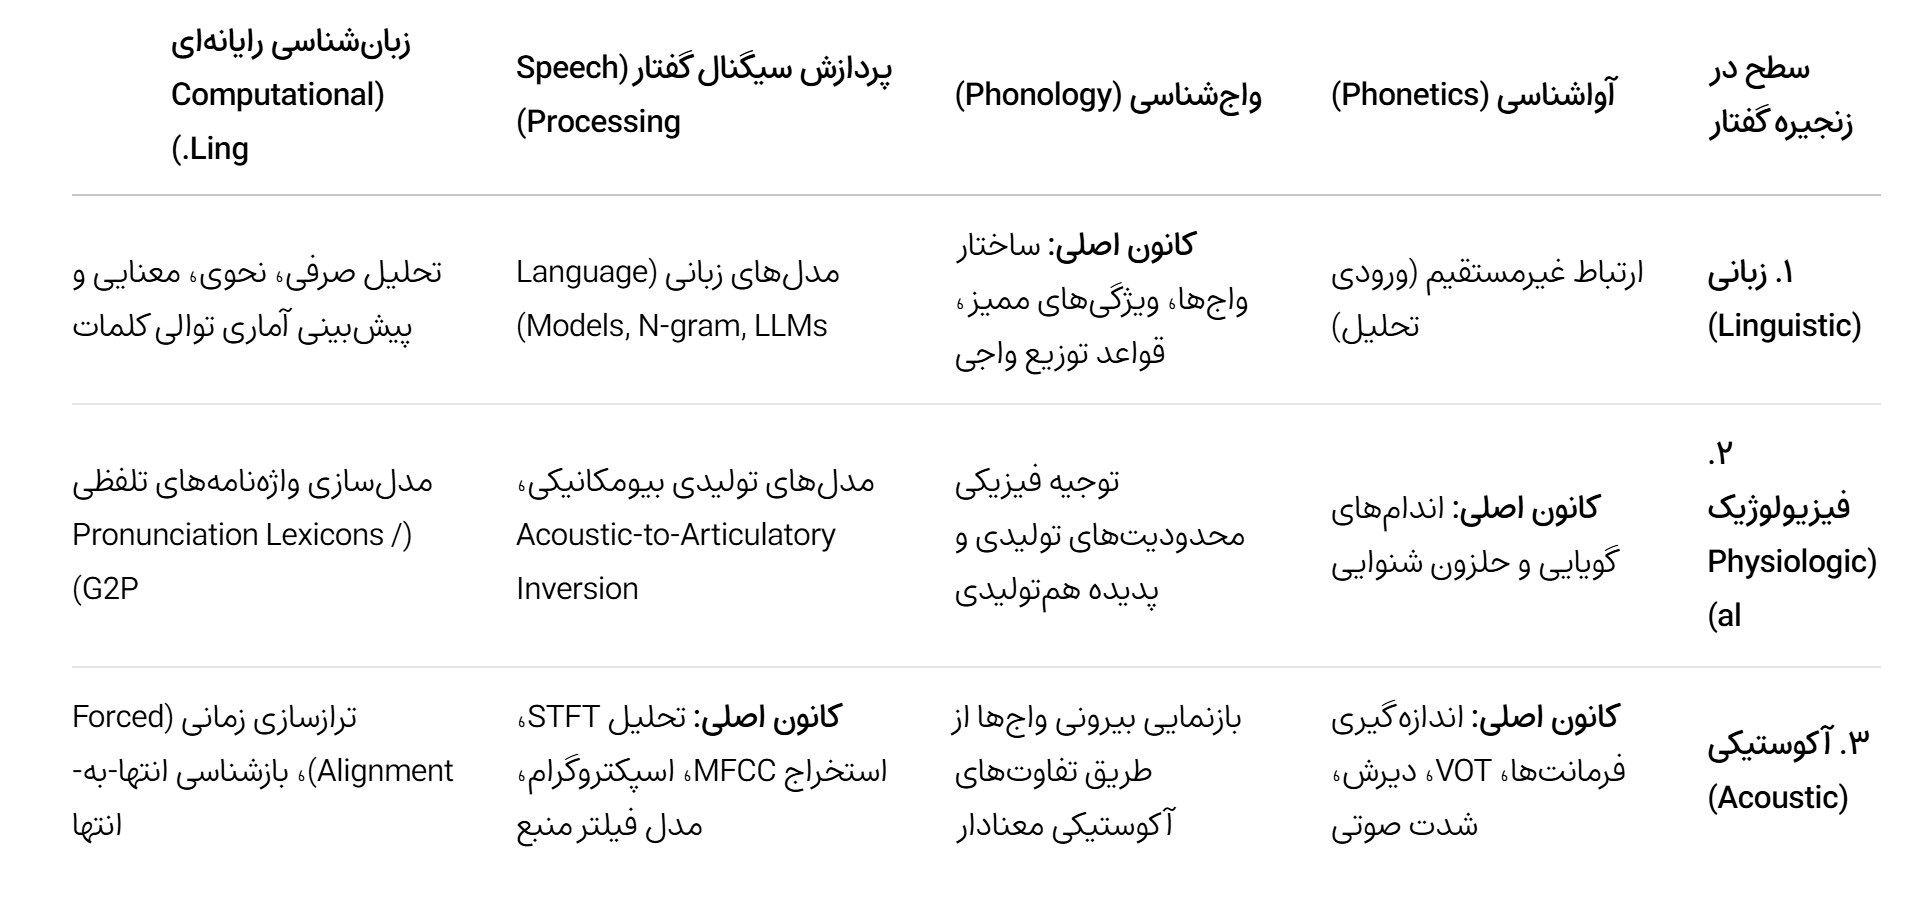
| سطح در زنجیره گفتار | آواشناسی (Phonetics) | واجشناسی (Phonology) | پردازش سیگنال گفتار (Speech Processing) | زبانشناسی رایانهای (Computational Ling.) |