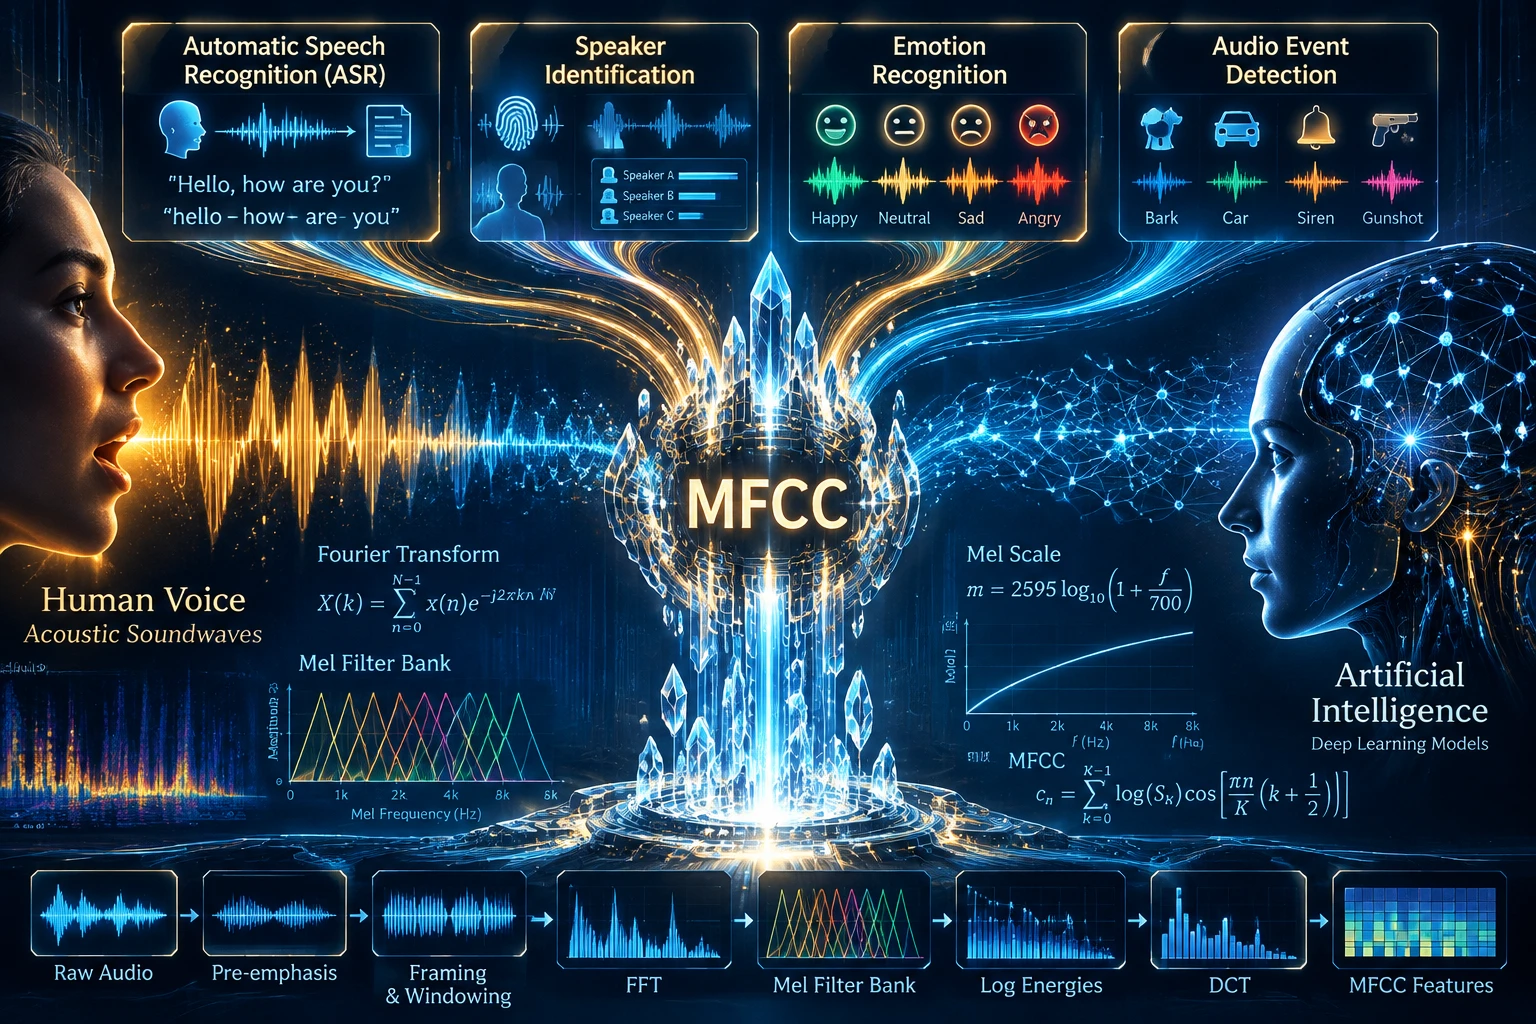
روش استخراج ویژگیهای ضرایب کپسترال در مقیاس مل (MFCC: Mel-Frequency Cepstral Coefficients) یکی از ماندگارترین، موثرترین و کلاسیکترین شاهکارهای حوزه پردازش سیگنال گفتار (Speech Signal Processing) است.
مقالهای که به عنوان مرجع اصلی و نخستین معرفی رسمی MFCC در ادبیات پردازش گفتار شناخته میشود، مقاله مشهور سال ۱۹۸۰ توسط دیویس و مِرمِلستاین (Davis & Mermelstein) است:
Davis, S. B., & Mermelstein, P. (1980).
“Comparison of parametric representations for monosyllabic word recognition in continuously spoken sentences.”
IEEE Transactions on Acoustics, Speech, and Signal Processing (ASSP), 28(4), 357–366.
اگرچه دیویس و مرملستاین پایهگذار فرم استاندارد MFCC برای بازشناسی گفتار بودند، ایده تلفیق مقیاس مل با تبدیل کپستروم نتیجه پیوند دو جریان علمی پیشین بود:
مفهوم کپستروم (Cepstrum): در سال ۱۹۶۳ توسط بوگرت، هیلی و توکی (Bogert, Healy, Tukey) برای تحلیل دادههای لرزهنگاری ابداع شد و کمی بعد در اواخر دهه ۱۹۶۰ و اوایل دهه ۱۹۷۰ توسط بزرگان DSP نظیر الن اوپنهایم (Alan V. Oppenheim) و رونالد شیفر (Ronald Schafer) وارد حوزه تحلیل همومورفیک (Homomorphic Signal Processing) گفتار شد.
مقیاس مل (Mel Scale): مقیاس ادراکی فرکانس در سال ۱۹۳۷ توسط استیونز، وولکمن و نیومن (Stevens, Volkmann, & Newman) در سایکوآکوستیک (روانشناسی صوت) معرفی شده بود.
گامهای ابتدایی فیلتربانک شنیداری: در اواسط دهه ۱۹۷۰، افرادی مانند بریجر (Bridle & Brown, 1974) از بانک فیلترهای منطبق با شنوایی استفاده کرده بودند، اما دیویس و مرملستاین بودند که فرمولاسیون دقیق MFCC (فیلتربانک مثلثی با توزیع مل + لگاریتم انرژی + تبدیل کسینوسی گسسته DCT) را فرموله کرده و برتری قاطع آن را در بازشناسی کلمات نشان دادند.
از سال ۱۹۸۰ تاکنون، این روش مسیر تکاملی پرباری را طی کرد:
معرفی ضرایب پویا (Dynamic/Delta Coefficients) - اواخر دهه ۱۹۸۰:
گفتار یک سیگنال غیرایستا (Non-stationary) است و فریمهای ایستا بتنهایی پویایی زمانی را نشان نمیدادند.
با پژوهشهای سادائو فوروی (Sadao Furui, 1986)، ضرایب مشتق اول (Delta:Δ) و مشتق دوم (Delta-Delta:ΔΔ یا شتاب) به بردار ویژگی اضافه شدند (معمولاً بردار ۱۳تایی به ۳۹تایی تبدیل شد).
استانداردسازی صنعتی (HTK و Sphinx) - دهه ۱۹۹۰:
جعبهابزار HTK (Hidden Markov Model Toolkit) دانشگاه کمبریج و جعبهابزار CMU Sphinx فرمولهای پیادهسازی MFCC را استاندارد کردند (از جمله فرمول هرتز به مل، پیشتاکید/Pre-emphasis، پنجره همینگ، و پیادهسازی بهینه با DCT-II).
مقاومسازی در برابر نویز (Robustness Enhancement):
اضافه شدن تکنیکهایی مثل CMVN (نرمالسازی میانگین و واریانس کپسترال) برای حذف اثر کانال و میکروفون.
تکنیک RASTA-PLP و فیلترگذاری زمانی روی ضرایب کپسترال.
استاندارد ETSI Aurora - اوایل دهه ۲۰۰۰:
موسسه استانداردهای مخابراتی اروپا استاندارد ETSI ES 201 108 را به عنوان استاندارد استخراج ویژگی در سمت کلاینت (Distributed Speech Recognition) بر مبنای MFCC پایهگذاری کرد.
اهمیت MFCC ناشی از حل همزمان چند چالش بنیادین در مدلسازی ریاضی گفتار است:
جداسازی تحریک از پاسخ مجرای صوتی بر اساس مدل منبع-فیلتر (Source-Filter Model):
در حوزه زمان، سیگنال گفتار حاصل کانولوشن تحریک تارآواها و پاسخ ضربه مجرای صوتی است.
تبدیل فوریه کانولوشن را به ضرب و لگاریتم آن را به جمع تبدیل میکند. اعمال فیلتربانک و DCT باعث میشود شکل پوش طیفی (فورمانتها که نشاندهنده واجها هستند) در ضرایب پایین کپستروم و زیروبمی (Pitch) در ضرایب بسیار بالا قرار بگیرند و از هم تفکیک شوند.
مدلسازی فیزیولوژی گوش انسان:
گوش انسان فرکانسها را به صورت خطی درک نمیکند. تفکیک در فرکانسهای زیر ۱ کیلوهرتز بسیار دقیق و در فرکانسهای بالا لگاریتمی/تراکمپذیر است (بحرانی در درک واکهها و همخوانها).
پایهگذاری دوران طلایی HMM-GMM:
سیستمهای بازشناسی گفتار برای دههها بر پایه مدلهای مخفی مارکوف و ترکیبهای گاوسی (GMM-HMM) استوار بودند. بدون MFCC، آموزش ماتریسهای کوواریانس قطری با ابعاد فضا غیرممکن یا بسیار ناپایدار میشد.
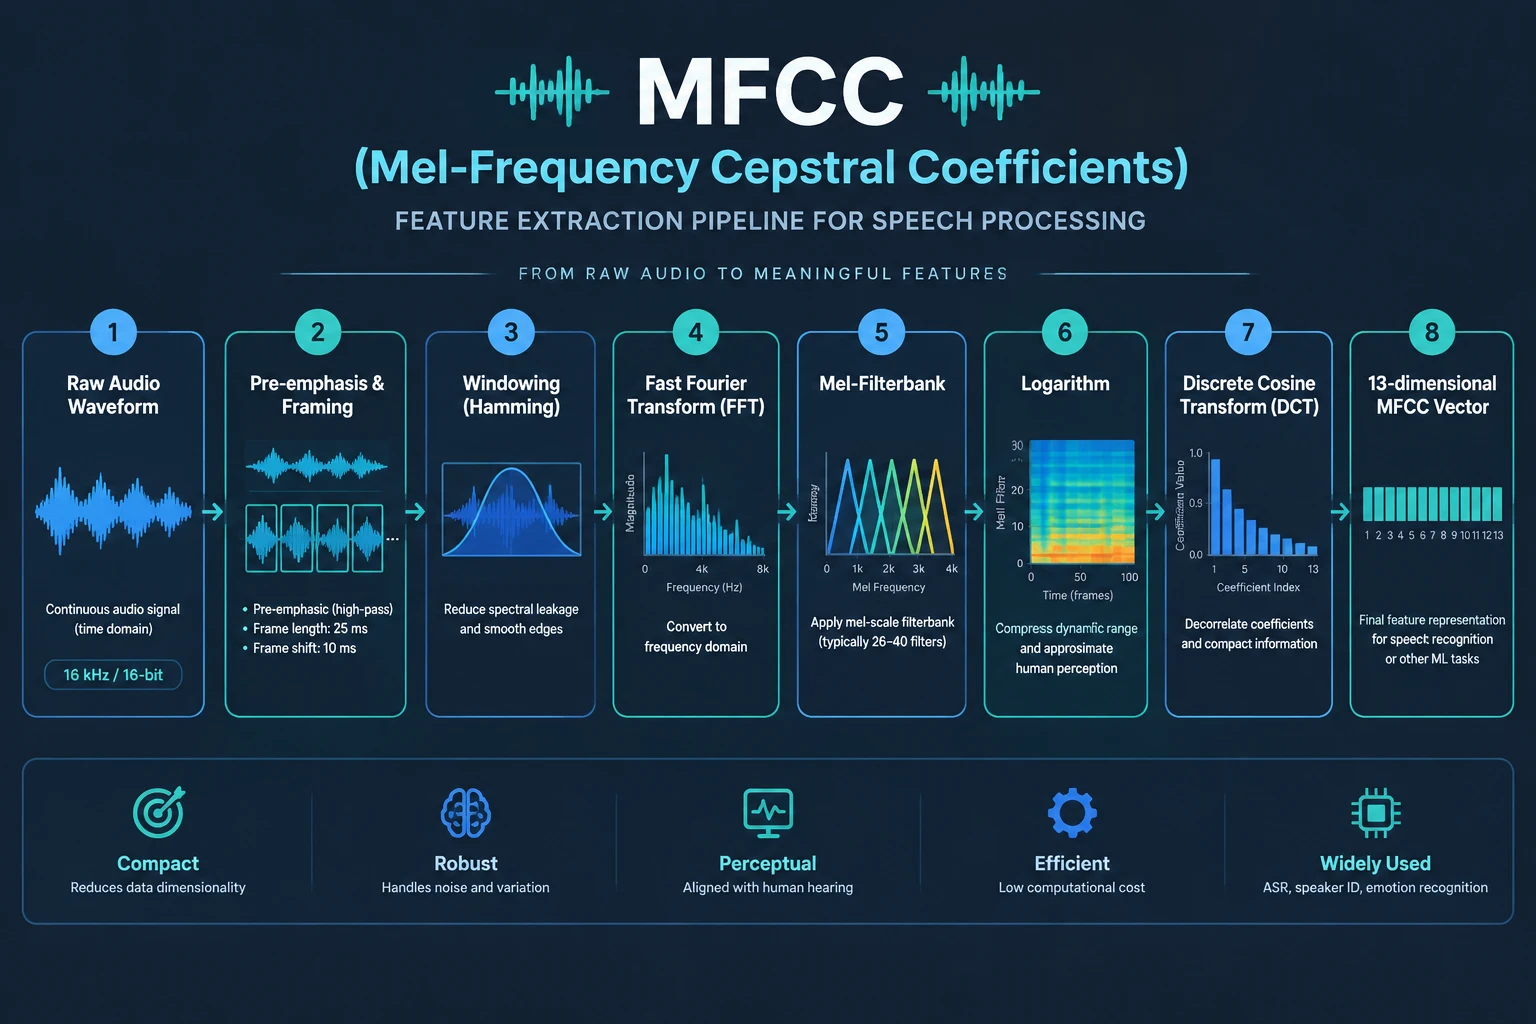
با وجود ورود یادگیری عمیق، شبکههای End-to-End و مدلهای خودنظارتی مدرن (مانند wav2vec 2.0 و Whisper) که روی سیگنال خام یا اسپکتوگرام خطی آموزش میبینند، روش استخراج ویژگی گفتاری MFCC هنوز زنده است، تدریس میشود و در بسیاری از سیستمهای عملیاتی به کار میرود. دلایل این ماندگاری عبارتند از:
متعامدسازی و استقلال آماری مولفهها با DCT (Decorrelation):
تبدیل کسینوسی گسسته (DCT) در واقع تقریب بسیار نزدیکی از تبدیل بهینه کاروهنن-لوو (KLT) برای فرآیندهای مارکوف مرتبه اول است.
این تبدیل باعث میشود ابعاد بردار ویژگی تقریباً ناهمبسته (Uncorrelated) شوند. این ویژگی به مدلها اجازه میدهد به جای ماتریس کوواریانس کامل، از کوواریانس قطری (Diagonal Covariance) استفاده کنند که حجم محاسبات و خطر بیشبرازش (Overfitting) را فوقالعاده کاهش میدهد.
کاهش ابعاد فشرده و کارآمد (High Information Density):
تبدیل یک فریم سیگنال چندصد نمونهای به تنها ۱۲ تا ۱۳ ضریب متراکم، بار محاسباتی ذخیره و پردازش را در لبه شبکه (Edge/Embedded Devices) به حداقل میرساند.
مقاومت ذاتی در برابر تغییرات شدت و فاز:
حذف اطلاعات فاز و استفاده از مقیاس لگاریتمی توان، بازنمایی را نسبت به تغییرات بهره (Gain) و تغییرات فاز آکوستیکی پایدار میکند.
تطبیق فوقالعاده با سیستم ادراک شنوایی (Auditory System Alignment):
MFCC بر اساس اصول اثباتشده بیولوژیکی شنوایی طراحی شده و به همین دلیل برخلاف روشهای صِرفاً دادهمحور، وابسته به توزیع داده خاصی نیست و یک بایاس استقرایی (Inductive Bias) آکوستیک بسیار قدرتمند ارائه میدهد.
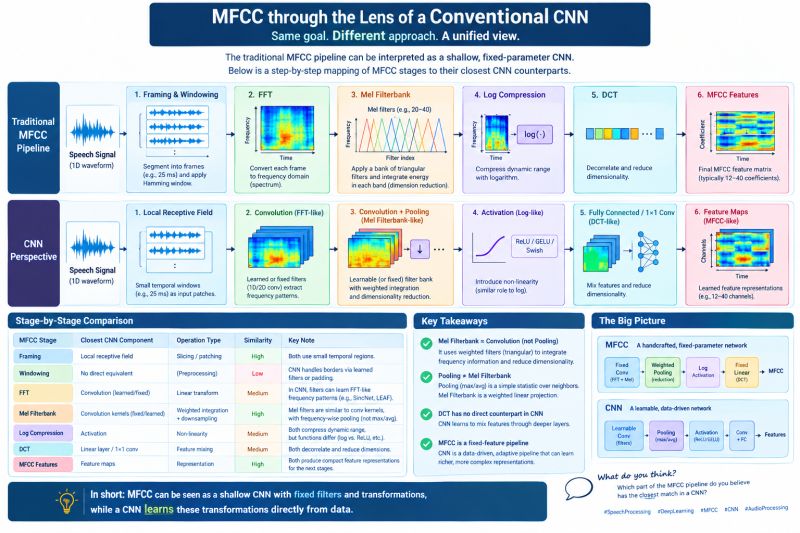
مقایسهی خط لوله (Pipeline) استخراج MFCC با یک معماری ساده شبکه عصبی پیچشی (CNN) یکی از زیباترین نقاط تلاقی پردازش سیگنال سنتی (DSP) و یادگیری عمیق (Deep Learning) است. جالب اینجاست که در یک نگاه ساختاری، MFCC را میتوان نوعی «CNN تکلایه، غیرخطی، دستساز (Handcrafted) و با وزنهای ثابت» دانست.
استخراج ویژگی موضعی (Locality): هر دو روش فرض میکنند که نمونههای مجاور در محور زمان (و محور فرکانس در اسپکتوگرام) همبستگی بالایی با هم دارند و باید در قالب پنجرهها/کرنلهای محلی تحلیل شوند.
پایایی در برابر انتقال زمان (Shift/Translation Invariance): در CNN این ویژگی از طریق اشتراک وزنها (Weight Sharing) و Pooling حاصل میشود؛ در MFCC با پنجرهبندی لغزان زمان (STFT) و میانگینگیری انرژی در باندهای فرکانسی.
سلسلهمراتب استخراج اطلاعات: هر دو روش سیگنال خام را از یک فضای بسیار پربُعد با همبستگی بالا به یک فضای نهفته (Latent Space) کمبُعد با چگالی اطلاعاتی بالا تصویر میکنند.
علیرغم شباهتهای عملکردی، فلسفه و رفتار ریاضی این دو تفاوتهای عمیقی دارد:
الف) وزنهای ثابت بر اساس فیزیک در برابر وزنهای یادگیریپذیر (Handcrafted vs. Data-Driven)
در MFCC: تمامی وزنها و پارامترها (ضرایب فیلتر پیشتاکید، شکل و پهنای باند فیلترهای مثلثی مِل، توابع کسینوسی DCT) کاملاً تحلیلی و ثابت (Hardcoded) هستند. این فیلترها بر اساس مدل فیزیولوژیکی شنوایی انسان و تئوری خطی سیستمها طراحی شدهاند و نیازی به داده آموزشی ندارند.
در CNN: کرنلهای پیچشی تصادفی مقداردهی اولیه شده و از طریق الگوریتم پسانتشار خطا (Backpropagation) و گرادیان کاهشی بهینهسازی میشوند تا بهترین ویژگیها را مستقیماً از داده و برای تسک خاص (Task-Specific) بیاموزند.
ب) ناهمبستهسازی در برابر حفظ توپولوژی (DCT vs. Convolutions)
در MFCC: با اعمال DCT، همبستگی بین ابعاد از بین میرود و ترتیب بردار خروجی اهمیت موضعی خود را از دست میدهد (ضریب ۱ با ضریب ۲ مجاور فضایی نیستند، بلکه مؤلفههای متعامد KLT هستند). این ویژگی دقیقاً برای مدلهای قدیمی مثل GMM-HMM حیاتی بود.
در CNN: اگر خروجی نهایی یک لایه به لایه کانولوشن بعدی برود، حفظ رابطه همسایگی ابعاد (Local Structure) بسیار مهم است. به همین دلیل در شبکههای CNN عمیق مدرن صوتی، معمولاً از Mel-Spectrogram (بدون مرحله DCT) به عنوان ورودی استفاده میشود؛ زیرا اعمال DCT ساختار همسایگی دوبعدی زمان-فرکانس را از بین میبرد و عملیات کانولوشن دوبعدی بعدی را بیمعنی میکند.
ج) عمق معماری و ظرفیت مدل (Shallow vs. Deep Representation)
در MFCC: این پایپلاین ذاتاً یک تبدیل کمعمق (Shallow) با مرتبه محاسباتی مشخص و ثابت است و ویژگیهای سطح پایین آکوستیکی (عمدتاً شکل مجرای صوتی و پوش طیفی) را استخراج میکند.
در CNN: با چیدن چندین لایه کانولوشن روی هم، شبکه یک سلسلهمراتب از مفاهیم انتزاعی میسازد: لایههای اول لبهها و تنهای فرکانسی را یاد میگیرند، لایههای میانی فرمانتها و تغییرات زمانی واجها را مدل میکنند و لایههای عمیق ویژگیهای کلمهای یا گوینده را انتزاع میکنند.
د) فاز سیگنال و دامنه تعمیم
در MFCC: فاز طیف به طور کامل دور ریخته میشود (فرضیه: گوش انسان تا حد زیادی نسبت به فاز نامحسوس است).
در CNNهای مدرن: اگر ورودی CNN سیگنال خام حوزه زمان باشد (مانند معماریهای SincNet یا WaveNet)، شبکه حتی میتواند اطلاعات وابسته به فاز و تأخیرهای زمانی ریز را که برای کارهایی مثل محلیسازی جهت منبع صوت یا شفافسازی گفتار مهم است، کشف و حفظ کند.