
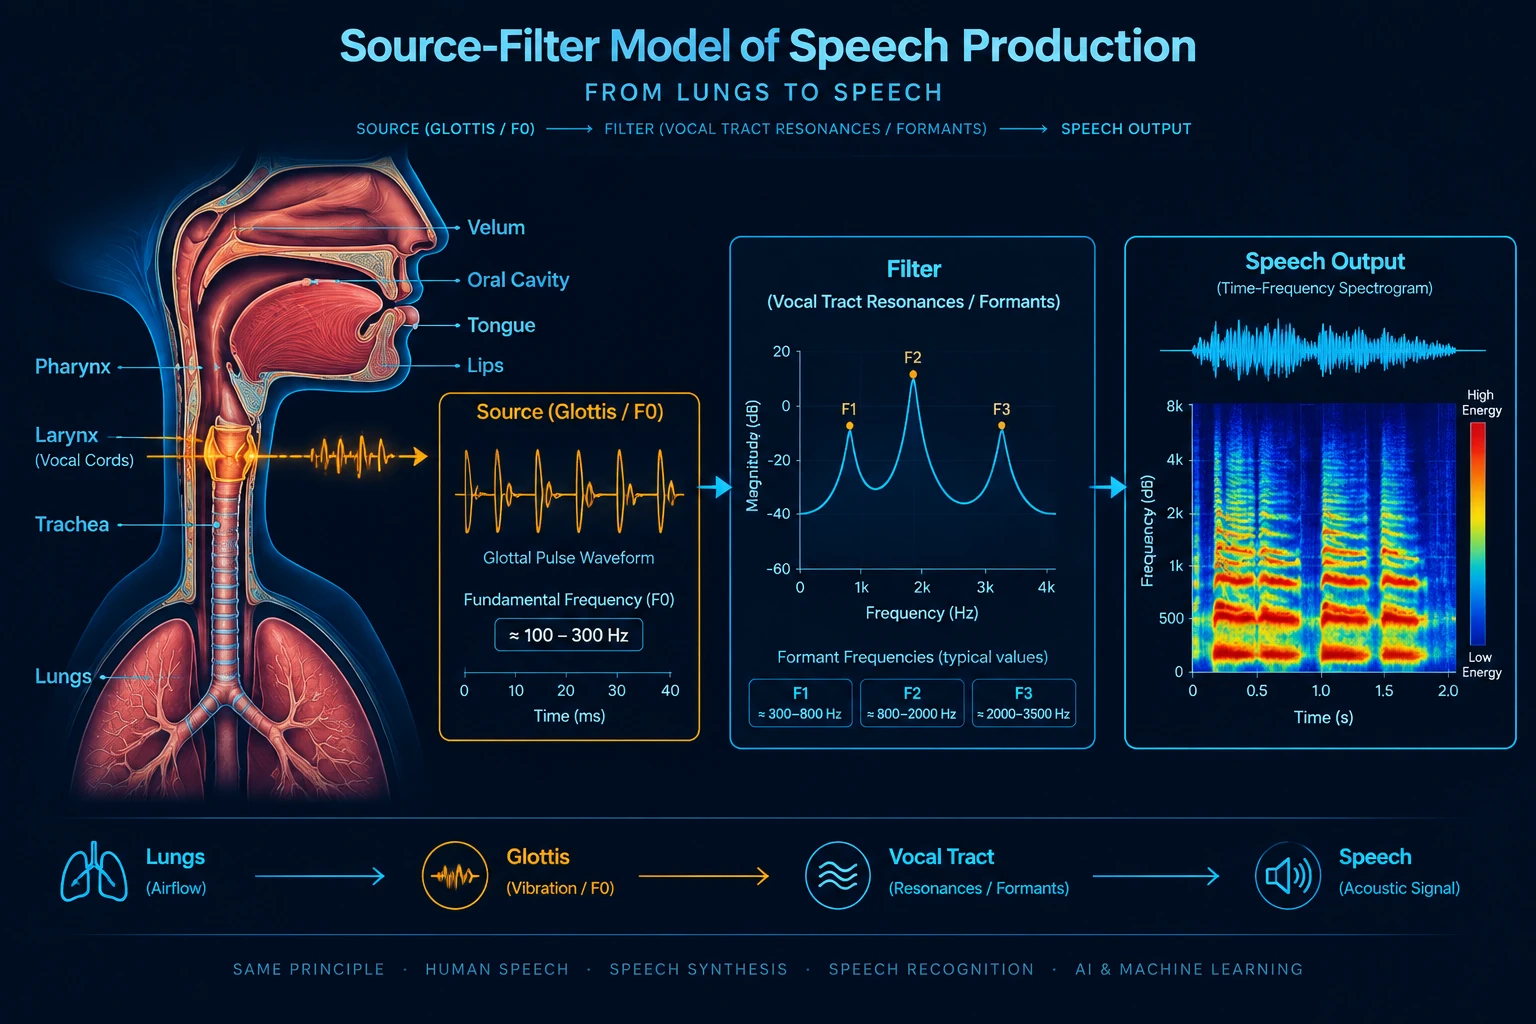
فرایند تولید گفتار از منظر فیزیولوژیک بر پایهی مدل کلاسیک منبع–فیلتر (Source-Filter Model) قابل تبیین است. در گام نخست، ریهها با تخلیه هوای بازدمی و کنترل فشار زیرچاکنایی، توان آکوستیکی اولیه را فراهم میآورند. با عبور این جریان از حنجره و به لطف اثر برنولی و خاصیت الاستیک بافت، تارهای صوتی به نوسان درمیآیند؛ حاصل این پدیده برای واجهای واکدار، یک جریان هوای پالسمانند شبهدورهای است که بسامد پایهی آن (F_0) را تعیین میکند، در حالی که برای اصوات بیواک مانند سایشی، تنگی موضعی مجرا جریان را به منبعی نویزی و آشوبناک بدل میسازد. از دید یادگیری ماشین، ویژگیهای منبع مانند F_0، تغییرات پریودیک (Jitter/Shimmer) و نسبت هارمونیک به نویز (HNR)، همبستگی مستقیمی با فیزیولوژی حنجره دارند و سرنخهای کلیدی در وظایفی چون تشخیص هیجان (SER) و ارزیابی آسیبهای صوتی به شمار میروند (Fant, 1960; Titze, 1994).
در مرحلهی دوم، سیگنال خام حنجره وارد مجرای گفتاری (شامل حلق، حفره دهان و بینی) میشود که در نقش یک فیلتر آکوستیکی متغیر با زمان عمل میکند. تغییر موقعیت اندامهای متحرک گفتار نظیر زبان، لبها، فک پایین و نرمکام، پاسخ فرکانسی این لوله تشدیدگر را دگرگون ساخته و فرکانسهای تشدید یا همان فرمنتها (F_1, F_2, F_3,) را شکل میدهد؛ به عنوان نمونه، ارتفاع زبان فرمنت اول (F_1) و پیشآمدگی زبان فرمنت دوم (F_2) را کنترل میکند، در حالی که جفتشدن مجرای بینی قطبها و صفرهای جدیدی به طیف میافزاید. مبنای ریاضی بسیاری از بازنماییهای مهندسی—از پیشبینی خطی (LPC) گرفته تا بانکهای فیلتر (Filterbanks)—در واقع تقریب پارامتریک همین پاسخ فرکانسی مجرا است و حذف اثر منبع برای دستیابی به محتوای پایدار زبانی را هدف میگیرد (Stevens, 1998; Rabiner & Schafer, 2011).
پیوند این مفاهیم آناتومیک با یادگیری عمیق، امکان طراحی معماریهای آگاه به فیزیک (Physics-informed) و تفکیکپذیر (Disentangled) را فراهم میآورد. در بازشناسی گفتار (ASR)، شبکه میکوشد تغییرات ناشی از طول مجرا (Vocal Tract Length) و گام منبع را نرمالسازی کرده و تنها بر فضای تبدیل فرمنتی تمرکز کند. برعکس، در بازشناسی گوینده (Speaker Verification)، اثرات مجرای صوتی و ویژگیهای ساختاری تارهای صوتی به عنوان بیومتریک زیست سنجی استخراج میشوند. در تبدیل صدا (VC) و سنتز گفتار (TTS) نیز شکستن بازنمایی نهفته به دو مولفهی فیزیولوژیکِ «منبع/نوایی» (F_0 و انرژی) و «فیلتر/محتوا» (طیف فرمَنتها)، از پایهایترین راهکارها برای دستیابی به مدلهای چندگوینده بهشمار میرود (Dutoit, 1997; Shen et al., 2018).
مراجع علمی
- Fant, G. (1960). Acoustic Theory of Speech Production. Mouton & Co. (مرجع کلاسیک نظریه منبع–فیلتر)
- Titze, I. R. (1994). Principles of Voice Production. Prentice Hall. (مرجع فیزیولوژی و بیومکانیک حنجره)
- Stevens, K. N. (1998). Acoustic Phonetics. MIT Press. (نگاشت تحلیلی آناتومی مجرا به فرمنتها)
- Quatieri, T. F. (2002). Discrete-Time Speech Signal Processing: Principles and Practice. Prentice Hall. (پیوند پردازش سیگنال، تحلیل خطی مجرا و کاربردها)
- Rabiner, L. R., & Schafer, R. W. (2011). Theory and Applications of Digital Speech Processing. Pearson.
- Shen, J., et al. (2018). "Natural TTS Synthesis by Conditioning Wavenet on Mel Spectrogram Predictions." IEEE ICASSP. (پیوند نمایش منبع-فیلتر مل با مدلهای نوین)

