
تولد: اواخر تابستان ۲۰۱۶.
تیم DeepMind با معرفی WaveNet نشان داد که یک شبکهٔ عصبی کانولوشنیِ خودرگرسیو میتواند شکلموج صوت را مستقیماً، نمونهبهنمونه، مدل کند و تولید کند. این رویکرد کیفیت گفتار مصنوعی را بهطور چشمگیری ارتقا داد و فاصلهٔ آن را با گفتار طبیعی کاهش داد.
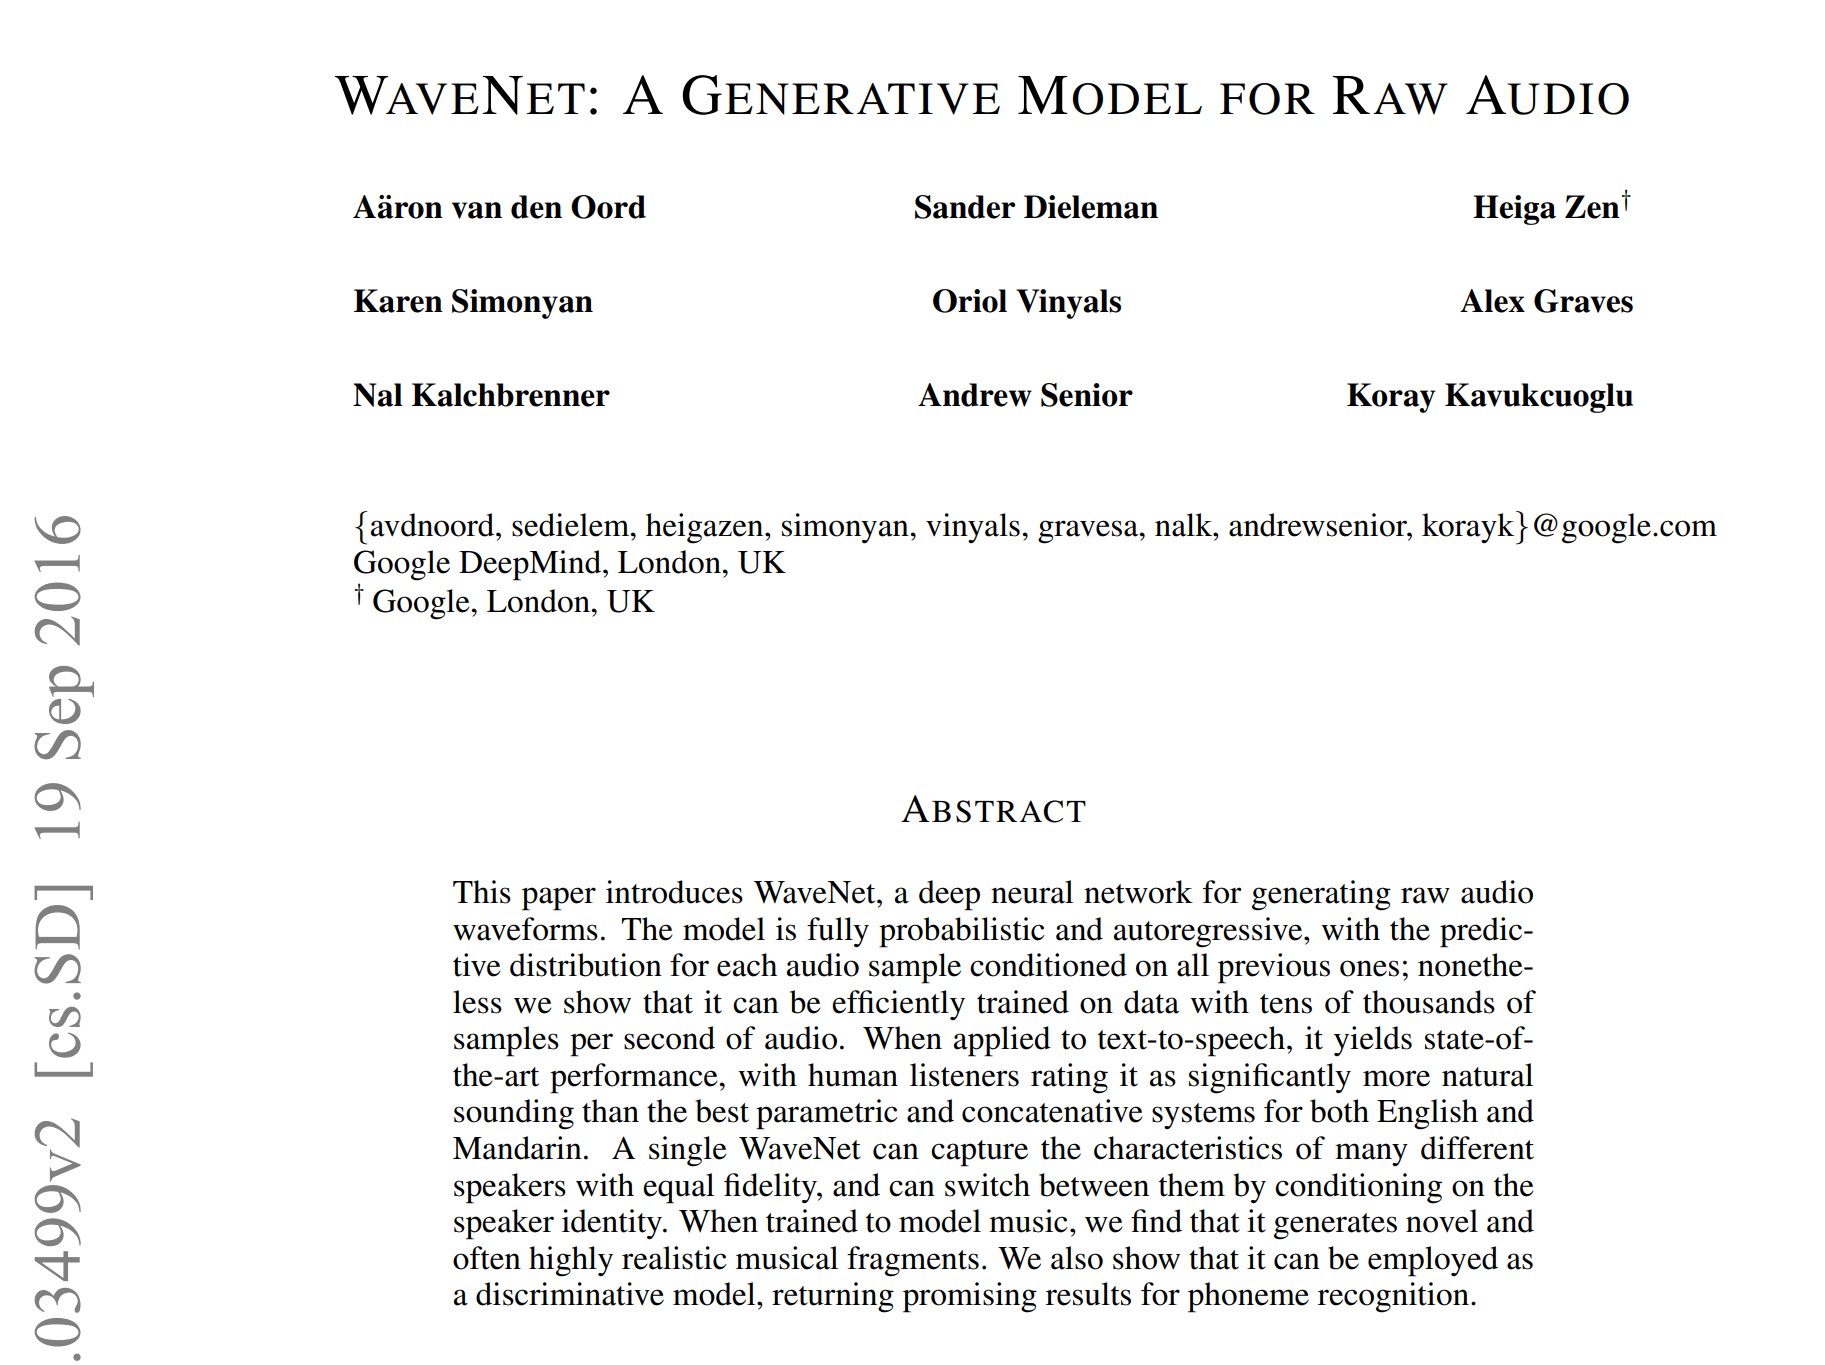
پیش از WaveNet، سامانههای تبدیل متن به گفتار (TTS) یا از سنتز الحاقی استفاده میکردند؛ یعنی تکههایی از گفتار ضبطشده را به هم میچسباندند، یا از سنتز پارامتری بهره میبردند؛ یعنی ابتدا ویژگیهای آکوستیکی را برآورد و سپس با یک وکودر به صدا تبدیل میکردند. این روشها در برخی شرایط صدایی مصنوعی یا کمطبیعی تولید میکردند.
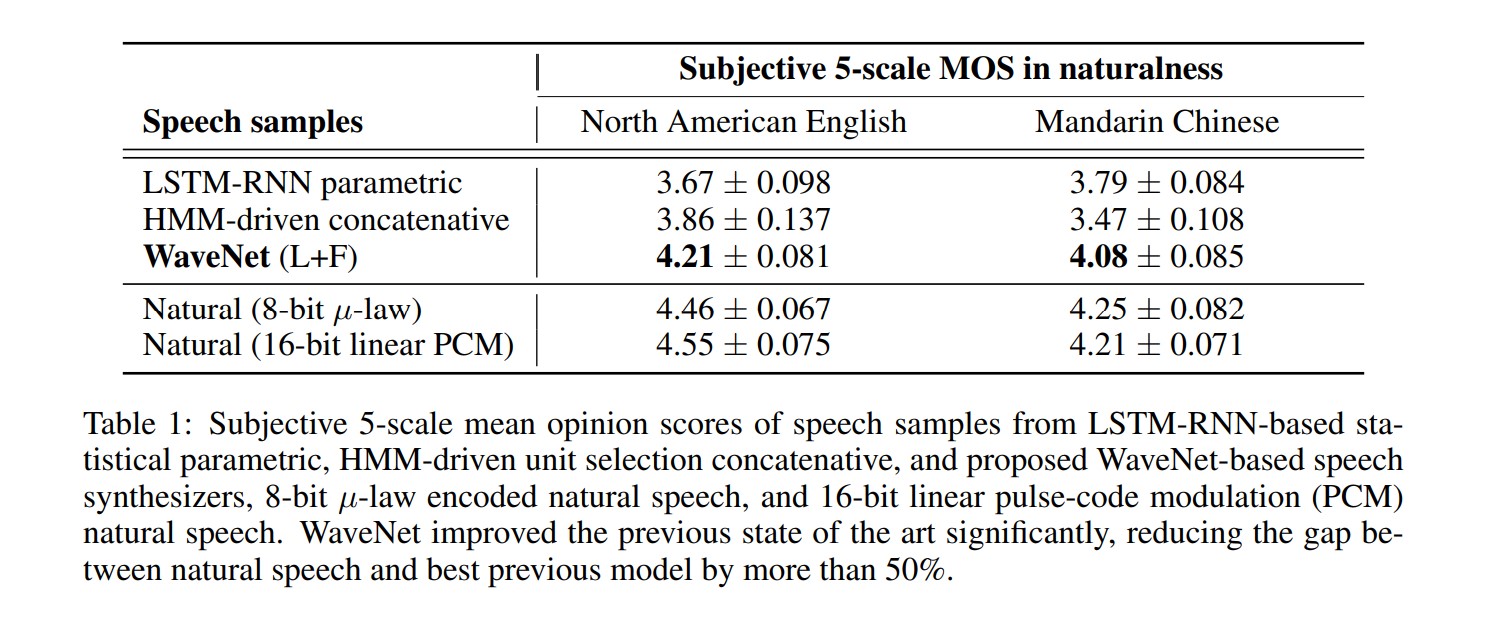
WaveNet بهجای تولید قطعههای ازپیشضبطشده یا بازسازی صدا از پارامترهای آکوستیکی، احتمال نمونهٔ بعدی موج صوتی را با توجه به نمونههای قبلی یاد میگرفت. نتیجه، بهبود محسوس طبیعیبودن صدا در آزمونهای شنیداری بود؛ هرچند کیفیت نهایی همچنان به زبان، دادهٔ آموزشی و شیوهٔ ارزیابی وابسته بود.
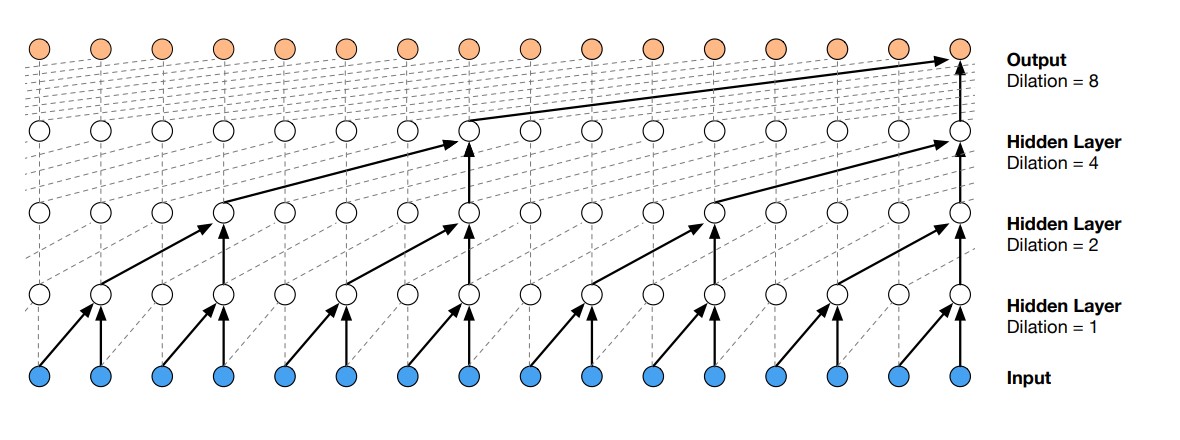
از اجزای کلیدی معماری آن، کانولوشنهای علّیِ اتساعیافته (dilated causal convolutional) بودند. علّیبودن تضمین میکرد که مدل هنگام پیشبینی، به نمونههای آینده دسترسی نداشته باشد؛ اتساعیافتگی نیز میدان دید زمانی شبکه را گسترش میداد تا وابستگیهای بلندمدت صوت را با عمق محاسباتی قابلکنترلتری بیاموزد. شبکه همچنین از فعالسازیهای دروازهای و اتصالات باقیمانده و پرشی استفاده میکرد.
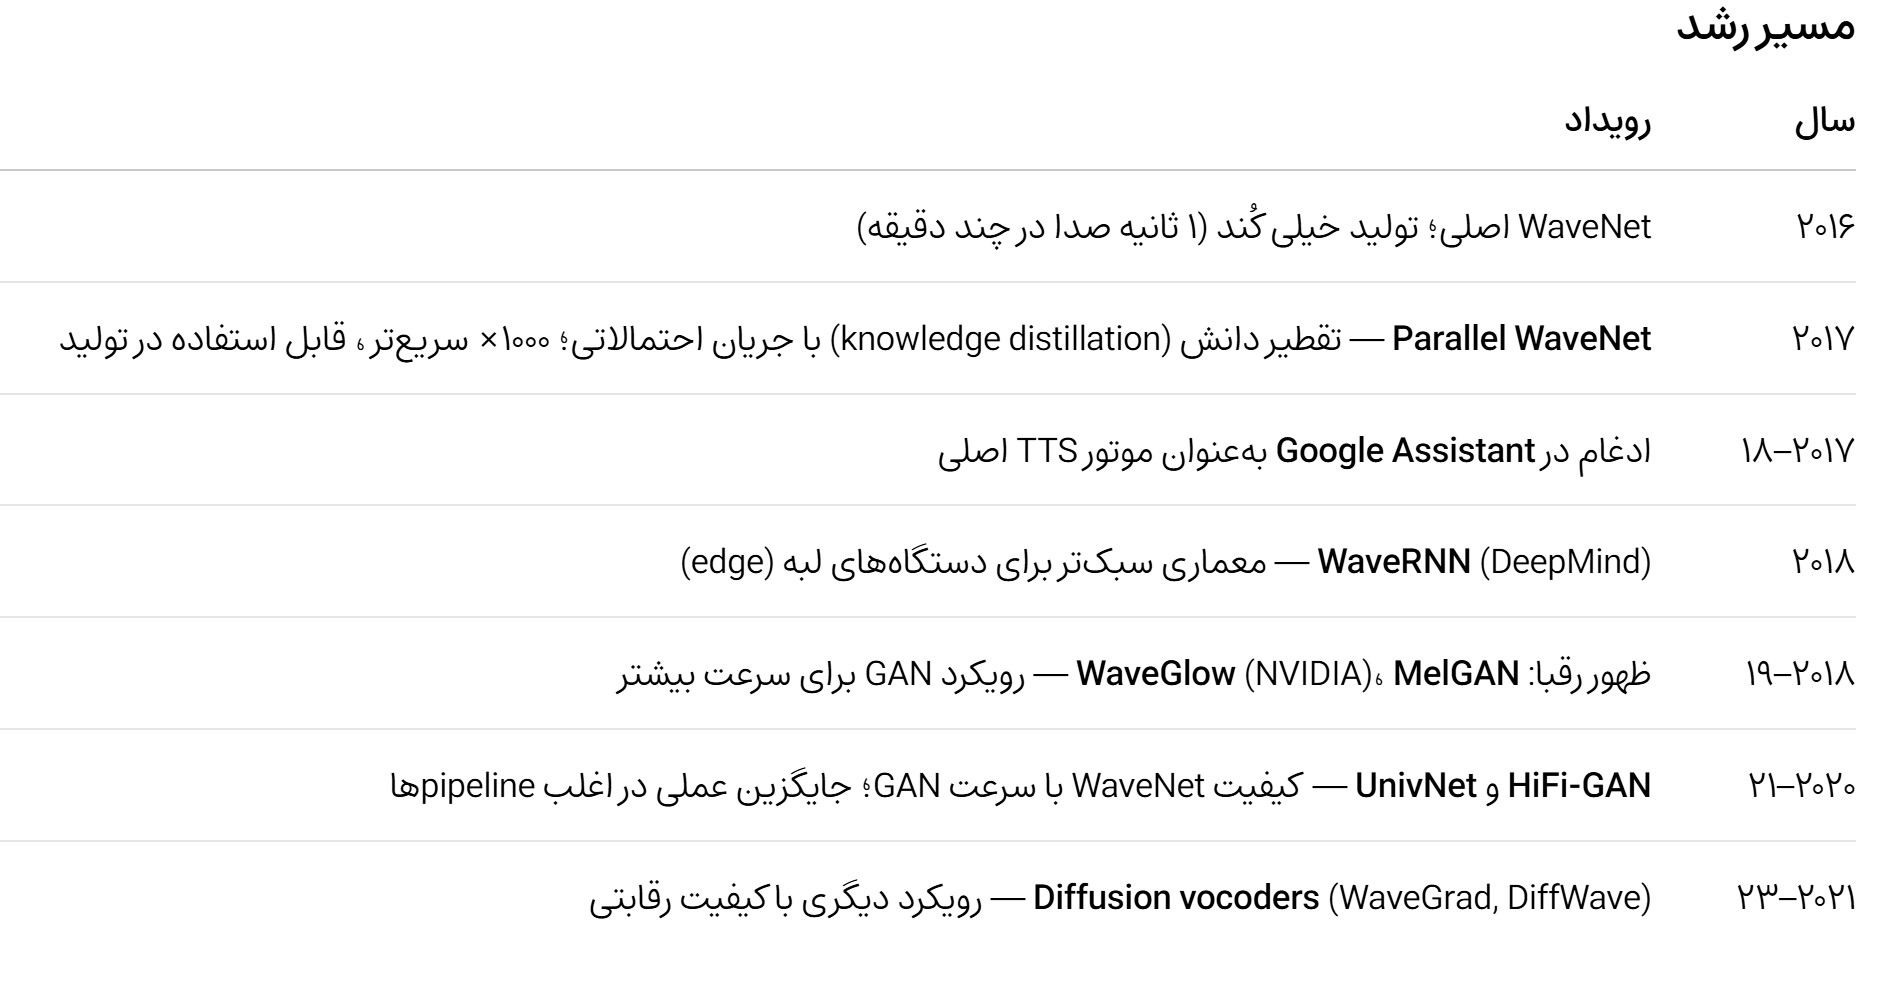
در سالهای ۲۰۲۵ و ۲۰۲۶، WaveNet دیگر معماری پیشرو برای بیشتر کاربردهای جدید نیست؛ تولید نمونهبهنمونه هزینهٔ محاسباتی و تأخیر بالایی دارد. در عوض، وکودرهای موازی و معماریهای تازهتر امکان تولید سریعتر را فراهم کردهاند. بااینحال، WaveNet نقطهٔ عطفی در تولید عصبی گفتار باقی مانده است:
بسیاری از سامانههای جدید، از جمله مدلهای یکپارچهٔ متنبهگفتار و مدلهای مولد صوت، الزاماً از معماری WaveNet استفاده نمیکنند؛ اما در همان مسیر گستردهترِ یادگیری عمیق برای تولید صوت قرار میگیرند. همچنین، در تشخیص گفتار مصنوعی و دیپفیک صوتی، شناخت روشهای تولید و ویژگیهای مدلهایی مانند WaveNet میتواند مفید باشد، اما آرتیفکتها ثابت و جهانشمول نیستند و تشخیص قابلاتکا باید بر ارزیابی تجربی و دادههای متنوع تکیه کند.
WaveNet دیگر state-of-the-art نیست، اما میراثش همهجاست:
اغلب سیستمهای TTS مدرن (VITS، NaturalSpeech 2/3، Voicebox) ایده مدلسازی موج خام یا حداقل vocoder عصبی را از آن گرفتهاند
HiFi-GAN در اکثر محصولات تجاری جای WaveNet را گرفته — سریعتر، سبکتر، کیفیت مشابه
مدلهای زبانی بزرگ مثل AudioLM و VoiceCraft از tokenization صوتی استفاده میکنند و نه vocoder سنتی — یک پارادایمشیفت جدید
در deepfake detection شناخت آثار WaveNet-based synthesis هنوز بخشی از feature engineering است — آرتیفکتهای مشخصه تولید نمونهبهنمونه قابل تشخیص هستند
ده سال پیش WaveNet نشان داد که عصبی کردن کامل pipeline صوتی ممکن است. این تغییر مسیر، نه فقط یک مدل، میراث واقعی آن است.

