
اثر هانس زرنگ (Clever Hans Effect) در مهندسی—بهویژه در حوزههای یادگیری ماشین (Machine Learning)، و آزمون و ارزیابی نرمافزار (Software Testing) —به پدیدهای گفته میشود که در آن یک سیستم یا مدل به نظر میرسد مسئله را هوشمندانه و درست حل میکند، اما در واقع با تکیه بر نشانهها، الگوهای کاذب (Spurious Correlations) یا خطاهای ناخواسته در دادهها/محیط تست به پاسخ درست رسیده است، نه با یادگیری واقعی مسئله.
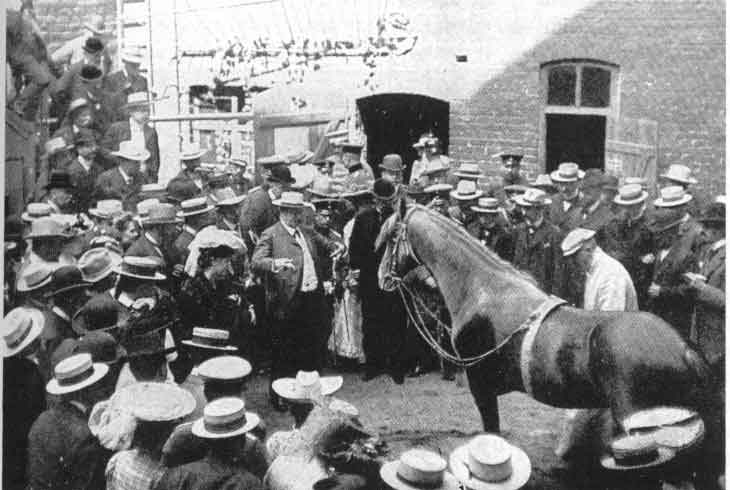
در اوایل قرن بیستم، اسبی به نام «هانس» ادعا میشد که میتواند مسائل ریاضی، جمع، تفریق و تقویم را حل کند و با سم کوبیدن روی زمین جواب بدهد. بررسیهای دقیقتر یک روانشناس (اسکار فون فونکست) نشان داد که اسب ریاضی بلد نیست، بلکه زبان بدن مربی و مخاطبان (تنش، تغییر تنفس یا نگاه هنگام نزدیک شدن به شماره درست) را میخواند و به محض دیدن نشانه توقف، سم زدن را متوقف میکرد.
این حوزه بارزترین مثالها را در دنیای مهندسی دارد:
مسئله: مدلی برای تشخیص بیماری از روی تصاویر X-Ray آموزش داده شد و دقت بالای ۹۵٪ ثبت کرد.
علت هانس زرنگ: مدل به جای بافت آسیبدیده ریه، واترمارک یا برچسب فلزی دستگاه رادیولوژی بیمارستان خاصی را یاد گرفته بود (چون بیمارستانهای تخصصی موارد بدخیم بیشتری داشتند و برچسب دستگاهشان خاص بود). در محیط عملیاتی با بیمارستان جدید، مدل کلاً شکست خورد.
مسئله: مدلی که گرگ را از سگ تفکیک میکرد، دقت بالایی داشت.
علت: تمام تصاویر گرگها در پسزمینه برف داشتند. مدل فقط حضور «برف» در پسزمینه را یاد گرفته بود، نه ویژگیهای آناتومیک گرگ!
در حوزه تشخیص پاتولوژی حنجره و صوت (Voice Pathology Detection / Dysphonia Detection) از روی سیگنال گفتار (مانند واکه کشیده/a/ یا متنهای استاندارد مثل Rainbow Passage)، پدیده Clever Hans یکی از شایعترین دلایل شکست مدلهای یادگیری عمیق در کاربردهای بالینی واقعی (Clinical Deployment) است. پایگاههای داده استاندارد و معروفی مثل MEEI (Massachusetts Eye and Ear Infirmary)، SVD (Saarbruecken Voice Database) و AVPD سالها بستر اصلی مقالات این حوزه بودهاند. با این حال، تحلیلهای متدولوژیک و بازتولیدپذیری نشان دادهاند که بخش بزرگی از دقتهای خیرهکننده (۹۵٪ تا ۱۰۰٪) در مقالات اولیه، ناشی از بهرهبرداری مدل از میانبرهای آکوستیکی نامربوط بوده است.
رسوایی معروف پایگاه داده MEEI: در نسخه اصلی پایگاه داده MEEI، صدای سوژههای سالم در یک محیط آکوستیک، با یک میکروفون و با نرخ نمونهبرداری ۲۵ کیلوهرتز (یا ۱۰ کیلوهرتز) ضبط شده بود؛ در حالی که صدای بیماران پاتولوژیک در محیط درمانگاهی بیمارستان با کارت صدای متفاوت و نرخ نمونهبرداری ۵۰ کیلوهرتز ضبط شده بود!
نتیجه: مدلهای هوش مصنوعی نیازی به اندازهگیری بینظمی در تارهای صوتی نداشتند؛ مدل صرفاً حضور یا غیاب مولفههای طیفی بالای فرکانس نایکویست نسخه سالم، یا پاسخ فرکانسی خاص میکروفون کلینیک را یاد میگرفت و به دقت ۱۰۰٪ میرسید. این مثال، کلاسیکترین هانس زرنگ در تاریخ پردازش صوت است.
در ضبط واکه کشیده /a/، بیماران مبتلا به پاتولوژیهای انسدادی یا فلج تارهای صوتی (مثل تودههای پولیپ، نودل، یا Vocal Cord Paralysis) به دلیل افت حجم تنفسی (Reduced Vital Capacity) و نشت هوا (Air Leakage)، قادر به حفظ واکه به مدت طولانی نیستند (افت شاخص MPT: Maximum Phonation Time).
در نتیجه، طول فایلهای صوتی بیماران معمولاً بسیار کوتاهتر از افراد سالم بود.
اگر در پیشپردازش، کل طول فایل به مدل داده شود، شبکه با یادگیری یک فیچر سطحی یعنی «طول سیگنال» یا تعداد فریمهای زمانی، بیمار را از سالم تفکیک میکند، بدون اینکه پایداری فرکانس پایه (F0) یا اختلال ارتعاش تارهای صوتی را بررسی کرده باشد.
پاتولوژیهای صوت شیوع نامتقارن سنی/جنسی دارند (مثلاً ادم رینکه در زنان سیگاری یا تغییرات تار صوتی سالخوردگی - Presbylaryngis در افراد مسن).
اگر توزیع سنی/جنسیتی بین دو دسته Match نباشد، طبقهبند عمیق به جای پاتولوژی، افت فرمانتها (سازه ها) و تغییرات طبیعی رزونانس صوتی ناشی از کهولت سن یا جنسیت را به عنوان اختلال صوتی یاد میگیرد.
در واکههای پایدار، لحظه شروع آواسازی (Glottal Attack) و لحظه قطع صدا ذاتاً نوسانات بالایی دارند.
در افراد سالم، این بخشها گاهی تمیزتر برش داده میشوند؛ مدل به جای تمرکز بر بخش مانا (Quasi-stationary state) واکه، صرفاً تفاوتهای مربوط به نویز ترانزینت کلیک دهان یا سگمنتیشن دستی غیردقیق را مبنا قرار میدهد.
استفاده از ابزارهای تفسیرپذیری و شفافیت (Explainable AI / XAI):
استفاده از متدهایی مثل Grad-CAM، SHAP و LIME برای دیدن اینکه مدل دقیقاً به کجای ورودی (پیکسلها، کلمات، پارامترها) توجه کرده است.
تستهای خصمانه (Adversarial Testing):
اضافه کردن نویز یا تغییر دادن پسزمینهها/متغیرهای نامربوط برای دیدن اینکه آیا خروجی به هم میریزد یا خیر (مثلاً قرار دادن گرگ در چمنزار در مثالهای قبلی).
جداسازی سختگیرانه دادهها (Data Splitting Strategy):
اطمینان از اینکه دادههای تست از منابع، محیطها، تجهیزات و توزیعهای کاملاً متفاوتی نسبت به دادههای آموزش گردآوری شدهاند.

