
مفهوم اثر مهمانی شبانه (Cocktail Party Effect) و سازوکار توجه (Attention Mechanism) در یادگیری عمیق، یکی از زیباترین و شهودیترین پیوندها میان «سیستم شنوایی انسان» و «هوش مصنوعی» را شکل میدهند.
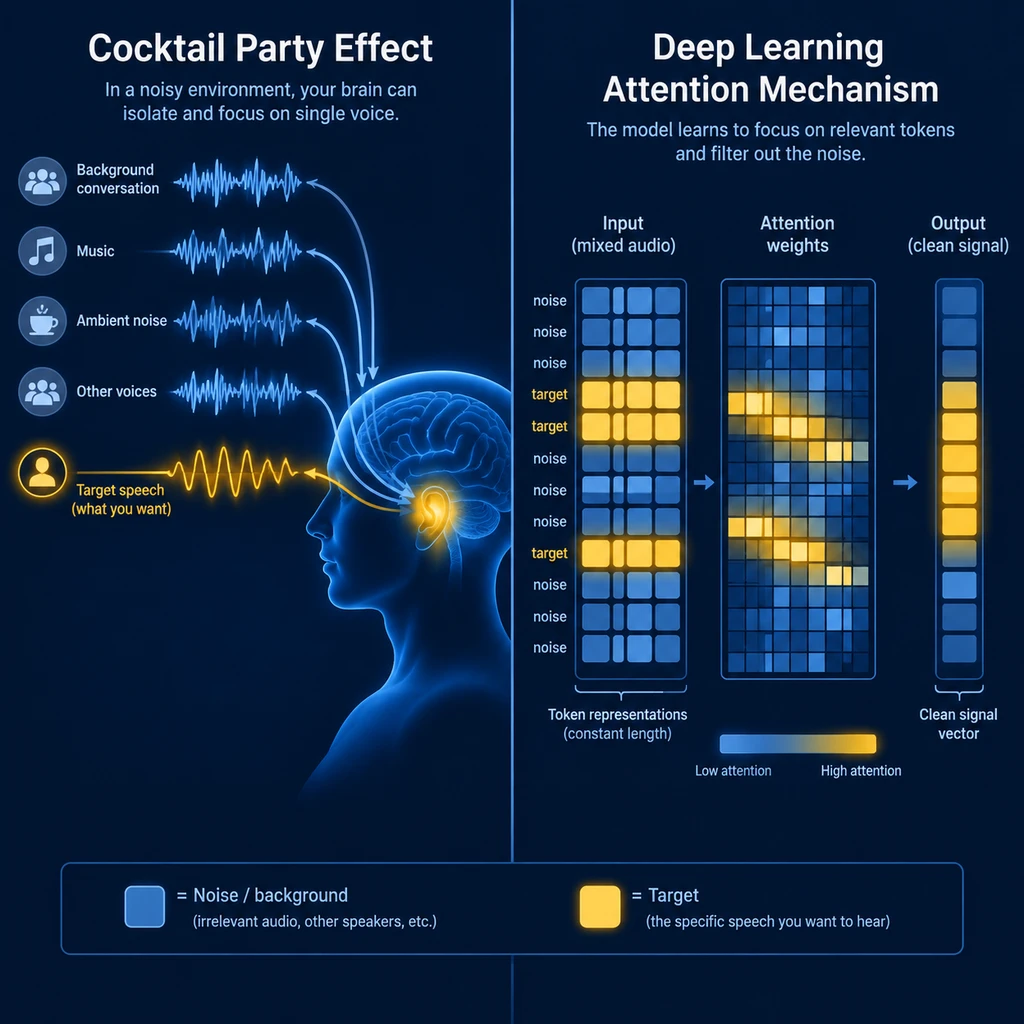
تصور کنید در یک مهمانی شلوغ هستید؛ دهها نفر همزمان صحبت میکنند، صدای موسیقی در پسزمینه پخش میشود و صدای برخورد لیوانها به گوش میرسد. با این حال، اگر روبهروی دوستی ایستاده باشید، مغز شما میتواند بهطور شگفتانگیزی صدای همه را فیلتر کرده و فقط روی صدای او تمرکز کند. جالبتر اینکه اگر فردی در آن سوی اتاق ناگهان «نام شما» را صدا بزند، توجه شما فوراً به آن سمت جلب میشود.
سیستم شنوایی انسان از دو گوش (داده دوتایی/Binaural)، حافظه صوتی، پردازش فرکانسی-زمانی مغز و فیلترهای شناختی بهره میبرد. اما برای کامپیوتر:
مسئله جداسازی منبع (Source Separation): وقتی سیگنال آکوستیک مرکب توسط یک یا چند میکروفون ضبط میشود، تفکیک سیگنالهای همپوشان بدون آگاهی قبلی از منابع، یک مسئلهی نامعین معکوس (Ill-posed Inverse Problem) است.
پیشنیاز مدلهای مدرن گفتار: مدلهای تشخیص گفتار (ASR)، احراز هویت گوینده (Speaker Verification) و تشخیص جعل صدا (Audio Deepfake Detection) در محیط واقعی (In-the-wild) اگر نتوانند گوینده هدف را از همهمه و نویز جدا کنند، با افت شدید دقت و خطای توهم روبهرو میشوند.
مکانیزم Attention در شبکههای عصبی دقیقاً با الهام از رفتار شناختی انسان ساخته شده است: «تخصیص منابع محاسباتی محدود به بخشهای مرتبط داده و نادیدهگرفتن بخشهای نامرتبط».
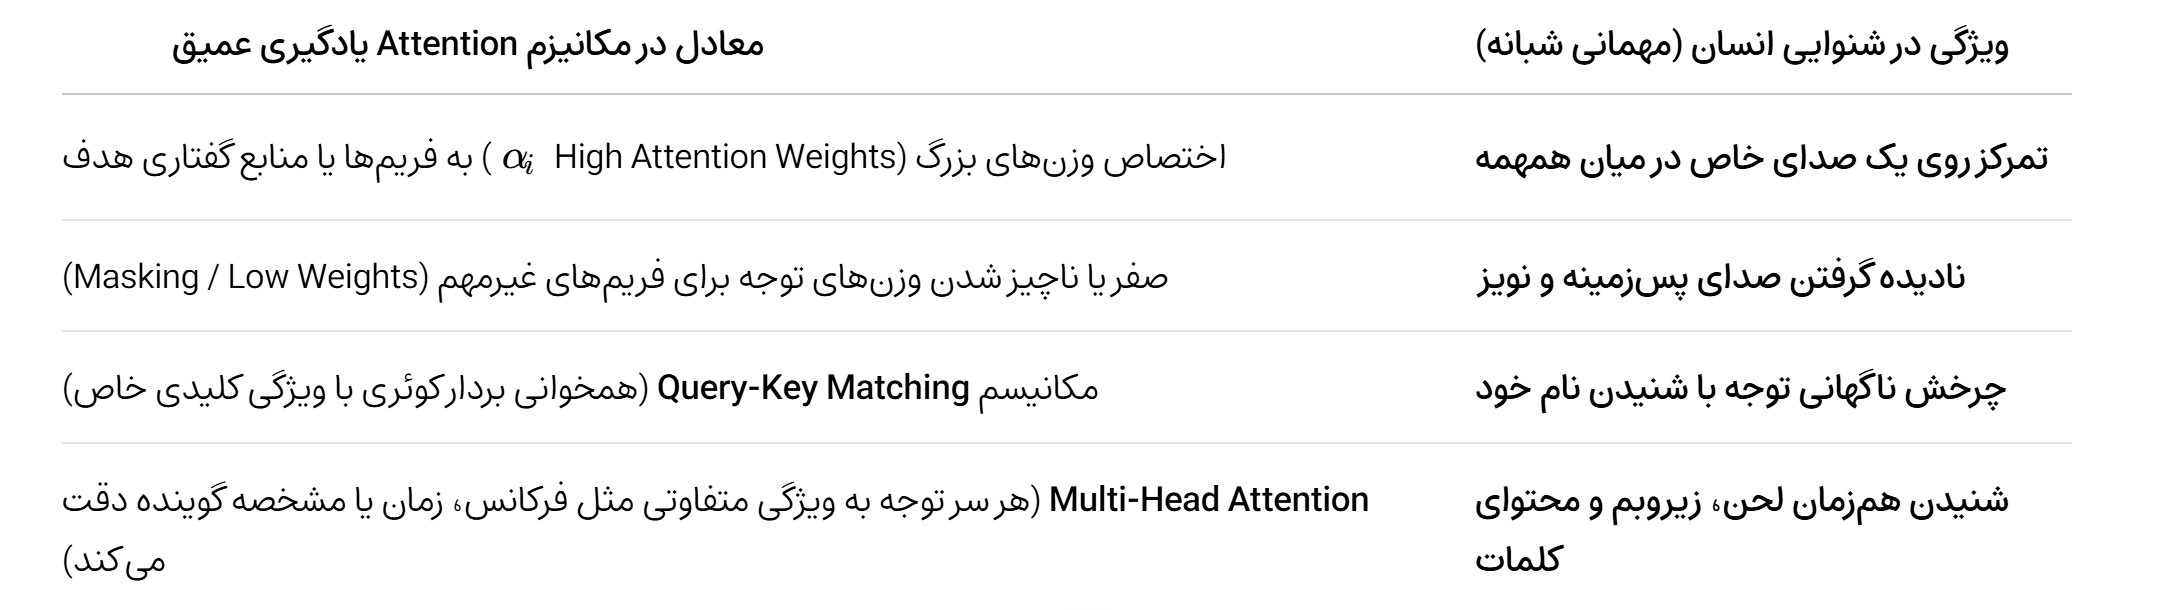
در مدلهای پردازش گفتار مبتنی بر ترانسفورمر و کانولوشن، مکانیزم توجه به سه روش اصلی این اثر را بازسازی میکند:
سیگنال صوتی به اسپکتوگرام یا امبدینگهای فریمبهفریم تبدیل میشود. مکانیزم Self-Attention مشخص میکند که در طول زمان (T) و فرکانس (F):
کدام فریمها مربوط به هجاهای واضح گوینده هدف هستند؟
کدام بخشها مربوط به سکوت، خنده دیگران یا نویز ناپایدار محیطی هستند؟
در مسائلی مانند Target Speaker Extraction (TSE)، یک فایل مرجع چند ثانیهای از صدای گوینده (د-وکتور / d-vector یا x-vector) به عنوان Query به شبکه داده میشود. شبکه با استفاده از Cross-Attention، کل فایل صوتی شلوغ را اسکن کرده و تنها فریمهایی را که شباهت آکوستیک با بردار کوئری دارند استخراج میکند؛ درست مثل مغز شما که با دانستن تن صدای دوستتان، او را در مهمانی پیدا میکند.
در پردازش گفتار، سرهای مختلف توجه روی ابعاد متفاوتی قفل میشوند:
Head 1: فرکانسهای پایه (F0) و مشخصههای بم/زیر بودن صدا (Pitch).
Head 2: فرمانتهای گفتار (محتوای واکهها و همخوانها).
Head 3: ساختار زمانی و ریتم ادای کلمات.
ترکیب این سرها امکان تفکیک دقیق دو گوینده که حتی روی یک فرکانس صحبت میکنند را فراهم میسازد.
اثر مهمانی شبانه در واقع صورت مسئله و هدف غایی در جداسازی و درک گفتار در محیطهای واقعی است و مکانیزم Attention ابزار ریاضی و ساختاری است که یادگیری عمیق به کمک آن این توانایی مغز انسان را بازآفرینی میکند. این هماهنگی امروزه هسته اصلی معماریهای پیشرفته در پردازش سیگنال گفتار نظیر TF-GridNet، SepFormer، Whisper و سیستمهای مدرن حذف نویز فعال (ANC) و سمعکهای هوشمند مبتنی بر هوش مصنوعی را تشکیل میدهد.

