
APIها همیشه برای برقراری ارتباط بین سرویسها و برنامههای نرمافزاری استفاده میشدند و صرفا یک رابط ساده بهحساب میآمدند. اما امروزه، این APIها تبدیل به اجزای اساسی و بنیادین سیستمهای نرمافزاری و حتی کسبوکارها شدند! امروزه نیاز داریم تا بتوانیم روی دستگاههای مختلف، به صورت یکپارچه و همزمان کار کنیم.
قبل از این رویکرد، برای ساخت نرمافزار، ابتدا بکاند ساخته میشد. یعنی ساخت پایگاه داده و نوشتن کدهای اصلی در اولویت بود و بعد از آن، برای اتصال بخشهای دیگر به این کدها API مربوطه ساخته میشد. ما تازه در این نقطه میتوانستیم بفهمیم که آیا نیازهای کاربر با کد نوشته شده و API، تطابق دارد یا نه. و اگر همخوانی نداشت، باید کل کدهای گذشته را از نو مینوشتیم!
برای اینکه این مشکل پیش نیاید، از رویکرد API-first Approach استفاده میشود. در اینجا، اولویت با APIهاست. دیگر رابطها یک محصول نهایی نیستند، بلکه قبل از نوشته شدن هر کدی، طراحی و ساخته میشوند. اینگونه دیگر تیم فرانتاند، نیازی ندارد تا منتظر اتمام کار تیم بکاند شود و میتواند بهطور موازی کار را پیش ببرد و استقلال در تیمها رعایت میشود. همین باعث ایجاد تجربه بهتر برای توسعهدهندگان(Developer Experience) میشود. چون ورودی و خروجیهای API از قبل مشخص شده است و همه چیز حول محور آنها میچرخد. مسئولین پروژه باهم به توافق رسیده و قراردادی برای توصیف APIها تنظیم میکنند. این کار توسعهپذیری را آسانتر و اجرای چرخهها(Iteration) سریعتر میکند و استفادهی مجدد را بالا میبرد.
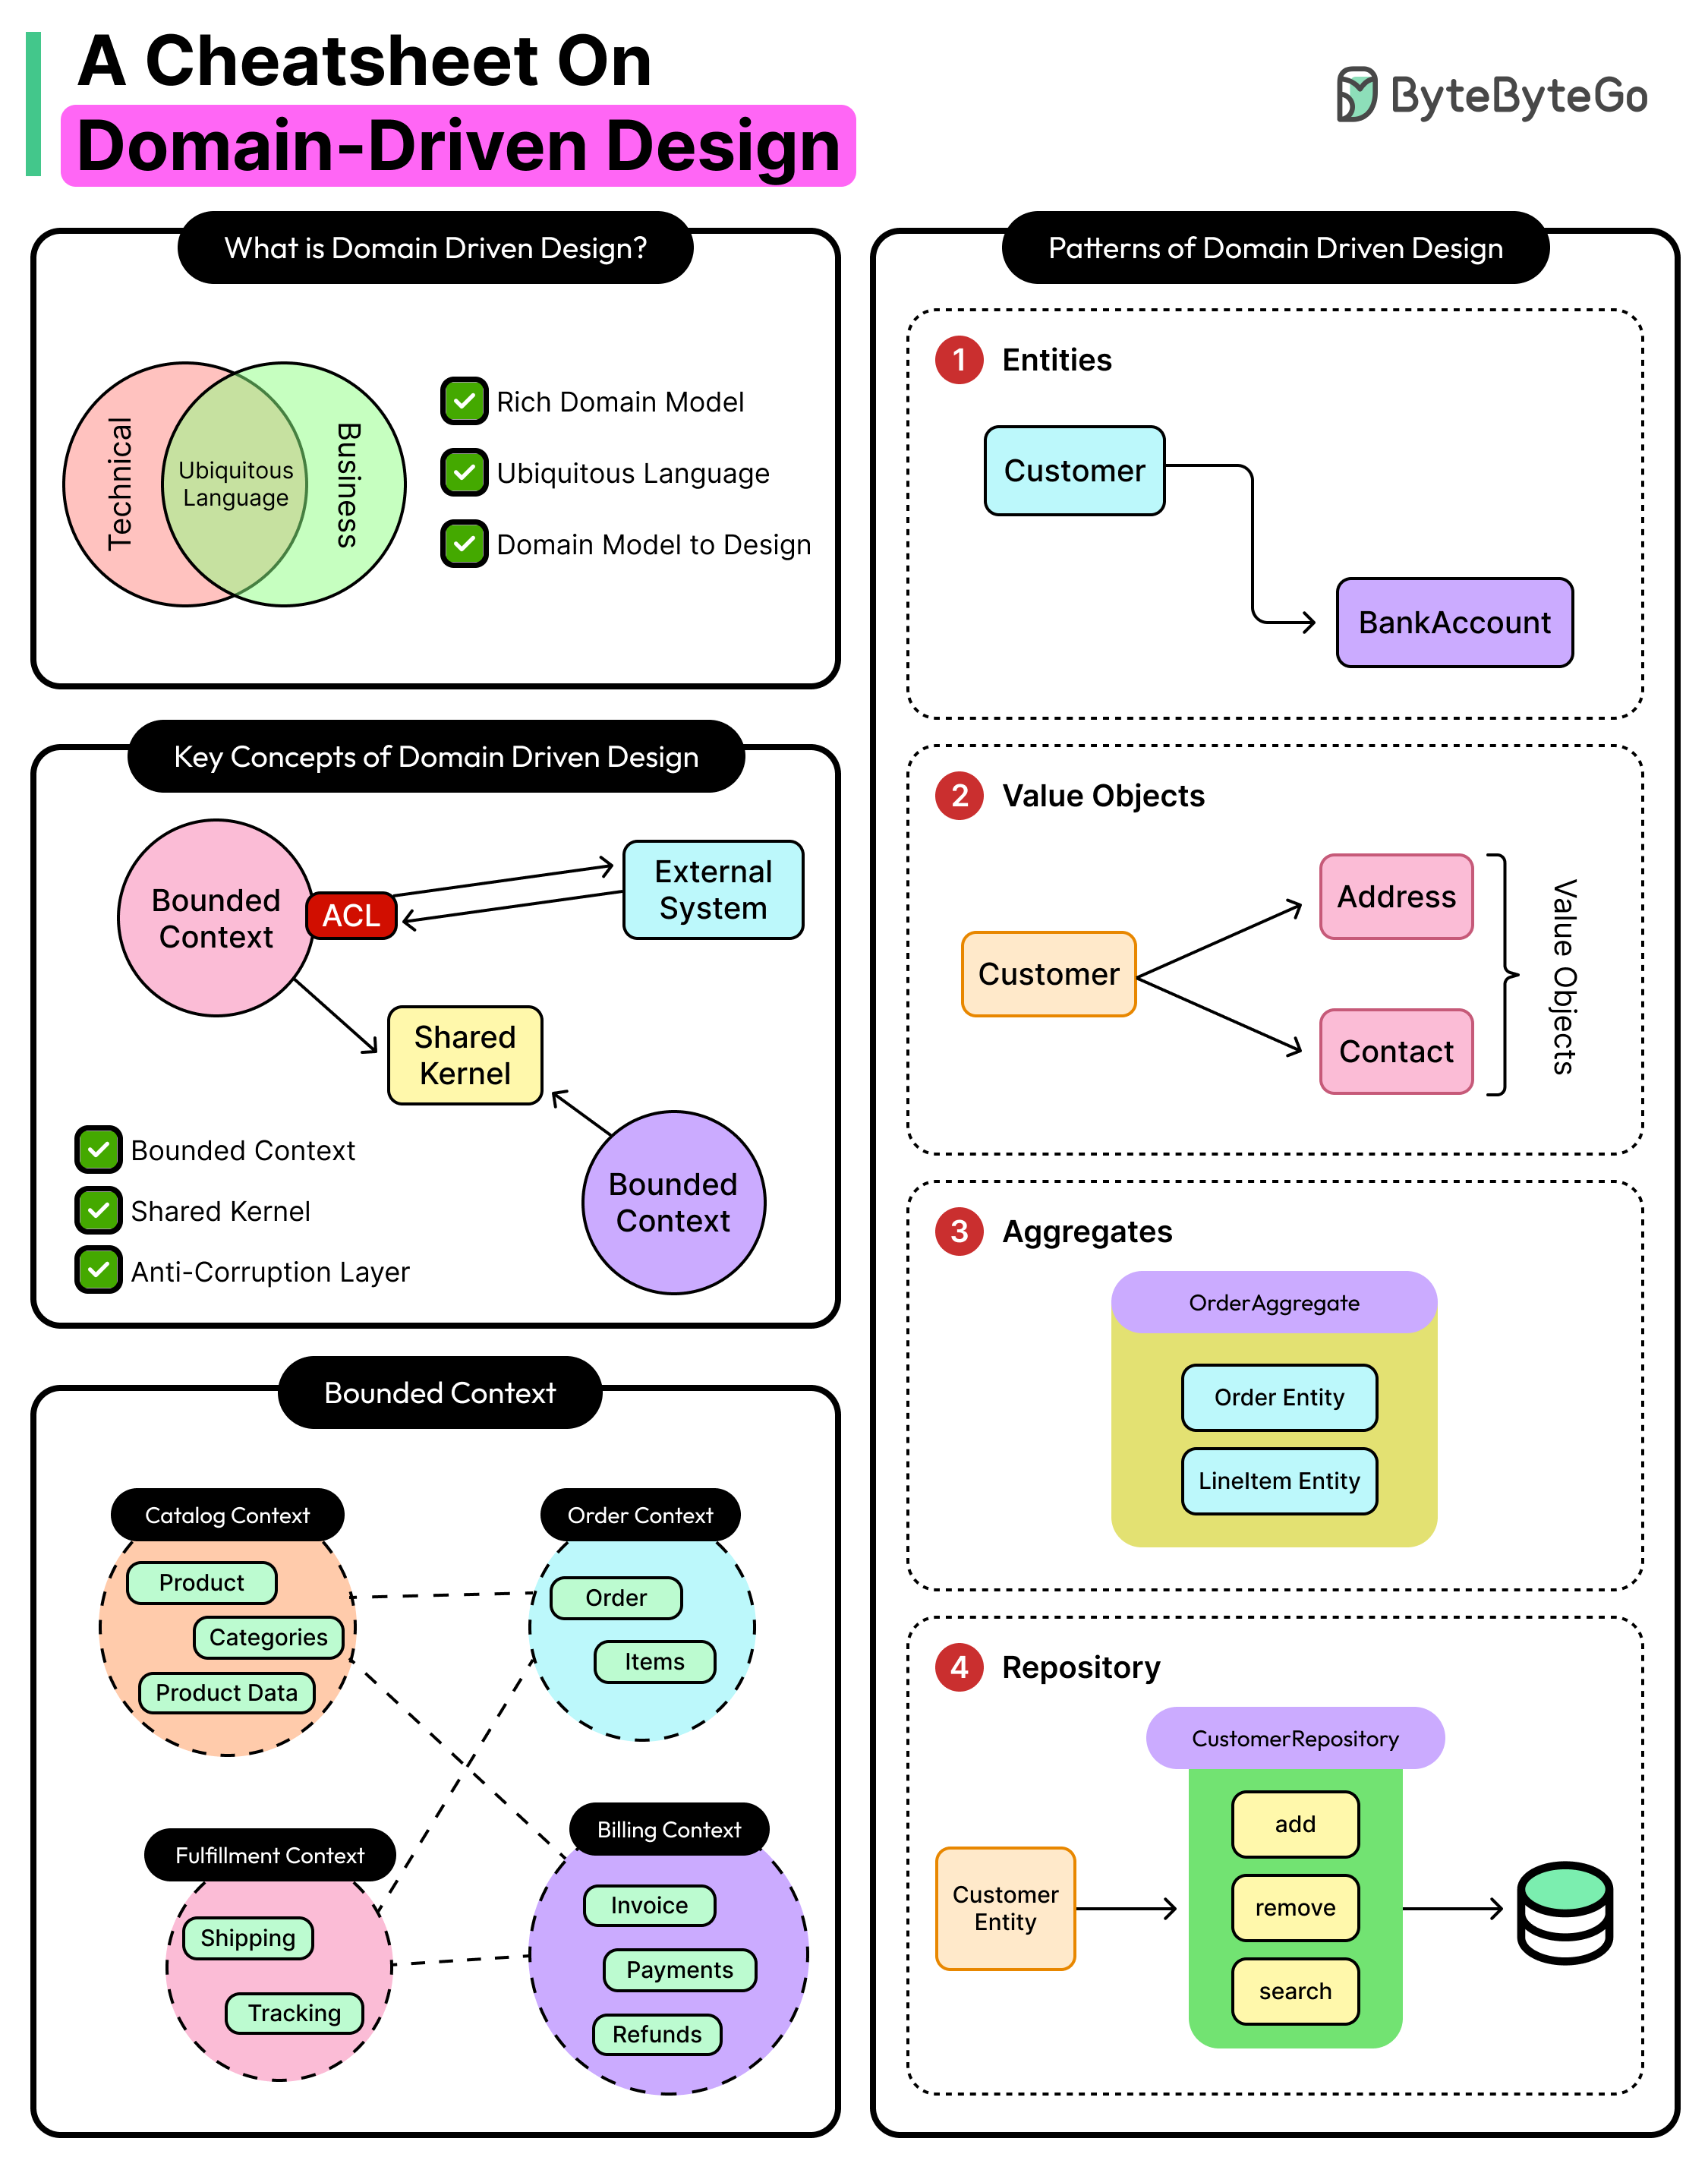
رویکرد DDD، بیشتر درباره فهم عمیق کسبوکار است. در این رویکرد، ما با واقعیتِ پیچیدهی سازمان روبهرو هستیم که به آن Domain(دامنه) میگویند. نباید سعی کرد این سیستم پیچیده را یکجا بفهمیم. پس آن را به تکههای کوچکتر یا Subdomain(زیردامنه) میشکنیم:
Core Subdomain یا هسته مرکزی: آن مزیت رقابتی اصلی که کسبوکار روی آن بنا شده است. بیشترین زمان و توان مهندسی سیستم باید همینجا متمرکز شود.
Supporting / Generic Subdomains یا پشتیبانی: بخشهایی مثل سیستم حسابداری، احراز هویت یا انبارداری که برای بقای سیستم ضروریاند، اما بخش اصلی آن سازمان نیستند.
برای عبور از فضای مسئله به سمت کدنویسی، به دو ابزار نیاز داریم تا مطمئن شویم معماری سیستم با ساختار تیمها و فرآیندها در تضاد نیست:
Bounded Contexts یا محدودههای مرزبندیشده: هر زیردامنه، به یک محدوده نرمافزاری ایزوله تبدیل میشود. مثلا موجودیتِ کالا در سیستم انبارداری، ویژگیها و رفتارهای کاملا متفاوتی با همان کالا در سیستم فروش دارد. ما این دو مفهوم را در یک جدول یا کلاس با هم مخلوط نمیکنیم، بلکه برای هر کدام مرز میکشیم.
Ubiquitous Language یا زبان فراگیر: درون هر کدام از این محدودهها، تیم توسعه و افراد درگیر در سازمان باید یک فهم واحد داشته باشند تا هیچ سوءتفاهمی در ترجمهی نیازمندیها به کد پیش نیاید.
حال اجزای سازندهی مدل دامنه (Domain Model) که با اصول پیشرفتهی تفکیک لایهها و ایزولهسازی درگیر هستند را بررسی کنیم:
موجودیتها یا Entities: اشیائی که ID دارند و وضعیتشان در طول زمان تغییر میکند.
اشیاء مقداری یا Value Objects: مفاهیمی که ID ندارند و فقط با مقادیرشان شناخته میشوند (مثل یک آدرس پستی یا یک واحد پول) و باید کاملاً غیرقابلتغییر(Immutable) باشند.
Aggregates: مرکز کنترلِ ثباتِ سیستم. شامل موجودیتها و اشیاء مقداری، که به عنوان یک واحد منفرد رفتار میکنند و یک موجودیت ریشه(Aggregate Root)، تمام تراکنشها و قوانین حاکم بر آنها را کنترل میکند.
این هستهی ایزولهشده، در نهایت از طریق مخازن(Repositories) با زیرساخت داده درگیر میشود و با انتشار Domain Events با سایر محدودهها ارتباط برقرار میکند تا اتصال بین سرویسها در سستترین حالت ممکن(Loose Coupling) باقی بماند.
حالا ببینیم این آزمایش چطور کار میکند:
۱. تعریف وضعیت پایدار (Steady State): ابتدا مشخص میکنیم که سیستم در حالت عادی چه رفتاری دارد. مثلا در هر ثانیه ۱۰۰ تراکنش موفق ثبت میشود.
۲. طرح فرضیه (Hypothesis): یک پیشبینی انجام میدهیم. مثلاً، فرضیهی ما این است که اگر سرویسِ بررسیِ موجودیِ انبار از کار بیفتد، کل سایت داون نمیشود؛ بلکه فقط دکمه افزودن به سبد خرید غیرفعال میشود.
۳. تزریق خطا (Fault Injection): حالا در محیط عملیاتی با کنترل دقیق شعاع تخریبی که مشتریان متوجه نشوند، به صورت عمدی، سرورِ سرویسِ انبار را خاموش میکنیم یا شبکه آن را کُند میکنیم.
۴. مشاهده و تحلیل (Observation): بررسی میکنیم که آیا سیستم طبق فرضیه ما رفتار کرد؟ یا برعکس، باعث یک «خرابی آبشاری» (Cascading Failure) شد و کل دیتابیس را درگیر کرد؟
۵. بهبود معماری: اگر سیستم شکست خورد، آزمایش متوقف میشود و تیم مهندسی شروع به اصلاح معماری و ایجاد مسیرهای جایگزین (Fallback) میکند.

