
معماری نرمافزار، لایهای است که جهتگیریهای کلان سیستم را تعیین میکند و کیفیت آن، ضامن بقای پروژههای پیچیده است. تصمیمهای معمارانه معمولاً پرهزینه و دشوار برای اصلاحاند و این ویژگی، اهمیت دقت در فرآیند طراحی را دوچندان میکند. با پیچیدهتر شدن سامانههای توزیعشده، نیاز به ابزارهایی که بار شناختی معماران را کاهش دهند، بیش از همیشه حس میشود.
مدلهای زبانی اکنون از وظایف تکراری کدنویسی فراتر رفته و به حوزه تصمیمگیری وارد شدهاند. این تحول، توانمندیهایی مانند سنتز ساختارهای مایکروسرویس، استخراج منطق طراحی و تحلیل ناهنجاریهای ساختاری را بهوجود آوردهاست. اما ظاهر معقول خروجیها همیشه با منطق معماری همسو نیست. هوش مصنوعی اغلب خروجیهایی ارائه میدهد که اگرچه از نظر متنی روان و حرفهای به نظر میرسند، در لایههای زیرین فاقد صحت فنی یا انطباق با قیود نانوشته سازمانی هستند. وابستگی مدلها به دادههای ناقص و محدودیت مشاهدهپذیری نسبت به فشارهای زمانی یا بدهی فنی، آنها را در موقعیتهای واقعی، آسیبپذیر میکند.
معیارهای سنتی ارزیابی، یعنی دقت زبانی یا شباهتهای آماری هم برای سنجش اعتبار معماری کفایت نمیکنند. یک استدلال منسجم متنی، لزوماً به معنای یک معماری پیمانهای، نگهداشتپذیر یا کارآمد نیست. همین شکاف میان متن خوب و معماری خوب، اصلیترین خلأ در تحقیقات فعلی است.
آینده این حوزه در واگذاری تصمیمگیری به ماشین نیست بلکه در الگوی انسان در حلقه معنا میشود. ماشین میتواند گزینهها را بازیابی کند، دادهها را تحلیل کند و پیشنویسهای اولیه را آماده سازد، اما قضاوت نهایی باید با معمار باقی بماند. پژوهش حاضر به بررسی همین تعامل میپردازد. هدف، تحلیل نقش هوش مصنوعی در حوزههایی همچون مستندسازی، سنتز و ارزیابی کیفی است تا مشخص شود چگونه میتوان این فناوری را در قالب یک دستیار کنترلشده و مسئولانه به کار گرفت. این نگاه، راه را برای گذار از جایگزینی معمار به سمت تصمیمسازی تقویتشده باز میکند.
معماری نرمافزار صرفاً ترسیم نمودار نیست بلکه ترکیبی از تصمیمهای ساختاری برای سازماندهی و تکامل سیستم است [1]. ورود هوش مصنوعی این اکوسیستم را دگرگون کرده. مدلهای یادگیری ماشین صرفاً یک مؤلفه نیستند و باید به عنوان لایههای دادهمحور، خط لوله استنتاج و فرآیندهای بازآموزی در کل پیکره سیستم تحلیل شوند.
قوانین بنیادین معماری در مواجهه با هوش مصنوعی همچنان پابرجاست اما پیچیدگی بیشتری دارد. هر تصمیم معماری نوعی مصالحه است. مثلاً انتخاب مدل بزرگتر اگرچه دقت را بالا میبرد اما هزینه اجرا و تاخیر را افزایش میدهد. هوش مصنوعی میتواند با تحلیل الگوها این مصالحهها را شبیهسازی کند اما انتخاب نهایی نیازمند شناخت زمینههای سازمانی است که از عهده مدل برنمیآید. ثبت تصمیمها یا همان ADRها در این فرایند اهمیت حیاتی دارد تا فرضیات انتخاب یک مدل یا سبک معماری در طول زمان قابل ردیابی باشد.
برای پیادهسازی معماری مدرن، باید هوش مصنوعی به جای تصمیمگیرنده در جایگاه دستیار قرار داد. مدلها در شناسایی ریسکها، تحلیل وابستگیهای پنهان در نمودارها و پیشنهاد الگوهای ارتباطی بسیار قدرتمندند اما مسئولیت حقوقی و فنی پذیرش این پیشنهادات بر عهده معمار انسانی باقی میماند.
یک چارچوب معماری تقویتشده با هوش مصنوعی در سه لایه عملیاتی میشود. لایه نخست جمعآوری دانش و نیازمندیها، لایه دوم استنتاج و تولید سناریو توسط مدل، و لایه سوم اعتبارسنجی خروجی با استفاده از قواعد سختگیرانه و نظارت انسانی است. این ترکیب، وابستگی به مدل را به یک ابزار قابل کنترل تبدیل میکند و اجازه میدهد با اعمال لایههای مراقبتی بر خروجیها، ریسک خطاهای سیستماتیک به حداقل برسد. در این صورت معماری هوشمندانه بر اساس پاسخهای خودکار مدل بنا نمیشود بلکه به تعامل دقیق میان دانش دامنه انسانی و استنتاج ماشینی تکیه میکند.
هوش مصنوعی در ساختارهای مدرن جزیی تفکیکناپذیر از اکوسیستم نرمافزار بازتعریف میشود. کتاب مهندسی سیستمهای هوشمند با تمرکز بر مبانی معماری و عملیات، این پدیده را یک سیستم ماشینمحور توصیف میکند که از ترکیب مؤلفههای هوشمند و غیرهوشمند برای اثرگذاری بر محیط شکل گرفته است [2]. این تغییر نگرش، کانون توجه معمار را از صرف کدنویسی به سمت رویکردی کلنگر متمایل میسازد که کیفیت را برآیند تعامل میان چرخهعمر، ساختار نرمافزار و ویژگیهای مدل میداند. در این شرایط معماری سیستم بستری برای تحقق الزامات غیرعملکردی است. برخلاف نگاه سنتی که کیفیت را در دقت مدل خلاصه میکرد، امروزه طراحی تاکتیکهای معماری برای مدیریت ورودیها و استقرار پایدار سرویسها اهمیتی دو چندان دارد. مدیریت ماهیت احتمالی مدلهای هوشمند نیازمند ساختاری است که ریسک خروجیهای نادرست را با الگوهایی همچون تصمیمگیری چندمدلی یا نظارت انسانی تعدیل کند.
همگرایی MLOps و DevOps در این نقطه معنا مییابد. پیوند میان مدیریت چرخه عمر مدل و استقرار یکپارچه نرمافزار، زیرساخت را به کدی تبدیل میکند که تکرارپذیری محیطها را تضمین خواهد کرد. سازگاری نسخههای کتابخانه و مدل در محیطهای مختلف مانع از بروز خطاهای محیطی شایع در سیستمهای هوشمند میشود. مشاهدهپذیری نیز از ثبت ساده وقایع فراتر رفته و به ردیابی خط سیر داده و مؤلفهها میپردازد. اتصال MLOps به DevOps تنها ثبات محیطی میآورد و برای کنترل رفتار احتمالی مدلها کافی نیست. سیستم هوشمند نیاز دارد که در هر لحظه، وضعیت خود را به معماران گزارش دهد. اینجاست که مشاهدهپذیری از یک ابزار مانیتورینگ ساده به یک اصل بنیادی معماری ارتقا مییابد تا خط سیر داده و ردپای اجزا به طور پیوسته ثبت شوند.
تحقق مسئولیتپذیری در چنین ساختاری نیازمند بهکارگیری لاگگیری ساختاریافته با فرمتهایی نظیر JSON است تا تحلیل ماشینمحور وقایع میسر شود. در این رویکرد، متخصصان عملیات به عنوان ذینفعان کلیدی از همان ابتدای طراحی حضور دارند. ثبت دقیق زمینه استنتاج شامل شناسه کاربر و زمان دقیق وقوع، به تیمهای فنی اجازه میدهد هنگام بروز خطا، علت ریشهای را در دادههای ورودی یا نسخههای خاص مدل جستجو کنند. کیفیت در چنین سیستمی محصول طرحریزی معماری و فرآیندهای عملیاتی است که از نخستین مراحل ساخته میشود.
معماری نرمافزار، یک نقشه ایستا نیست بلکه پدیدهای پویاست [3]. ورود هوش مصنوعی به این اکوسیستم، سطح جدیدی از عدمقطعیت و وابستگیهای پنهان ایجاد کرده است. معماران دیگر صرفاً با فراخوانی سرویسها روبرو نیستند. آنها باید وابستگی به زیرساخت آموزش، نسخههای مدل و خط لوله داده را مدیریت کنند. تحلیل دقیق جفتشدگی در اینجا حیاتی است تا تشخیص دهیم یک قابلیت هوشمند باید درون سرویسهای فعلی ادغام شود یا به عنوان یک زیرسامانه مستقل طراحی گردد.
توابع تناسب نقش نگهبانان کیفیت را در این معماری بر عهده دارند. این توابع، معماری را از یک سند توصیفی به سازوکاری فعال تبدیل میکنند که مواردی مثل پایداری مدل، مصرف منابع و تأخیر سرویسها را خودکار میسنجد. بدون چنین نظارتی، رفتار پیشبینیناپذیر مدلها به فرسایش تدریجی سیستم منجر میشود. مکمل این نظارت، سوابق تصمیمات معماری است. ثبت این سوابق، تریدآفهای دشوار میان دقت مدل و هزینههای عملیاتی را شفاف میکند و مانع از آن میشود که تیمهای آینده مجبور به حدس و گمان درباره چرایی تصمیمات حال حاضر باشند. بسیاری از شکستهای هوش مصنوعی ناشی از معماری ناصحیح داده است تا ضعف الگوریتمها و راهکارهایی مثل Data Mesh با توزیع مسئولیتها میان دامنههای کسبوکار، بستری برای توسعه پایدار فراهم میکنند. جریانهای کاری توزیعشده نیز باید به عنوان هسته اصلی معماری، مدلسازی شوند. وقتی مراحل پیشپردازش، استنتاج و بازخوردگیری به صورت پراکنده و بدون طراحی دقیق توسعه یابند، عیبیابی سیستم ناممکن میشود. معمار موفق کسی است که اثر ورود هوش مصنوعی را در تغییرات نگهداشتپذیری و دسترسپذیری سیستم بهطور همزمان تحلیل کند.
معماری سیستمها بیش از آنکه حاصل طراحی روی کاغذ باشد، تابعی از ساختار ارتباطی سازمان است. مفهوم نیروی همومورفیک در کتاب Team Topologies [4] دقیقاً به همین اشاره دارد که ساختار ارتباطی تیمها، شکلدهندهی نهایی معماری است. اگر معماری مطلوب با ساختار سازمانی در تضاد باشد، سازمان لزوماً این معماری را به سمت الگوهای ارتباطی واقعی و پیشفرض خود میکشد.
ورود قابلیتهای هوش مصنوعی به سیستمها، این اصل را به یک چالش حیاتی تبدیل کرده است. پیچیدگی مدیریت مدل، خطلولههای داده و زیرساختهای عملیاتی، ساختارهای سنتی و سیلوهای مجزای امنیت و داده را به گلوگاه تبدیل میکند. مانور کانوی معکوس راهکار کلیدی در این بستر است. سازمان باید پیش از استقرار نهایی نرمافزار، مسیرهای ارتباطی خود را بازتعریف کند تا بستر پدیدار شدن معماری هوشمند فراهم شود.
مدیریت بار شناختی در این ساختار از طریق چهار توپولوژی تیمی تعریف میشود. تیمهای همراستا با جریان ارزش مسئولیت مستقیم محصول را دارند و مدلهای هوشمند را در خدمت تجربه مشتری به کار میگیرند. برای جلوگیری از غرق شدن این تیمها در پیچیدگیهای فنی، تیمهای پلتفرم وارد عمل میشوند و با ارائه سرویسهای ساده سازی شده در حوزهی MLOps و زیرساخت داده، بار شناختی را کاهش میدهند. شکافهای دانشی نیز توسط تیمهای توانمندساز پر میشود یعنی متخصصانی که پس از انتقال مهارتهای اعتبارسنجی یا فریمورکهای جدید، از جریان کاری خارج میشوند. در لایههایی از سیستم که نیازمند تخصص عمیق ریاضی است، تیمهای زیرسیستم پیچیده مسئولیت را میپذیرند تا تمرکز تیمهای ارزش حفظ شود.
بار شناختی در سازمانهای هوش مصنوعیمحور نباید وضعیتی ایستا فرض شود. هنر مدیریت در این سازمانها، جایگزینی پیچیدگیهای بیپایان با ابزارهای پلتفرمی است. با بازطراحی سازمان بر پایه این توپولوژیها و تمرکز بر جریان سریع کار، معماری سیستم از تلهی ساختارهای سنتی رها شده و در بستری پویا و سازگار با نیازهای نوآورانه تکامل مییابد.
مطالعات مروری اخیر نشان میدهند که کاربرد هوش مصنوعی مولد در معماری نرمافزار، هرچند هنوز در مرحله بلوغ اولیه قرار دارد، اما بهسرعت در حال تبدیلشدن به یکی از محورهای مهم تحول در چرخه حیات معماری است [5]. بر اساس این مرور، عمده کاربردهای AI در این حوزه را میتوان در چند دسته کلی صورتبندی کرد: پشتیبانی از تصمیمگیری معماری، تولید و سنتز مصنوعات معماری از نیازمندیها یا دانش موجود، بازسازی و تجزیه معماری از کد و سامانههای موجود، ارزیابی کیفیت و شناسایی ناهنجاریها یا ضدالگوهای معماری، و نیز پشتیبانی از گذار میان سطوح مختلف چرخه حیات معماری؛ بهویژه از نیازمندی به معماری و از معماری به پیادهسازی. این مرور همچنین نشان میدهد که استفاده از مدلهای زبانی بزرگ عمدتاً در مراحل آغازین چرخه معماری، با اتکا به راهبردهایی مانند few-shot prompting و RAG، و غالباً با حضور فعال انسان در حلقه تصمیمگیری انجام میشود. با این حال، مسائلی مانند دقت خروجی، توهم مدل، فقدان چارچوبهای ارزیابی معتبر، حریم خصوصی و کمبود دادههای تخصصی معماری، همچنان موانع مهم گسترش عملی این رویکردها بهشمار میآیند. بر این اساس، زیربخشهای بعدی این فصل، نمونههایی از این طبقهبندی کلی را با تمرکز بر مطالعات شاخص و کاربردهای مشخص AI در معماری نرمافزار بررسی میکنند.
مستندسازی تصمیمات معماری یا همان ADR یکی از نقاط ضعف رایج در تیمهای نرمافزاری است، زیرا فشار زمانی اغلب مانع از ثبت دقیق منطق و گزینههای طراحی میشود. پژوهشی که به بررسی استراتژیهای زمینهدهی برای تولید خودکار ADR با مدلهای زبانی میپردازد، نشان میدهد که این مدلها پتانسیل بالایی برای کاهش بار مستندسازی دارند [6]. نکته کلیدی در این مطالعه، تعیین میزان و نوع اطلاعات پیشینهای است که مدل برای تولید خروجی دقیق نیاز دارد. محققان با بررسی مجموعهدادهای بزرگ دریافتند که تکیه صرف بر عنوان تصمیم، منجر به تولید متنی طولانی و کمارتباط میشود. و برخلاف انتظار، دادن کل تاریخچه تصمیمها یا همان راهبرد All_N همواره بهترین نتیجه را نمیدهد. راهبردهای مبتنی بر تصمیمهای اخیر یا Last_K عملکردی همتراز با استفاده از کل تاریخچه دارند و علاوه بر کاهش هزینه پردازش، انسجام خروجی را حفظ میکنند. یافتهها نشان میدهد استفاده از ۳ تا ۵ تصمیم اخیر، موازنهای بهینه میان کیفیت و مصرف توکن ایجاد میکند. با این حال، باید توجه داشت که معیارهای خودکار مانند BLEU و ROUGE برای ارزیابی کفایت معماری کافی نیستند و خروجی مدل بدون نظارت انسانی میتواند فریبنده باشد.
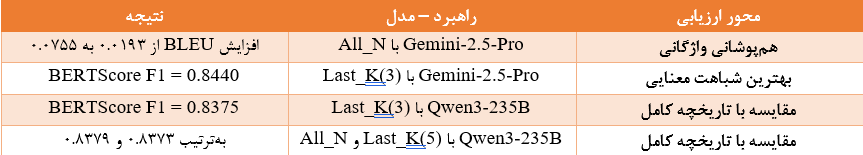
جدول بالا نشان میدهد که استفاده از چند تصمیم اخیر، از نظر شباهت معنایی تقریباً هم سطح با کل تاریخچه عمل میکند. پس افزودن همه پیشینه تصمیمها لزوماً به بهبود معنادار کیفیت منجر نمیشود. راهبرد Last_K(3) نیز در مدل Gemini بهترین تطابق معنایی را ثبت کرده است و این نشان میدهد انتخاب پنجره زمینه باید بر مبنای کیفیت مؤثر، و نه بر مبنای حجم اطلاعات، انجام شود.
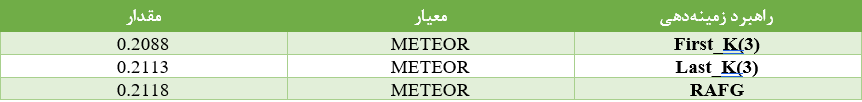
در جدول بالا مقایسه این راهبردها بیانگر برتری نسبی بازیابی آگاه از زمینه یعنی RAFG است، هرچند فاصله آن با تصمیمهای اخیر محدود باقی میماند. این نزدیکی عملکرد، مزیت کاربردی Last_K را برجسته میکند زیرا بدون پیچیدگی اضافی، خروجی قابلقبولی فراهم میسازد بهویژه در جریانهای کاری تیمی، دسترسی به تاریخچه نزدیک معمولاً برای تدوین ADR کفایت بیشتری دارد.
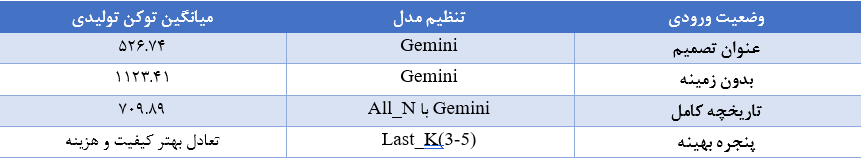
نتایج جدول بالا نشان میدهد نبود زمینه، مدل را به تولید متن طولانیتر و کم تمرکزتر سوق میدهد. در مقابل، زمینهدهی محدود با تصمیمهای اخیر، هم انسجام معماری را حفظ میکند و هم هزینه توکن را کنترل مینماید. پنجره Last_K(3-5) در مجموع بهترین موازنه میان دقت، مقیاسپذیری و هزینه پردازش را دارد. با این حال، معیارهای خودکار بهتنهایی کفایت ADR را تضمین نمیکنند و بازبینی انسانی همچنان ضروری است.
فراتر از ثبت تصمیم، مسئله چرایی انتخابها یا همان Design Rationale نیز اهمیت ویژهای در چرخه حیات نرمافزار دارد. پژوهش دیگری با بررسی دقیق توانمندی مدلها در تولید این منطق طراحی، از رویکردهای مبتنی بر Chain-of-Thought و عاملهای هوشمند استفاده کرده است [7]. ارزیابیهای صورتگرفته نشان میدهد که مدلها در بازیابی استدلالهای مرتبط موفقتر از تولید دقیق و بینقص آنها هستند. با وجود ثبت مقادیر قابلتوجهی از استدلالهای مفید، بخشی از خروجیها همچنان با خطاهایی همراه است که نیاز به نظارت انسانی را پررنگ میکند. این یافتهها تأکید دارد که مدلهای زبانی جایگزین معمار نیستند، بلکه به عنوان دستیاری برای پیشنویس اولیه و غنیسازی مستندات کارآمد هستند.
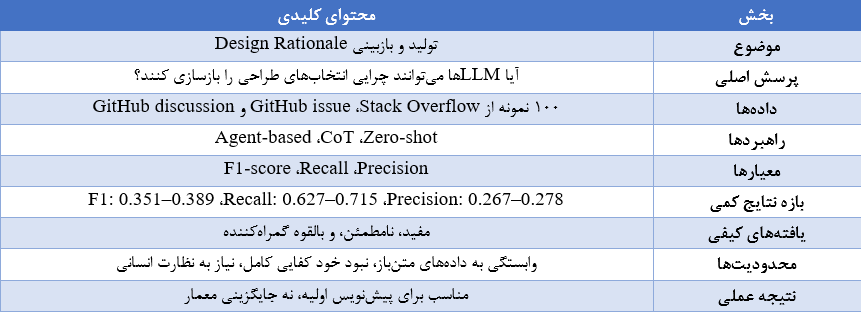
جدول بالا نشان میدهد که مدلها در بازسازی منطق طراحی، بیشتر در بازیابی استدلالهای مرتبط موفقاند تا در تولید خروجی بینقص. به بیان دیگر، مدل توان کمک دارد، اما هنوز از خطای انسانی بینیاز نیست. همین فاصله میان بازیابی و دقت کامل، دلیل اصلی نیاز به human-in-the-loop است.
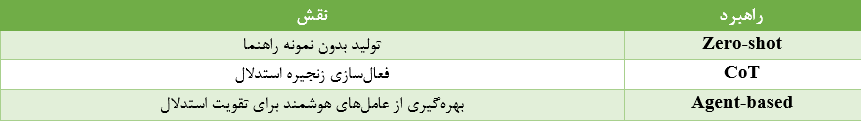
در جدول بالا این سه راهبرد نشان میدهند که افزودن ساختار به استدلال، کیفیت پاسخ را بالا میبرد. CoT و رویکرد عاملمحور معمولاً برای منطقهای چند مرحلهای مناسبترند. با این حال، حتی این روشها هم به تنهایی خطاپذیری را حذف نمیکنند. پس مسئله فقط فکر کردن مدل نیست، بلکه فکر درست است.
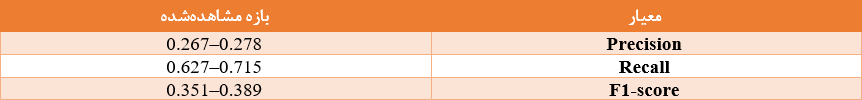
بازهها نشان میدهند که مدل در بازیابی موارد مرتبط بهتر از تولید دقیق عمل کرده است و پوشش نسبی مناسبتر از دقت نهایی بوده است. از منظر ارزیابی، این الگو معمولاً نشانه خروجیهای مفید اما ناپایدار است.
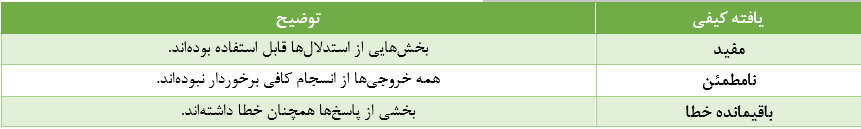
ارزیابی کیفی نشان میدهد که ارزش خروجیها واقعی است، اما یکدست نیست. این ناهمگنی دقیقاً همان نقطهای است که نظارت انسانی را ضروری میکند پس مدل، تولیدکننده نهایی تصمیم نیست و بیشتر نقش یک دستیار تسهیلگر را دارد و باید تحت نظارت باشد.
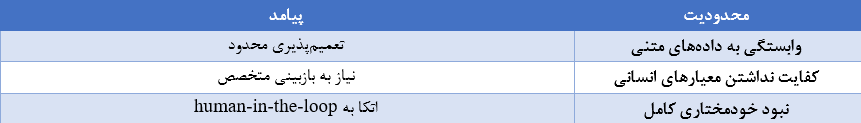
این محدودیتها نشان میدهند که مدلها هنوز جایگزین تخصص معماری نشدهاند و نقش آنها بیشتر در غنیسازی مستندات و تولید پیشنویس اولیه تعریف میشود. از این رو، استفاده درست از آنها باید همراه با داوری انسانی باشد.
نگاهی تطبیقی به این دو مطالعه نشان میدهد که خودکارسازی مستندسازی معماری نیازمند رویکردی چند لایه است. پژوهش نخست بر کیفیت ورودی و مهندسی زمینه تأکید دارد، در حالی که پژوهش دوم بر صحت و قابلیت اعتماد خروجی متمرکز است [6, 7]. یک راهکار عملی باید ترکیبی از این دو باشد. استفاده از راهبردهای بازیابی هوشمند برای تأمین زمینه موردنیاز و بهرهگیری از سازوکارهای انسان-در-حلقه برای ارزیابی منطق استدلالی، کلید موفقیت است. اگر ورودی غنی باشد و خروجی با نظارت معمار پالایش شود، مستندات معماری از یک وظیفه جانبی و خستهکننده به دارایی زندهای برای حفظ دانش پروژه تبدیل میشوند. خودکارسازی بدون نظارت در این حوزه ریسک بالایی دارد و تنها راهبرد مطمئن، استفاده از LLMها به عنوان تقویتکننده حافظه و قلم معمار است، و نباید تصمیمگیرنده نهایی باشند.
مطالعهای پیرامون سنتز معماری مایکروسرویس از نیازمندیهای متنی به این چالش پرداخته است که چگونه پیش از نگارش کد، معماری سیستم را طراحی کنیم [8]. بسیاری از روشهای فعلی به تحلیل کد وابستهاند، اما پژوهشگران با بهکارگیری مدل OpenAI o3 روی دو سیستم Bookstore و PetClinic نشان دادند که مدلهای زبانی توانایی استخراج سرویسها و روابط آنها را مستقیماً از توصیفهای متنی دارند.
تفاوت عملکرد میان راهبردهای زیرو-شات و چند-شات در این آزمایش چشمگیر بود. در حالت زیرو-شات، مدل با اعتمادبهنفس کاذب ارتباطات غیرضروری زیادی میان سرویسها ایجاد کرد که دقت خروجی را کاهش داد. ارائه تنها یک نمونه ساختاری در حالت چند-شات، همگرایی با معماری مرجع را به طرز قابل توجهی افزایش داد بهطوری که امتیاز F1 برای شناسایی سرویسها از 0.79 به 0.97 رسید. ولی این خروجیها همچنان به نظارت دقیق نیاز دارند. محدودیتهایی مانند تمرکز بر یک مدل خاص، حجم محدود دادههای آزمایشگاهی و تکیه بر معماریهای مرجع به عنوان یک مبنای پیادهسازی شده که لزوماً بهینه نیست، باعث میشود نتایج نیازمند بازبینی متخصص باشند. این مدلها به جای جایگزینی معمار، نقش ابزاری کمک کننده برای تدوین پیشنویس اولیه را ایفا میکنند که فضای تصمیمگیری را برای تحلیل انسانی محدودتر و دقیقتر میسازد.
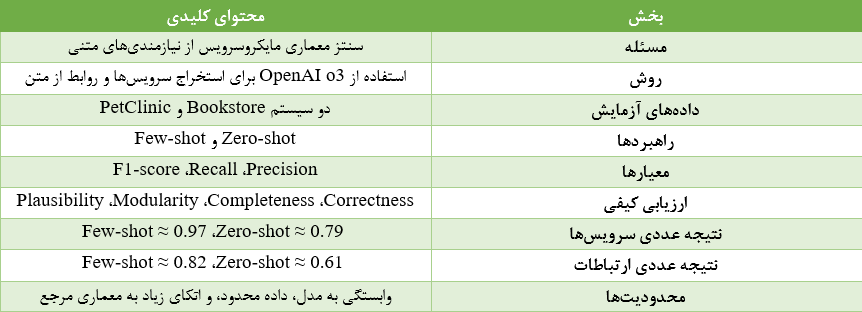
جدول بالا نشان میدهد که مدل زبانی میتواند از متن خام، پیشنویس معماری استخراج کند اما کیفیت خروجی در حالت چند-شات به مراتب بهتر از حالت زیرو-شات بوده است. اعداد F1 هم همین تفاوت را تأیید میکنند و برتری Few-shot را روشنتر میسازند. در عین حال، خروجی هنوز نیازمند داوری انسانی است.
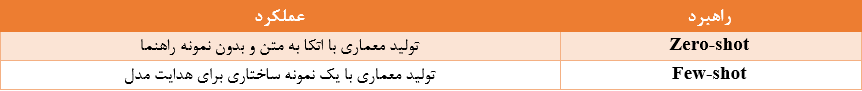
در Zero-shot، مدل آزادی بیشتری دارد اما همین آزادی گاهی به اتصالهای غیرضروری منجر میشود. در Few-shot، یک نمونه مرجع مسیر استدلال را منظمتر کرده و خروجی را به معماری مطلوب نزدیکتر میکند. این تفاوت نشان میدهد که حتی یک نمونه خوب میتواند نقش جهت دهنده مهمی داشته باشد.
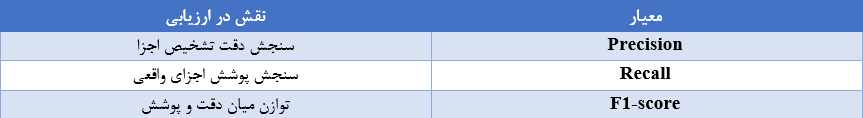
این معیارها نشان میدهند که فقط درستگفتن کافی نیست، باید همه اجزای مهم هم دیده شوند. F1-score برای این نوع مسئله شاخص مناسبتری است چون بین دقت و پوشش تعادل برقرار میکند. رشد چشمگیر F1 در Few-shot نشاندهنده بهبود هم زمان کیفیت و جامعیت خروجی است.
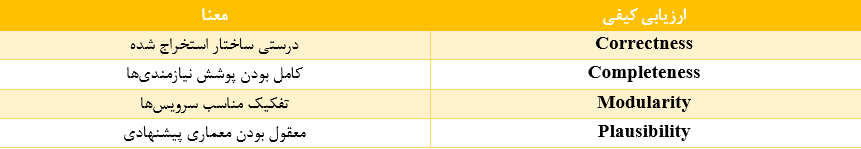
این چهار شاخص کمک میکنند کیفیت معماری فقط با عدد دیده نشود، بلکه از منظر طراحی هم سنجیده شود. Modularity و Plausibility در چنین پژوهشهایی اهمیت ویژه دارند چون مستقیماً به قابلیت پیادهسازی مربوط هستند. میتوان ادعا کرد که خروجی مدل مفید است اما هنوز یک پیشنویس هوشمندانه محسوب میشود و همچنان به نظارت انسانی نیاز دارد.
مطالعهی [9] مسئلهی تجزیهی سامانههای مونولیتیک به مایکروسرویس را از زاویهی بازنمایی معنایی کد بررسی میکند. دشواری اصلی در این نوع مهاجرت، تشخیص مرزهای درست سرویسهاست یعنی مرزهایی که صرفاً با وابستگیهای ساختاری یا شباهتهای نحوی قابل شناسایی نیستند. بسیاری از روشهای رایج، مانند تحلیل ایستای گراف کلاسها، در فهم منطق تجاری کد محدودیت دارند و همین مسئله میتواند به تفکیک نادرست سرویسها منجر شود. پژوهشگران در این مطالعه برای پاسخ به این ضعف، رویکرد MonoEmbed را معرفی کردهاند. این روش از مدلهای زبانی بزرگ و یادگیری کنتراستیو برای ساخت بردارهای بازنمایی استفاده میکند. ایدهی اصلی آن است که کلاسهای متعلق به یک مایکروسرویس در فضای برداری به یکدیگر نزدیکتر شوند و کلاسهایی که به سرویسهای متفاوت تعلق دارند از هم فاصله بگیرند. تابع زیان Triplet Loss در این فرایند نقش محوری دارد، زیرا مدل را وادار میکند تفاوت میان شباهت سطحی کد و نزدیکی واقعی از منظر منطق کسبوکار را بهتر تشخیص دهد.
یکی از بخشهای مهم این روش، استفاده از نمونههای منفی دشوار است. این نمونهها ممکن است از نظر ساختاری به کلاس مبنا شبیه باشند، اما از نظر کارکرد تجاری به حوزهی دیگری تعلق داشته باشند. چنین طراحیای باعث میشود مدل کمتر به ظاهر کد وابسته بماند و بیشتر به معنای عملیاتی آن توجه کند. برای کاهش هزینهی آموزش نیز از LoRA استفاده شده است تا fine-tuning مدلهای بزرگ بدون نیاز به منابع محاسباتی سنگینتر انجام شود.
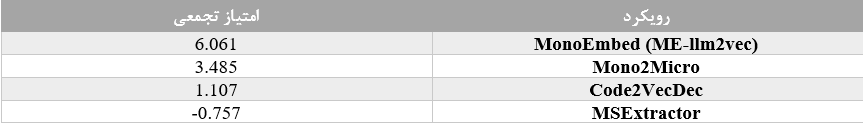
جدول بالا رویکرد مبتنی بر بازنمایی معنایی عمیق، یعنی MonoEmbed، در تشخیص مرزهای سرویسها بیشترین کارایی را داشته است. در مقابل، روشهای قدیمیتر یا متکی بر نشانههای سطحی، توان کمتری در فهم منطق تجاری و جداسازی درست مولفهها نشان دادهاند. برتری این نتایج تأیید میکند که در مهاجرت از مونولیت به مایکروسرویس، شباهت ظاهری کد به تنهایی کافی نیست و باید معنا و کارکرد واقعی نیز مدل شود.
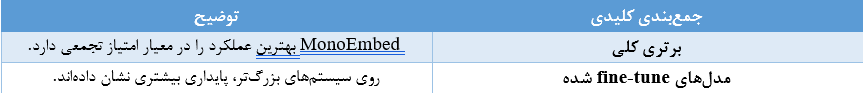
جدول بالا نشان میدهد MonoEmbed در امتیاز تجمعی، بهترین عملکرد را ثبت کرده و از نظر دقت کلی برتر بوده است. همچنین مدلهای fine-tune شده در سیستمهای بزرگتر، پایداری بیشتری نشان دادهاند و از این رو برای مقیاسهای پیچیدهتر مناسبترند. ترکیب بازنمایی معنایی با تنظیم دقیق مدل، میتواند کیفیت تفکیک و تحلیل ساختار را بهطور محسوسی بهبود دهد.
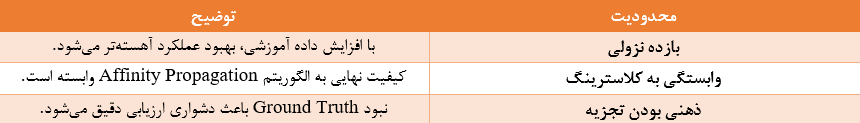
جدول بالا شنان میدهد که با وجود کارایی مناسب، بهبود عملکرد در دادههای بیشتر با بازده نزولی همراه میشود. همچنین کیفیت نهایی تا حدی به الگوریتم Affinity Propagation وابسته است و این وابستگی میتواند نتایج را حساس کند. از سوی دیگر، نبود Ground Truth ارزیابی دقیق را دشوار میسازد و بخشهایی از تجزیه را ناگزیر ذهنیتر میکند.
مطالعات [8] و [9] دو کاربرد مکمل هوش مصنوعی در معماری مایکروسرویس را نشان میدهند. مطالعهی [8] به سنتز معماری از نیازمندیهای متنی میپردازد؛ یعنی مدلی مانند OpenAI o3 پیش از وجود کد، سرویسها و روابط میان آنها را پیشنهاد میکند. در مقابل، مطالعهی [9] با استفاده از MonoEmbed، مرزهای سرویس را از کد یک سیستم مونولیتیک استخراج میکند و برای این کار از یادگیری کنتراستیو، Triplet Loss و نمونههای منفی دشوار بهره میگیرد. در [8]، استفاده از Few-shot مقدار F1 شناسایی سرویسها را از 0.79 به 0.97 افزایش داد. در [9] نیز MonoEmbed با امتیاز تجمعی 6.061، عملکرد بهتری از Mono2Micro با امتیاز 3.485 داشت. این نتایج نشان میدهند که کیفیت خروجی به زمینهی ارائه شده و نحوهی تنظیم مدل وابسته است.
هیچیک از دو رویکرد، معماری نهایی و قطعی تولید نمیکند. محدودیت دادهها، وابستگی به کیفیت پرامپت یا کلاسترینگ و نبود یک پاسخ یگانه برای تجزیهی مونولیت، نیاز به ارزیابی متخصص را حفظ میکند. بنابراین، هوش مصنوعی در این مطالعات بیشتر بهعنوان ابزار تقویت تصمیم معماری عمل میکند: [8] برای طراحی سیستمهای جدید و [9] برای بازمعماری سیستمهای موجود.
مطالعهی SIAD چارچوبی مبتنی بر هوش مصنوعی برای تشخیص ناهنجاری در محیطهای اینترنت صنعتی اشیا ارائه میکند [10]. دادههای حسگرهای صنعتی معمولاً حجیم، پویا و پیچیدهاند و روشهای متعارف در مواجهه با آنها دقت کمتری دارند یا هشدارهای کاذب بیشتری ایجاد میکنند. این مسئله در زیرساختهایی مانند سامانههای تصفیه آب اهمیت بالایی دارد زیرا هشدار نادرست میتواند موجب خستگی اپراتور، مداخلههای نگهداری غیرضروری و کاهش اعتماد به سامانه نظارتی شود.
SIAD از معماری ترکیبی لبه و ابر استفاده میکند. در لایه لبه، مدل سبکوزن GRU وظیفه تشخیص اولیه و واکنش سریع به الگوهای غیرعادی را بر عهده دارد. دادهها یا رخدادهای مشکوک برای بررسی دقیقتر به ابر منتقل میشوند تا مدل Transformer تحلیل عمیقتری انجام دهد و اعتبار هشدار را ارزیابی کند. این تقسیم کار، پردازش بلادرنگ در محل تولید داده را با توانایی مدلهای پیچیدهتر برای کشف وابستگیهای پنهان ترکیب میکند. معماری پیشنهادی ساختاری ماژولار و مبتنی بر ریز خدمات دارد و از طریق MQTT و REST API با اجزای صنعتی موجود یکپارچه میشود. نقش هوش مصنوعی در این طرح صرفاً به تحلیل داده محدود نیست بلکه انتخاب و استقرار مدلها، مرز مسئولیت مؤلفهها و نحوه توزیع پردازش میان لبه و ابر را نیز شکل میدهد. GRU برای واکنش محلی با تأخیر کم بهکار میرود، در حالی که Transformer وظیفه تحلیل موارد پیچیدهتر و کاهش هشدارهای نادرست را دارد. این ترکیب میان دقت، زمان پاسخ، مقیاسپذیری و قابلیت اطمینان مصالحهای عملی ایجاد میکند.

جدول بالا نشان میدهد SIAD در هر دو مجموعه داده رفتاری باثبات و قابل اعتماد نشان میدهد و اختلاف عملکرد آن میان SWaT و WADI چندان چشمگیر نیست. با وجود این، مقایسه شاخصها روشن میکند که مدل در سطح تشخیص کلی قویتر از تفکیک دقیق رخدادها عمل میکند و هنوز برای رسیدن به دقتی کاملاً بینقص، به بهبود بیشتری نیاز دارد. AUC بالا در کنار نرخ مثبت کاذب پایین نیز نشان میدهد سامانه توانسته میان حساسیت و پرهیز از هشدارهای نادرست توازن مناسبی برقرار کند و هنوز جای پیشرفت دارد.

در جدول بالا، تفاوت آشکار میان معماریهای استقرار دیده میشود و مشخص است که نسخه لبهای کمترین تأخیر را دارد. با ورود پردازش ترکیبی و سپس اجرای کامل در ابر، زمان پاسخ به صورت معناداری افزایش مییابد و همین موضوع نشان میدهد که انتخاب معماری، مستقیماً بر کارایی بلادرنگ اثر میگذارد. برای سامانههای حساس، این فاصله فقط یک عدد نیست بلکه مرز میان پاسخگویی مناسب و تأخیر دردسرساز است.
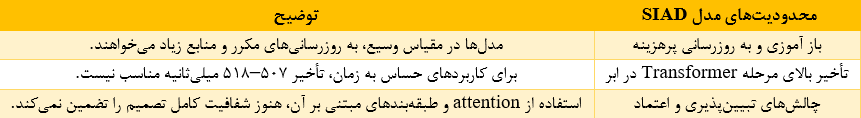
جدول بالا نشان میدهد که کارایی مناسب SIAD لزوماً به معنای آمادگی بیقید و شرط آن برای استقرار عملی نیست، زیرا هزینههای بازآموزی، محدودیتهای زمانی و مسئله اعتمادپذیری همچنان پابرجا هستند. نیاز به به روزرسانی مداوم در مقیاس بزرگ، بهرهبرداری از مدل را از نظر محاسباتی و اجرایی سنگین میکند و تأخیر بخش ابری نیز برای محیطهای حساس، یک مانع جدی به شمار میآید. از سوی دیگر، هرچند سازوکارهای attention تا حدی به تفسیرپذیری کمک میکنند، اما هنوز شفافیتی فراهم نمیکنند که بتوان با اطمینان کامل به منطق تصمیمگیری مدل تکیه کرد.
مطالعهی دوم تجربهی صنعتی شرکت Combitech را در توسعهی یک پلتفرم نرمافزاری برای نسل جدید گیرندههای دیجیتال تلویزیونی مبتنی بر استاندارد DVB بررسی میکند [11]. مسئلهی اصلی پروژه، ساخت یک سامانهی نهفته و بلادرنگ در شرایط زیر فشار زمان عرضه، تغییرپذیری نیازمندیها، توسعهی همزمان سختافزار و نرمافزار، پراکندگی جغرافیایی تیمها و نیاز به پشتیبانی از گونههای متنوع محصول برای بازارهای مختلف بود.
رویکرد محوری، توسعهی مدلمحور با تکیه بر UML و ابزار Rhapsody بود. مدل سامانه همراه با بخشهایی از کد C++ به کد عملیاتی C++ تبدیل میشد و لایهی اجرایی ابزار، وابستگی به سکوی هدف را تا حد زیادی پنهان میکرد. معماری نیز بر پایهی خط محصول نرمافزاری شکل گرفت تا تولید و نگهداری نسخههای مختلف محصول آسانتر شود. این ساختار، لایههایی مانند HAL، BSP، RTOS، OSAL، درایورهای رسانه، پلتفرم رسانهی مشترک و API اختصاصی را دربر میگرفت. این مطالعه مستقیماً از هوش مصنوعی استفاده نمیکند، اما چون نشان میدهد خودکارسازی در معماری نرمافزار فقط به تولید کد محدود نیست حائز اهمیت است. مدلها بخش بزرگی از مسیر تبدیل طراحی به پیادهسازی را خودکار کردند، اما اعمال قواعد معماری همچنان مسئلهساز باقی ماند. بیش از 60 قاعدهی معماری به زبان طبیعی مستند شده بود و کنترل انطباق مؤلفهها با آنها عمدتاً بر عهدهی معماران و بازبینی دستی قرار داشت. همینجا گلوگاه اصلی دیده میشود. دو معمار پروژه بخش قابل توجهی از زمان خود را صرف بازبینی انطباق 166 مؤلفه با قواعد معماری کردند و بسیاری از این بازبینیها پس از تکمیل یا آزمون مؤلفهها انجام شد. نتیجه دوبارهکاری و اصلاحات پرهزینه بود. وابستگی به قواعدی که به زبان طبیعی نوشته شده بودند نیز ابهام و تفسیرهای متفاوت ایجاد میکرد. این مطالعه بهخوبی نشان میدهد که رسمیسازی قواعد معماری و تحلیل خودکار آنها هنوز یک نیاز جدی است و فقط یک تجمل فنی نیست.
مطالعهی سوم کاربرد دو مدلچکر نرمافزاری، Blast و CBMC، را در آزمون اجزای یک پلتفرم ذخیرهسازی مبتنی بر حافظهی فلش بررسی میکند [12]. مسئلهی اصلی این است که آزمونهای متعارف، بهویژه در نرمافزارهای نهفته و پیچیده مانند درایورهای دستگاه و سامانههای فایل، اغلب خطاهای پنهان را آشکار نمیکنند. همین خطاها بعداً به هزینههای توسعه، پشتیبانی و نگهداری تبدیل میشوند.
در این پژوهش، ابزارها بر پایهی تحلیل صوری خودکار عمل میکنند و بر اساس یادگیری ماشین نیستند. Blast از پالایش انتزاع با هدایت مثال نقض و انتزاع محمولی استفاده میکند، در حالی که CBMC بر تحلیل کراندار و حل ارضاپذیری بولی تکیه دارد. مزیت هر دو در این است که میتوانند برنامهی C را مستقیماً تحلیل کنند و نیاز به ساخت دستی یک مدل انتزاعی مستقل را کاهش دهند. اثر این رویکرد بر فرایند مهندسی نرمافزار، جابهجایی بخشی از تضمین کیفیت از آزمون سناریو محور به سمت تحلیل نظاممند فضای حالت برنامه است. این ابزارها میتوانند مانند آزمون واحد پیشرفته عمل کنند و خطاهای نادر یا وابسته به شرایط مرزی را پیش از استقرار شناسایی کنند. برای اجزای سطح پایین مانند درایورها و مؤلفههای مدیریت ذخیرهسازی، این توانایی بسیار مهم است، چون نقص در چنین لایههایی معمولاً اثر زنجیرهای دارد.
یافتههای مقاله نشان میدهد مدلچکینگ ظرفیت خوبی برای تکمیل آزمونهای سنتی دارد، اما جایگزین کامل آن نیست. محدودیتهای مقیاسپذیری، وابستگی به کرانهای تحلیل، دشواری پوشش همهی ویژگیهای برنامههای C واقعی و نیاز به تخصص در تعریف مشخصات و تفسیر مثالهای نقض، استفاده از این ابزارها را در صنعت پیچیده میکند.
این سه مطالعه با وجود تفاوت در فناوریهای به کار رفته، یک نکتهی مشترک را نشان میدهند. ارزش واقعی هوشمندسازی در معماری نرمافزار صرفاً در افزودن یک مدل هوش مصنوعی به سامانه نیست، بلکه در خودکارسازی تصمیمها، کنترلها و تضمینهای معماری در نقاطی است که روشهای دستی به گلوگاه تبدیل میشوند. SIAD با توزیع هوشمند استنتاج میان لبه و ابر، میان دقت تشخیص و تأخیر عملیاتی توازن برقرار میکند. مطالعهی مدلمحور نشان میدهد که خودکارسازی تولید کد بدون خودکارسازی اعمال قوانین معماری کافی نیست. مطالعهی مدلچکینگ نیز ظرفیت تحلیل خودکار برای کشف خطاهای پنهان در مؤلفههای حساس را برجسته میکند. معماریهای نرمافزاری آینده باید ترکیبی از مدلهای هوشمند، قواعد معماری قابل اجرا، تحلیل صوری و نظارت خودکار باشند، بدون آن که نقش نظارت و تأیید انسانی در تصمیمهای حساس معماری کنار گذاشته شود.
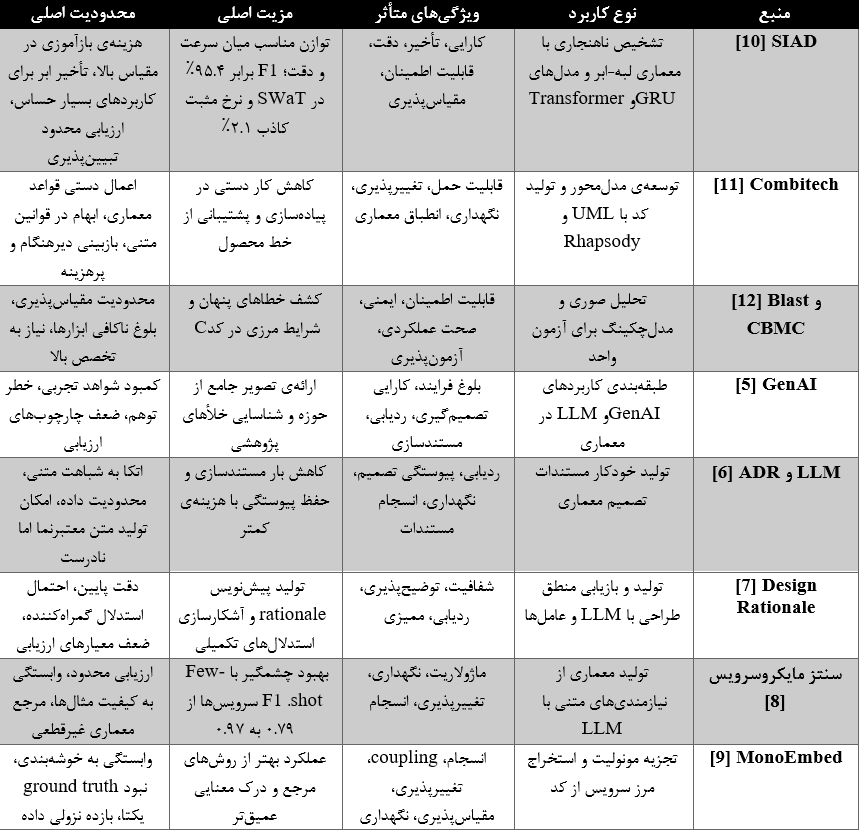
بررسی هشت مطالعه نشان میدهد که اثر هوش مصنوعی بر معماری نرمافزار در سه سطح رخ میدهد. در سطح نخست، AI مستقیماً رفتار زمان اجرای سامانه را شکل میدهد. نمونهی روشن آن SIAD در [10] است که با GRU و Transformer، توازن میان تأخیر، دقت و قابلیت اطمینان را تنظیم میکند. در سطح دوم، خودکارسازی برای کنترل و تضمین انطباق معماری به کار میرود. مطالعهی [11] نشان میدهد که تولید خودکار کد، بدون رسمیسازی قواعد معماری، کافی نیست و [12] نیز نشان میدهد تحلیل صوری میتواند خطاهای پنهان را آشکار کند، هرچند مقیاسپذیری آن محدود است. در سطح سوم، مدلهای زبانی بزرگ از تصمیمگیری و تکامل معماری پشتیبانی میکنند؛ [6] و [7] به ثبت و استخراج منطق طراحی میپردازند، [8] از نیازمندی به معماری میرسد و [9] مسیر معکوس را برای بازیابی مرزهای مایکروسرویس طی میکند. [5] هم این کاربردها را در سطح حوزه جمعبندی کرده است.
ارزش اصلی AI در معماری نرمافزار، تولید متن یا کد نیست بلکه کاهش بار شناختی، آشکارسازی ساختارهای پنهان و تقویت کنترلهای مهندسی است. با این حال، وابستگی به داده و زمینه، نبود ground truth قطعی، محدودیت شواهد تجربی و نیاز به نظارت انسانی همچنان پابرجاست. پس الگوی واقعبینانه، معماری تقویتشده با هوش مصنوعی است، و حداقل برای الان به معماری کاملاً خودکار نرسیدهایم.
هوش مصنوعی در معماری نرمافزار، بیش از ابزار تولید متن و کد، به سازوکاری برای پشتیبانی از تصمیمسازی و مستندسازی تبدیل شده است. یک الگوی تکرارشونده در مطالعات دیده میشود به این صورت که هرچه زمینهی معماری دقیقتر و ساخت یافتهتر بوده، خروجی هم بهتر شده است. این الگو در ADR، Design Rationale و نیز سنتز یا تجزیهی مایکروسرویسها خود را نشان میدهد. روند دیگر، فاصله گرفتن از تولید عمومی و حرکت به سمت تولید زمینهمند است. روشهایی مثل Few-shot، Last_K و بازیابی معنایی معمولاً از Zero-shot بهتر عمل کردهاند، چون مدل را از پاسخهای کلی و نامرتبط دور میکنند. در معماری نرمافزار، مسئله فقط توان تولید نیست بلکه تولید در چارچوب قیود معماری است.
از نظر پژوهشی، مهمترین شکاف به ارزیابی برمیگردد. بسیاری از مطالعات هنوز از معیارهایی مانند BLEU، ROUGE و BERTScore استفاده میکنند، اما این شاخصها لزوماً کیفیت تصمیم معماری را نشان نمیدهند. فاصلهی میان شباهت متنی و صحت معماری، بهویژه در ADR و DR، همچنان جدی است.
کمبود دادههای تخصصی و باکیفیت هم مانع مهم دیگری است. بیشتر پژوهشها به مخازن متنباز، issueها و discussionها تکیه دارند. این دادهها همیشه پیچیدگی واقعی سازمان را بازتاب نمیدهند و اغلب نویزی و ناهمگناند. در کنار آن، کیفیت داده، محدودیت مشاهدهپذیری و نوسان عملکرد مدل باعث میشود نتایج هنوز ثبات کاملاً قابل اتکایی نداشته باشند. AI در معماری نرمافزار زمانی ارزشمند میشود که در چرخهی human-in-the-loop و context-aware بهکار رود. نقش آن تقویت حافظه و تحلیل معماری است، و جایگزینی معمار نیست. تا وقتی کیفیت داده و محدودیت مشاهدهپذیری حل نشده، خروجی AI باید پیشنهادگر هوشمند بماند، و مرجع نهایی تصمیم نباشد.
هوش مصنوعی در معماری نرمافزار فقط ابزار تولید کد نیست. بیشتر به سازوکاری برای پشتیبانی از تصمیمسازی، مستندسازی و بازشناسی ساختارهای معماری تبدیل شده است. این اثرگذاری از تولید ADR و Design Rationale تا سنتز معماری از نیازمندیها و حتی تجزیهی مونولیت به ریزخدمت را دربر میگیرد. در مستندسازی، مدلهای زبانی میتوانند پیشنویس تصمیمها را بسازند، اما کیفیت آنها به زمینهای وابسته است که دریافت میکنند.
در تولید و سنتز معماری هم الگوی مشابهی دیده میشود. Few-shot و بازیابی زمینهای معمولاً از Zero-shot بهتر عمل میکنند، چون مدل را از پاسخهای کلی و نامرتبط دور نگه میدارند. با این حال، معماری پیشنهادی مدل لزوماً بهترین گزینه نیست چون تصمیم معماری فقط به منطق فنی وابسته نیست و قیود سازمانی، امنیت، هزینه و مهارت تیم هم در آن دخیلاند. در بازیابی معماری و تجزیهی سیستمهای قدیمی، AI میتواند وابستگیها و مرزهای بالقوه سرویسها را آشکار کند. این توانایی برای سامانههای بزرگ و کممستند ارزش زیادی دارد. اما تعیین مرز سرویسها پاسخ یگانه ندارد و بدون فهم بافت کسبوکار، خروجی مدل فقط یک پیشنهاد است، و تصمیم نهایی نیست.
مشکل مهم دیگر، ارزیابی است. شباهت متنی یا معیارهای رایج مثل F1 همیشه نشان نمیدهند که خروجی واقعاً از نظر معماری درست است. یک متن میتواند روان و منسجم باشد، اما با قیود واقعی سیستم ناسازگار بماند. پس ارزیابی باید به صحت معماری، شفافیت trade-offها و امکان پذیری اجرایی هم توجه کند.
در کل میتوان گفت AI جای معمار را نمیگیرد، اما میتواند تصمیمگیری را تقویت کند. ارزش واقعی آن زمانی دیده میشود که در یک چارچوب زمینهمند، قابلردیابی و human-in-the-loop به کار رود.
· [1] Richards, M., & Ford, N. (2025). Fundamentals of Software Architecture: A Modern Engineering Approach (2nd ed.). O'Reilly Media.
· [2] Bass, L., Lu, Q., Weber, I., & Zhu, L. (2025). Engineering AI Systems: Architecture and DevOps Essentials. Addison-Wesley.
· [3] Ford, N., Richards, M., Sadalage, P., & Dehghani, Z. (2021). Software Architecture: The Hard Parts: Modern Trade-Off Analyses for Distributed Architectures. O'Reilly Media.
· [4] Skelton, M., & Pais, M. (2025). Team Topologies: Organizing Business and Technology Teams for Fast Flow (2nd ed.). IT Revolution.
· [5] Esposito, M., Li, X., Moreschini, S., Ahmad, N., Cerny, T., Vaidhyanathan, K., Lenarduzzi, V., & Taibi, D. (2025). Generative AI for software architecture: Applications, challenges, and future directions. arXiv preprint arXiv:2503.13310.
· [6] Gupta, A., Dhar, R., Feitosa, D., & Vaidhyanathan, K. (2026). Context matters: Evaluating context strategies for automated ADR generation using LLMs. arXiv preprint arXiv:2604.03826.
· [7] Zhou, X., Li, R., Liang, P., Zhang, B., Shahin, M., Li, Z., & Yang, C. (2025). Using LLMs in generating design rationale for software architecture decisions. ACM Transactions on Software Engineering and Methodology (TOSEM).
· [8] Albuquerque, D., Renan, J., Rodríguez, G., Dantas, E., França, A., Perkusich, M., Gorgônio, K., & Perkusich, A. (2026). From textual requirements to microservice architectures: A comprehensive evaluation of LLM-based design synthesis. arXiv preprint arXiv:2607.28307.
· [9] Sellami, K., & Saied, M. A. (2025). Contrastive learning-enhanced large language models for monolith-to-microservice decomposition. arXiv preprint arXiv:2502.04604.
· [10] Asad, M., & Alhasawi, Y. (2026). SIAD: A low-latency AI-driven software architecture for anomaly detection in industrial IoT environments. Cluster Computing, 29, Article 427.
· [11] Mattsson, A., Lundell, B., Lings, B., & Fitzgerald, B. (2009). Linking model-driven development and software architecture: A case study. IEEE Transactions on Software Engineering, 35(1), 83–93.
· [12] Kim, M., Kim, Y., & Kim, H. (2011). A comparative study of software model checkers as unit testing tools: An industrial case study. IEEE Transactions on Software Engineering, 37(2), 146–160.
اين مطلب، بخشي از تمرينهاي درس معماري نرمافزار در دانشگاه شهيدبهشتي است.
#معماري_نرم_افزار_بهشتي

