
وقتی درباره سیستمهای مبتنی بر هوش مصنوعی و Large Language Models یا همان LLMها صحبت میکنیم، اولین چیزی که به نظر میرسد خودِ مدل است؛ اینکه GPT چیست، چه مدلی دقیقتر است، چطور Prompt بنویسیم یا چطور یک مدل را Fine-tune کنیم و از این قبیل سؤالها.
اما هرچه بیشتر با سیستمهای واقعی مبتنی بر ML و LLM کار میکنیم، یک سؤال مهمتر خودش را نشان میدهد:
مدل قرار است دقیقاً کجای سیستم قرار بگیرد؟
یک مدل زبانی بهتنهایی یک سیستم نرمافزاری محسوب نمیشود. در یک سامانه واقعی، مدل باید با داده، پایگاههای دانش، سرویسهای نرمافزاری، APIها، حافظه، ابزارهای خارجی، زیرساخت اجرا، مانیتورینگ، امنیت و در نهایت کاربر ارتباط داشته باشد و از همینجا مسئله معماری شروع میشود.
در این مطالعه تلاش کردم به جای اینکه فقط درباره قابلیتهای LLMها صحبت کنم، مسئله را از زاویه Software Architecture بررسی کنم: اگر قرار باشد یک سیستم هوشمند در مقیاس واقعی طراحی کنیم، چه اجزایی باید در معماری آن دیده شوند؟ چه دغدغههایی با ورود ML و LLM به سیستم به وجود میآیند؟ و آیا میتوان بر اساس پژوهشهای موجود، یک Reference Architecture قابل دفاع برای این سیستمها پیشنهاد کرد؟
یکی از منابعی که برای شروع این مسیر اهمیت زیادی داشت، پژوهش Muccini و Vaidhyanathan درباره معماری سیستمهای مبتنی بر Machine Learning بود. از دید این پژوهش مسئله صرفاً اضافه کردن یک مدل ML به نرمافزار نیست و ورود ML باعث ورود مفاهیم جدیدی به فضای معماری میشود؛ از داده و مدل گرفته تا Data Engineer، Data Scientist و دغدغههایی مانند کیفیت داده، Fairness، Privacy و قابلیت اعتماد.
در معماری نرمافزار سنتی، معمولاً تمرکز اصلی روی اجزای نرمافزاری، پایگاه داده، سرویسها، رابطها و ویژگیهای کیفی سیستم است. اما در یک سیستم ML، داده و مدل نیز عملاً به بخشی از معماری تبدیل میشوند و حتی انتخاب مدل میتواند روی ویژگیهای کیفی نرمافزار تأثیر بگذارد. برای مثال، یک مدل پیچیدهتر ممکن است دقت بالاتری ایجاد کند، اما در مقابل منابع محاسباتی بیشتری مصرف کند و Latency را افزایش دهد. بنابراین از همان ابتدا یک رابطه میان کیفیت مدل و کیفیت کل سیستم شکل میگیرد. همین موضوع باعث میشود معمار دیگر نتواند نرمافزار و ML را کاملاً جدا از یکدیگر ببیند.
این سؤال ما را به سمت MLOps میبرد.
در یک سیستم ML، کار با آموزش مدل تمام نمیشود. داده باید مدیریت شود، مدل باید Version شود، Training باید تکرارپذیر باشد، مدل باید Deploy شود و پس از Deployment نیز رفتار آن باید Monitoring شود.
پژوهش Bialek، Groenboom و Andrikopoulos دقیقاً از همین زاویه جالب است. این پژوهش با یک Systematic Mapping Study، نقطه تلاقی سه حوزه Sustainable Digital Transformation، Machine Learning و Software Architecture را بررسی میکند. نتیجه قابل توجه این پژوهش این بود که با وجود حجم بالای پژوهشها در هر یک از این حوزهها، تقاطع هر سه حوزه نسبتاً کوچک است.
از میان ۱۵۰ مطالعه نهایی این پژوهش، ۱۴۲ مطالعه با Machine Learning و Sustainable Digital Transformation ارتباط داشتند، اما فقط ۱۲ مطالعه ارتباط Sustainable Digital Transformation و Software Architecture را پوشش میدادند و تنها ۴ مطالعه در تقاطع هر سه حوزه قرار میگرفتند. این نتیجه نشان میدهد مسئله معماری سیستمهای ML هنوز از نظر پژوهشی کاملاً تثبیت نشده است.
از طرف دیگر، بررسی اجزای MLOps نیز تصویر جالبی نشان داد: Data Curation بیشترین حضور را داشت، در حالی که مؤلفههایی مانند Storage & Versioning، CI/CD و Inference در مطالعات بسیار کمتر دیده میشدند.
به زبان ساده، در بسیاری از پژوهشها درباره «مدل و داده» صحبت شده، اما معماری کامل چرخه عمر مدل هنوز به همان اندازه در دنیای پژوهشی پررنگ نیست.
در اینجا یک پژوهش دیگر نیز برای این بحث اهمیت پیدا میکند. Najafabadi در پژوهش Reference Architecture of MLOps Workflows دقیقاً به مسئله نبود یک روش استاندارد و یکپارچه برای طراحی و مدیریت Workflowهای MLOps پرداخته و یک Reference Architecture برای این Workflowها پیشنهاد میکند. نکته جالب این پژوهش، علاوه بر بحث یکپارچهسازی اجزای مختلف MLOps، توجه به میزان مناسب دخالت انسان در Workflowهای MLOps است. بنابراین MLOps فقط مجموعهای از ابزارها برای Deploy کردن مدل نیست، بلکه بخشی از معماری و چرخه عمر سیستم محسوب میشود.
با ظهور LLMها، مسئله یک لایه پیچیدهتر میشود.
پژوهش Schmid و همکاران که ۱۸ مقاله مرتبط با استفاده از LLMها در Software Architecture را بررسی کرده است، نشان میدهد LLMها تاکنون در حوزههایی مانند Classification & Detection، Extraction & Generation، Reference Architectures و Architectural Assistants به کار گرفته شدهاند. طبق این مطالعات، LLMها گاهی برای انجام کامل یک وظیفه و گاهی فقط برای یک Subtask استفاده شدهاند.
اما نکته جالبتر این است که بخش قابل توجهی از این پژوهشها هنوز به روشهای ساده Prompting متکی هستند. Zero-shot Prompting رایجترین تکنیک گزارششده بوده و تکنیکهایی مانند Chain-of-Thought و Retrieval-Augmented Generation هنوز حضور محدودی داشتهاند.
بنابراین اکنون یک سؤال مهم شکل میگیرد:
اگر قرار است LLM در یک سیستم واقعی و پیچیده قرار بگیرد، آیا صرفاً قرار دادن یک API برای مدل کافی است؟
بر اساس این مجموعه مطالعات پاسخ به روشنی خیر است. حال باید علت این پاسخ را بررسی کنیم.
یکی از منابع مهم دیگر در این مسیر، SALLMA است؛ معماریای برای سیستمهای Multi-Agent مبتنی بر LLM.
ایده اصلی SALLMA این است که یک Agent منفرد محدودیتهایی دارد؛ برای مثال محدودیت در تخصصیسازی وظایف، حافظه و دسترسی به اطلاعات معتبر. در مقابل، میتوان چند Agent تخصصی را در یک معماری هماهنگ کرد تا هرکدام وظیفه مشخصی را انجام دهند.
SALLMA این ساختار را در دو لایه اصلی سازماندهی میکند:
Operational Layer برای مدیریت درخواست، اجرای وظایف و Orchestration
Knowledge Layer برای نگهداری و مدیریت دانش، Metamodelها و تنظیمات Workflowها و Agentها
این ایده برای معماری پیشنهادی من یک پیام مهم دارد:
LLM نباید به عنوان یک «جعبه هوشمند» منفرد در مرکز سیستم دیده شود؛ بلکه باید بخشی از یک اکوسیستم معماریشده در نظر گرفته شود.
از طرف دیگر، مقاله Bucaioni و همکاران با عنوان A Functional Software Reference Architecture for LLM-Integrated Systems دقیقاً به همین خلأ معماری نزدیک میشود. نویسندگان با اشاره به نبود یک Software Reference Architecture پذیرفتهشده برای سیستمهای LLM-integrated، یک Functional Reference Architecture اولیه ارائه میکنند و دغدغههایی مانند Privacy، Security، Modularity و Interoperability را مورد توجه قرار میدهند. معماری آنها نیز روی سه سیستم متنباز در حوزههای Computer Vision، Text Processing و Coding بررسی شده است.
برای این پژوهش، اهمیت این مقاله در این است که نشان میدهد مسئله Reference Architecture برای LLM-integrated Systems فقط یک ایده نظری نیست و در پژوهشهای جدید نیز بهعنوان یک مسئله معماری مستقل مطرح شده است.
وقتی وارد سیستمهای واقعی میشویم، انتخاب معماری به یک مسئله Trade-off تبدیل میشود.
پژوهش Indykov، Wohlrab و Strüber روی چهار شرکت فعال در حوزه AI نشان میدهد که سازمانها به صورت تکرارشونده با کیفیتهایی مانند Reliability، Functional Suitability و Resource Efficiency مواجهاند. و مهمتر اینکه رسیدن به یک Quality Attribute معمولاً بدون هزینه برای سایر ویژگیها نیست.
برای مثال کاهش منابع مصرفی میتواند به کاهش تست، Monitoring یا ظرفیت پردازشی منجر شود. یا مدلهای پیچیدهتر ممکن است Accuracy بیشتری ایجاد کنند، اما توضیحپذیری تصمیمات آنها دشوارتر شود.
بنابراین معماری پیشنهادی نباید فقط بگوید «چه اجزایی وجود دارند»، بلکه باید امکان مدیریت این Trade-offها را نیز فراهم کند.
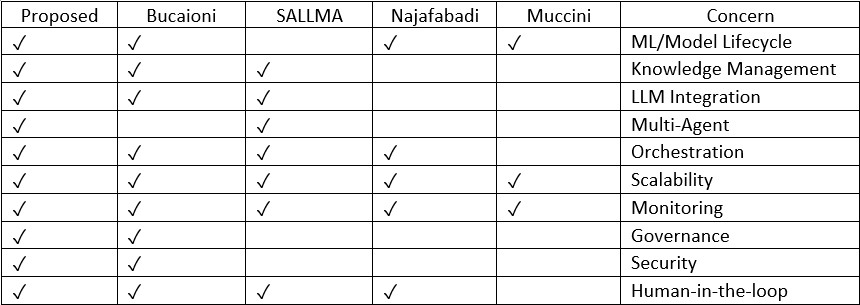
این جدول نشان میدهد هر یک از پژوهشهای بررسیشده بیشتر روی کدام بخش از مسئله تمرکز دارند و معماری پیشنهادی چگونه تلاش میکند این دغدغهها را در کنار یکدیگر قرار دهد. و رسم این جدول به معنی برتری مطلق معماری پیشنهادی نیست؛ بلکه هدف آن نشان دادن این است که ایده معماری پیشنهادی از کنار هم قرار دادن چند خط پژوهشی مختلف شکل گرفته است.
سیستم LLM اگر قرار باشد در محیط واقعی استفاده شود، باید بتواند با افزایش تعداد درخواستها کنار بیاید.
اینجا مقاله Semerikov و همکاران درباره استفاده از Machine Learning برای Autoscaling در Microservices Architecture اهمیت پیدا میکند. این پژوهش به خوبی نشان میدهد که ML میتواند برای پیشبینی بار و تصمیمگیری درباره Scaling سرویسها مورد استفاده قرار گیرد و در کنار الگوهایی مانند API Gateway، Circuit Breaker، SAGA و CQRS قرار بگیرد.
بنابراین Scaling در معماری پیشنهادی صرفاً یک ویژگی زیرساختی نیست؛ بلکه میتواند بخشی از رفتار هوشمند سیستم نیز باشد.
با کنار هم قرار دادن این خطوط پژوهشی، به یک نتیجه رسیدم:
یک Reference Architecture برای سیستمهای LLM/ML باید حداقل پنج مسئله را همزمان پوشش دهد: تعامل با کاربر و سیستمهای خارجی، Orchestration و مدیریت Workflow، مدیریت LLM و فرآیند Inference، مدیریت داده و دانش، Governance، Security، Monitoring و کنترل چرخه عمر. و بر همین اساس، معماری پیشنهادی به صورت یک معماری لایهای و ماژولار طراحی شده است.
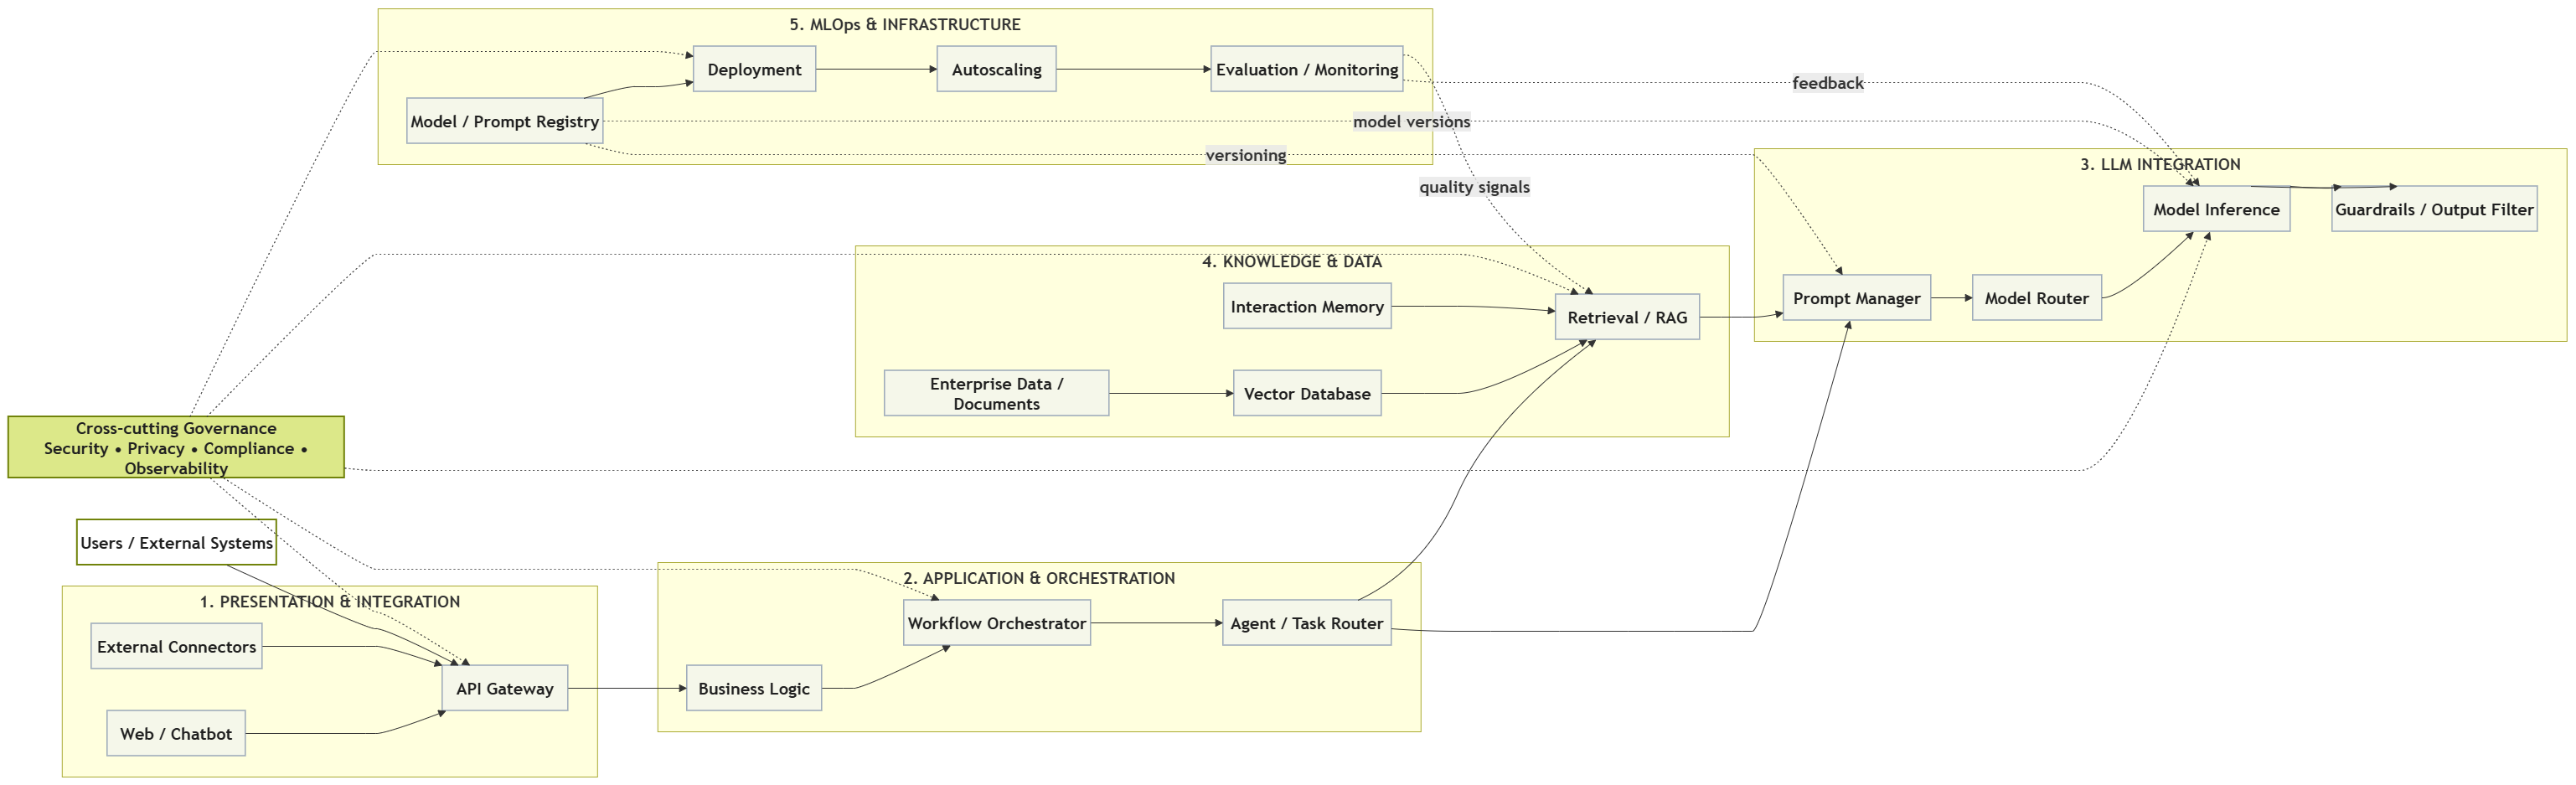
معماری را میتوان در چند بخش اصلی دید.
این لایه نقطه ورود کاربران و سیستمهای خارجی است. رابطهای وب، Chatbotها، API Gateway و Connectorها در این بخش قرار میگیرند و وجود این لایه باعث میشود LLM مستقیماً به Interface یا Client وابسته نباشد و بتواند از طریق APIهای استاندارد با سایر اجزا هم تعامل داشته باشد.
در این لایه منطق اصلی سیستم قرار دارد.
Orchestrator وظیفه دارد مشخص کند یک درخواست باید از چه Workflowای عبور کند و چه سرویسها یا Agentهایی باید درگیر شوند. در سیستمهای Multi-Agent، این بخش میتواند نقش هماهنگکننده Agentهای تخصصی را داشته باشد. به این ترتیب، معماری از یک مدل منفرد به سمت یک سیستم قابل توسعه حرکت میکند.
این بخش قلب AI سیستم است، اما عمداً آن را به عنوان «کل سیستم» در نظر نمیگیریم. در این لایه میتوان اجزایی مانند Pre-processing، Prompt Processing، Model Inference، Model/Agent Selection، Post-processing و Output Filtering را قرار داد. همچنین این لایه باید امکان استفاده از مدلهای مختلف را فراهم کند؛ یعنی معماری نباید به یک Provider یا یک مدل خاص وابسته باشد.
یکی از مهمترین بخشهای معماری همین لایه است.
LLM به تنهایی نمیتواند دانش اختصاصی یک سازمان را در خود نگه دارد. بنابراین سیستم باید بتواند به منابعی مانند Document Repository، Enterprise Knowledge Base، Architecture Repository، Structured Databases، Vector Database و Interaction Memory متصل شود و در این مرحله RAG نیز میتواند نقش مهمی ایفا کند. کاربر سؤال میپرسد، سیستم اطلاعات مرتبط را از منابع معتبر بازیابی میکند و سپس این اطلاعات به عنوان Context در اختیار مدل قرار میگیرد. این کار وابستگی سیستم به دانش داخلی و ثابت مدل را کاهش میدهد و امکان استفاده از دانش بهروز و تخصصی را فراهم میکند.
این بخش عمداً به صورت یک Concern عرضی در نظر گرفته شده است.
امنیت، Privacy، Compliance، Fairness، Guardrails و Monitoring نباید فقط در یک مرحله از سیستم قرار بگیرند. برای مثال، Monitoring باید بتواند Latency، Error Rate، Resource Usage و رفتار سیستم را بررسی کند. Guardrails نیز میتوانند سیاستهای امنیتی و محتوایی را اعمال کنند و از ورود Promptهای مخرب یا خروجیهای نامناسب جلوگیری کنند. از طرف دیگر، Human-in-the-loop در تصمیمهای حساس اهمیت دارد. بهخصوص در سیستمهایی که خروجی LLM میتواند مستقیماً روی یک تصمیم سازمانی اثر بگذارد، نباید خروجی مدل را معادل حقیقت در نظر گرفت.
یک جزء مهم دیگر که نباید در معماری نادیده گرفته شود، چرخه عمر مدل است.
مدل همه مراحل زیر را در بر دارد:
Train → Validate → Register → Deploy → Monitor → Evaluate → Update
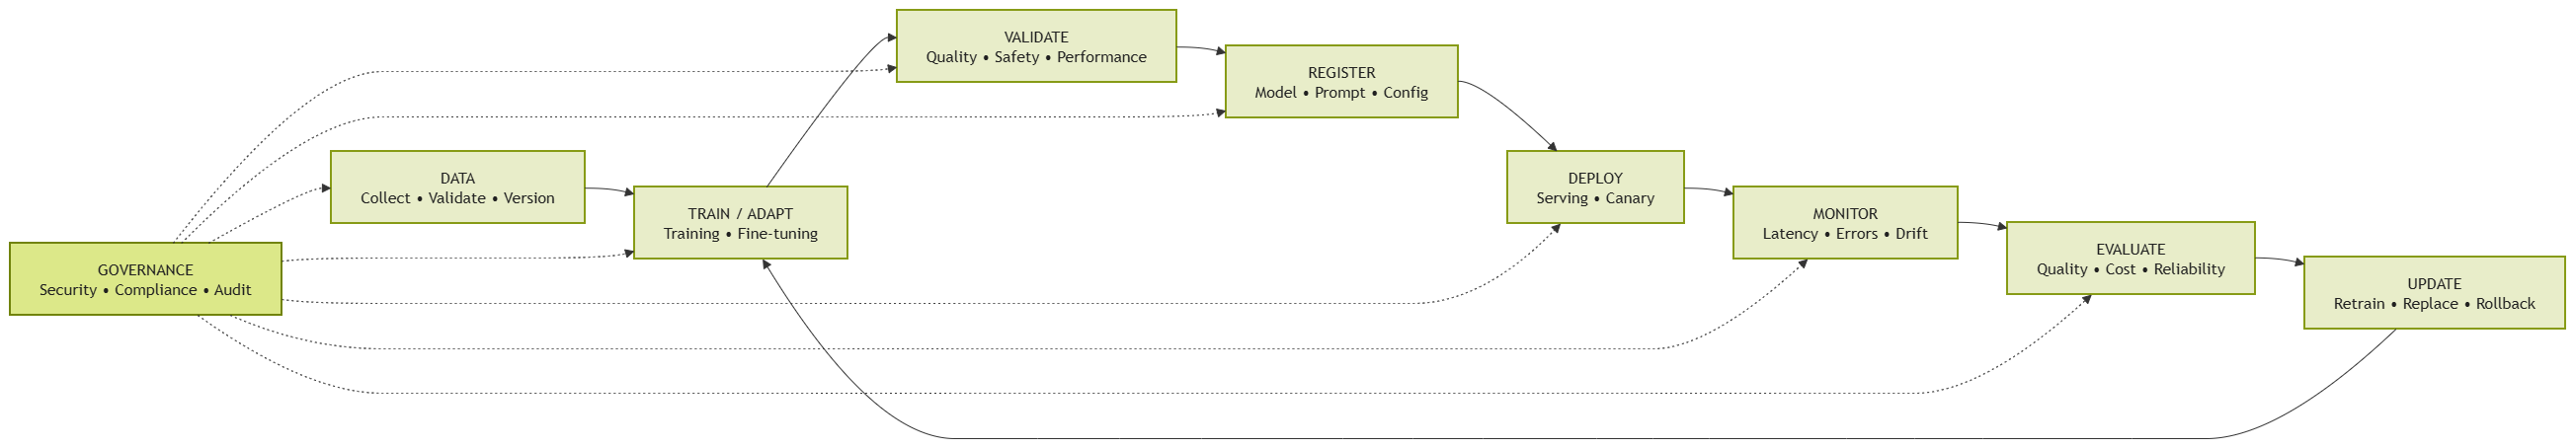
در این چرخه، Model Registry، Versioning، CI/CD، Evaluation و Monitoring بسیار اهمیت پیدا میکنند.
این بخش یکی از تفاوتهای مهم سیستمهای ML/LLM با بسیاری از نرمافزارهای سنتی است؛ زیرا Artifact اصلی سیستم فقط Source Code نیست. Dataset، Model، Prompt، Configuration و حتی نسخههای Knowledge Base میتوانند بر رفتار سیستم اثر بگذارند. بنابراین Versioning نباید فقط به کد محدود شود.
در این مرحله چند تصمیم اصلی در طراحی معماری گرفته شد.
اولین تصمیم، استفاده از یک ساختار Layered و Modular بود. دلیل این انتخاب این بود که مسئولیتهای مختلف از یکدیگر جدا شوند و تغییر یک بخش، کمترین اثر ممکن را روی بخشهای دیگر داشته باشد.
تصمیم دوم، جدا کردن Application & Orchestration از LLM Integration بود. دلیل آن این است که منطق اصلی سیستم نباید به یک مدل یا Provider خاص وابسته شود. اگر مدل تغییر کند، نباید مجبور باشیم Business Logic سیستم را نیز تغییر دهیم.
تصمیم سوم، جدا کردن Knowledge & Data از LLM بود. این تصمیم از این ایده میآید که دانش سیستم نباید الزاماً داخل مدل قرار داشته باشد. با این جداسازی میتوان Knowledge Base را تغییر داد یا بهروزرسانی کرد، بدون اینکه الزاماً مدل اصلی تغییر کند.
تصمیم چهارم، قرار دادن Governance، Security و Monitoring به صورت Cross-cutting Concern بود. این تصمیم به این دلیل گرفته شد که این مسائل فقط مربوط به یک لایه خاص نیستند و باید در بخشهای مختلف سیستم قابل اعمال باشند.
تصمیم پنجم، جدا کردن Model Lifecycle از Runtime Processing بود. مدل بعد از Deploy شدن تمام نمیشود و باید Version، Monitor، Evaluate و در صورت نیاز Update شود. بنابراین MLOps باید به عنوان بخشی از چرخه عمر معماری در نظر گرفته شود.
این تصمیمها در کنار هم ساختار معماری پیشنهادی را شکل میدهند.
تا اینجا معماری مشخص میکند چه اجزایی در سیستم وجود دارند. اما برای اینکه رفتار معماری واضحتر شود، میتوان یک درخواست نمونه را نیز دنبال کرد.
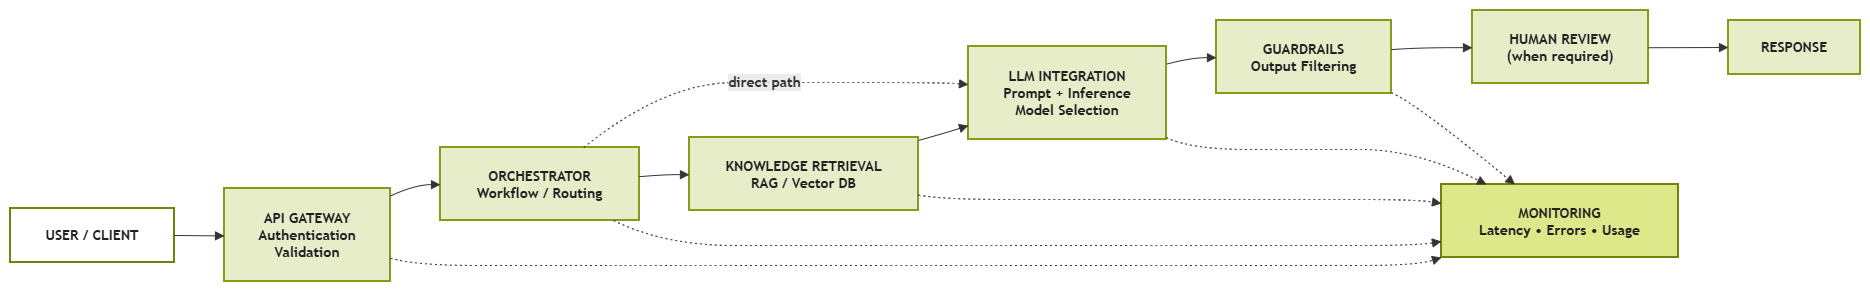
فرض کنیم کاربر یک سؤال را از طریق Web یا Chatbot ارسال میکند. ابتدا درخواست وارد API Gateway میشود و Authentication و Validation اولیه انجام میشود. سپس درخواست به Application & Orchestration Layer میرسد. Orchestrator تصمیم میگیرد درخواست به چه Workflowای نیاز دارد. اگر سؤال نیازمند اطلاعات اختصاصی باشد، سیستم از Knowledge Layer اطلاعات مرتبط را بازیابی میکند. اطلاعات بازیابیشده به همراه درخواست کاربر در اختیار LLM قرار میگیرد. مدل پاسخ اولیه را تولید میکند و خروجی میتواند قبل از بازگشت به کاربر از Guardrails یا Output Filtering عبور کند. در موارد حساس، Human-in-the-loop نیز میتواند وارد این فرآیند شود.
در تمام این مراحل، اطلاعاتی مانند Latency، Error Rate و Resource Usage میتوانند برای Monitoring ثبت شوند. این جریان نشان میدهد که LLM تنها یکی از اجزای فرآیند است و نتیجه نهایی حاصل تعامل چندین جزء معماری است.
یکی از دلایل اصلی طراحی این معماری، توجه همزمان به چند Quality Attribute بوده است.
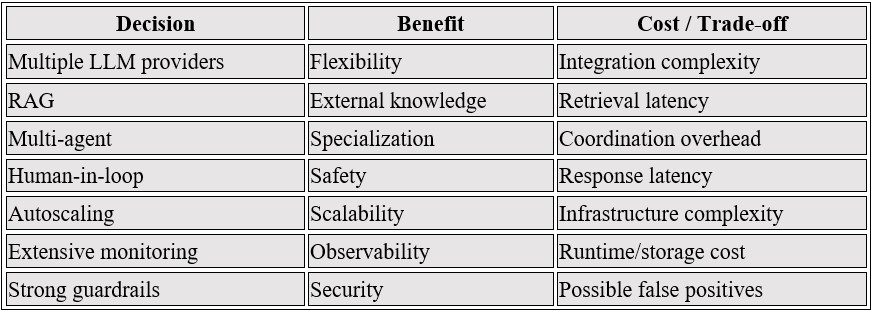
برای مثال، جداسازی لایهها میتواند Modifiability را افزایش دهد، اما تعداد Interfaceها و اجزای سیستم را بیشتر میکند. استفاده از RAG میتواند دسترسی به دانش تخصصی را بهتر کند، اما Retrieval نیز به سیستم اضافه شده و میتواند Latency و Complexity را افزایش دهد. Multi-Agent Architecture میتواند امکان تخصصیسازی وظایف را فراهم کند، اما Coordination Overhead ایجاد میکند. Human-in-the-loop میتواند کنترل و Safety را افزایش دهد، اما در مقابل زمان پاسخ را بیشتر میکند.
بنابراین معماری پیشنهادی قرار نیست همه Quality Attributeها را به صورت همزمان و بدون هزینه به حداکثر برساند. هدف، فراهم کردن ساختاری است که این Trade-offها در آن قابل مشاهده و مدیریت باشند.
معماری پیشنهادی برای پشتیبانی از چند Quality Attribute اصلی طراحی شده است.
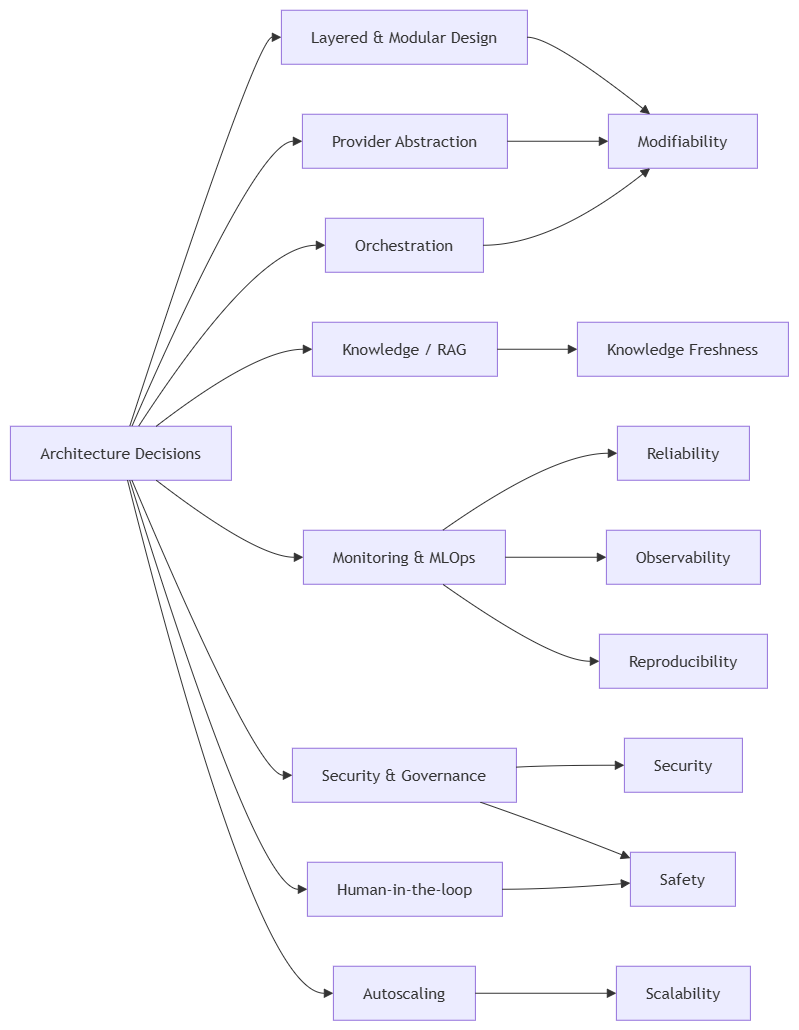
برای مثال، جداسازی لایهها و Provider Abstraction از Modifiability پشتیبانی میکنند. Knowledge Layer و RAG از دسترسی به دانش تخصصی و بهروز حمایت میکنند. Monitoring و Fallback Mechanisms میتوانند به Reliability کمک کنند و Autoscaling از Scalability پشتیبانی میکند.
در مقابل، همانطور که در بخش Trade-offها گفته شد، هر مکانیزم معماری هزینهای نیز دارد. بنابراین انتخاب هر جزء باید بر اساس Context و Requirements سیستم واقعی انجام شود.
برای اینکه معماری پیشنهادی فقط مجموعهای از اجزای انتخابشده به صورت شهودی نباشد، ارتباط میان نیازمندیها، اجزای معماری و Quality Attributes نیز در نظر گرفته شد.
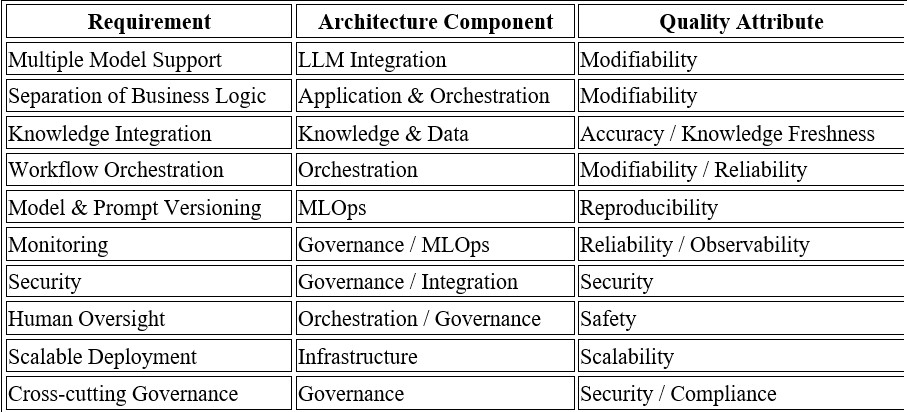
این جدول نشان میدهد که اجزای مختلف معماری مستقیماً با نیازمندیهای استخراجشده مرتبط هستند و هر جزء حداقل یک مسئله مشخص در طراحی سیستم را پاسخ میدهد.
منظور از Reference Architecture این نیست که این ساختار تنها معماری صحیح برای تمام سیستمهای LLM است. و برعکس، معماری باید متناسب با Context، Requirements، Constraints و Quality Attributes هر سیستم تنظیم شود. هدف از بیان Reference Architecture این است که یک نقطه شروع مشترک ایجاد کند. که یعنی هنگام طراحی یک سیستم جدید بتوان پرسید: آیا داده و دانش سیستم مشخص شده است؟ مدل چگونه Integration میشود؟ Workflowها چگونه Orchestrate میشوند؟ مدل و Prompt چگونه Version میشوند؟ Monitoring کجاست؟ Security و Governance چگونه اعمال میشوند؟ و در نهایت، سیستم چگونه در برابر افزایش بار Scale میشود؟
به این ترتیب، Reference Architecture بیشتر از اینکه یک نسخه آماده برای پیادهسازی باشد، یک ابزار برای فکر کردن درباره معماری است.
در ابتدا ممکن است تصور کنیم چالش اصلی در ساخت یک سیستم LLM انتخاب مدل مناسب است. اما وقتی مطالعات مختلف را کنار هم قرار میدهیم، تصویر متفاوتی شکل میگیرد. مسئله اصلی فقط Model نیست. مسئله، سیستمی است که Model را در خود جای میدهد. داده، دانش، مدل، Workflow، API، زیرساخت، Monitoring، Security، Governance و انسان همگی بخشی از همان سیستم هستند. به همین دلیل، به نظر میرسد آینده سیستمهای LLM نه صرفاً در «مدلهای بزرگتر»، بلکه در معماریهایی است که بتوانند این اجزا را به شکل قابل اعتماد، مقیاسپذیر و قابل کنترل کنار هم قرار دهند.
این معماری یک Reference Architecture پیشنهادی است و نه یک استاندارد نهایی.
در این مرحله تمرکز اصلی پژوهش بر مرور منابع، استخراج دغدغههای معماری و سنتز یک معماری مرجع بوده است و هنوز یک Prototype کامل برای اندازهگیری Runtime اجرا نشده است. مرحله بعدی برای اعتبارسنجی آن میتواند شامل پیادهسازی یک Prototype، مقایسه معماریهای مختلف و ارزیابی ویژگیهایی مانند Scalability، Latency، Reliability، Resource Efficiency، Explainability و Security باشد. همچنین میتوان معماری را در یک Case Study واقعی پیادهسازی کرد و با استفاده از معیارهای کمی، تأثیر انتخاب Patternهای معماری را ارزیابی کرد.
این موضوع با پژوهشهایی که اخیراً چارچوبهای کمی برای ارزیابی معماری سیستمهای ML ارائه کردهاند نیز همراستا است؛ برای مثال معیارهایی مانند Number of Requests at Max Throughput، Horizontal Scaling Index و Scalability Coefficient میتوانند در ارزیابیهای آینده مورد استفاده قرار بگیرند.
مسیر این مطالعه برای من از یک سؤال ساده شروع شد:
اگر LLM قرار است بخشی از یک سیستم نرمافزاری واقعی باشد، معماری آن سیستم چگونه باید طراحی شود؟
مرور پژوهشها نشان داد که هنوز یک پاسخ واحد و تثبیتشده برای این سؤال وجود ندارد.
پژوهشهای معماری ML بر نقش داده، مدل، Stakeholderهای جدید و MLOps تأکید میکنند. مطالعات LLM، مسئله Integration، Knowledge، Modularity و تعامل با مدلها را پررنگ میکنند. معماریهای Multi-Agent مسئله Orchestration و تخصصیسازی Agentها را مطرح میکنند و مطالعات صنعتی نیز نشان میدهند که معماری همواره با Trade-off میان ویژگیهای کیفی مختلف همراه است.
بر اساس همین نقاط مشترک، معماری مرجع پیشنهادی تلاش میکند یک تصویر یکپارچه از این اجزا ارائه دهد؛ تصویری که در آن LLM دیگر یک «جعبه سیاه در مرکز سیستم» نیست، بلکه یکی از اجزای یک معماری بزرگتر، قابل مدیریت و قابل تکامل است.
و شاید مهمترین نتیجه همین باشد:
برای ساخت یک سیستم هوشمند قابل اتکا، فقط هوشمند بودن مدل کافی نیست؛ خودِ سیستم نیز باید معماری مناسبی داشته باشد.
و در آخر نیاز است بیان شود «اين مطلب، بخشي از تمرينهاي درس معماري نرمافزار در دانشگاه شهيدبهشتي است»
[1] Bialek, L., Groenboom, R., & Andrikopoulos, V. (2026). Software architecture for machine learning to aid sustainable digital transformation: A systematic mapping study. Information and Software Technology, 190, 107931. DOI: 10.1016/j.infsof.2025.107931.
[2] Muccini, H., & Vaidhyanathan, K. (2021). Software Architecture for ML-based Systems: What Exists and What Lies Ahead. Proceedings of the IEEE/ACM Workshop on AI Engineering – Software Engineering for AI (WAIN@ICSE 2021), 121–128. DOI: 10.1109/WAIN52551.2021.00026.
[3] Schmid, L., Hey, T., Armbruster, M., Corallo, S., Fuchß, D., Keim, J., Liu, H., & Koziolek, A. (2025). Software Architecture Meets LLMs: A Systematic Literature Review. arXiv:2505.16697.
[4] Becattini, M., Verdecchia, R., & Vicario, E. (2025). SALLMA: A Software Architecture for LLM-Based Multi-Agent Systems. IEEE/ACM International Workshop on New Trends in Software Architecture (SATrends@ICSE 2025). DOI: 10.1109/SATRENDS66715.2025.00006.
[5] Semerikov, S. O., Zubov, D., Kupin, A., Kosei, M., & Holiver, V. (2024). Models and Technologies for Autoscaling Based on Machine Learning for Microservices Architecture. Proceedings of the 8th International Conference on Computational Linguistics and Intelligent Systems (COLINS 2024), 316–330.
[6] Indykov, V., Wohlrab, R., & Strüber, D. (2025). Quality trade-offs in ML-enabled systems: a multiple-case study. Proceedings of the 40th ACM/SIGAPP Symposium on Applied Computing (SAC 2025), 1730–1737. DOI: 10.1145/3672608.3707754.
[7] Emanuilov, S., & Dimov, A. (2025). A quantitative framework for evaluating architectural patterns in ML systems. arXiv:2501.11543.
[8] Najafabadi, F. A. (2024). Reference Architecture of MLOps Workflows. In A. Ampatzoglou et al. (Eds.), Software Architecture. ECSA 2024 Tracks and Workshops, Lecture Notes in Computer Science, vol. 14937, pp. 49–57. Springer. DOI: 10.1007/978-3-031-71246-3_6.
[9] Bucaioni, A., Weyssow, M., He, J., Lyu, Y., & Lo, D. (2025). A Functional Software Reference Architecture for LLM-Integrated Systems. Proceedings of the 22nd IEEE International Conference on Software Architecture (ICSA 2025), pp. 1–5. DOI: 10.1109/ICSA-C65153.2025.00006.

