
با ظهور و تکامل دستیاران خودکار کدنویسی و ابزارهای مبتنی بر Agentic AI نظیر Claude Code، OpenAI Codex CLI، OpenCode و Cursor، سبک توسعه نرمافزار دستخوش تحولی بنیادین شده است. در این پارادایم نوین، ایجنتهای هوشمند دیگر فقط یک مدل تکمیل کد درون ادیتور نیستند؛ بلکه مستقیماً به محیط ترمینال، سیستم فایل و مخازن کد دسترسی داشته و وظایف پیچیدهای نظیر ریفکتورینگ گسترده، کشف باگهای ساختاری و توسعه ماژولهای جدید را بر عهده میگیرند.
اما در پروژههای واقعی و انترپرایز با صدها هزار خط کد و چندین مونوریپو (Monorepo) یا سرویس مجزا، این ایجنتها بلافاصله با یک گلوگاه اساسی مواجه میشوند: ناتوانی ابزارهای سنتی مثل grep یا ripgrep در درک معنایی معماری پروژه و پدیدهای موسوم به Context Bloat (انفجار مصرف توکن).
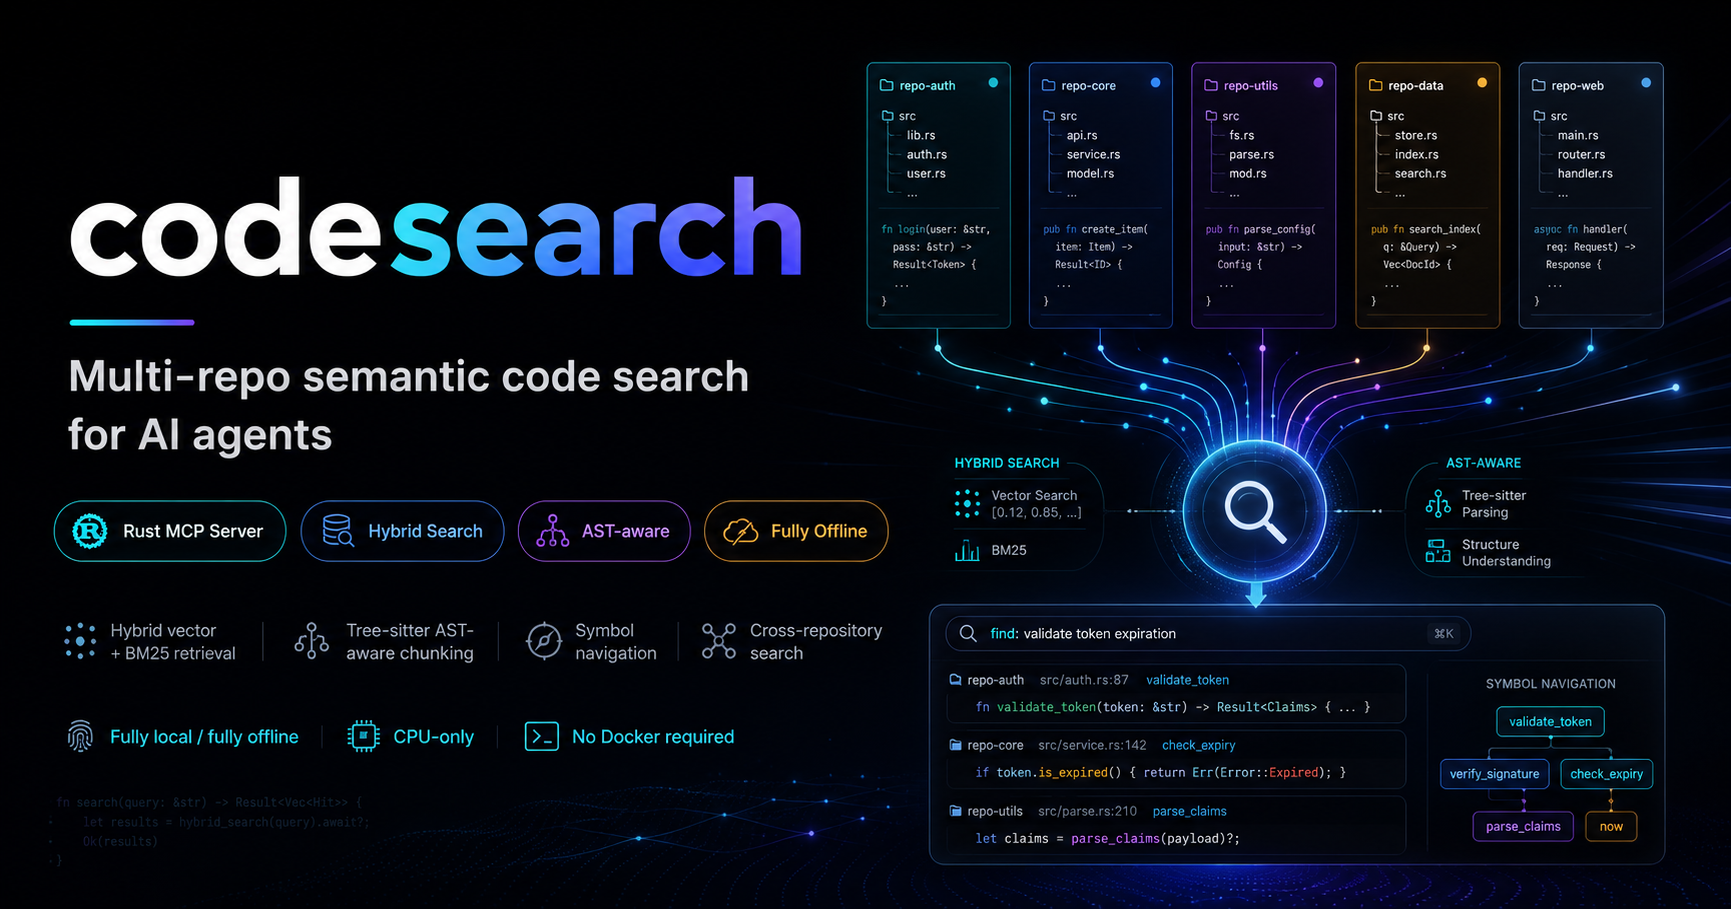
در این مقاله، به کالبدشکافی و راهنمای جامع ابزار متنباز و قدرتمند CodeSearch میپردازیم؛ یک سرور محلی Model Context Protocol (MCP) توسعهیافته با زبان Rust که با ترکیب جستجوی برداری (Vector Search) و متنی (BM25)، موتور نحو درختی (Tree-sitter AST) و ناوبری نمادها (Symbol Navigation)، تجربه کاربری ایجنتهای هوش مصنوعی را به سطحی بالاتر ارتقا میدهد.
grep و find) برای ایجنتهای AI شکست میخورند؟بسیاری از دستیاران هوش مصنوعی به صورت پیشفرض برای کاوش در پروژهها از دستورات خط فرمانی مانند grep، ripgrep یا find استفاده میکنند. این رویکرد در محیطهای عملیاتی با چالشهای زیر روبرو است:
عدم درک مفاهیم انتزاعی و مترادفها (Synonym Blindness): اگر شما از ایجنت بخواهید «نحوه مدیریت نرخ درخواستها (Rate Limiting) را پیدا کن»، ابزار grep به دنبال رشته تحتاللفظی rate_limiting میگردد. اگر نام تابع در پروژه throttleRequests یا TokenBucketFilter باشد، نتیجه صفر خواهد بود.
پدیده Context Bloat و هدررفت فاحش توکن: هنگامی که grep فایلهای احتمالی را برمیگرداند، ایجنت چارهای جز خواندن کل محتوای فایلها (cat file.ts) ندارد. خواندن چندین فایل چندصدخطی تنها برای یافتن یک تابع ۲۰ خطی، پنجره کانتکست مدل را اشباع کرده، هزینههای API را به شدت افزایش میدهد و باعث کاهش دقت (Hallucination) مدل میشود.
محدودیتهای راهکارهای ابری و گرافهای سنگین: ابزارهای Code-Graph ابری یا پایگاههای داده برداری سنگین معمولاً نیازمند کارت گرافیک اختصاصی (GPU)، کانتینرهای داکر حجیم، ارسال کدهای محرمانه به سرورهای ثالث و تنظیمات شبکه پیچیده هستند که در محیطهای محلی و پروکسیهای انترپرایز با چالش جدی مواجه میشوند.
پروژه CodeSearch یک سرور مستقل، سبک و فوقسریع بر پایه پروتکل MCP است که به صورت ۱۰۰٪ محلی و آفلاین روی CPU اجرا میشود. این ابزار از هیچ سرویس کلودی یا مدل رانتایم خارجی استفاده نمیکند و تمام فرآیند ایندکسینگ و بازیابی را در کسری از ثانیه انجام میدهد.
بازیابی هیبریدی (Hybrid Retrieval with RRF):
کدسرچ برای هر کوئری دو استراتژی مجزا را به صورت موازی اجرا میکند:
Dense Retrieval (برداری): تولید امبدینگهای متراکم با استفاده از مدلهای بهینه روی CPU (مانند FastEmbed با موتور ONNX Runtime نظیر nomic-embed-text-v1.5 یا bge-small-en-v1.5) و ذخیره در شاخص برداری arroy (موتور جستجوی نزدیکترین همسایگی ANN توسعه داده شده توسط تیم Meilisearch) روی پایگاهداده حافظهمحور LMDB.
Sparse Retrieval (متنی): جستجوی متنی پیشرفته بر اساس الگوریتم محبوب BM25 از طریق موتور قدرتمند Tantivy به همراه پشتیبانی از عبارات باقاعده (Regex) و تطابق دقیق شناسهها.
ترکیب رتبهبندی با Reciprocal Rank Fusion (RRF): نتایج بازیابی متنی و برداری با الگوریتم RRF ترکیب میشوند تا بالاترین دقت بازیابی معنایی و ساختاری حاصل شود.
قطعهبندی هوشمند با درخت نحو (Tree-sitter AST Chunking):
برخلاف سیستمهای سنتی RAG که فایلها را بر اساس تعداد خطوط تصادفی (مثلاً هر ۱۰۰ خط) برش میزنند، CodeSearch با استفاده از گرامر Tree-sitter ساختار واقعی کد در بیش از ۱۷ زبان برنامهنویسی را تحلیل میکند. قطعات (Chunks) دقیقاً بر مبنای توابع، کلاسها، متدها، بلوکهای مارکداون یا سلولهای ژوپیتر ساخته میشوند.
طراحی بهینه بر اساس صرفهجویی در توکن (Token-Efficient Design):
به صورت پیشفرض نتایج جستجو در حالت فشرده (compact=true) شامل شناسه قطعه (chunk_id)، مسیر فایل، شماره خطوط و امضای متد بازگردانده میشوند. ایجنت پس از ارزیابی متادیتا، تنها در صورت نیاز واقعی بدنه کد را با ابزار get_chunk دریافت میکند.
پشتیبانی بومی از چند مخزن (Multi-Repo & Federation):
قابلیت مدیریت دهها پروژه به صورت همزمان، گروهبندی مخازن و اتصال توزیعشده به سرورهای راه دور (Peer Federation) از طریق HTTPS و احراز هویت Bearer Token.
سرور CodeSearch مجموعهای از ابزارهای استاندارد MCP را در اختیار مدلهای هوش مصنوعی قرار میدهد:
نام ابزار MCP نوع کاربرد ورودیهای کلیدی خروجی و رفتار search جستجوی معنایی یا متنی query, mode, filter_path, language, compact ترکیب Vector + BM25 در حالت Semantic یا جستجوی Tantivy در حالت Literal find ناوبری و ردیابی نمادها symbol, kind (definition / usages / imports / dependents) یافتن تعاریف، مصارف و ارتباطات میان فایلها explore کاوش ساختاری فایل target, kind (outline / similar) دریافت لیست تمام توابع و کلاسهای یک فایل یا یافتن چانکهای مشابه get_chunk خواندن قطعه کد مشخص chunk_id, context_lines, project فراخوانی متن دقیق کد بر اساس شناسه بازگشتی با حداقل مصرف توکن find_impact تحلیل اثر تغییرات (Call Sites) symbol_name, file, line ردیابی تمامی نقاط فراخوانی با پروتکل SCIP (ویژه C# و TypeScript) status وضعیت ایندکس و متادیتا kind (index / projects) اطلاعات سلامت ایندکس، زبانهای پشتیبانیشده و لیست ریپوها
میتوانید آخرین نسخه اجرایی را متناسب با سیستمعامل خود مستقیماً از بخش Releases گیتهاب CodeSearch دانلود کرده و در مسیر $PATH قرار دهید:
# دانلود نسخه لینوکس x86_64 curl -sL https://github.com/flupkede/codesearch/releases/latest/download/codesearch-linux-x86_64.tar.gz | tar xz chmod +x codesearch sudo mv codesearch /usr/local/bin/ # بررسی نسخه codesearch --version
در صورتی که ابزارهای توسعه زبان Rust را روی سیستم دارید:
# کلون و کامپایل نسخه Release
git clone https://github.com/flupkede/codesearch.git
cd codesearch
cargo build --release

# انتقال باینری به مسیر اجرایی
sudo cp target/release/codesearch /usr/local/bin/
فرایند ایندکسگذاری در کدسرچ به صورت محلی و با سرعت خیرهکننده انجام میشود.
وارد دایرکتوری پروژه مورد نظر خود شوید و دستور زیر را اجرا کنید:
cd /path/to/my-project # ثبت و ایندکسگذاری کامل مخزن codesearch index add
دستور فوق پروژه را در فایل کانفیگ ~/.codesearch/repos.json ثبت کرده و پایگاهداده شاخص را ایجاد میکند.
به صورت پیشفرض مدل nomic-embed-text-v1.5 با کیفیت و سرعت عالی استفاده میشود. در صورت تمایل میتوانید مدل مورد نظر را مشخص کنید:
codesearch index --model nomic-embed-text-v1.5
.codesearchignore)مشابه .gitignore، میتوانید فایلی با نام .codesearchignore در ریشه مخزن بسازید تا دایرکتوریهای بیلد، لاگها یا داکیومنتهای حجیم ایندکس نشوند:
# .codesearchignore
dist/
build/
coverage/
*.min.js
legacy/
کدسرچ میتواند به دو شیوه در اختیار ایجنتها قرار گیرد:
حالت محلی (Local Stdio Mode): اجرای مستقیم codesearch mcp به عنوان یک سابپراسس توسط کلاینت.
حالت سرور مرکزی (Serve HTTP Mode): اجرای دائم codesearch serve با داشبورد TUI و پشتیبانی همزمان از چندین مخزن.
فایل تنظیمات MCP کلاینت کلود را در مسیر ~/.config/claude-code/config.json (یا claude_desktop_config.json) باز کرده و سرور کدسرچ را اضافه کنید:
{
  "mcpServers": {
    "codesearch": {
      "command": "codesearch",
      "args": ["mcp"]
    }
  }
}
اگر سرور چندمخزنه را از قبل با دستور codesearch serve اجرا کردهاید، از آرگومان کلاینت استفاده کنید:
{
  "mcpServers": {
    "codesearch": {
      "command": "codesearch",
      "args": ["mcp", "--mode", "client"]
    }
  }
}
در فایل ~/.config/opencode/config.json:
{
  "mcp": {
    "codesearch": {
      "type": "local",
      "command": ["codesearch", "mcp"],
      "enabled": true
    }
  }
}
یا اتصال از طریق ریموت HTTP در حالت Serve:
{
  "mcp": {
    "codesearch": {
      "type": "remote",
      "url": "http://127.0.0.1:39725/mcp",
      "enabled": true
    }
  }
}
در ادیتور Cursor یا محیطهای مشابه، میتوانید در بخش MCP Servers دستور codesearch mcp را اضافه کنید. همچنین جهت ملزم کردن مدل به استفاده از این موتور به جای ابزارهای کند، دستورالعمل زیر را در فایل AGENTS.md یا .cursorrules پروژه قرار دهید:
# Agent Code Search Policy
- For finding implementations, tracing flows, or symbol usages, always prefer `codesearch` MCP tools (`search`, `find`, `explore`, `get_chunk`).
- Avoid running raw `grep` or full-file reads unless dealing with trivial single-line edits or exact literal matches in a single known file.
- When calling `search`, inspect metadata with `compact=true` first, then fetch exact code chunks via `get_chunk(chunk_id)`.
برای تیمهای توسعه و محیطهای چندسرویسی، اجرای کدسرچ در حالت سرور مستقل بهترین بازدهی را دارد:
codesearch serve
این فرمان یک رابط کاربری ترمینالی جذاب (Ratatui TUI Dashboard) را باز میکند که وضعیت شاخص مخازن، تعداد چانکها، ترافیک کوئریها و وضعیت واچرهای فایل را به صورت لایو نمایش میدهد.
┌── CodeSearch Hub (Port 39725) ────────────────────────────────────────────────────────┐
│ [auth-service]      Indexed: 1,420 chunks  │ Watcher: Active   │ RAM: 142 MB           │
│ [payment-gateway]   Indexed: 3,890 chunks  │ Watcher: Active   │ RAM: 210 MB           │
│ [frontend-core]     Indexed: 5,120 chunks  │ Watcher: Idle     │ RAM: 180 MB           │
├───────────────────────────────────────────────────────────────────────────────────────┤
│ Active Queries: 2 | Total Invocations: 1,489 | Cache Hit Rate: 94.2%                  │
└───────────────────────────────────────────────────────────────────────────────────────┘
میتوانید مخازن مرتبط را در گروههای اختصاصی دستهبندی کنید تا ایجنت بتواند در سطح کل یک دامنه کسبوکار به جستجو بپردازد:
# ایجاد گروه میکروسرویسهای مالی codesearch group add fin-services auth-service payment-gateway billing-api # جستجوی معنایی همزمان در تمام سرویسهای مالی codesearch search "handle idempotent refund" --group fin-services
شاخص فنی دستورات سنتی (grep / rg) ابزارهای ابری و گرافهای سنگین CodeSearch MCP درک معنایی کانسپتها ندارد (فقط تطابق رشته) دارد کامل (ترکیب Vector ANN + BM25) سرعت پاسخدهی بسیار بالا متغیر (وابسته به شبکه و ابر) فوقالعاده بالا (زیر ۲۰ میلیثانیه) مصرف منابع سیستم بسیار کم سنگین (GPU / چند گیگابایت رم) بسیار سبک (CPU Only / چندصد مگابایت) میزان مصرف توکن ایجنت بسیار زیاد (بارگذاری کل فایل) متوسط حداقلی با مکانیزم compact و get_chunk امنیت و حریم خصوصی ۱۰۰٪ محلی نیازمند خروج کد از زیرساخت ۱۰۰٪ محلی، ایزوله و آفلاین پروتکل ارتباطی Stdio CLI API اختصاصی پروتکل استاندارد MCP
ورود به عصر توسعه مبتنی بر ایجنت (Agentic Software Development) نیازمند بازطراحی ابزارهای پیرامونی هوش مصنوعی است. تکیه بر دستورات دهههای گذشته نظیر grep، پتانسیل مدلهای زبانی را در گرداب مصرف بیهوده توکن و گمراهی در معماری غرق میکند.
ابزار CodeSearch با بهرهگیری از قدرت و حافظه امن زبان Rust، ترکیب هوشمندانه پایگاه داده برداری متراکم و شاخص متنی BM25 و انطباق کامل با پروتکل استاندارد MCP، زیرساختی ایدهآل، رایگان و بدون دغدغه ابری را برای توسعهدهندگان و معماران نرمافزار فراهم ساخته است.
✍️ درباره نویسنده:
برای مطالعه مقالات تخصصی بیشتر در حوزههای SRE، دیتابیس، لینوکس و ابزارهای Agentic AI، میتوانید به وبسایت من به نشانی amirimatin.ir مراجعه کنید.

