
فریمورک LangChain یک فریمورک محبوب برای ساخت اپلیکیشنهای مبتنی بر مدلهای زبانی بزرگ است. مثلاً اگر بخواهید یک چتبات بسازید که به پرسشهای معمول کاربران وبسایتتان پاسخ میدهد، میتوانید از componentهائی که LangChain در اختیارتان قرار میدهد برای توسعه و دیباگ کردن راحتتر استفاده کنید.
در این مقاله به اختصار و با مثال، با طرز کار و قابلیتهای LangChain آشنا میشویم.
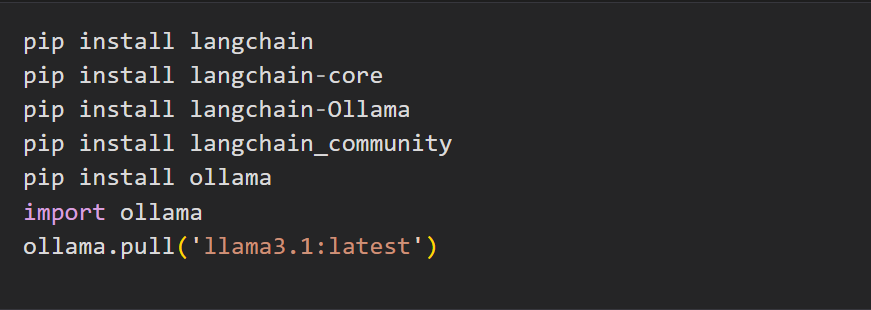
برای استفاده از LangChain، علاوه بر نصب کتابخانههای مرتبط با آن، به یک مدل زبانی هم نیاز دارید. برای این مقاله از Ollama استفاده میکنیم. Ollama ابزاری است که به شما امکان دانلود و کار کردن با مدلهای زبانی رایگان open-source مثل Llama3 را در سیستم خودتان میدهد. میتوانیم از دستورات زیر برای نصب کتابخانههای LangChain و Ollama و دانلود مدل زبانی llama3 نسخه ۸ میلیارد پارامتری استفاده کنیم.
برای کار با LangChain باید مولفههای مختلف آن را به ترتیب فراخوانی در workflow اپلیکیشن، در قالب یک زنجیر به هم وصل کنید. هر مولفه مسئولیت خاصی دارد، مثلاً ساخت prompt، کوئری زدن به یک مدل زبانی یا parse کردن خروجی. این زنجیر با مولفهای که اول از همه ورودی کاربر را میگیرد شروع میشود، بعد مولفهای که روی خروجی مرحله قبلی پردازش انجام میدهد میآید و ... . با یک مثال همه چیز روشن میشود.
فرض کنید میخواهیم با کمک یک مدل زبانی، یک واژهنامه بسازیم که هر کلمه را به زبانی ساده و در یک جمله تعریف کرده است! برای این کار اول از همه باید شکل خروجی مورد انتظار کاربر و ورودی او را مشخص کنیم.
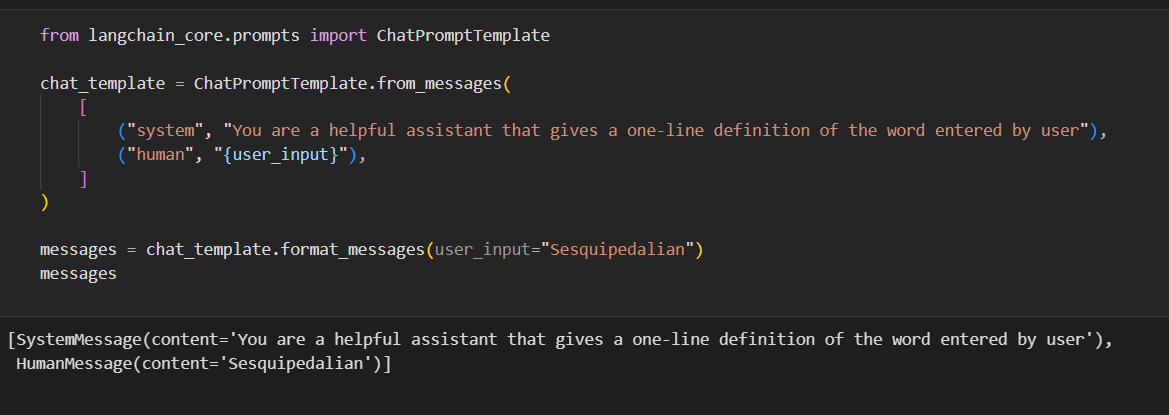
در مثال بالا مولفه ChatPromptTemplate برای منظور گفته شده، یک پرامپت تعریف میکند که به صورت دینامیک با ورودی کاربر (در user_input) تکمیل میشود. در مثال از متد from_messages استفاده شده که از دنبالهای از پیامها همراه با معرف/نقش هر پیام، یک template میسازد. نقش system برای تنظیم شکل و محتوای پاسخی که از LLM انتظار داریم استفاده شده است و نقش human برای مشخص کردن ورودی کاربر. با این متد میتوان پیشینه سوال و جواب بین مدل زبانی و کاربر را هم مشخص کرد. در این صورت برای پاسخهای مدل زبانی از نقش AI استفاده میکنیم. در مثال بالا نقش دستیاری که کلمات مطلوب کاربر را برای او در یک جمله تعریف میکند به مدل زبانی دادهایم. در ادامه نشان دادهایم که وقتی کلمه sesquipedalian را کاربر وارد میکند، پرامپت نهایی چه شکلی میشود. مولفه ChatModel در ادامه برای کوئری زدن به مدل زبانی استفاده میشود.
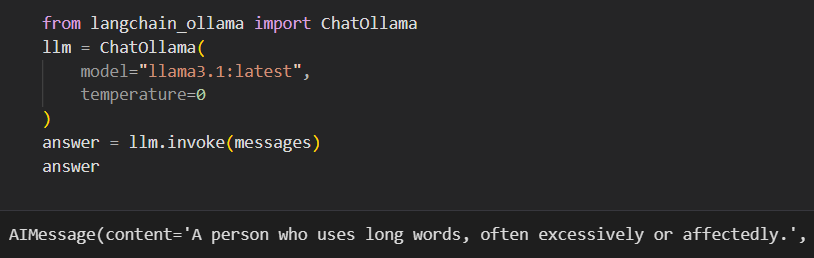
از مدل llama3.1 که دانلود کردیم برای ساخت ChatModel استفاده کردیم. کلاس Chatmodel با توجه به provider مدل زبانی فرق میکند و اینجا چون provider مورد استفاده Ollama هست، از ChatOllama استفاده شده است. در این مولفه میتوان پارامترهای مدل زبانی مثل temperature را هم تعریف کرد. در مثال بالا با کمک متد invoke به مدل زبانی کوئری میزنیم تا جواب کاربر را بگیریم. در خروجی مدل زبانی، علاوه بر جواب مدل زبانی چیزهای دیگری مثل response_metadataهست که درباره مدل استفاده شده، زمان تولید جواب و ... توضیح میدهد. اگر بخواهیم فقط جواب کاربر را نمایش دهیم نیاز به مولفه دیگری برای جدا کردن content از خروجی مدل (AIMessage) داریم:
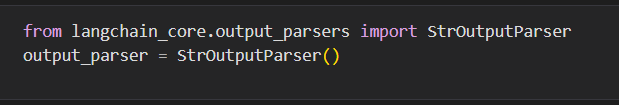
مولفه Output Parser میتواند پردازشهای پیچیدهتر مثل تولید فایل JSON هم انجام دهد اما برای ساده نگهداشتن مثال از StrOutputParser استفاده کردیم.
در محصول نهایی میخواهیم همه این مولفهها به ترتیبی که در مثالها آمد روی ورودی کاربر عمل کنند. بنابراین Chain زیر را میسازیم. برای گرفتن خروجی از Chain مثل LLM از متد invoke استفاده میشود.
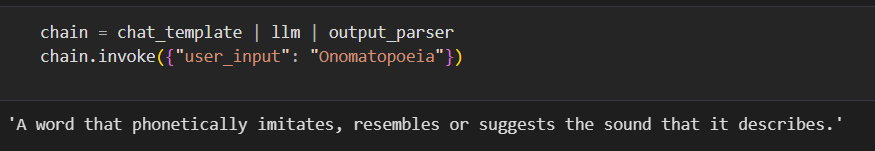
مثالی که زده شد، از عمد ساده نگه داشته شد. ممکن است بخواهیم اپلیکیشنی بسازیم که پیچیدهتر است. مثلاً میدانیم اطلاعات یک مدل زبانی، خصوصاً یک مدل زبانی open-source شاید برای پاسخگویی به سوالات تخصصی کافی نباشد و شاید اپلیکیشنی بخواهیم بسازیم که میتواند با توجه به اطلاعات ورودی (مثلاً یک اطلاعات فایل pdf یا محتوای html یک وبسایت) به سوال کاربر پاسخ دهد، یا اصطلاحاً Retrieval Augmented Generation انجام دهد. شاید هم بخواهیم کارهای ساده اینترنتی مثل رزرو هتل را اتوماتیک کنیم. در این صورت باید به مدل زبانی قابلیت استفاده از ابزار (tool calling) را بدهیم. فریمورک LangChain برای این کاربردهای پیشرفتهتر هم میتواند به ما کمک کند!
در ادامه بدون پرداختن به جزئیات واضح، با چند مثال در کد این قابلیتها را نشان دادهایم.
مثال اول یک اپلیکیشن RAG است. در این مثال میخواهیم از یک متن درباره langchain برای پاسخدهی به یک سوال درباره نمایش برداری متن (embedding) و LangChain استفاده کنیم.
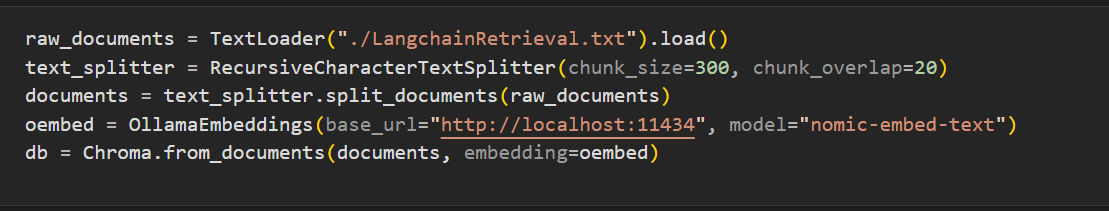
در اینجا اطلاعات خام ورودی را به قطعات کوچکتری متن تقسیم کردهایم. سپس هر قطعه را به یک یک بردار تبدیل کردهایم که در فضایی عددی «اطلاعات» یا «معنی» هر قطعه را به صورت عددی نمایش میدهد. مزیت این کار این است که میتوان با محاسبه میزان شباهت دو بردار، میزان مرتبط بودن متنی که نمایش میدهند را به دست آورد. این بردارها را در یک دیتابیس برداری ذخیره میکنیم. وقتی کاربر به بخشی از اطلاعات متن ورودی نیاز داشت به جای بررسی کل آن، بخشهایی از آن را که به آن نیاز دارد را میتوانیم با جستجو در دیتابیس به دست بیاوریم و همانها را به مدل زبانی بخورانیم تا با توجه به آنها جواب دهد. چرا این کار خوب است؟ چون هرچه ورودی مدل زبانی کوتاهتر باشد، در خروجی پاسخ بهتری میتواند تولید کند؟ چرا؟ چون هر مدل زبانی هم محدودیت در حجم متن ورودی دارد (context length) و هم اینکه هرچه متنی که پردازش میکند طولانیتر باشد احتمال اینکه بعضی اطلاعات آن را فراموش کند بیشتر میشود. در کدی که در ادامه آمده نشان دادهایم چطور میتوان از دیتابیس برداری مورد اشاره برای پاسخ به سوالات کاربر استفاده کرد.
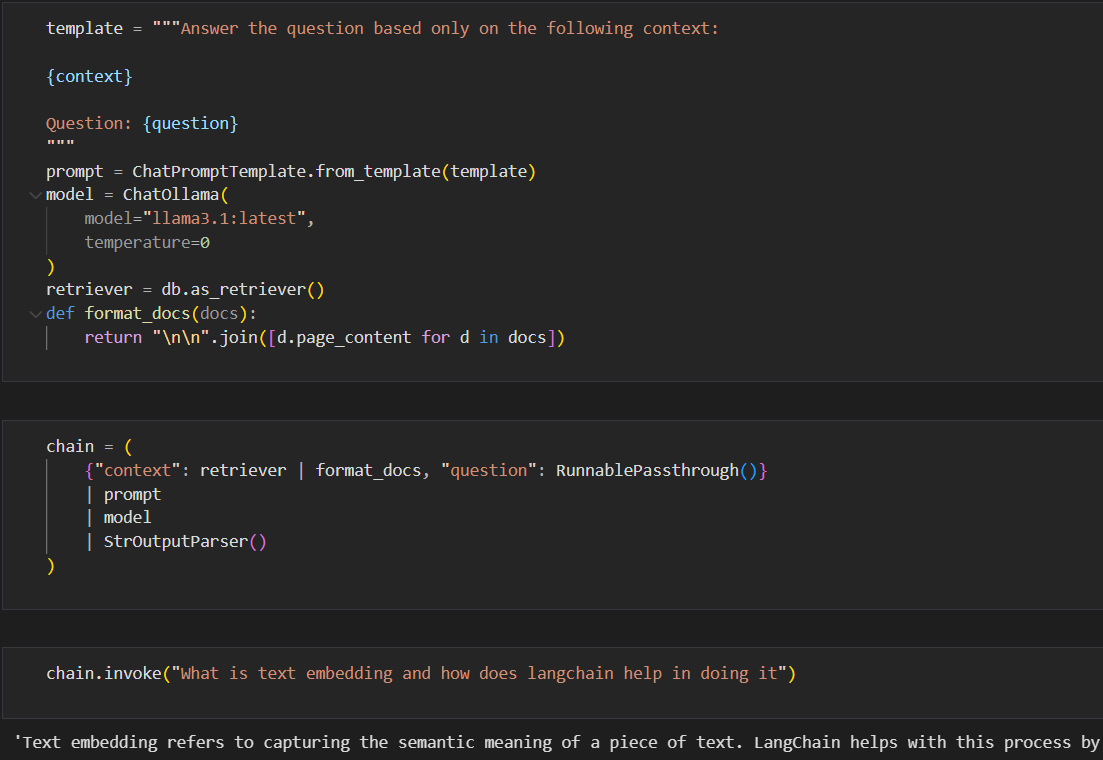
سوال پرسیده شده و خروجی کامل مدل زبانی در زیر آمده است.
'What is text embedding and how does langchain help in doing it?'
'Text embedding refers to capturing the semantic meaning of a piece of text. LangChain helps with this process by providing integrations with over 25 different embedding providers and methods, which enables users to quickly and efficiently find other pieces of text that are similar.'
مدل llama3.1:8b در دیتای آموزش خود مطمئناً اطلاعات زیادی درباره LangChain نداشته و نمیتوانست تنها با تکیه به اطلاعات خودش به سوالی که پرسیدیم پاسخ دهد.
مثال دوم که مثال آخر است، یک اپلیکیشن با tool calling میباشد. در اینجا میخواهیم با کمک Wikipedia و جستجو در اینترنت با کمک DuckDuckGo به سوالهای کاربر پاسخ دهیم.
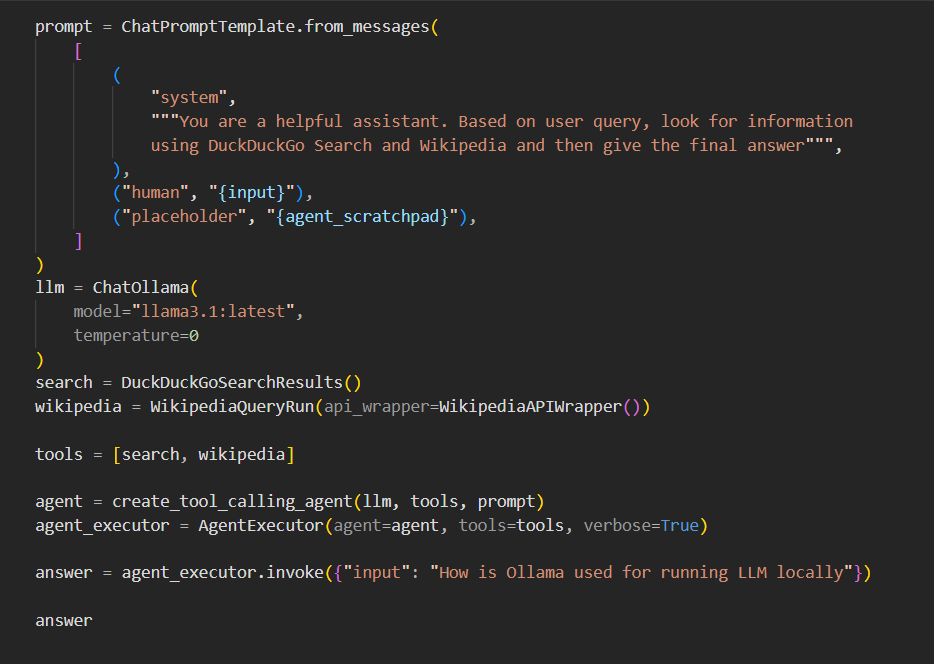
ابزارهای استفاده شده در این مثال به صورت پیشفرض در LangChain تعریف شدهاند اما LangChain به کاربر امکان تعریف ابزارهای دلخواه (Custom) هم میدهد که قابلیت بسیار جذابی است!
از توجه شما متشکرم و امیدوارم این مقاله کوتاه در جهت آشنایی شما با تواناییهای فریمورک LangChain مفید بوده باشد.

