
برای فهمیدن ژئوپلیتیک، شاید سؤال درست این نباشه که «چه اتفاقی قراره بیفته؟» سؤال عمیقتر اینه: اگر کشورها خودشون در حال یادگیری، سازگاری و تغییر استراتژی باشن، اصلاً چقدر میتونیم رفتارشون رو پیشبینی کنیم؟
و یه سؤال حتی جذابتر: اگر فرضیات یک تحلیلگر ژئوپلیتیک رو به چند عامل یادگیرنده بدیم، چه چیزی از دل بازی بیرون میاد که خود تحلیلگر پیشبینی نکرده؟
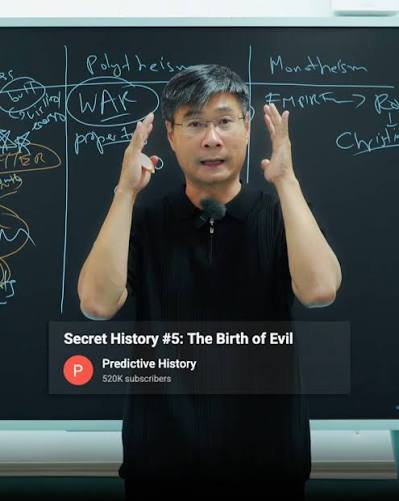
اینجاست که Jiang Xueqin برای من جالب میشه. او با ترکیب تاریخ، نظریه بازیها و فلسفه، تلاش میکند چیزی فراتر از تحلیل روزمره بسازد: چارچوبی برای فهم اینکه چرا دولتها در شرایط عدمقطعیت، اطلاعات ناقص و منافع متضاد، دست به انتخابهای خاصی میزنند.
اما یه نکته مهم وجود داره. جذابیت یه چارچوب تحلیلی لزوماً به معنای اعتبار پیشبینیهای آن نیست. محتوای ژئوپلیتیک وقتی وارد شبکههای اجتماعی میشه، با روایتپردازی، انتخاب مثالهای جذاب و سوگیریهای مخاطب ترکیب میشه. بنابراین باید بین قدرت توضیح یه مدل و دقت پیشبینی آن تفاوت قائل بشیم.
فرض کن تاریخ یک اتاق تاریکه. هر تحلیلگر یک نورافکن داره، اما نورش ناقصه. چیزی که میبینیم، به جایی که نور انداختهایم بستگی داره.
در ژئوپلیتیک، یک مشکل دیگر هم داریم: وقتی پیشبینی علنی میشود، ممکن است خودش بخشی از بازی شود.
جیانگ (Jiang Xueqin) با کانال Predictive History سعی کرده تو این اتاق تاریک نقشهای بکشه. معلم تاریخ و فلسفه تو Moonshot Academy پکنه، فارغالتحصیل Yale، و با ترکیب نظریه بازیها، تاریخ و فلسفه چارچوبی به اسم «تاریخ پیشبینانه» ساخته. از یه طرف آموزگاره، از طرف دیگه متخصص غیررسمی و خبرنگار شبکههای اجتماعی. این دوگانگی هویتش هم جذابش میکنه هم ارزیابی اعتبار علمیش رو پیچیده.
اما سؤال اصلی این نیست که «آیا جیانگ درست میگه؟» سؤال اینه: آیا اصلاً میشه تو این اتاق نقشهای کشید که خودش اتاق رو تخریب نکنه؟
کشورها بازیکنان شطرنج نیستند؛ آنها عاملهای یادگیرندهای (Learning Agents) هستند که در یک بازی تکرارشونده و نامتقارن گیر افتادهاند. تفاوتشان با شطرنج در این است که:
قوانین بازی ثابت نیست،
تخته بازی بزرگ میشود،
و هر بازیکن همزمان هم قانونگذار است و هم قانونشکن.
🇺🇸 آمریکا: بازیکنِ حفظکنندهٔ وضع فعلی
اگر در مدل، حفظ نظم موجود، اعتبار تعهدات، امنیت دریایی و نفوذ اقتصادی را وزن بالایی بدهیم، آمریکا به بازیکنی تبدیل میشود که برای عقبنشینی از تعهداتش هزینه میپردازد؛ چون از دست دادن اعتبار بازدارندگی میتواند هزینههای آینده را افزایش دهد.
🇮🇷 ایران: بازیکن فرسایشی و نامتقارن
اگر تو مدل، بقا و افزایش هزینه طرف مقابل رو وزن بالایی بدیم، ایران به بازیکنی تبدیل میشه که نابرابری قدرت رو با افزایش زمان و هزینه بازی تا حدی جبران میکنه.
🇷🇺 روسیه: بازیکنِ عمق استراتژیک
اگر در مدل، عمق استراتژیک، کاهش نفوذ رقبای خارجی و حفظ حوزهٔ نفوذ پیرامونی را وزن بالایی بدهیم، روسیه به بازیکنی تبدیل میشود که افق زمانی بلندتری را دنبال میکند و برای حفظ گزینههای ژئوپلیتیکی آینده حاضر است هزینههای کوتاهمدت بیشتری بپردازد.
در این مدل، ایران میتواند برای روسیه نه صرفاً یک متحد، بلکه بخشی از مسیرهای ارتباطی و موازنهٔ قدرت در جنوب باشد.
🇨🇳 چین: بازیکنِ بیشینهساز بلندمدت
اگر در مدل، رشد اقتصادی، امنیت انرژی، ثبات محیط خارجی و افزایش تدریجی قدرت نسبی را وزن بالایی بدهیم، چین به بازیکنی تبدیل میشود که ترجیح میدهد بدون ایجاد شوکهای بزرگ، فضای استراتژیک خود را در طول زمان گسترش دهد.
وابستگی چین به انرژی وارداتی و اهمیت ثبات خاورمیانه نیز میتواند باعث شود که در بسیاری از سناریوها، حفظ یک تعادل ناپایدار را به یک بیثباتی کنترلنشده ترجیح دهد.
در این مدل، زمان خودش به یک منبع قدرت تبدیل میشود.
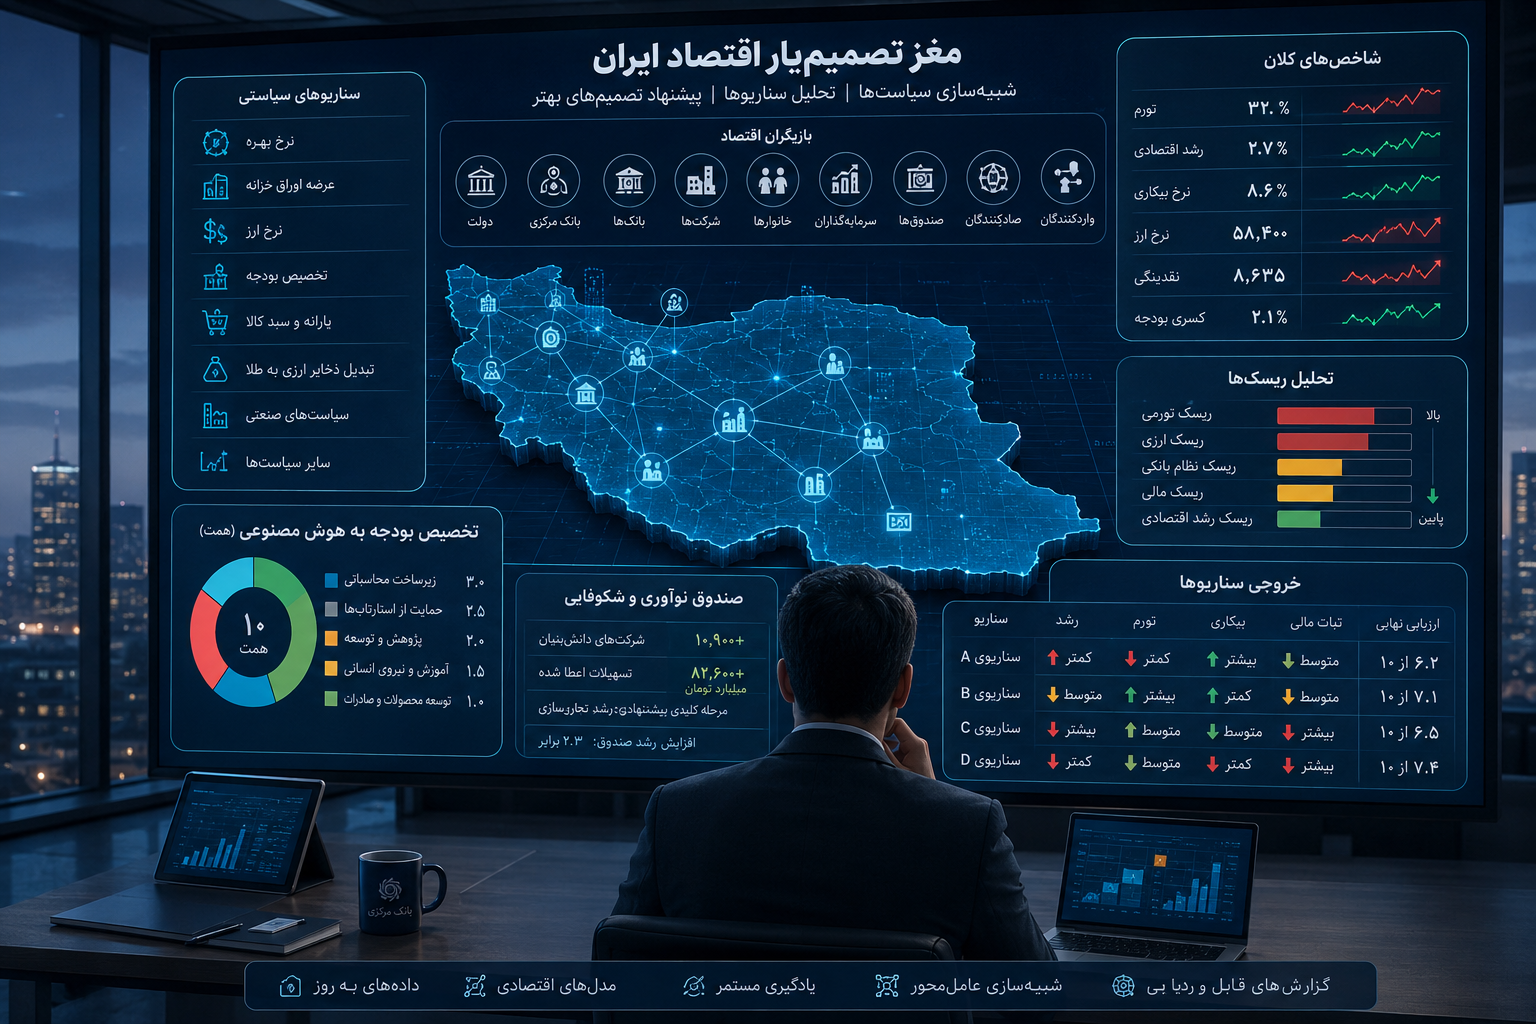
اینجا وارد متاگیم میشیم. بازی واقعی، بازیایه که درباره بازی فکر میکنی.
۱. بازیهای بیزی با اطلاعات ناقص هر کشور نوع خودش رو میشناسه، اما نوع حریف رو فقط با احتمال پسین تخمین میزنه. وقتی چین به تایوان نگاه میکنه، نه به خود تایوان، بلکه به «باور آمریکا درباره باور چین درباره آمریکا» نگاه میکنه. این باورهای مرتبه بالاتر بحرانی میسازه.
۲. تعادل نش با دست لرزان تو دنیای واقعی، حتی اگه بازیکنان تقریباً عقلانی باشن، خطا، نویز اطلاعاتی و اشتباه محاسباتی میتونه مسیر بازی رو تغییر بده. نظریه بازی ابزارهایی مثل تعادل دستلرزان رو برای بررسی پایداری تعادلها در برابر خطاهای کوچک ارائه میده.
۳. نقاط شلینگ و تعهد استراتژیک تنگه هرمز یه نقطه شلینگ طبیعیه: همه میدونن که همه میدونن که کنترلش مهمه. اما تعهد (مثل استقرار ناوگان) یه حرکت غیرقابلبرگشته که فضای استراتژیک رو عوض میکنه. گاهی باید خودت رو تو موقعیتی بذاری که عقبنشینی سختتر از جنگ باشه.
۴. بازی تکرارشونده و قضیه فولک تو بازیهای تکرارشونده، اگه بازیکنان آینده رو بهاندازه کافی مهم بدونن، مجموعهای از نتایج پایدار میتونه از طریق تهدید به تنبیه، همکاری و اعتبار شکل بگیره. آمریکا اگه امروز از تعهدش بگذره، فردا هزینهاش رو تو هر میز مذاکرهای میپردازه. بازدارندگی نه فقط به خاطر قدرت، بلکه به خاطر باور به قدرت کار میکنه.فرمول سودمندی:
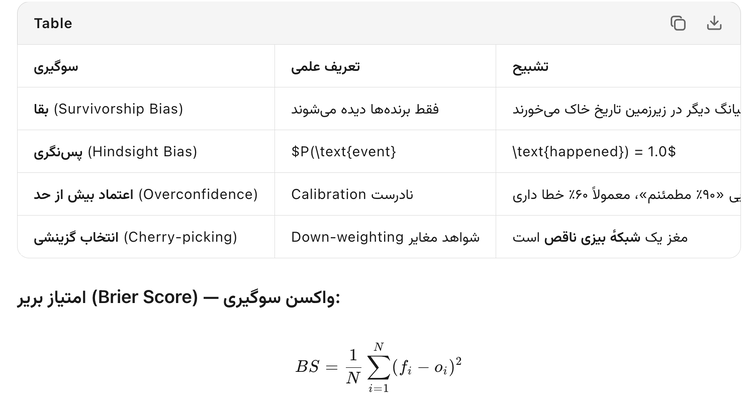
پیشبینیگری یه بازاره و تو هر بازاری ناکارآمدی اطلاعاتی وجود داره. سوگیریها ویروسهایی هستن که سیستم ایمنی شناختی ما رو فلج میکنن:
سوگیری بقا: فقط برندهها رو میبینیم.
سوگیری پسنگری: بعد از وقوع همه چیز واضح به نظر میرسه.
اعتمادبهنفس بیش از حد و انتخاب گزینشی شواهد.
نادیده گرفتن احتمالهای شرطی و سناریوهای جایگزین.
پیشبینی خوب باید قبل از وقوع قابل ارزیابی باشه: با timestamp، احتمال مشخص و امتیازدهی خارجی (مثل Brier Score). پیشبینیکننده خوب کسیه که کالیبره باشه؛ وقتی میگه ۷۰٪، واقعاً ۷ بار از ۱۰ بار درست بگه.
جیانگ چند تا پیشبینی درست درآورده، اما این «انتخاب موفق» خطرناکه. مدل معتبر باید بتونه ناموفقیتهای خودش رو هم پیشبینی کنه.
هر تلاش پیشبینی روی سه فرضیه اصلی سوار میشه:
عقلانیت عاملها: بازیکنان اهدافشون رو بهینه میکنن. اما تو بحرانها ایدئولوژی و نفسطلبی غالب میشه.
ثبات ساختارهای قدرت: چرخهها و بازیهای تکرارشونده وجود دارن. اما تو دورههای تغییر ساختاری (مثل پایان امپراتوریها) قوانین عوض میشه.
قابلیت مدلسازی: تعاملات پیچیده رو میشه تو یه بازی سادهشده مدل کرد. اما رفتارهای نوظهور و محدودیتهای شناختی مرز ایجاد میکنن.
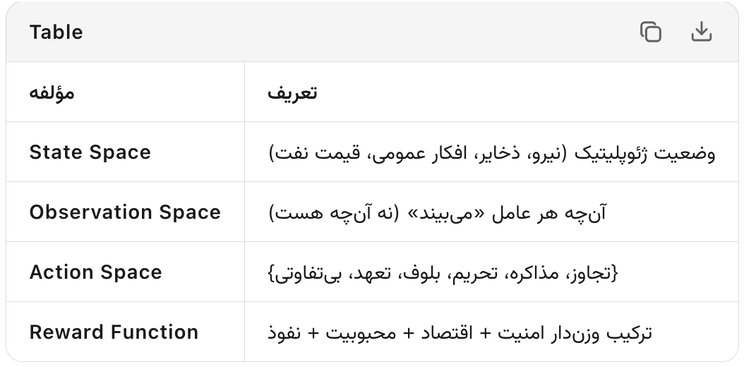
اینجاست که یادگیری تقویتی عمیق (DRL) و شبیهسازی مبتنی بر عامل (ABM) وارد میشن. میتونیم کشورها رو Agent کنیم:
هر Agent یه شبکه عصبی عمیق داره که تصمیم میگیره (اتحاد، تحریم، جنگ، مذاکره).
محیط شامل قدرت پویا، اتحادها، منابع و اطلاعات ناقص میشه.
توابع پاداش مستقیم فرضیههای جیانگ رو زنده میکنن: پاداش قدرت، امنیت، محدودیت (پرهیز از جنگ هستهای)، ایدئولوژی و اطلاعات.
الگوریتمهایی مثل Multi-Agent RL، Fictitious Play و Nash Q-Learning اجازه میدن Agentها در برابر هم یاد بگیرن.
US / China / Russia / Iran
و هرکدام فقط این پنج Action را دارند:
Negotiate / Sanction / Escalate / Ally / De-escalate
و هر Agent اینها را نمیداند:
تابع مطلوبیت واقعی دیگری
میزان تحمل هزینه دیگری
اطلاعات خصوصی دیگری
استراتژی یادگیری دیگری
«۱۰هزار بار شبیهسازی میکنیم؛ نه برای اینکه آینده را پیدا کنیم، بلکه برای اینکه ببینیم تحت چه فرضهایی، الگوهای پایدار یا رفتارهای نوظهور ظاهر میشوند.»
آیا روسیه و چین بدون اینکه ما به آنها بگوییم متحد شوند، تحت برخی فرضیات به سمت یک تعادل همکاری پایدار حرکت میکنند؟
ما نمیتونیم آینده رو «ببینیم». اما میتونیم فضای احتمالات رو فشردهتر کنیم. مدلسازی ژئوپلیتیک مثل هواشناسیه: نه برای پیشبینی دقیق بارش ساعت ۱۴:۳۲، بلکه برای هشدار طوفان.چالشهای یادگیری:
Non-stationarity: وقتی همه همزمان یاد میگیرند، محیط ثابت نیست.
Credit Assignment: در جنگ، کدام حرکت باعث پیروزی شد؟
Explore vs. Exploit: آیا استراتژی جدید امتحان کنی یا از ثبات استفاده کنی؟
جیانگ نه پیشگو، بلکه مدلسازه. ارزش کارش نه تو «درستی مطلق»، بلکه تو ساختاردهی به ابهامه. اصول Superforecasting (تجزیه تحلیلی، بهروزرسانی بیزی، تنوع شناختی و ارزیابی خارجی) هنوز بهترین راهنمان.
پارادوکس نهایی اینه: هرچه مدل وارد حلقه تصمیمگیری عاملها شود، پیشبینی سختتر میشود؛ چون خودِ پیشبینی میتواند به بخشی از محیط تبدیل شود.
«اگر فرضیات این مدل را به عاملهای یادگیرنده بدهیم، چه رفتارهایی بهصورت نوظهور ظاهر میشوند؟»
پارادوکس نهایی: هرچه مدلسازی دقیقتر شود، عاملها آگاهتر میشوند؛ و هرچه آگاهتر شوند، رفتارشان غیرقابلپیشبینیتر. مدل کامل، مدلی است که خودش را نابود کند.
اگه این اپیزود رو ندیدی، حتماً ببین:
[Professor Jiang: Is World War 3 Is About To Begin? – The Diary Of A CEO](https://www.youtube.com/watch?v=BTJGr78-zyw)
این مقاله با کمک ابزارهای هوش مصنوعی زیر ساخته است:
Gemini, Qwen studio, Kimi, Grok, ChatGPT

