
سالهاست سازمانها برای تصمیمگیری بهتر، داده جمع میکنند، انبار داده میسازند، سامانههای هوش تجاری راهاندازی میکنند و دهها یا حتی صدها داشبورد مدیریتی در اختیار مدیران قرار میدهند. اما یک تناقض جالب وجود دارد: با وجود اینکه امروز سازمانها بیش از هر زمان دیگری داده در اختیار دارند، بسیاری از تصمیمهای مهم هنوز با ترکیبی از تجربه، جلسه، فایلهای اکسل و حدس گرفته میشوند. شاید مشکل دیگر کمبود داده نباشد؛ شاید مسئله اصلی فاصلهای باشد که هنوز میان «داده» و «تصمیم» وجود دارد.
فرض کنید مدیر یک سکوی بزرگ تجارت الکترونیکی هستید. صبح وارد داشبورد میشوید و میبینید فروش نسبت به ماه گذشته ۱۲ درصد کاهش پیدا کرده است. داشبورد به شما میگوید چه اتفاقی افتاده، اما سؤال بعدی شروع میشود: چرا؟ تیم تحلیل بررسی میکند و متوجه میشود بیشتر این کاهش مربوط به سه محصول خاص است. حالا سؤال دیگری مطرح میشود: چرا فروش این سه محصول کاهش پیدا کرده؟ مشخص میشود موجودی آنها در چند مرکز توزیع پایین آمده است. چرا موجودی پایین آمده؟ پیشبینی تقاضا خطا کرده و سفارش تأمین با تأخیر انجام شده است. حالا بعد از چند ساعت تحلیل به مهمترین سؤال میرسیم: چه کاری باید انجام دهیم؟
به نظرم این همان نقطهای است که نسل بعدی هوش تجاری از نسل قبلی جدا میشود. هوش تجاری سنتی عمدتاً برای پاسخ به سؤال «چه اتفاقی افتاد؟» ساخته شد. سپس ابزارهای تحلیلی تلاش کردند به سؤال «چرا اتفاق افتاد؟» پاسخ دهند و یادگیری ماشین و مدلهای پیشبینی قدم بعدی را برداشتند و پرسیدند «احتمالاً چه اتفاقی خواهد افتاد؟». اما هنوز یک سؤال مهم باقی مانده است: «با توجه به شرایط موجود، چه تصمیمی باید بگیریم؟» این سؤال دیگر صرفاً مسئله گزارشگیری یا پیشبینی نیست؛ مسئله تصمیمگیری است.
این تغییر در تعریف مسئله، به نظرم یکی از مهمترین اتفاقات سالهای اخیر در حوزه داده و هوش مصنوعی است. در ادبیات جدید، مفاهیمی مانند «هوش تصمیمیار» و «معماری هوشمند انتخاب» دقیقاً به همین سمت اشاره دارند: سامانهای که فقط اطلاعات را نمایش نمیدهد، بلکه میتواند گزینههای مختلف را شناسایی کند، پیامدهای آنها را مقایسه کند، عدم قطعیت را در نظر بگیرد و تصمیمگیرنده را در انتخاب میان گزینهها یاری دهد. در واقع ارزش داده زمانی آزاد میشود که بتواند فاصله میان مشاهده یک اتفاق و واکنش مناسب به آن را کاهش دهد.
برای مثال همان مدیر تجارت الکترونیکی را دوباره در نظر بگیرید. یک داشبورد سنتی ممکن است نشان دهد هزینه ارسال ۱۴ درصد افزایش یافته است. یک لایه تحلیلی میتواند مشخص کند که بخش بزرگی از این افزایش مربوط به سه منطقه خاص است. یک مدل پیشبینی میتواند هشدار دهد که اگر روند فعلی ادامه پیدا کند، هزینه ماه آینده نیز افزایش خواهد یافت. اما یک سامانه تصمیمیار میتواند یک قدم جلوتر برود و بگوید سه گزینه در اختیار دارید: افزایش ظرفیت ناوگان، تغییر تخصیص سفارشها میان مراکز توزیع یا تغییر سیاست ارسال برای بخشی از مشتریان. سپس میتواند هزینه، اثر احتمالی بر زمان تحویل، رضایت مشتری و ریسک هر گزینه را کنار هم قرار دهد. در این حالت هوش مصنوعی جای مدیر را نگرفته است؛ کاری کرده که مدیر بتواند مسئله را با اطلاعات بیشتر و در زمان کوتاهتری ببیند.
این تفاوت از یک جهت بسیار مهم است. یکی از وسوسههای اصلی در موج فعلی هوش مصنوعی این است که همهچیز را به خودکارسازی تبدیل کنیم. سؤال رایج این است که «کدام کار را میتوانیم با هوش مصنوعی حذف کنیم؟» اما شاید سؤال ارزشمندتر این باشد که «کدام تصمیم مهم سازمان امروز به دلیل کمبود اطلاعات، سرعت پایین تحلیل یا محدودیت شناختی انسان، با کیفیت پایینتری گرفته میشود؟» پاسخ این دو سؤال میتواند کاملاً متفاوت باشد. در بسیاری از سازمانها شاید ارزشمندترین کاربرد هوش مصنوعی حذف انسان نباشد؛ بلکه حذف بخشی از کارهای شناختی تکراری اطراف انسان باشد تا او بتواند زمان بیشتری برای قضاوت، حل مسئله و تصمیمهای استثنایی صرف کند.
این نگاه با مفهوم «عقلانیت محدود» هربرت سایمون نیز ارتباط جالبی دارد. سایمون در دهه ۱۹۵۰ نشان داد که انسانها در دنیای واقعی نمیتوانند تمام گزینهها، اطلاعات و پیامدهای احتمالی یک تصمیم را بررسی کنند. زمان، توجه و توان پردازش ما محدود است و به همین دلیل تصمیمگیری واقعی اغلب به جای یافتن بهترین گزینه مطلق، به یافتن گزینهای رضایتبخش در شرایط موجود منجر میشود [1]. اگر این محدودیت را بپذیریم، یکی از ارزشهای اصلی هوش مصنوعی میتواند افزایش ظرفیت شناختی تصمیمگیرنده باشد: دیدن گزینههای بیشتر، پردازش اطلاعات بیشتر و بررسی سناریوهایی که انسان بهتنهایی فرصت بررسی آنها را ندارد.
اما اینجا یک خطر مهم وجود دارد. اگر دادههای سازمان بیکیفیت باشند، تعریف شاخصها میان واحدهای مختلف متفاوت باشد، ارتباط میان دادهها مشخص نباشد و منشأ اعداد قابل ردیابی نباشد، هوش مصنوعی لزوماً مشکل را حل نمیکند. حتی ممکن است آن را خطرناکتر کند، چون یک سامانه زبانی میتواند پاسخی بسیار قانعکننده اما اشتباه تولید کند. بنابراین سازمانی که میخواهد از هوش مصنوعی برای تصمیمگیری استفاده کند، قبل از هر چیز باید بداند «داده» دقیقاً چه معنایی دارد، از کجا آمده، چگونه محاسبه شده و چه محدودیتهایی دارد.
اینجاست که به نظرم اهمیت «زمینه» از خود داده بیشتر میشود. یک عدد بهتنهایی ارزش محدودی دارد. اگر بدانیم فروش امروز ۱۰۰ میلیارد تومان بوده، هنوز نمیدانیم این عدد خوب است یا بد. باید بدانیم بودجه چقدر بوده، ماه گذشته چقدر بوده، فصل مشابه سال قبل چه وضعیتی داشته، قیمتها تغییر کردهاند یا نه، موجودی چگونه بوده و آیا کمپین بازاریابی خاصی اجرا شده است. بنابراین سیستم هوشمند آینده باید فقط داده را بشناسد؛ باید معنای داده و ارتباط آن با سایر بخشهای کسبوکار را نیز بفهمد.
به همین دلیل یکی از تغییرات مهم در معماری داده، حرکت از «پرسیدن سؤال از پایگاه داده» به سمت «گفتوگو با لایه معنایی سازمان» است. در نسل جدید سامانههای داده، کاربر میتواند سؤال خود را با زبان طبیعی مطرح کند، اما سیستم باید بتواند آن سؤال را به چند مرحله تحلیل تبدیل کند، منابع مناسب را پیدا کند، کیفیت داده را بررسی کند، محاسبات لازم را انجام دهد، نتایج را با یکدیگر مقایسه کند و در نهایت پاسخی ارائه دهد که قابل بررسی باشد. پژوهشهای جدید درباره عاملهای داده نیز دقیقاً در همین مسیر حرکت میکنند؛ یعنی ساخت سامانههایی که فقط یک پرسوجوی ساده اجرا نمیکنند، بلکه فرایند تحلیل داده را تا حدی خودکار میکنند [2].
با این حال، به نظرم ویژگی مهم یک سامانه تصمیمیار خوب این نیست که فقط جواب بدهد؛ بلکه باید بتواند توضیح دهد چرا به آن جواب رسیده است. اگر سیستم بگوید احتمال ریزش یک گروه از مشتریان ۳۲ درصد است، مدیر باید بتواند بپرسد چرا. کدام متغیرها بیشترین نقش را داشتهاند؟ داده از کجا آمده؟ اگر یکی از فرضها تغییر کند چه اتفاقی میافتد؟ اگر قیمت را پنج درصد کاهش دهیم، پیشبینی چگونه تغییر میکند؟ در چنین محیطی، هوش مصنوعی نباید یک جعبه سیاه جدید باشد؛ باید به ابزاری برای ساختن یک فرایند تصمیم قابل بررسی تبدیل شود.
این مسئله اهمیت انسان را نیز از بین نمیبرد؛ بلکه نقش او را تغییر میدهد. پژوهشهای مربوط به همکاری انسان و هوش مصنوعی نشان میدهند که ترکیب این دو همیشه بهتر از هرکدام بهتنهایی نیست. در بعضی وظایف، انسان عملکرد بهتری دارد و در برخی دیگر ماشین؛ بنابراین مسئله اصلی طراحی درست تقسیم کار میان این دو است [3]. اگر تصمیمهای ساده و تکراری را به ماشین بسپاریم و تصمیمهای پیچیده، مبهم و حساس را برای انسان نگه داریم، ممکن است نتیجه بسیار متفاوت باشد با زمانی که تلاش کنیم همه تصمیمها را خودکار کنیم.
از این زاویه، شاید نقش مدیر هوش تجاری در آینده نیز تغییر کند. مدیر BI دیگر صرفاً مسئول ساخت گزارش، نگهداری انبار داده یا تعریف شاخصهای عملکرد نخواهد بود. سؤال اصلی او باید این باشد که سازمان کدام تصمیمها را بیشتر و بهتر میتواند بگیرد، چه اطلاعاتی برای این تصمیمها لازم است، کجا عدم قطعیت وجود دارد، کدام بخش از فرایند را میتوان به ماشین سپرد و کجا هنوز قضاوت انسانی ضروری است. به عبارت دیگر، BI از یک واحد گزارشدهی به بخشی از معماری تصمیمگیری سازمان تبدیل میشود.
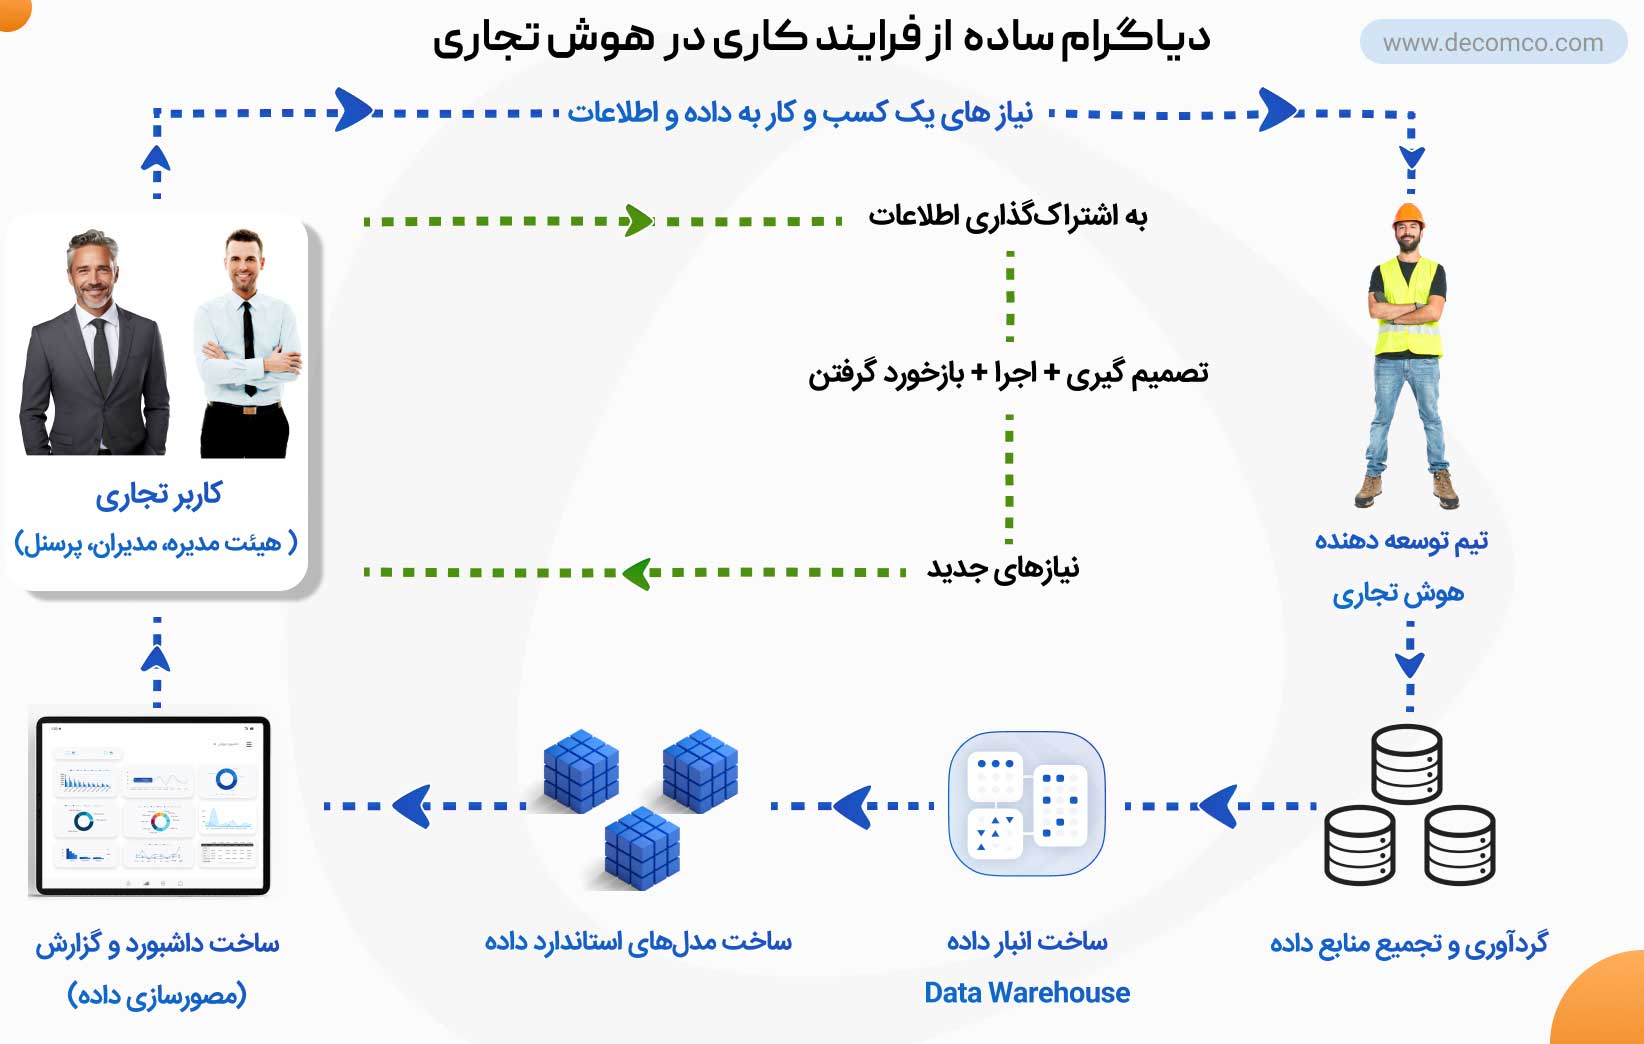
اگر بخواهیم این تحول را در یک زنجیره ساده خلاصه کنیم، مسیر را میتوان اینگونه دید: داده، زمینه، تحلیل، پیشبینی، گزینهها، تصمیم، اقدام و در نهایت یادگیری از نتیجه. داشبورد در این چرخه همچنان مهم است؛ مدل پیشبینی نیز همچنان مهم است و حتی عاملهای هوشمند نیز بخشی از آن خواهند بود. اما هیچکدام هدف نهایی نیستند. هدف، کوتاهتر کردن فاصله میان «اتفاقی که افتاده» و «تصمیمی که باید گرفته شود» است.
شاید به همین دلیل تفاوت مهمی میان یک «سازمان دادهمحور» و یک «سازمان تصمیممحور» وجود داشته باشد. سازمان دادهمحور ممکن است هزاران داشبورد داشته باشد و تقریباً همهچیز را اندازهگیری کند. اما سازمان تصمیممحور میداند کدام تصمیمها بیشترین ارزش را ایجاد میکنند، چه اطلاعاتی برای آنها لازم است، میزان عدم قطعیت چقدر است، چه کسی باید تصمیم بگیرد و نتیجه تصمیم چگونه باید اندازهگیری شود.
در نهایت، شاید آینده هوش تجاری نه ساختن داشبوردهای بیشتر، بلکه ساختن سیستمهای تصمیم بهتر باشد. هوش مصنوعی قرار نیست لزوماً جای مدیر، تحلیلگر یا کارشناس را بگیرد. ارزش واقعی آن میتواند در این باشد که پیش از تصمیم، اطلاعات بیشتری در اختیار انسان بگذارد؛ هنگام تصمیم، گزینهها و پیامدهای آنها را روشنتر کند؛ و بعد از تصمیم، نتیجه را دوباره به چرخه یادگیری برگرداند.
در این نگاه، معیار موفقیت یک تیم BI دیگر تعداد داشبوردهای ساختهشده یا حتی تعداد کاربران سامانه نیست. سؤال مهمتر این است: آیا تصمیمهای سازمان سریعتر، دقیقتر و قابلدفاعتر شدهاند؟
اگر پاسخ مثبت باشد، شاید دیگر چندان مهم نباشد که آن سامانه را «هوش تجاری»، «هوش مصنوعی سازمانی»، «عامل داده» یا «هوش تصمیمیار» بنامیم.
چون در نهایت، ارزش داده نه در این است که بتوانیم آن را ببینیم؛ بلکه در این است که بتوانیم با کمک آن بهتر تصمیم بگیریم.
منابع
[1] Simon, H. A. (1955). A Behavioral Model of Rational Choice. The Quarterly Journal of Economics, 69(1), 99–118.
[2] Gao, D., et al. (2026). Data Agents: A Survey of Agentic Data Analysis. arXiv.
[3] Vaccaro, M., Almaatouq, A., & Malone, T. W. (2024). When Combinations of Humans and AI Are Useful: A Systematic Review and Meta-Analysis. Nature Human Behaviour.
[4] Dellermann, D., Ebel, P., Söllner, M., & Leimeister, J. M. (2019). Hybrid Intelligence. Business & Information Systems Engineering, 61, 637–643.
[5] Jarrahi, M. H. (2018). Artificial Intelligence and the Future of Work: Human-AI Symbiosis in Organizational Decision Making. Business Horizons, 61(4), 577–586.
[6] Davenport, T. H., & Harris, J. G. (2007). Competing on Analytics: The New Science of Winning. Harvard Business School Press.

