
چكیده
تعیین شباهت بین تصاویر از جمله دسته بندی تصویر ،برچسب زنی تصویر و همچنین بازیابی ، مرحله اساسی در بسیاری از برنامه های كاربردی است . روش های اتوماتیك برای ارزیابی شباهت اغلب ناكارآمد است و وقتی كه زمینه معنایی برای كار نیاز است نیاز به قضاوت انسان پیش می آید چنین قضاوتهائی را می توان از طریق فنون جمع سپاری بر اساس كارهای ارائه شده توسط كاربران وب جمع آوری نمود. با این حال برای ممكن ساختن برآورد شباهت تصاویر با زمان و هزینه معقول ایجاد كارها برای مقدار انبوه باید به طریقه دقیقی انجام شود . ما مشاهده كردیم كه فواصل بین همسایگی های محلی اطلاعات ارزشمندی فراهم می كند كه به ما این امكان را می دهد كه معیارشباهت كلی را سریع و دقیق ایجاد كنیم. این ملاحظه كلیدی ما را به سمت راه حلی براساس وظائف دسته بندی ومقایسه تصاویر نسبتاً مشابه هدایت می كند درهرجستجو،اعضای گروه مجموعه كوچكی از تصاویر را درداخل صندوق های خود جمع آوری می كنند . نتایج حاكی از شباهت های نسبی زیاد بین عكس ها می باشد ، كه برای ایجاد معیار شباهت مورد استفاده قرار گرفته اند. این معیاربه صورت تصاعدی اصلاح می شود و برای ترتیب دادن تحقیقات بهتر ومكانی تر در تكرارهای بعدی بهبود می یابد . ما موثر بودن روش خودمان را بر روی مجموعه داده ها وقتی زمینه میدانی وجود داشته باشد و روی مجموعه ای از تصاویر در صورتی كه شباهتهای معنایی را نمی توان اندازه گیری كرد اثبات می كنیم . درحالت خاص نشان می دهیم روش ما گزینه بهتری از روش های مرجع است و موثر بودن تحقیقات جمع آوری و فرآیند اصلاح ما را بهبود می بخشد .
مقدمه
درسالهای اخیر پیشرفت های بسیاری در ضبط عكس در ابزارهای همراه حاصل شده است كه كاربران نهائی را تشویق می كند عكس های بیشتری با كیفیت بالاتر ضبط نمایند.در نتیجه این امر درمجموعه های عكس، هم در رایانه های شخصی و هم در وب سایت هائی نظیر فیسبوك،فلیكرواینستاگرام وفوردائمی وجود دارد. چنین مجموعه های بی شماری نیاز به روش هائی برای دسته بندی عكس ها ، برچسب زنی تصویر و به ویژه ذخیره عكس دارد كه به كاربران این اجازه را می دهد به سرعت عكس مناسب برای نیازشان را بیابند.این روش ها ضرورتاً متكی بر موجود بودن شباهت های دوبدو بین دو عكس در مجموعه هستند.
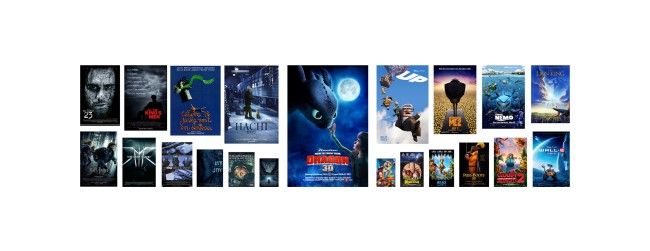
بسیار دشوار است كه یك معیار فاصله ای تعیین كنیم تا شباهت شناخت حضوری یا معنایی بین تصاویر را به خوبی ضبط كند. روش های تحلیلی برای محاسبه چنین معیار زمانی كه شباهت ها از زمینه معنایی بر می آید ناكارآمد است . این ناكارآمدی ممكن است شامل روابط فرّار نظیر هیجان و احساس مشابه كه توسط تصویرالقا می شود.(مثلاً تصایری كه ترس یا یا آرامش را انتقال می دهند)تصاویر اشیائی كه از لحاظ معنائی مرتبط هستند(مثلاً انواع مختلف وسائل باغ) ، همانندی بین افرادی كه عكسشان گرفته شده و غیره .به عنوان نمونه به شباهت بین تصاویر پوستر فیلم در شكل یك دقت كنید . شناسائی چنین شباهتهائی معمولاً توسط انسان به آسانی انجام می شود ، اما با این حال همراه باعث بروز ایراد مشكل شدید محاسباتی خواهد بود.
كار مرتبط
دسته بندی تصاویر مسئله ای كه خیلی خوب مورد بررسی قرار گرفته است . الگوی عام بر اساس توصیفگرهای تصویر نظیر هیستوگرام رنگ تصاویر ، توصیفگر ها بر اساسSIFT یا توصیفگرهای GIST است . فاصله بین دو تصویر به عنوان فاصله اقلیدسی بین توصیفگرهای تصویر تعریف شده است ،دراولویت تمامی تكنیك های آموزشی كه در ماشین می تواند برای یافتن شباهتها به كارگرفته شود تا شباهتها یا مجموعه عكس ها یافته شود. با این حال چنین متدهائی از روش(BoF) (حالت های كیفی پر از حالتها ) اجزا بصری استفاده می كنند كه یا به تصویر به صورت دستی چسبانده شده یا از بافت متنی یك صفحه وب استفاده می كنند. یا این حال چنین متدهائی وقتی دسته بندی مبتنی بر حالتهای معنائی غنی باشد و ممكن است تنها بخشی از آن در برچسب منعكس شده باشد ، ناكارآمد است . برای مثال تصاویر پل های لندن و پاریس حاكی از بسیاری حالات معنائی نظیر استایل ، مواد ساختمانی و محیط عمومی هستند. تصاویر و برچسب ها ی شرح دهنده آنها نه تمام این حالات و نه اهمیت نسبی آنها را برای تعیین شباهت ضبط نمی كنند .
الگوریتم
ما بعداً متد ایجاد پرسش ها را برای گروه براساس معیار برآورد شده شباهت و بهبود معیار بر اساس پاسخ های اخذ شده از گروه شرح خواهیم داد . قصد ما استفاده از پرسش ها ئی است كه مشتمل بر تصاویری از یك محل همسایگی است كه برای تعیین معیار كلی موثرتر است .
الگوریتم ما پرسش های دسته بندی را با استفاده از تصاویر nq ایجاد می كند . پاسخ دریافت شده از اعضای گروه برای قرار دادن تصویر دسته های nc است . گروه منبع نسبتاً گرانی به لحاظ نایابی ، تلاش انسان و هزینه پولی است . بنابر این در بسیاری از موارد تجربی ، تعداد كل پرسشهائی كه می توان پرسید به لحاظ بودجه از پیش تعیین شده محدود است . با چنین بودجه مشخصی هدف ، الگوریتمی كه ما بوجود آوردیم بهره گیری از پرسش ها به بهترین وجه ممكن با منحصراً با درنظرگرفتن همسایگی های محلی است. حاصل این امرفرآیند تكراری است درحالی كه همسایگی ها مطابق با نتایج پرسش ها تغییر می یابند.
آزمایشات
برای ارزیابی كارآمدی روش ما سه مجموعه ازآزمایشات را ترتیب دادیم كه درزیر شرح داده شده است. اول برای سنجش درستی روشمان مجموعه آزمایشاتی در مقیاس كوچك را روی مموعه ای از داده ها ترتیب دادیم وقتی زمینه میدانی شناخته شده باشد. این زمینه میدانی امكان ارزیابی كیفیت نتیجه را ایجاد می كند . دوم عملی بودن روش را برای تصاویری غنی لحاظ معنایی با استفاده ازمجموعه های گسترده تر تصاویر با زمینه میدانی نامعلوم آزمودیم . درانتها برای بررسی بیشتر هر بخش از راه حل،آزمایشات ساختگی ترتیب دادیم(درحالت زمینه میدانی معلوم و درحالتی كه به جای پاسخ گروه واقعی به پرسش ها ، شبیه سازی گروه صورت گرفته بود.) ما پارامترهای مختلفی از سیستم را تغییر دادیم و نتیجه آن را روی كیفیت خروجی مشاهده نمودیم . در تمام مجموعه آزمایشات ما بیشتر نتایج بدست آمده را با الگوریتم های پایه جایگزین مقایسه كردیم .
آزمایشات گروه با زمینه میدانی
به عنوان بررسی درستی ما دو آزمایش با مقیاس كوچك با افراد كم (حدود 10 تا 15 عضو گروه) و مجموعه های كوچكی از تصاویر با زمینه میدانی معلوم انجام دادیم . آزمایش ما با دوكار متفات محاسباتی صورت گرفت : top-k و دسته بندی . برای هركار ، اعضای گروه به پرسش های الگوریتم مبنا و الگوریتم ما پاسخ می دهند .
نتیجه گیری
در این مقاله ، ما روش موثری برای برآورد شباهتهای تصاویر منحصراً بر مبنای داده های گروه ارائه دادیم . سیستم ما به صورت مستمر تصاویر ارائه شده به گروه را تصحیح می كند تا مقایسات شباهت بین تصاویر در یك همسایگی را بدست آورد كه همگرائی برای معیار دقیق شباهت را ممكن سازد. در بررسی آزمایشی ما تعداد به ویژه كمی از پرسش ها مورد استفاده قرار گرفت بر این اساس كه بتوانیم برآورد نسبتاًخوبی از شباهت معنایی حاصل نمائیم .
محدودیت ها و كار بعدی این كارتنها برداده های ارائه شده توسط گروه تمركزیافته بود . با این حال به تكراردر این مورد ذكر شد ، سررشته ای كه برای شباهت معنایی تصاویر وجود دارد در فرم حالتهای تصاویر یا بافت متنی موجود است . حتی اگر این سرنخ خا برای كل محدوده ارتباطات معنایی در حساب نیاید ، جالب خواهد بود كه چگونه آنها را در پیوند همزمان با الگوریتم ما مورد استفاده قرار دهیم.این جنبه در مقیاس پذیری روش ها مخصوصا در مجموعه های بسیار بزرگ تصویر ، تعداد مقرون به صرفه پرسش ها حتی ممكن است دراندازه مجموعه خطی نباشد.یك روش درست برای تجمیع سررشته های معنائی، از الگوریتم ما برای آموختن شباهتها برای بخش كوچكی از مجموعه تصویر استفاده خواهد نمود وسپس با به كارگیری تكنیك های آموزش ماشین برای تكمیل بقیه كار ، از حالتهای سررشته های معنائی استفاده خواهد نمود. (ایجاد شده توسطLun و دیگران [9] ، Saleh و دیگران [13]، Yiو دیگران [22]) . راه حل جالب تر ممكن است تركین سررشته ها با مرحله ایجاد پرسش باشد . چون بهره بردن از سایر برآوردها می تواند به صورت بالقوه باعث نادیده شدن تصاویردارای شباهت معنائی شود ، این امر كم اهمیت نیست.روش چالش برانگیزدیگربرای كارآینده طرز برخورد دقیق تربا عدم قطعیت ناشی ازعمل گروه باشد. اغلب اعضای گروه روی شباهت تصاویر هم رای نیستند،یا حتی جواب های متناقضی ارائه می دهند. تا این مرحله ما فرض كردیم كه جادهی كه انجام دادیم اثر چنین تناقض هائی را كاهش می دهد . با این حال ، شاید بخواهیم برای تناقض ها با مدلینگ احتمال گرایانه رفتار گروه محاسبه دقیقی داشته باشیم مثلاً به گونه ای كه در [7] به منظور دسته بندی انجام شده است . بنابر این جالب خواهد بود كه مدل های احتمال گرایانه را اختصاصاً برای یادگیری معیار شباهت توسعه دهیم . بویژه ، این روش باید محاسبات كارآمد را هم كنش با ماهیت هم كنشی الگوریتم ما پشتیبانی كند.
این مقاله ISI در سال 2016 در نشریه اسپرینگر و در مجله کامپیوتر بصری، توسط دانشگاه تل آویو منتشر شده و در سایت ای ترجمه جهت دانلود ارائه شده است. در صورت نیاز به دانلود رایگان اصل مقاله انگلیسی و ترجمه آن می توانید به پست دانلود ترجمه مقاله دریافت شباهت معنایی تصوير از طريق دسته بندی در سایت ای ترجمه مراجعه نمایید.

