
10.1: ذخیره سازی الگوهای همبسته
همان طور که در بخش 3.1 و 4.3 بحث کردیم توانایی بیادآوری صحیح خاطره ها اگر عددp از الگوهای ذخیره شده از یک حد معین بیشتر شود تجزیه می شود(از بین می رود.).هنگامی که پیوندهای سیناپسی بر طبق قانون Hebb تعیین شده هستند،این کار در تراکم (چگالی)ذخیره سازی اتفاق می افتدα=p/N=0.138 .دلیل این رفتار،تاثیردیگر الگوهای ذخیره شده که با ضابطه اختلال نوسان در(3.13)بیان می شود،می باشد.همان طور که در انتهای بخش 3.1 اشاره کردیم،اگر الگوها بر یکدیگر متعامد باشند همانند انچه که در بخش (3.16) بیان شد،این اثر دقیقا ناپدید خواهد شد.به عبارت دیگر توان تجدیدخاطره روبه وخامت می رود حتی قبل از آنکه الگوهای ذخیره شده شدیدا با یکدیگر مرتبط شوند.درباره نمایش گرافیکی حروف رومی فکر کنید،جایی که E شباهت نزدیکی به F داردو C شبیه G است یا درباره لیست معمولی از اعداد کتابچه تلفن،که احتمالا بسیار به هم مرتبط هستند، فکرکنید.
از برنامه ASSO برای یادگیری و بیادآوری 26 حرف حروف الفبا استفاده کنید:A-Z مقادیر زیر را انتخاب کنید:(26/26/0/1) و (1//0/0/1;2) برای مثال آپدیت متوالی،دما و آستانه صفر و آزمایش با مقدار مجاز اختلال(صدا).آیا حرف خاصی پایدار است؟آزمایش را با 6 حرف اول الفبا و مطالعه توانایی شبکه در به یادآوردن حروف مشابه E و F تکرارکنید.
ماهیت مساله از آنچه که در بخش قبلی در ارتباط با شبکه های لایه ای تغذیه مستقیم مطرح شد،فرق نمی کند.ضابطه یادگیری پرسپترون راهبرد یادگیری کامل برای پرسپترون های ساده بدون لایه های مخفی نورون ها فراهم می کند.با این حال،این طرح ها در عمل قابل استفاده نیستند چون حتی در حل مسایل بسیار ساده هم شکست می خورند.به همین دلیل است که مفاهیم پرسپترون برای بیست سال کنارگذاشته شد،اگرچه پرسپترون های چندلایه با لایه های پنهان نورون از چنین مشکلی رنج نمی برد.اما بدون الگوریتم یادگیری عملی،که درابتدا با خطای پس انتشار در دسترس است،یک جایگزین عملی فراهم نخواهد شد.
10.1.1 قانون تجسم
با این وجود روشن است که مشکل تبعیض بین الگوهای مرتبط یک جواب ساده مهم دارد که حتی به ذخیره گاه p=N اجازه می دهد به طور اختیاری الگوهای همبسته را انتخاب کند تا زمانی که به طور خطی مستقل باشند.برای دیدن اینکه چگونه کار می کند ماتریس ضرب اسکالر بین جفت الگوها(σ_i^μ=±1) را تشکیل می دهیم:
Q_μv=1/N ∑_i〖σ_i^μ σ_i^v 〗 (1≤μ,v≤p) (10.1)
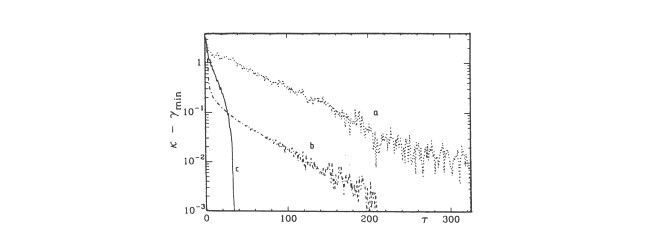
کیفیت به یاد آوری الگو با افزایش دما و استفاده از حافظه α=p/N رو به تحلیل می رود.همانند مورد قانون Hebb کیفیت بازیابی با پارامتر m تعریف شده در(4.15) می باشد. m=1 نشان دهنده یادآوری کامل حافظه است با این حال m=0 نشان دهنده فراموشی کامل است.ناحیه کارآیی و فراموشی حافظه با مقدار m در مرز فاز در شکل 10.1 نشان داده شده است.شعاع جذب R الگوی ذخیره شده در شکل 10.2 به عنوان تابعی از تراکم ذخیره α برای مدل های کانتر و سامپولینسکی و پرسوناز،نشان داده شده است.در اینجا شعاع جذب با رابطه R=1-m0 تعریف شده است که m0 کمترین همپوشانی الگوی si که می تواند با الگوی ذخیره شده σ_i داشته باشد،که به طور قطعی توسط شبکه تشخیص داده می شود.همان طور که می بینیداز بین رفتن جفت های مورب ω_ij در مدل [Ka87] منحنی (a) اثر موثرتری(بهینه تر) دارد.
10.2 قانون یادگیری خاص
10.2.1 ارتقاء حافظه را فراموش کنید!
همان طور که در بخش 3.3 بحث کردیم قانون یادگیری استاندارد(قانون Hebb) منجر به بروز فراموشی کلی ناخواسته در تابع انرژی E[s]می شد.در عمل به این معناست که تکامل شبکه می تواند گرفتارجعلی بودن،پیکربندی های پایدار محلی،نظیر آنچه که در (3.23) بود؛بشود.شبکه های بزرگ معمولا تعداد وسیعی از اعداد نظیر حالت های پایدار جعلی می شود که بسیاری از آنها حتی ترکیب خطی نقاط پایدار مورد نظرهم نیست.قانون یادگیری برای الگوهای همبسته که در بخش 10.1 بحث شد،از این مشکل در امان نیستند.نوسانات حرارتی کمک می کنند تا پیکربندی های جعلی بی ثبات شوند،اما با مصرف ظرفیت حافظه.علاوه بر آن ناپدیدکردن همه وضعیت های جعلی در دمای نهایی T تضمین شده نیست.
رقت سیناپس
فرض اینکه همه نورون ها به یکدیگر متصل هستند واقعی نیست،به خصوص اگر کسی به مدل شبکه عصبی بیولوژیکی علاقمند باشد.ممکن است بپرسید آیا شبکه عصبی به عنوان یک حافظه انجمنی موثر عمل کند اگرکسر بزرگی از پیوندهای سیناپسی قطع شوند یا کم شدت شوند؟اتصال سیناپسی معمولا با حذف پیوندها(اتصالات) به طور تصادفی رقت(کم شدت) می شوند و فقط کسرd<1 از همه سیناپس ها نگه داشته می شود.اگر این کار انجام شود در حالیکه تقارن ماتریس سیناپسی نیز حفظ شود ظرفیت حافظه یک شبکه آموزش دیده با قانون Hebb تقریبا به طور خطی با dکاهش پیدا می کند همان طور که در شکل 10.7 نشان داده شده است که و ضریب کیفیت یادآوری بحرانی به عنوان تابعی از کسر پیوندهای سیناپسی تخریب شده نشان داده شده است. [1] این نتایج به وضوح مقاومت در برابر خطا شبکه های عصبی را نشان می دهد.حتی بعد از حذف کسز بزرگی از سیناپس ها شبکه تلاش می کند تا کاملا قابل اعتماد عمل کند.رهیافت دیگر رقت کردن سیناپس های غیر متقارن است برای مثال تنظیم اما دیگرلازم نیست.این مورد می تواند در حد به طور تحلیلی حل شود.یکی از یافته ها این است که ظرفیت حافظه در سیناپس های باقیمانده تقریبا چهار برابر برای شبکه کامل متصل هستند.
این مقاله در سال 1990 در نشریه اسپرینگر و در مجله فیزیک شبکه های عصبی، توسط گروه فیزیک منتشر شده و در سایت ای ترجمه جهت دانلود ارائه شده است. در صورت نیاز به دانلود رایگان اصل مقاله انگلیسی و ترجمه آن می توانید به پست دانلود ترجمه مقاله حافظه انجمنی و راهبردهای یادگیری در سایت ای ترجمه مراجعه نمایید.

