
یکی از تجربههایی که باعث شد ساختمان داده و الگوریتم را کمی متفاوتتر از قبل ببینم، زمانی بود که روی یک سیستم پایش و کنترل سلامت دادههای مالی کار میکردم.
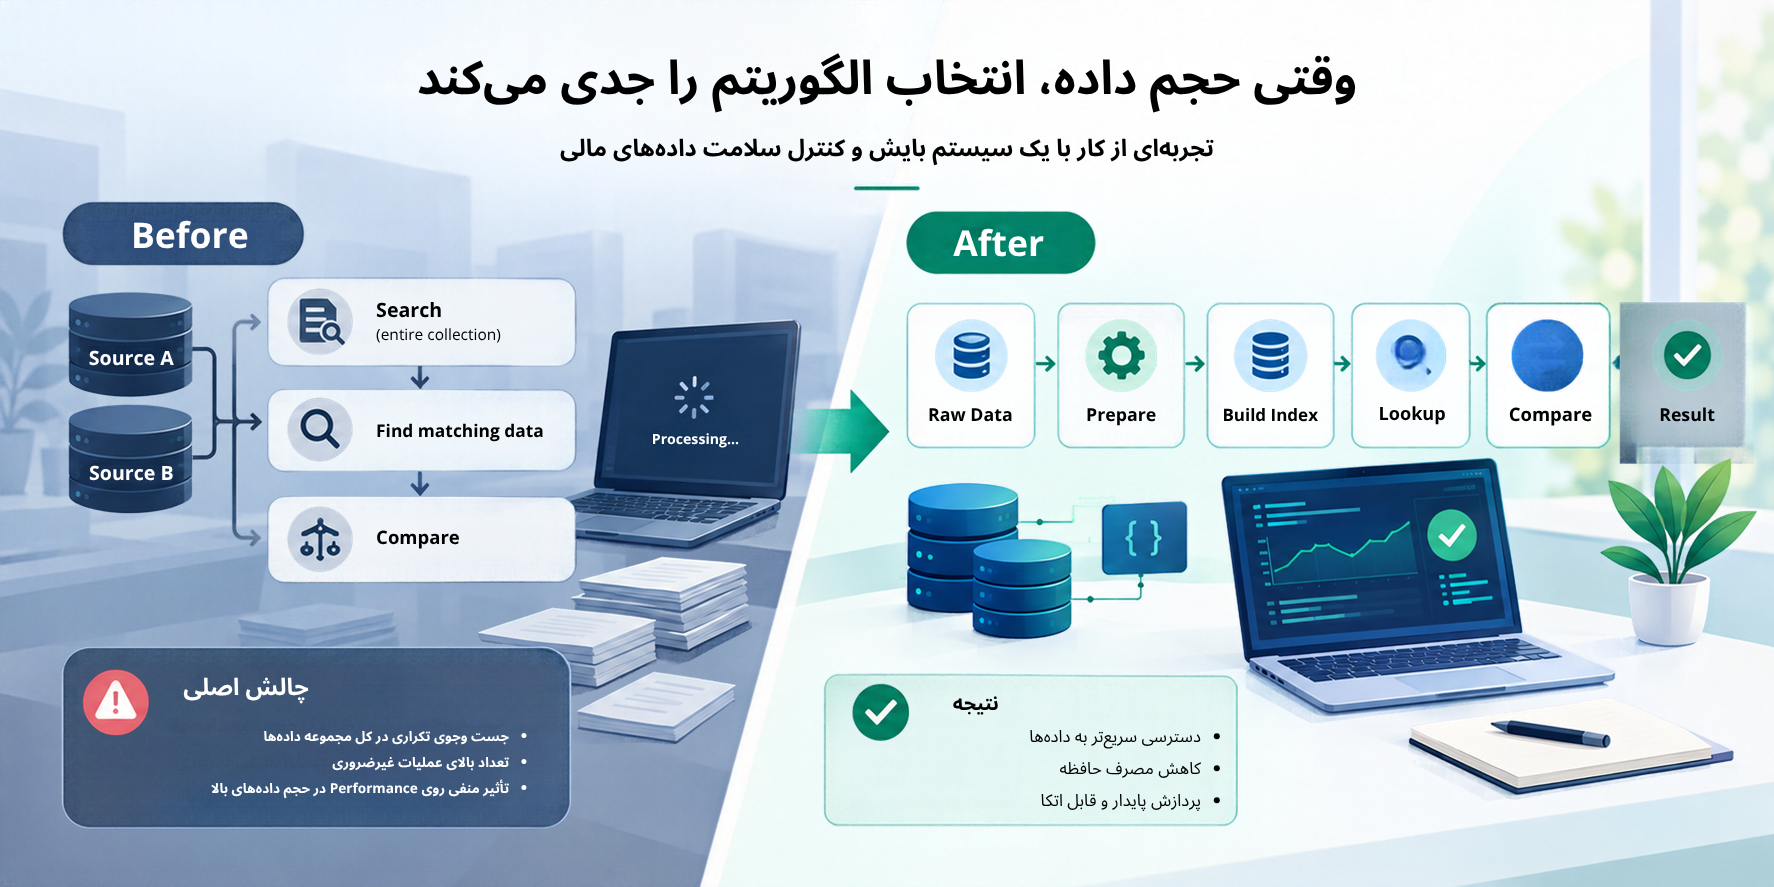
قبل از آن هم با مفاهیمی مثل Big-O، HashMap، Array، Set و انواع روشهای جستوجو کار کرده بودم؛ در پروژههای معمولی، خیلی وقتها تفاوت بین یک انتخاب خوب و یک انتخاب متوسط آنقدر محسوس نیست اما وقتی حجم داده بالا میرود، این تفاوت خودش را نشان میدهد.
در این پروژه، با حجم زیادی از دادههای مالی از سورس های مختلفی سروکار داشتم و هدف، بررسی و تطبیق دادهها و پیدا کردن مواردی بود که نیاز به بررسی بیشتر داشتند.
در نگاه اول، مسئله ساده به نظر میرسید.
برای هر رکورد، رکورد متناظر را پیدا میکنم و بعد اطلاعاتشان را با هم مقایسه میکنم.
اما چالش فراتر از اینها بود چون در چنین سیستمی، بخش مهم ماجرا خودِ مقایسه نیست بلکه پیدا کردن دادهای است که قرار است مقایسه شود.
فرض کنیم دو مجموعه داده داشته باشیم:
A = 1,000,000 records
B = 1,000,000 records
اگر برای هر رکورد از A، مجموعه B را جستوجو کنم، عملاً دارم تعداد بسیار زیادی عملیات غیرضروری انجام میدهم.
ممکن است روی چند صد یا حتی چند هزار رکورد Performance قابل قبول باشد اما وقتی تعداد رکوردها به حجمهای بسیار بالا میرسد، دیگر نباید فقط به این فکر کنیم که: کد درست کار میکند.
برای من، این تبدیل شد به یکی از مهمترین سؤالها هنگام حل این چالش که این کد با این حجم داده چقدر کار اضافه انجام میدهد و برای پاسخ به آن باید مسئله را یک مرحله پایینتر برد و به جای تمرکز صرفا روی Business Logic، روی Algorithm و Data Structure مورد استفاده برای Lookup تمرکز کرد.
اگر برای پیدا کردن هر رکورد مجبور باشم مجموعه بزرگی از دادهها را بررسی کنم، در بدترین حالت با پیچیدگیای نزدیک به O(N × M) مواجه میشوم و در چنین شرایطی، حتی اگر منطق مقایسه کاملاً بهینه باشد، باز هم قسمت Search میتواند کل پردازش را تحت تأثیر قرار دهد.
برای من اینجا یک نکته خیلی ملموس شد:
گاهی مشکل Performance در جایی نیست که عملیات اصلی را انجام میدهیم؛ در پیدا کردن ورودی آن عملیات است.
به همین دلیل تصمیم گرفتم به جای اینکه هر بار داده را Search کنم، ساختار دسترسی به داده را تغییر بدهم.
به جای اینکه هر بار روی مجموعه اصلی جستوجو کنم، دادهها را بر اساس Keyهایی که برای تطبیق لازم داشتیم Index کردم.
به شکل ساده، چیزی شبیه این:
Raw Data → Prepare → Build Index → Lookup → Compare → Result
با این تغییر، دیگر برای هر رکورد لازم نبود کل مجموعه را بررسی کنم.
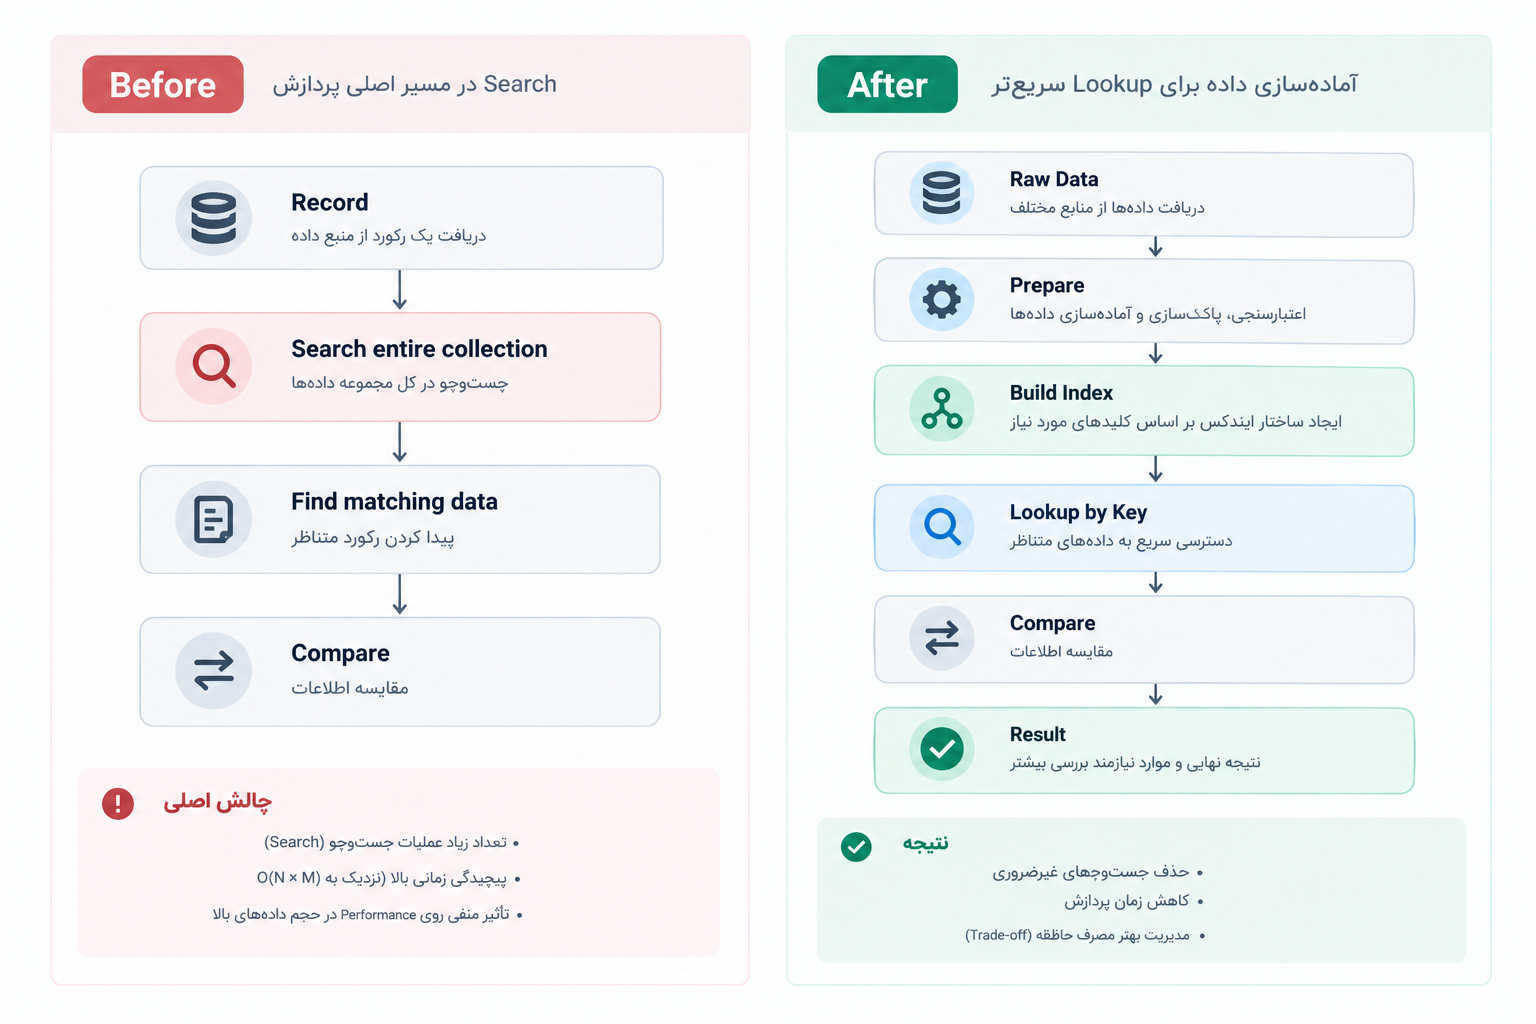
دادهای که قرار بود بارها به آن دسترسی داشته باشم، یک بار برای Lookup مناسب آماده میشد و بعد میتوانستم مستقیماً به سراغ آن بروم و ساختارهایی مثل HashMap برایم دیگر فقط یک مثال از ساختمان داده در یک دوره آموزشی نبود.
واقعاً میدیدم که انتخاب یک Data Structure مناسب میتواند تعداد زیادی عملیات غیرضروری را از سیستم حذف کند.
این تغییر بدون هزینه نبود.
وقتی داده را برای Lookup سریعتر Index میکردیم، طبیعتاً حافظه بیشتری مصرف شد.
در نتیجه نمیتوانستم فقط بگویم:
Lookup سریعتر شد، پس راهحل تمام است
باید همزمان به Memory هم فکر میکردم و این قسمت برای من جالب بود، چون مسئله از یک سؤال ساده (که چطور سریعتر Search کنم؟) تبدیل شد به مجموعهای از سؤالها:
چه مقدار داده را وارد حافظه کنم؟
چه چیزی را Index کنم؟
Key مناسب برای Lookup چیست؟
آیا همهی دادهها به Index نیاز دارند؟
دادهای وجود دارد که چند بار پردازش شود؟
آیا میتوان بخشی از پردازش را مرحلهبندی کرد؟
هزینه ساخت Index در مقابل هزینه Searchهای بعدی چقدر است؟
در واقع، انتخاب Data Structure به یک تصمیم Performance تبدیل شده بود.
یکی از چیزهایی که این تجربه برای من تغییر داد، نگاه من به Complexity بود چون قبلاً وقتی درباره O(N) یا O(N²) صحبت میکردم، بیشتر به عنوان یک مفهوم الگوریتمی به آن نگاه میکردم.
در این پروژه، تفاوت بین O(N) و O(N²) دیگر یک تفاوت تئوری نبود. وقتی حجم داده بالا رفت، این تفاوت خودش را در زمان اجرای واقعی سیستم نشان داد.
برای همین از آن به بعد، وقتی با یک Collection یا یک حلقه تودرتو مواجه میشوم، فقط به خوانایی کد نگاه نمیکنم بلکه از خودم میپرسم:
اگر این Collection یک میلیون عضو داشته باشد چه؟
اگر این Loop برای هر رکورد اجرا شود چه؟
اگر این Lookup چند میلیون بار تکرار شود چه؟
این سؤالها معمولاً سریع مشخص میکنند که یک Implementation واقعاً برای Scale موردنظر مناسب است یا نه.
اگر بخواهم تجربه این پروژه را خلاصه کنم، شاید مهمترین قسمت آن انتخاب HashMap یا یک Algorithm خاص نباشد بلکه برای من مهمتر این بود که متوجه شدم قبل از بهینه کردن کد، باید نحوه کار کردن سیستم با داده را بفهمم.
وقتی حجم داده زیاد است، باید بدانم:
داده از کجا میآید؛
چند بار خوانده میشود؛
چند بار جستوجو میشود؛
چه چیزی باید Index شود؛
چه چیزی را میتوان یک بار محاسبه کرد؛
چه چیزی نباید دوباره محاسبه شود؛
و در نهایت، چه مقدار زمان و حافظه برای این تصمیم پرداخت میکنم.
به نظرم این همان جایی است که ساختمان داده و الگوریتم از یک موضوع تئوری فاصله میگیرند و وارد مهندسی واقعی نرمافزار میشوند.
این سیستم مربوط به دادههای مالی و اطلاعات حساس بود و به همین دلیل نمیتوانم جزئیات واقعی آن را منتشر کنم چون اطلاعاتی مثل ساختار دقیق دادهها، قوانین مغایرتگیری، حجم واقعی اطلاعات، معیارهای تطبیق، نام سرویسها و جزئیات مربوط به دادههای حقوقی و مالی قابل انتشار نیستند.
بنابراین تجربهای که در این نوشته آوردم به نمونه واقعی نزدیک است اما صرفاً برای توضیح نوع مسئله و تصمیم فنی مشابهسازی شده قرار نیست ساختار واقعی سیستم را بازسازی کند.
وقتی حجم داده بالا میرود، انتخاب Algorithm و Data Structure دیگر فقط یک تصمیم در سطح کدنویسی نیست؛ مستقیماً روی Performance تاثیر میگذارد
این تجربه برای من یادآوری کرد که وقتی با دادههای سنگین کار میکنم، Algorithm و Data Structure دیگر جزئی از کد نیستند بلکه بخشی از تصمیم مهندسی من درباره خود سیستم هستند.

