
پردازش پیش بینی کننده (predictive processing) بدون شک یکی از بزرگترین کشفیات علمی در حوزه ی دانش مغز و علوم شناختی در دو دهه اخیر بوده است. ایده ی پردازش پیش بینی کننده طیف وسیعی از پدیده های مربوط به مغز را که قبلا برای ما معما بودند در یک چارچوب واحد توصیف می کند.
ایده ی پردازش پیش بینی کننده این است که بر خلاف درک سنتی از مغز ادراک ما تنها یک جریان از جهان بیرون و از طریق حسگر هایمان (بینایی چشایی لامسه بویایی و شنوایی) به مغز نیست. در دیدگاه سنتی هنگامی که شما تصویر یک سیب را میبینید این تصویر بعد از شکل گرفتن بر روی شبکیه چشم و عبور از عصب های بینایی وارد مغز شده و در مرحله نخست الگوهای ساده مانند خطوط شناسایی می شوند و به تدریج ویژگی های سطح بالاتر آن اضافه می شوند (مناطق V1 تا V5 مغز). در این دیدگاه مغز یک سیستم منفعل است که منتظر پردازش داده های بیرون است. به عبارتی مغز چیزی جز یک ماشین تشخیص الگو نیست. اما این توصیف تنها نصف ماجرا است.
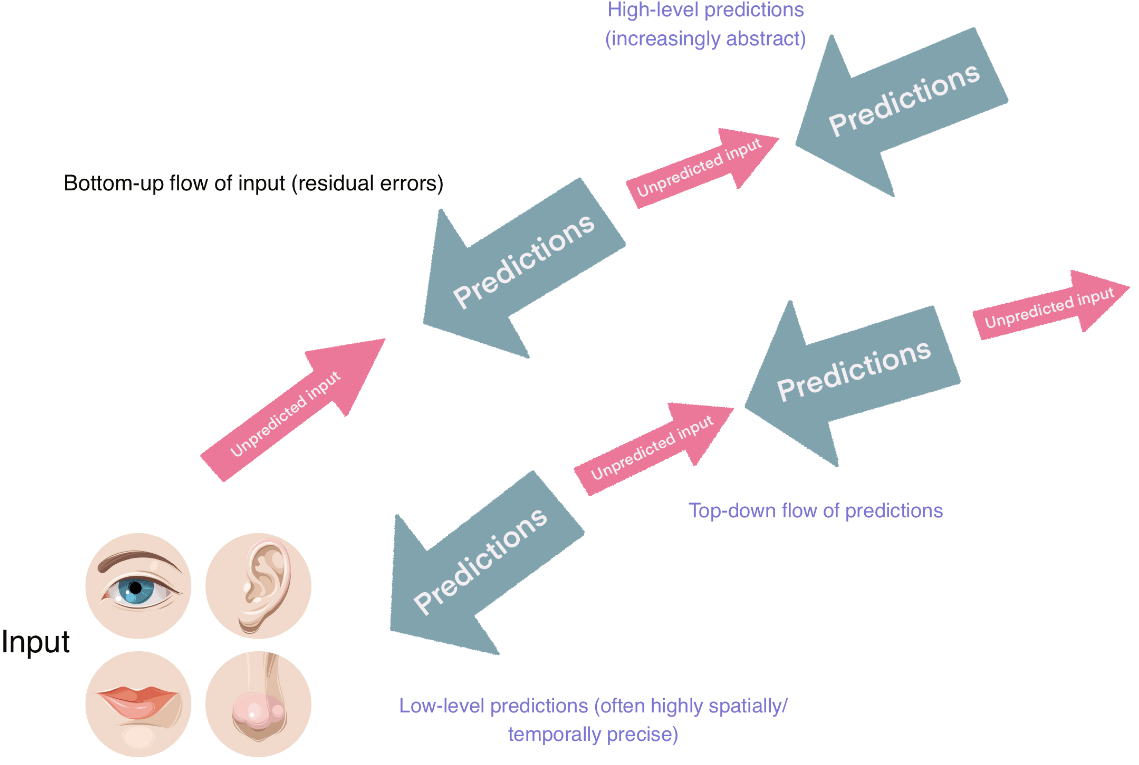
در پردازش پیش بینی کننده به این نکته پی می بریم که مغز قبل از آنکه حتی سیگنال های حسی از راه برسند دست به ساختن واقعیت بیرونی میزند! به عبارتی مغز علاوه بر جریان اطلاعات از پایین به بالا (از حسگرها به مراحل بالاتر مغز) یک جریان اطلاعات از بالا به پایین هم دارد که قبل از آنکه مثلا تشخیص داده شود که فلان قسمت تصویر یک سیب وجود دارد آن تصویر را میسازد. به این ترتیب مغز به صورت فعال در ساختن واقعیتی که درک می کنیم، دخیل است. اما مغز چگونه می داند که چه باید تولید کند؟ پژوهش ها نشان داده است که مغز حاوی مدل های تولیدی (generative model) زیادی است که با دقت زیاد می توانند آنچه انتظار می رود را پیش بینی کنند.
فرض کنید وارد اتاقتان می شوید و به سمت میز کار می روید و فنجان چایتان را بر میدارید. تصور خودتان این است که تمام محیط اطراف را می بینید و می شنوید و لمس و بو میکنید اما در عمل مغز شما بخش زیادی از آنچه در اطراف شماست از صداها و بوها و تصاویر و غیره را میسازد چون از قبل می داند قرار است به چه محیطی وارد شود. مغز ما حاوی میلیون ها چارچوب است که براحتی جهان اطراف ما را بازسازی می کند. ممکن است گاهی متوجه شده باشید چیز خیلی مشخصی را که در جلویتان بود را ندیده اید. مثلا یک لنگه جوراب روی میزتان! دلیل این اتفاق این است که شما همه چیز را نمی بنید! البته این به آن معنی هم نیست که مغز به داده های ورودی توجهی نمی کند. مغز بر اساس پیش فرض ها (prior) ها جلو می رود تا زمانی که جریان تولیدی از بالا به پایین در نقطه ای با جریان پایین به بالا تناقض داشته باشد در این صورت یک جریان خطا ایجاد می کند و سیگنال خطا به مناطق بالاتر منتقل شده و پیش فرض اصلاح می شود. اما در بقیه موارد جریان پایین به بالا اگر تفاوت چندانی با جریان بالا به پایین نداشته باشد کنسل شده و به مراحل بالاتر نمیرود. با این کار مغز حجم بسیار زیادی از محاسبات را انجام نمی دهد. آنچه ادراک می شود انتظار ما از جهان بیرون است و نه آنچه واقعا بیرون است!!
این جریان بالا به پایین در خواب هایی که میبینیم به صورت کامل غالب می شود. به این ترتیب که هیچ جریانی از پایین با بالا وجود ندارد و تمام آنچه ادراک می شود مدل های تولیدی مغز است. اندی کلارک در کتاب surfing the uncertainty ادراک را نوعی توهم (hallucination) کنترل شده توصیف می کند! به عبارتی همه ما همیشه (حتی در بیداری) در یک رویا قرار داریم و فقط هر از گاهی متوجه واقعیت بیرون می شویم. این یکی از مهم ترین شیوه های مغز در کارا بودن و صرفه جویی کردن در حجم باورنکردنی از محاسبات است.
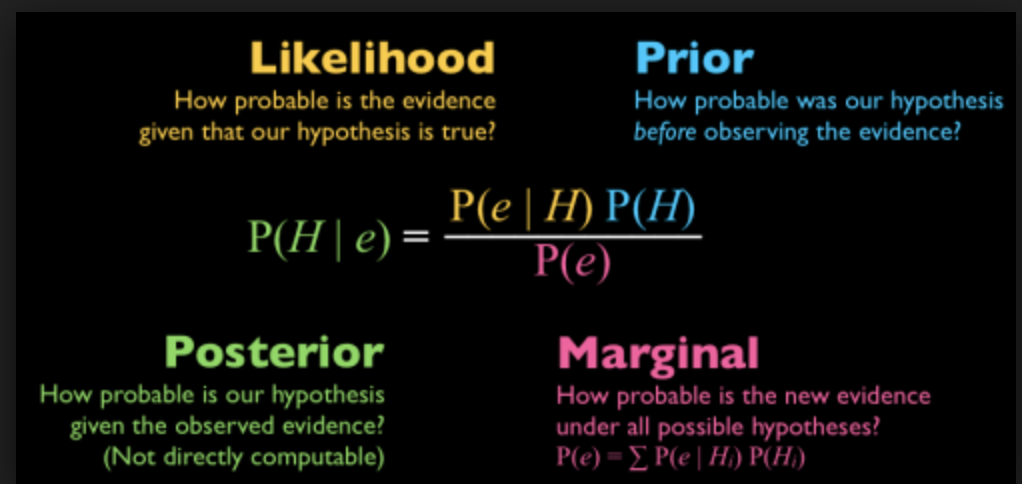
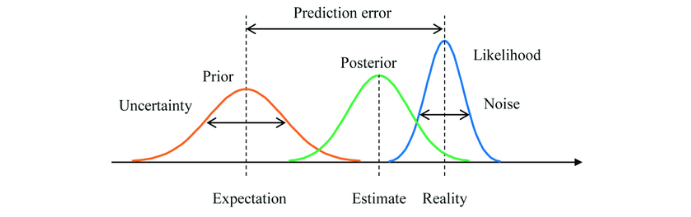
از یک دیدگاه بیزینی مدل های تولیدی (generative models) که جریان بالا به پایین را می سازند همان احتمال های پیشنی prior ها هستند که ما از طریق تجربه ساخته ایم و جریان پایین به بالا نمایانگر اطلاعات خام یا likelihood ها هستند. اتفاقی که می افتد این است که اگر داده ها و پیشینی ها با هم همخوانی داشته باشند احتمال posterior یا پسینی تغییر چندانی نخواهد داشت اما اگر این دو از هم فاصله زیاد داشته باشند احتمال پسینی مجبور به حرکت به سمت توزیع داده ها می شود. این همان قانون بیز است.
اینکه چقدر به سمت داده حرکت می کنیم و چقدر در احتمال پیشینی می مانیم بستگی به میزان اعتماد ما به داده ها دارد. در اصطلاح مغز به این «توجه» (Attention) می گوییم. به عبارتی توجه میزان بالانس بین جریان های پایینی و بالایی است و با فاکتوری به اسم precision میزان آن تعیین می شود. در این جا precision چیزی جز معکوس واریانس داده های پایین به بالا نیست. (در شکل زیر همان Noise). اما در عمل این چطور کار می کند. فرض کنید در یک شب تاریک و بارانی و طوفانی در یک مسیر آشنا به سمت خانه رانندگی می کنید در این حالت اعتماد شما به آنچه بیرون می بینید کمتر است به عبارتی در این حالت اعتماد شما به prior های مغز که همان جریان بالا به پایین است بیشتر از جریان داده های پایین به بالاست. از طرفی هنگامی که در یک جاده ی نا آشنا در روز رانندگی می کنید کمتر به اطلاعات پیشینی (prior) دقت می کنید و سعی می کنید بیشتر به اطلاعات جدید از پایین به بالا (از حسگر هایتان) اعتماد کنید. پیچیدگی این تنظیم ها آنقدر زیاد است که شاید آشکار کند چرا با وجود سالها وعده و وعید در مورد اتومبیل های خودران همچنان چنین سیستم هایی مشکلات زیادی دارند.
مجموعه ی زیادی از روش های یادگیری ماشین در حوزه شبکه های عصبی مبتنی بر روش های بدون ناظر (unsupervised) هستند. به این معنی که چنین روش هایی نیاز به برچسب گذاری داده ها ندارند. به طور مثال در این روش ها به جای آنکه اول به دنبال دسته بندی و تشخیص گلابی از سیب باشیم به دنبال این هستیم که بتوانیم اشیای مختلفی که به شبکه داده می شود را بسازیم! این روش منجر به ساختن سیستم هایی می شود که خود سازمانده هستند (self-organized) و نیازی به ناظر خارجی برای اصلاح ندارند.
چنین مشی ای برای ساخت یک سیستم یادگیرنده اساس شبکه های عصبی مختلفی مانند ماشین بولتزمن و ماشین هلمهولتز هستند. در ماشین بولتزمن یک گراف دو بخشی داریم که یک بخش آن نورون های حسگر هستند (visible) این نورون ها شباهت زیادی به حسگرهای ما دارند و بخش دوم نورون های نهان (hidden) هستند که مسئول ساختن بازنمایی های سطح بالا هستند. چنین معماری بسیار ساده ای در عین حال توانمند هم هست. در این معماری از یک مجموعه از ارتباطات بین این دو دسته نورون استفاده می شود. این کانکشن ها ابتدا اعداد تصادفی هستند و به محض قرار دادن یک داده ی واقعی بر روی نورن های حسگر می توان با ضرب ماتریسی ساده اعداد متناظر بر روی نورون های نهان را محاسبه کرد. در روش یادگیری contrastive divergence وزن های این کانکشن ها یاد گرفته می شود به این معنا که اگر به جای قرار دادن اعداد بر روی نورونهای حسگر اعدادی بر روی نورون های نهان قرار دهیم الگوهای آموخته شده را می توان بر روی حسگر ها بازسازی کرد!
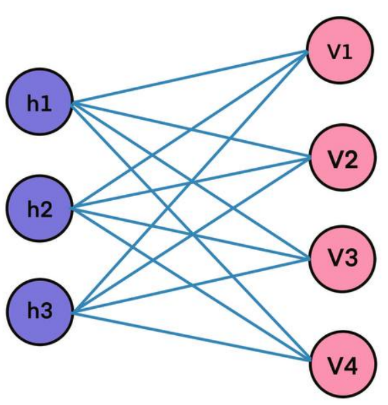
در ویدیو زیر من یک الگوی ساده را چندین بار به شبکه میخورانم (از طریق قرار دادن بر روی نورون های حسگر) و سپس در بخش daydreaming نورون های نهان را تحریک می کنم تا الگوهایی بر روی نورون های حسگر بیندازند و آنطور که مبینید آنها واقعا می توانند الگوی ساده ای که چند بار دیده اند را بر روی ورودی بازسازی کنند!
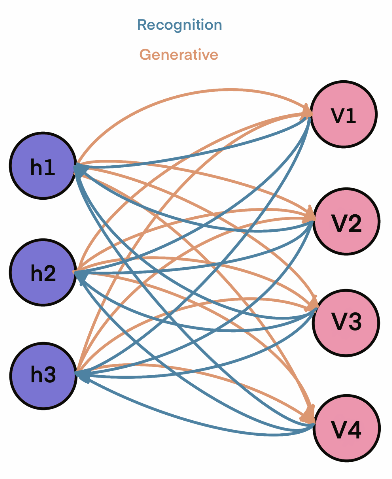
شبکه های عصبی ماشین هلمهولتز بسیار مشابه هستند با این تفاوت که در این شبکه مسیرهای بالا به پایین و پایین به بالا از هم متفاوت هستند (از دید ریاضی به این معناست که ماتریس وزن ها در این حالت متقارن نیست). به شبکه ی پایین به بالا شبکه تشخیص (recognition) و شبکه بالا به پایین تولیدی (Generative) می گویند.
منابع:
[1] Clark, Andy. Surfing uncertainty: Prediction, action, and the embodied mind. Oxford University Press, 2015.
[3] https://matthewho.me/restricted-boltzmann-machine-visualizer/
[4] Yanagisawa, Hideyoshi, Oto Kawamata, and Kazutaka Ueda. “Modeling emotions associated with novelty at variable uncertainty levels: A Bayesian approach.” Frontiers in computational neuroscience 13 (2019): 2.

