
بسیاری از الگوریتم هایی که به طور معمول استفاده می کنیم مانند الگوریتم های هوش مصنوعی(تکاملی، بیزین) الگوریتم های شبکه و تقریبا تمام شبیه سازی ها نیاز به نمونه گیری تصادفی دارند. بنابراین وقتی ندانید چگونه باید این کار را به صورت بهینه انجام دهید وقت و انرژی زیادی از شما صرف می شود. در این راه ممکن است قطعه کدهایی بنویسید که اصلا لازم نیستند چرا که خود متلب این امکانات را قبلا برای شما فراهم کرده است!
ابتدا با ساده ترین حالت ها شروع می کنیم: فرض کنید تعدادی عدد دارید و می خواهید به صورت تصادفی چند تایی از آن ها را انتخاب کنید. وقتی به این شکل صحبت می کنیم همواره پیش فرض ما این است که احتمال تمام عددها برای انتخاب شدن یکسان هستند(مانند لاتاری!) متلب برای تمامی این موارد یک تابع فوق العاده ایجاد کرده است: randsample مثلا مورد زیر را در نظر بگیرید
out = randsample([3,5,1,6,7], 3)
در این قطعه کوچک برنامه شما سه عدد به صورت تصادفی از لیست اعداد [3,5,1,6,7] انتخاب می کنید. حالا ممکن است شرایط قدری پیچیده باشد یعنی شما می خواهید انتخاب های شما با جایگذاری باشند. مانند یک کیسه توپ که پس از انتخاب دوباره آن را به کیسه برگردانید تا شانس دوباره ای به آن داده باشید. در این حالت کافی است آرگومان سوم(replacement ) را true کنید.
out = randsample([3,5,1,6,7], 3, 'true')
حالت های پیچیده تر هم ممکن است پیش بیاید! من در این جا یک مثال کاربردی ذکر می کنم: در الگوریتم کلونی مورچگان در قسمتی از الگوریتم(مهمترین قسمت آن) مورچه باید از بین چندین مسیر از نودی که در آن قرار دارد یکی را به صورت تصادفی انتخاب کند. . یک نما از این حالت را در شکل زیر می بینید:
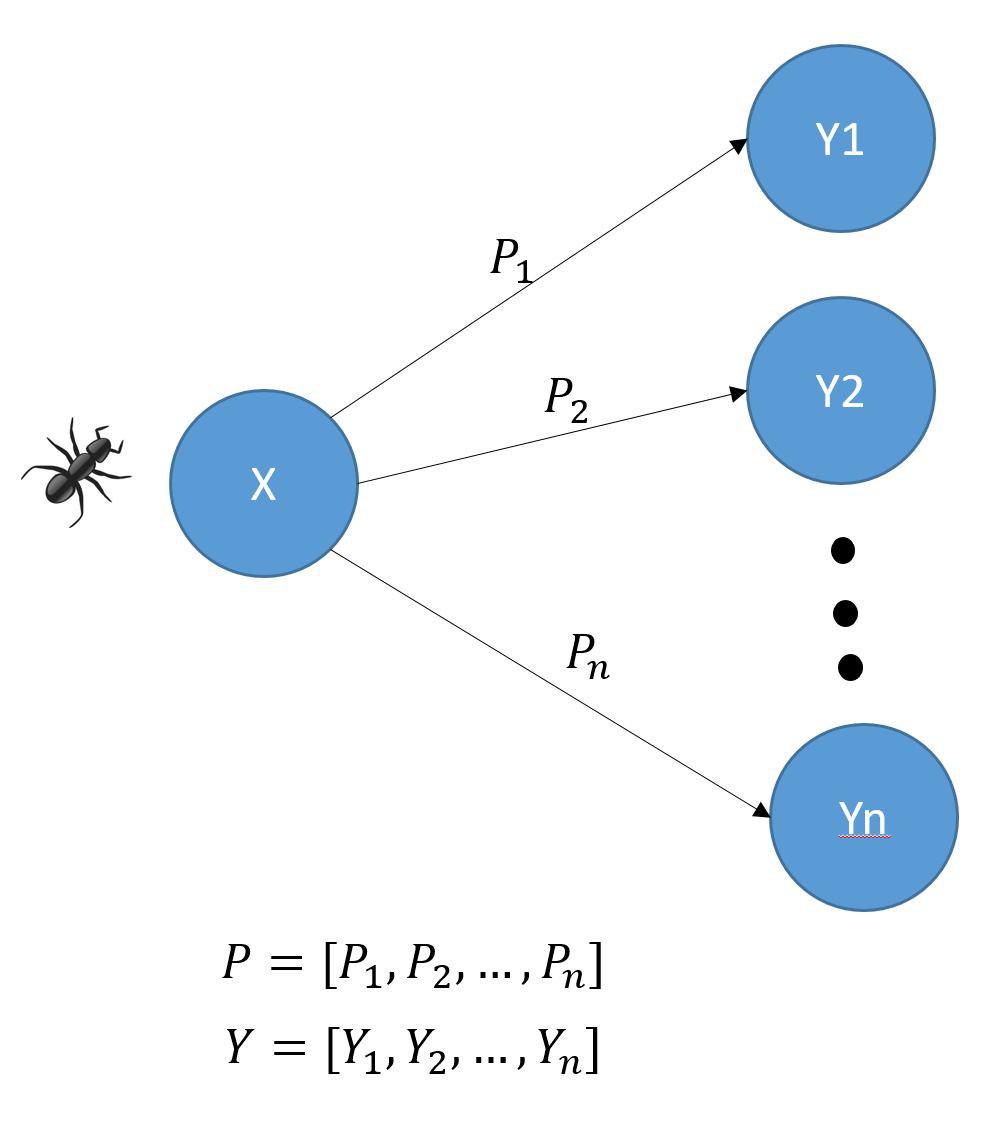
اما مساله این است که احتمال انتخاب مسیر ها با هم متفاوت است و بنابراین این احتمال را باید در انتخابمان لحاظ کنیم. فرض کنید پس از قرار دادن در فرمول (به الگوریتم کلونی مورچه مراجعه کنید) احتمال مسیر ها به صورت یک لیست 5 تایی به صورت [0.2, 0.1, 0.1, 0.05, 0.3, 0.05, 0.12, 0.08] به دست آمدند که به ترتیب متناظر با حرکت به سمت نود های [3,5,1,6,7] هستند. حالا چون ما می خواهیم فقط یک مسیر را انتخاب کنیم آرگومان چهارم که احتمال مسیر هاست را به صورت زیر به خورد تابع می دهیم:(وقتی یکی انتخاب می کنیم قاعدتا با جایگذاری یا بدون آن مهم نیست)
SelecteNode = randsample([3,5,1,6,7], 1, “true”,[0.2, 0.1, 0.1, 0.05, 0.3, 0.05, 0.12, 0.08] )
فراموش نکنید که لزومی ندارد حتما یک زیر مجموعه از نمونه ها را انتخاب کنید! شما می توانید بر اساس توزیع احتمالی که دارید نمونه تولید کنید. مثلا فرض کنید که می خواهیم یک دنباله 48 تایی از دنباله DNA را تولید کنیم با این دانش که از چهار پروتئین سازنده DNA یعنی (Adenine, Thymine, Guanine , Cytosine) احتمال حضور آن هریک در زنجیره ی مارپیچی به صورت زیر است:
R = randsample('ACGT',48,'true',[0.15 0.35 0.35 0.15])
با همین تابع شما می توانید مقدار زیادی کد، وقت و اعصاب از خودتان را ذخیره کنید!
در قسمت بعدی نشان می دهیم که چگونه می توان همین کار را برای یک تابع احتمال پیوسته انجام داد.

