
بخش بزرگی از آنچه جهان دیجیتال ما را شکل داده است ریشه در نظریه اطلاعات شنون دارد. نظریه ای قدرتمند که اساس نظری ارتباطات رادیویی و دیجیتال، کامپیوتر های امروزی، زبان های برنامه سازی و به طور خلاصه سنگ بنای آنچه به اسم «اطلاعات» می شناسیم است. با تمام موفقیت های چشم گیر این نظریه مشکلات فلسفی و نظری زیادی در مورد آن وجود دارد که خود شنون به وجود آنها آگاه بود. اما مشکل کار کجاست؟
فرض کنید یک نفر ادعا کند یک سکه سالم دارد با این حال او صد بار سکه را می اندازد و هر صد بار صفر (شیر) می آید. ما سریع اعتراض میکنیم که سکه مشکل دارد. با این حال آن شخص استدلال می کند که بر طبق نظریه احتمال هر دنباله از صد بار انداختن سکه دارای احتمال برابری است (1/2^100). و هر دنباله ی دیگری هم می آمد همین احتمال را داشت. به عبارتی «چیز خاصی» در صد بار آمدن صفر نیست!
نظریه احتمال هیچ پایه ای در اختیار ما نمی گذارد که نتیجه یک فرآیند تصادفی را بعد از آنکه رخ داد مورد چالش قرار دهیم. اما این مختصر به رویداد «صد بار صفر آمدن» نیست. مثلا اگر دنباله به صورت 1010101... بود چه؟ شهود ما به ما می گوید چنین «الگوهایی» همینطوری درست نمی شوند.
Regular sequence Pr(00000000000000000000000000) = 1/2^26,
Regular sequence Pr(01000110110000010100111001) = 1/2^26,
Random sequence Pr(10010011011000111011010000) = 1/2^26.
دنباله ی دوم هر چند به نظر تصادفی می رسد از الگوی ساده ای پیروی می کند 0,1,00,01,10,11 (دنباله اعداد باینری) اما دنباله سوم تست تصادفی بود را پشت سر می گذارد.
نظریه شنون نمی تواند به شما بگوید که یک دنباله تصادفی است یا نه. در عوض می تواند در مورد امید ریاضی (expectation) ویژگی های «منبع تصادفی» که دنباله را تولید می کند صحبت کند. به عبارتی ویژگی تصادفی در یک مجموعه از نمونه ها که همه توسط منبع تصادفی تولید شده اند. برای دقیق تر شدن این موضوع از «متغیر تصادفی» (random variable) استفاده می کنیم. «متغیر تصادفی» یک مقدار ثابت نیست بلکه همانطور که از اسمش هم پیداست یک متغیر است و مقید به یک «توزیع احتمال» است. به طور مثال اگر همان منبع به طور متوسط ۹۰ درصد خروجی هاش صفر باشد و ۱۰ درصد یک باشد این یک توزیع احتمال است و خود همین نشان دهنده ی یک نظم در «فرآیند تصادفی» (random process) ایی هست که میبینیم. الان متوجه می شوید که نظریه احتمال بسیار درشت دانه با مفهوم «الگو» یا «تصادف» بر خورد می کند. الگو از دید نظریه اطلاعات انحراف از توزیع یکنواخت (۵۰ درصد یک و ۵۰ درصد صفر) است! همین! این ساده سازی بیش از حد اگرچه صدمه زننده به نظر می رسد اما به طرز شگفت انگیزی موفق عمل می کند. تقریبا تمام الگوریتم های فشرده سازی یا انتقال اطلاعات از شبکه به ویژگی های آماری درشت دانه منابع تصادفی نگاه می کنند و نه تک تک پیغام ها. مهم نیست پیغام شما عدد پی باشد یا یک نامه اداری یا تصویر یک گل. اگر بتوان ویژگی های درشت دانه آماری از منبع تولید آن در آورد قابل فشرده سازی است. این البته چیزی بود که خود شنون کاملا به آن آگاهی داشت. در مقاله بسیار مهم او «یک نظریه ریاضی برای ارتباطات» (A mathematical theory of communication) بیان می کند:
مساله اساسی ارتباطات بازسازی دقیق یا تقریبی یک پیام در یک سوی کانال ارتباطی است که از سوی دیگر فرستاده می شود. معمولا پیام ها معنی دارند به این معنا که به یک سیستم مفهومی یا فیزیکی خاص مرتبط هستند یا همبستگی دارند. این ویژگی های معنایی ارتباطات به مساله مهندسی ربطی ندارند. جنبه اساسی این است که پیام واقعی یکی از پیام هایی است که از مجموعه ای از پیام های ممکن انتخاب شده است. سیستم باید طوری طراحی شود که برای هر انتخاب ممکن کار کند و نه فقط یک پیام خاص چون چنین انتخابی از قبل مشخص نیست...
با چنین حسابی مثلا هنگام فرستادن یک پیام به زبان فارسی یا انگلیسی آنچه اهمیت دارند فرکانس آمدن هر حرف (یا کلمه) است و نه اینکه مثلا بتوان جمله را خلاصه تر بیان کرد. فرکانس آمدن حرف e در انگلیسی از همه بالاتر است بنابراین بیت های کمتری به آن اختصاص می یابد و z از همه کمتر و بیت های بیشتری به آن اختصاص می دهند. به این شیوه به بهینه ترین روش برای انتقال اطلاعات می رسیم (بیشتر).
اما کولموگروف به مشکل چنین دیدگاهی پی برد او می نویسد:
روش احتمالاتی در نظریه انتقال اطلاعات بر روی کانال های ارتباطی که حجم های زیادی از اطلاعات که متشکل از پیام های بی ربط یا با ربط ضعیف که تنها از یک توزیع احتمال پیروی می کنند، یک انتخاب طبیعی به نظر می رسد. اما معنای واقعی اینکه بپرسیم چقدر اطلاعات در رمان «جنگ و صلح» است؟ آیا عقلانی است که رمان را در یک مجموعه از «رمان های ممکن» بررسی کنیم و حتی بر روی آن یک توزیع احتمال تعریف کنیم؟ یا، بگوییم صحنه های مجزای این رمان یک دنباله تصادفی با روابط تصادفی (stochastic relation)را تشکیل می دهند؟ [...] تعریف ما از اندازه ی اطلاعات این برتری را دارد که به اشیا تک ارجاع می دهد و نه شی به عنوان یک نمونه از یک مجموعه از اشیا با توزیع احتمالی بر روی آنها.
برای روشن شدن موضوع به یک مثال می پردازیم: به طور مثال فرض کنید که بخواهم n رقم اول عدد پی را به صورت پیام به شما برسانم. یک راه این است که تمام رقم ها را یکی یکی به شما بگویم. از دید شنون چنین کاری بهینه نیست بهتر است ببینیم هر کدام از رقم ها ( ۰ تا ۹) با چه فرکانسی تکرار می شوند. مثلا اگر ۱ بیشتر تکرار می شود منطقی ست که تعداد بیت کمتری به آن اختصاص داد. نکته ای که وجود دارد این است که پی عددی است که تعداد رقم هایش نامحدود است بنابراین نمیتوان فرکانس را به صورت دقیق دانست اما مانند هر فرآیند تصادفی ای می توان آن را تخمین زد. این تخمین نشان می دهد که فرکانس همه رقم ها با هم برابر است! (حدس زده می شود که پی یک عدد نرمال است یعنی توزیع رقم های آن برابر است اما چنین چیزی هنوز اثبات نشده است). به این ترتیب نظریه شنون عملا کمکی در فشرده سازی نمی کند چون هر رقم فرکانس برابری برای ظاهر شدن دارد! به این ترتیب عدد پی و یک عدد کاملا تصادفی به یک اندازه «فشرده ناپذیرند» (incompressible) کد پایتون زیر آنتروپی (میزان بی قاعدگی) عدد پی و یک عدد تصادفی را نشان می دهد.
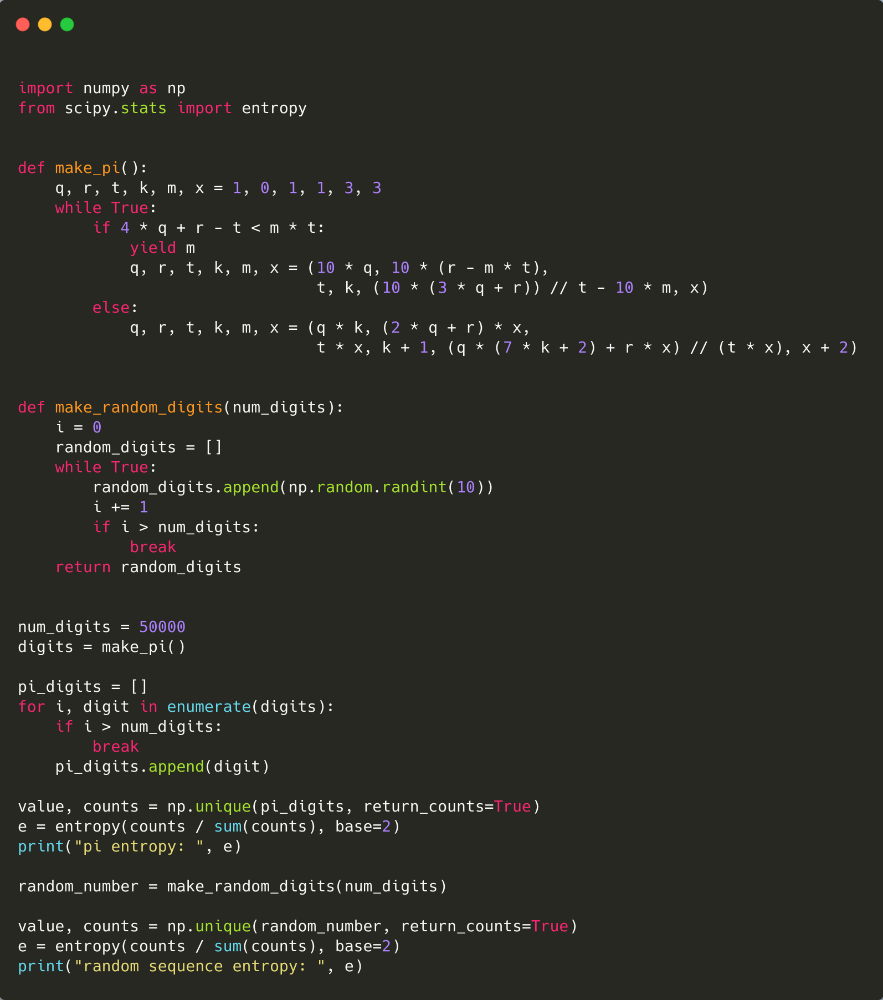
که خروجی آن می شود:
pi entropy: 3.3218434709282008
random sequence entropy: 3.321777392084359
همانطور که می بینید آنتروپی ها تقریبا برابر هستند ( هر قدر تعداد رقم ها بیشتر باشد این دو عدد نزدیک تر می شوند).
اما راه بهتر که مشخصا هر انسان عاقلی از آن استفاده می کند فرستادن برنامه تولید عدد پی و گفتن تعداد رقم هاست. به این طریق در آن سوی خط فقط کافی است که برنامه با ورودی ها اجرا شود! این دقیقا همان ایده کولموگروف بود. او متوجه شد برای بسیاری از دنباله ها برنامه تولید آن است که میزان «پیچیدگی» آن را تعیین می کند نه اندازه خود دنباله و نه ویژگی های آماری اش:
پیچیدگی کولموگروف: اندازه ی کوتاه ترین برنامه ای است که بتواند شی را تولید کند! (خروجی بدهد)
(منظور از اندازه برنامه اندازه بیتی است. دقت کنید برنامه و داده هر دو به بیت قابل اندازه گیری هستند!)
این تعریف به شدت مبهم به نظر می رسد: کدام برنامه؟ برای عدد پی ده ها فرمول وجود دارد و خود فرمول ها هم به زبان های مختلف برنامه نویسی می توان نوشت. طول چنین برنامه هایی یکی نیستند. کوتاه ترین؟ از کجا معلوم زبان برنامه نویسی ای نباشد که بتوان کوتاه تر نوشت.
کولموگروف نشان می دهد جزییات زبان برنامه نویسی اهمیتی ندارند. تفاوت از یک زبان برنامه نویسی به دیگری تفاوت یک ثابت است (به زبان دقیق تر O(1) ) آنچه اهمیت دارد این است که بعد از آنکه زبانتان را انتخاب کردید کوتاهترین برنامه برای آن چیست. آنگاه می توانید مقایسه کنید. به عبارتی انتخاب زبان برنامه نویسی شبیه به انتخاب دستگاه مرجع در فیزیک است. نتایج سرعت در دستگاهای مرجع مختلف با هم متفاوت است اما ما یکی را انتخاب کرده و بعد از آن دیگر تغییرش نمی دهیم.
از این نگاه ارقام عدد پی یک دنباله تصادفی نیست چون قابل توصیف با یک برنامه ساده است. اما از کجا بدانیم دنباله ای از صفر ها و یک ها اصلا تصادفی است؟ شاید قاعده ای دارد که ما نمی دانیم. کولموگروف به زیباترین شیوه «تصادفی» را تعریف می کند.
دنباله ای تصادفی است که نتوان هیچ برنامه ای یافت که اندازه ی آن از طول خود دنباله کوتاه تر باشد!
این با شهود ما در مورد تصادفی بودن همخوانی دارد. اگر بتوانی خلاصه تر از آن چیزی که هست توصیفش کنی (از دید بیتی) انگاه قابل فشرده سازی و بنابراین الگو دارد و بنابراین تصادفی نیست!
بنابراین از نگاه کولموگروف می توان برای یک دنباله تکی (مانند پی) هم آنتروپی (که یک معیار بی نظمی است) تعریف کرد برخلاف دیدگاه شنون که آنتروپی فقط متعلق به یک متغیر تصادفی (با یک توزیع احتمال) است. اما آیا ارتباطی بین مفهوم اطلاعات از دید شنون و کولموگرف وجود دارد؟ بررسی های ریاضی نشان می دهد که می توان ثابت کرد که ارتباط بسیار جالب و ظریفی بین این دو هست. در قسمت بعد به آن می پردازیم.

