
در حالی به عصر هوش مصنوعی صنعتی وارد می شویم و این تکنولوژی به زندگی عموم مردم وارد می شود، به ابزارهای شناختی ای دسترسی پیدا میکنیم که پیش از این قابل تصور نبود. این ابزارها مستقیما به ما در «فکر کردن» و فعالیت های شناختی کمک می کنند این کمک چیزی فراتر از ذخیره، بازیابی، جستجو و دسته بندی اطلاعات است. با این حال وقتی در مورد «هوش» این سیستم ها صحبت می کنیم باید با احتیاط بیشتری در مورد آن صحبت کنیم تا سو تعبیر های معمولی که در مورد «آگاه بودن»، «حیات داشتن» و «زنده بودن» وجود دارد، پیش نیاید.
در دهه ۱۹۶۰ بسیاری از زبان شناسان به تفاوت و تمایز بین «معنا» (semantics) و «نحو» (syntax) پی برده بودند. نوآم چامسکی به طور مشخص مثال های معروفی از جملاتی از زبان می آورد که دارای نحو صحیح هستند ولی هیچ معنایی ندارند مثل: «ایده های بی رنگ سبز به صورت خشمناکی میخوابند» نحو آنقدر بنیادی به نظر می رسید که می شد آن را به طور کامل جدا از معنا و ویژگی های دیگر زبان تعریف کرد. این تمایز به حدی خود را نمایان می کرد که چامسکی ایده ی «گرامر جهانی» (Universal Grammar) را معرفی کرد و اینکه حتی ممکن است انسان ها با ویژگی های زیست شناختی یا ژنتیکی خاصی به دنیا بیایند که این گرامر جهانی را به صورت پیشینی را با خود دارند. با این حال استفاده ی روزمره ی زبان نشان می دهد ما همیشه گرامر را رعایت نمیکنیم اگر چنین موارد جزیی را کنار بگذاریم، گرامر خود را چون استخوان زبان نشان میدهد که معنی تنها لباسی است که بر روی آن قرار می گیرید. اگر جدال های مربوط به گرامر جهانی و فقر محرک ها (Poverty of stimuli) را کنار بگذاریم چیزی که می دانیم این است که با داشتن گرامر می توان جملات مختلف را تولید کرد. به همین خاطر به آن گرامر تولید کننده (generative grammar ) هم می گویند. به طور مثال اگر شما درخت گرامری خاصی مثل یک جمله ی پرسشی را داشته باشید فقط کافی است که اسم را با یک اسم فعل را با یک فعل و صفت را با صفت از دیکشنری جایگزین کنید تا یک جمله ی درست تولید کنید. مشکل اساسی اما اینجاست که این جملات نه لزوما راست هستند و نه حتی معنی دار!
مساله ی معنی بسیار دشوار تر از چیزی بود که ابتدا نشان می داد و نیاز به نگاهی فراتر از روش های صوری داشت. به همین خاطر توجه به بازنمایی دانش (knowledge representation) بیشتر شد. همزمان با رشد تکنولوژی های دیجیتال و ظهور اینترنت پروژه های مختلفی ظهور پیدا کردند که هدف اصلی شان بازنمایی نه تنها دانش به معنای معمول آن یعنی دانش factual بلکه هر نوع اطلاعاتی از جهان و مهم تر از همه دانش متعارفی (common sense) می شد.دانش متعارفی به نوعی از اطلاع نسبت به جهان خارج گفته می شود که معمولا به صورت صریح جایی نوشته نشده است اما انسان ها همگی در اثر تعامل با جهان خارج آن را می آموزند. مثلا:
نوع اول دانش را می توان در پروژه های به نسبت موفق تری مانند wikipedia, dbpedia و مهم تر از همه گراف دانش گوگل (google knowledge graph) دید اما برای دانش متعارفی این تلاش ها به همان اندازه موفق نبود به طور خاص پروژ هایی چون Cyc و YAGO که به منظور بازنمایی دانش متعارفی اغاز شده بودند با صرف هزینه ها و زمان زیاد با شکست موجه شدند. بنظر می رسید چنین دانشی آنقدر وسیع و تجربه ی روزمره ی افراد آن قدر گسترده است و از طرفی این تجربه آنقدر حالت های استثنا دارد که چون دریایی بی انتها می ماند و هر گونه تلاشی برای نوشتن آن بی فایده است!
چالش دیگر استدلال متعارفی (common sense reasoning) است. استدلال متعارفی به توانایی انسان برای پر کردن جاهای خالی در برخورد با مسایل روزانه گفته می شود. برای این کار ما مجهز به دانش متعارفی در مورد جهان هستیم. توجه کنید این استدلال در بسیاری از مواقع با منطق ریاضی یا فلسفی تفاوت های زیادی دارد. به طور مثال روانشناسی عامیانه (Folk psycology) به عنوان یک نوع از استدلال متعارفی به توانایی ما در تشخیص احساسات و نیت های افراد برای انجام کارها و رفتارهای مشخص گفته می شود. از طریق روانشناسی عامیانه است که ما می توانیم دیگر انسان ها درک کنیم و به طور کلی روابطمان با بقیه را تنظیم کنیم. روانشناسی عامیانه می تواند خود را در نظریه ذهن (theory of mind) نشان می دهد. به طور مثال:
مثال دیگر فیزیک عامیانه (Folk physics) است که توسط آن ما درک عمومی از زمان، فضا و اشیا داریم. این توانایی به ما کمک میکند موقعیت های فیزیکی را درک کنیم و در جهان فیزیکی حرکت کنیم. دلیل تعریف آن به عنوان عامیانه این است که فیزیکی که ما از جهان درک میکنیم معمولا اشتباه و انطباق زیادی با فیزیک تجربی ندارد ولی با این حال «مفید» است. مثال های معمول فیزیک عامیانه:
این نوع درک شهودی به ما کمک می کند تا علت و معلول ها و استدلال های زمانی را درک کنیم. به مانند بازنمایی دانش متعارفی، استدلال متعارفی هم بسیار چالش برانگیز و مدل سازی آن دشوار است. تلاش های اولیه برای مطالعه ی استدلال متعارفی معطوف به گسترش سیستم های صوری برگرفته از ریاضیات و منطق به منظور مدلسازی ویژگی های خاص این نوع استدلال بود. یکی از موضوعات پژوهشی جالب در این مورد استدلال ربایشی (abductive reasoning) است که برای اولین بار توسط چارلز پیرس (Charles Pierce) که به پدر عملگرایی آمریکا هم شهرت دارد مورد بررسی قرار گرفت. استدلال ریایشی شاید نزدیک ترین نحوه ی استدلال به روش استدلال متعارفی باشد که در آن برخلاف استدلال استقرایی یا استنتاجی هدف تولید مجموعه ای از فرضیات با داشتن تعداد محدودی از مشاهده است. به طور مثال اگر شما به خانه برگردید و شیشه ی پنجره شکسته باشد می توانید «استدلال» کنید که دزد شیشه را شکسته یا سنگ به آن خورده یا یک پرنده به آن محکم خورده است. این نوع استدلال با نحوه ی استدلال بیزینی (Bayesian Inference) ارتباط بسیار نزدیکی دارد چرا که هدف آن تولید و ارزیابی مجموعه ای از فرضیات است که محتمل تر بنظر می رسند. پرداختن بیشتر به این نوع استدلال از حوصله ی این بحث خارج است ولی می توانید اینجا بیشتر روی آن مطالعه کنید.
اما مدل های زبانی می توانند تمام این پیچیدگی ها را با تعریف مساله ی به ظاهر بی اهمیت «پیش بینی کلمه ی بعدی» حل کنند! مدل های زبانی به صورت طبیعی «تولید کننده» (generative) هستند. به این معنا که یک بخش از متن را به صورت ورودی گرفته و با توجه به آن کلمه ی بعدی و بعدی را تولید می کنند. این تا حدی شبیه به گرامر هایی است که درباره ی آن ها صحبت کردیم با این تفاوت که در اینجا بازنمایی صحیح دانش و استدلال های متعارفی و بسیاری دیگر از ریزه کاری های زبانی که از نحو ساده فراتر می رود به صورت خودکار رعایت می شود. این مدل ها همچنین تصویر سنتی از مهندسی سیستم های خبره (expert system) و هوشمند و حتی نحوه ی دید معماری گونه در مورد این سیستم ها که حتی به دانش مغز هم سرایت کرده است ( ادامه ی نظریات شبه علمی ای چون phrenology) را مورد چالش جدی قرار می دهد. در تصویر سنتی سیستم هوشمند ساختاری ماجولار دارد که در آن پایگاه دانش، موتور استنتاجی و بخش های دیگر جدا از هم هستند. این در حالی است که مدل های زبانی مبتنی بر شبکه های عصبی چند لایه تمامی این ماجول ها را یکجا در خود دارند. هیچ بخش جداگانه ای برای استدلال یا ذخیره ی دانش وجود ندارد همه چیز در وزن ارتباطات شبکه ذخیره شده است!
اگر این مدل ها تنها تولید کننده ی زبان هستند نمی توان آن ها را «زنده» یا «هوشمند» نامید بلکه آنها صرفا سیستم های بسیار پیچیده ای هستند که آنقدر در شبیه سازی استفاده از زبان در تمامی جنبه های آن، از مکالمات روزمره، تکنیکی، شعر، انتقادی و غیره موفق هستند که عملا ما را گول می زنند!
دانستن این نکته مهم است که chatgpt با اینکه یک سیستم خارق العاده است نمی تواند دانش جدید تولید کند. به این معنا که چنین سیستمی قادر نیست که از جهان خارج نمونه برداری کرده و نتایج جدیدی بگیرد. اما این به آن معنا نیست چنین سیستمی نمی تواند مفید باشد بلکه کاملا برعکس در بسیاری از مواقع آنچه ما به عنوان «فکر کردن» می شناسیم چیزی جز گشتن در اطلاعات موجود و نتیجه گیری از آن ها نیست. اما در بسیاری از مواقع این اطلاعات به صورت صریح در ذهن ما وجود ندارد. به طور مثال دو قطعه اطلاعات زیر را در نظر بگیرید:
۱- شما می دانید که گیاهان نیاز به نور برای رشد دارند چون نور لازمه ی فوتوسنتز است.
۲- شما می دانید که میزان نور خورشید با توجه به زمان روز متفاوت است و معمولا بیشترین نور در حدود ظهر رخ می دهد.
از این دو قطعه اطلاعات می توانید نتیجه بگیرید گیاهان در طول روز در نزدیک ظهر بیشترین رشد را دارند. چنین اطلاعات جدیدی نتیجه ی «منطقی» اطلاعات پیشین است اما شاید ما به صورت صریح هرگز به آن فکر نکرده باشیم.
این مشاهده جالب است چرا که نشان می دهد chatgpt می تواند اطلاعات موجود را بگیرد و اطلاعات جالب جدیدی را تولید کند که هرگز به آن فکر نشده است. با این حال «فکر کردن» قطعا چیزی فراتر از پر کردن حفره های دانش به این طریق است. «کنجکاوی»، «مشاهده» و حتی بخش زیادی از «شهود» معانی ای فراتر از «شناخت» پیاده سازی شده در مدل های زبانی کنونی دارند. توجه بیش از حد به «شناخت» (cognition) به عنوان مهم ترین کارکرد مغز بشر باعث شد بسیاری به این باور برسند که تمرکز اصلی تنها باید بر روی سیستم های شناختی و شبیه سازی آن باشد. با این حال این باور قدیمی مورد چالش های جدی قرار گرفته است ولی همچنان اثر قوی اش را در رشته هایی چون هوش مصنوعی و حتی علوم عصب شناسی می توان دید.
بخش دیگری از توانایی ChatGPT در دسترسی اش به بدنه ی عظیمی از دانش و اطلاعات در حین آموزش برمیگردد که عملا خارج از توانایی یک شخص عادی برای مطالعه آن همه اطلاعات است. به طول مثال نمودار زیر یک تخمین است که نشان می دهد در بهترین حالت یک فرد در حدود بیست سالگی حدود ده هزار تا صد هزار برابر کمتر از GPT3 کلمه دیده است.
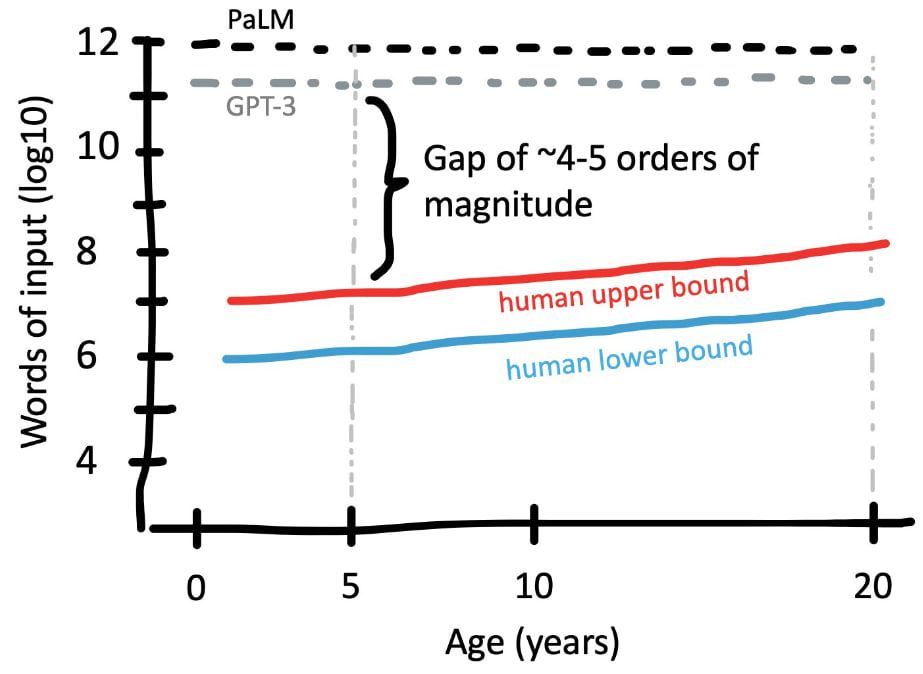
بنابراین قصور در توانایی های استدلالی یا یافتن همبستگی ها در چنین سیستم هایی معمولا با داده های عظیم جبران می شود.
مدل های GPT در اساس مدل های بسیار ساده ای هستند. تصور کنید بتوانید به سی یا چهل سال پیش برگردید و به زبان شناسان، دانشمندان علوم داده و هوش مصنوعی و حتی فیلسوفان بگویید که برای حل مساله ی «شناخت سطح بالا» (higher cognition) مانند استدلال متعارفی، داستان گویی، استدلال ریاضی،شعر و برنامه نویسی و آشپزی و پزشکی و تقریبا هر تخصص دیگری یک روش ساده وجود دارد که برای درک آن به ریاضی ای فراتر از دبیرستان نیاز نیست. تمام این افراد از تعجب شاخ در می آوردند!
مدل های ترنسفورمر که قلب GPT هستند بر مکانیزم attention متکی هستند که چیزی جز یافتن همبستگی بین کلمات در یک متن و پیش بینی کلمه ی بعدی نیست! نه خبری از معادلات دیفرانسیل عجیب و غریب و نه فیزیک کوانتوم یا حتی احتمال بیزینی اینجاست! البته نباید منکر شد که پیچیدگی های زیادی در جزییات مهندسی چنین سیستم هایی وجود دارد اما اساس خود مدل ها به شدت ساده است.
نتیجه ی داستان این است که بسیاری از بخش های «شناخت بشر» با مدل های بسیار ساده تر از آنچه قبلا تصور می شود قابل شبیه سازی است. با این حال این موضوع به این معنی نیست که مغز ساده است اما ممکن است به این معنی باشد که شاید مکانیزم های ساده ای در مغز هم وجود دارد که به پیچیدگی و هوشمندی و در نهایت آگاهی منجر می شود.
کار کردن با ChatGPT شگفت انگیز است چون به شما نشان می دهد چقدر می توان در مورد جهان تنها از طریق دسترسی به داده ی متنی دانست! با این حال باید بر این نکته تاکید کرد که وقتی می گویم مدل های زبانی این «زبان» در یک معنای محدود «متنی» مورد استفاده قرار گرفته و به معنای کلی «زبان» نیست. زبان یک پدیده ی پیچیده است که فراتر از متن می رود و به صورت، لهجه و واج شناسی (phonology)،عمل و شناخت متجسم (embodied cognition) و بسیاری از چیزهای دیگر خود را نشان می دهد. زبان از طریق رفتار و عمل در جهان و بازخورد از آن (اشیا و موجودات و انسان ها و غیره) آموخته می شود: چیزی که مدل های زبانی هیچ دسترسی ای به آن ندارند.
اصل مهمی که در تحقیقات پردازش زبان طبیعی برای دهه ها راهنمای پژوهشگران بوده است را می توان در جمله ی مهم زبان شناس فقید جان رابرت فیرث (John Robert Firth) خلاصه کرد:
« یک کلمه را در همراهانی که دارد درک می کنی»
رابرت فیرث ۱۹۵۷
ایده ی فیرث بسیاری از هم دوره ای هایش را تحت تاثیر قرار داد و منجر به چیزی شد که امروز به نام «مکتب لندن» در زبان شناسی شناخته می شود. ایده های او بعد ها «معنا شناسی شناختی» (cognitive semantics) که توسط جورج لاکوف (George Lakoff) معرفی شد را تحت تاثیر قرار داد. ایده ای که منجر به مفهوم «شناخت بدنمند(متجسم)» (embodied cognition) شد.
معنا شناسی توزیعی (distributional semantics) از ایده های فیرث می آید و بیان می کند «فقره های زبانی با توزیع مشابه دارای معنای مشابه هستند» به طور مثال کلماتی چون «موز» و «سیب» توزیع های زبانی مشابهی در متون دارند به این معنا که با کلمه هایی چون «خوردن»، «ویتامین»، «گیاه» و غیره همراهی بیشتری دارند تا کلماتی چون «کنگره»، « موش» یا «سرداب». این ایده ی نسبتا ساده اساس روش های embedding کلمات است که آن ها کلمه به صورت بردارهایی در یک فضای با بعد دلخواه بازنمایی می شوند. این بازنمایی برای روش های بعدی که بنیاد GPT بود بسیار اساسی تلقی می شود. دیدگاه فیرث نسبت به بسیاری از زبان شناسان هم دوره اش تفاوت های اساسی داشت که بیشتر به دنبال ساختن سیستم های تحلیلی، منطقی یا ساختار های کتگوریکال بودند. فیرث از سیستم سازی عبور کرد و به دنبال تعاریف عملی گشت.
از یک دیدگاه عمیق تر فلسفی، معنا از رابطه با جهان ایجاد می شود مفهومی که بیشتر به ویتگنشتاین متاخر منصوب است. ویتگنشتاین معنای کلمات را در کاربرد آن ها می دانست و نه تعاریف متافیزیکی. با این حال در اینجا باید دقت کرد که «کاربرد» فراتر از متن گرایی ( contextualims) در داده ی نوشتنی می رود و به معنای کلی آن است.
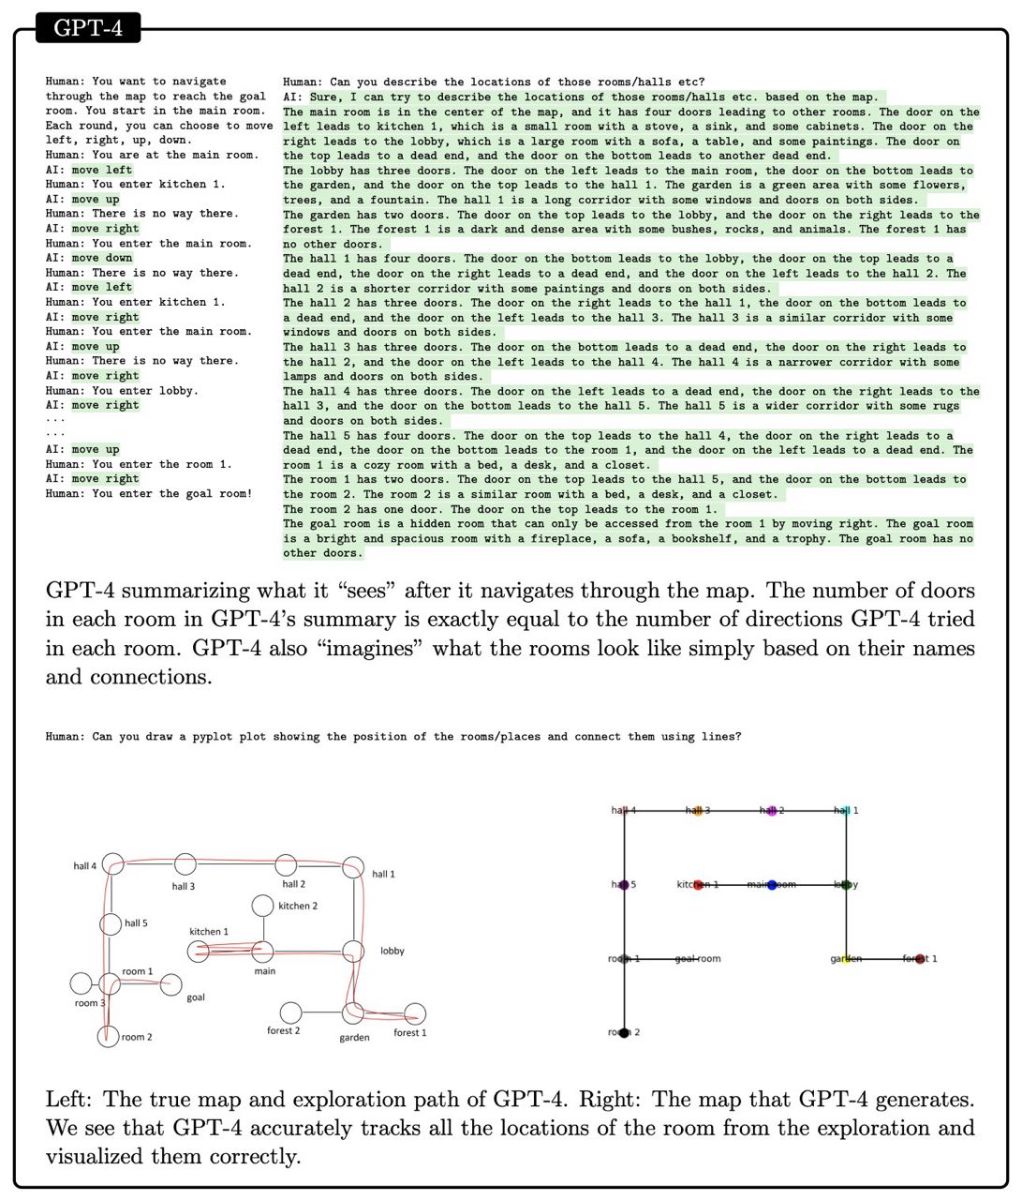
تعیین اینکه چقدر از این «کاربرد» در مدل های زبانی بزرگ نهفته است، سوال چالش بر انگیزی است اما نگاهی به عملکرد خارق العاده ی این مدل ها در درک اینکه چگونه کلمات در موارد مختلف مورد استفاده قرار می گیرند نشان می دهد متن به تنهایی حاوی اطلاعات بسیار زیادی است، شاید بیشتر از آنچه قبلا تصور میشد. به طور مثال شاید به نظر برسد فهم فیزیکی جهان نیازمند «عمل» در جهان است با اینحال چنین مدل های نشان می دهند تا حدود زیادی از اینکه چگونه جهان فیزیکی اطراف ما کار می کنند خبر دارند بدون اینکه اطلاعات مستقیمی از آن گرفته باشند. به طور مثال نمونه ی زیر از توانایی GPT4در حرکت در یک نقشه ی خیالی که توسط کاربر ترسیم شده است پرده بر میدارد. این مدل به راحتی در نقشه حرکت می کند و دقیقا می گوید کجاست و چگونه می توان به نقطه ی دیگر رسید! چیزی که ما به عنوان تصور فضایی می شناسیم!
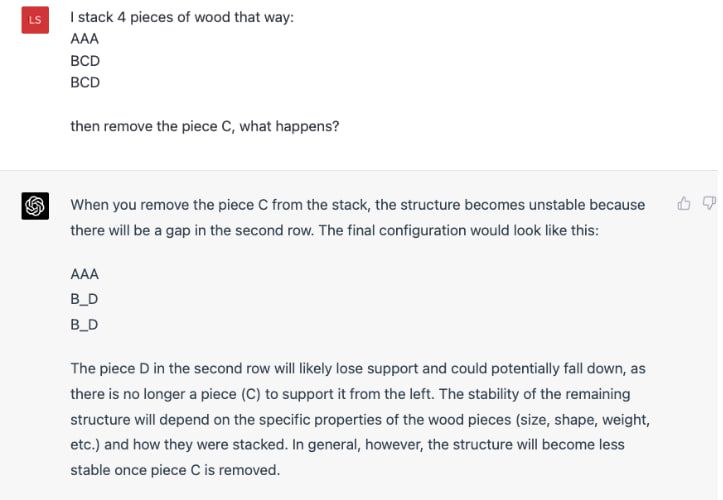
مثال دیگر نشان دهنده ی درک جاذبه ی ChatGPT است
یا استدلال ربایشی را در نظر بگیرید که نیازمند درک عمیق دانش متعارفی است که ما با استفاده از قدرت مدل تولیدی مغزمان (generative model) از عهده ی ما بر می آییم.
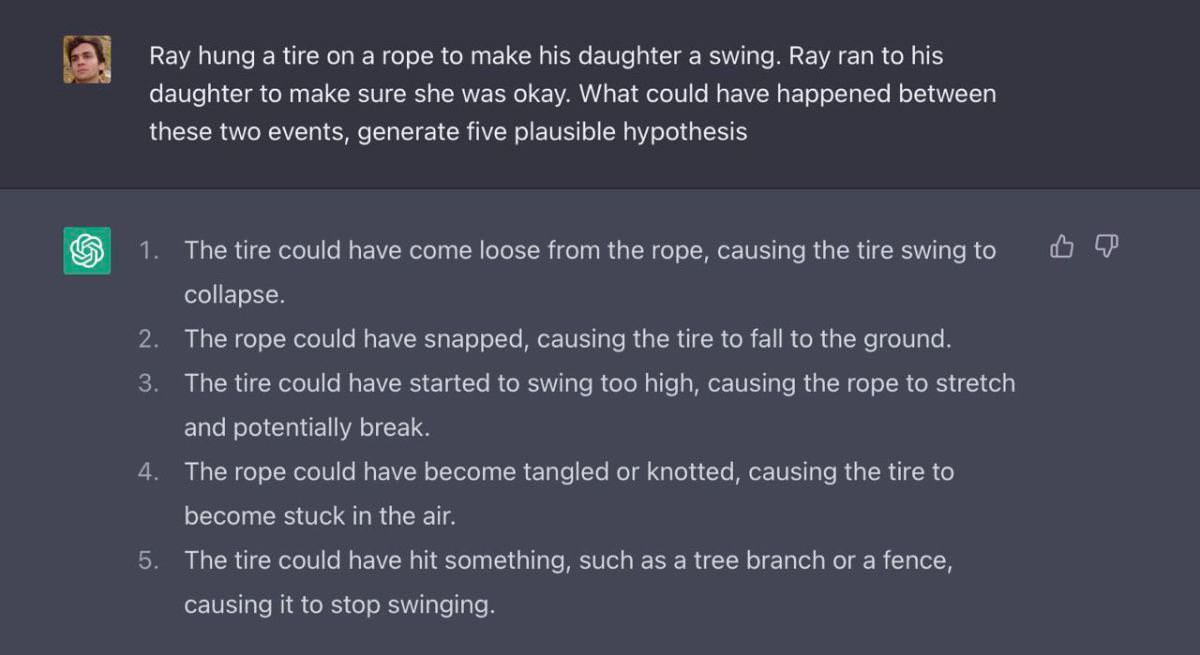
موارد بسیار بیشتری هست که می توان به آن پرداخت و بیشتر از توانایی این مدل ها در فهم جهان تحت تاثیر قرار گرفت.
با این حال باید به این نکته توجه کرد که این مدل ها بسیار ناکارآمد هستند به این معنا که برای رسیدن به سطحی از درک از جهان که یک کودک سه ساله براحتی به آن می رسد در عمل نیاز به خوردن تمام متن های جهان (کتاب ها مقالات بلاگ ها و اخبار و غیره) دارند. برخی احتمال می دهند دلیل چنین نا کارآمدی تکیه ی بیش از حد بر روی تنها متن است اما چنین سوالی یک مساله ی باز است.
بر اساس آنچه تاکنون درک کرده ایم مدل های زبانی بزرگ می توانند جنبه های زیادی از جهان را درک کنند که فراتر از توانایی هر شخص است. این ویژگی یکتا یک فرصت منحصر بفرد به این مدل ها می دهد و آن کاوش کردن بخش هایی از دانش کلی بشر است که به طور معمول یافتن آن ها زمان بر است. حفره های زیادی در فهم ما از جهان وجود دارد که لزوما نیازی به نگاه کردن به بیرون و جمع آوری داده های بیشتری ندارد. به طور مثال اخیرا کشف شده است که برخی از شکل های باستانی به صورت فراکتال هستند این در حالی است که هم این شکل های باستانی دهه هاست کشف شده اند و هم فراکتال ها مدت هاست شناخته شده اند با این حال این یافته جدید است! تنها مشکل این بود که کسی این دو را به هم ربط نداده بود. تصور کنید یک موتور قدرتمند تحلیل دانش بتواند در تمام دانش بشر کنکاش کرده و یافته های جدیدی پیدا کند که شاید دهه ها طول بکشد تا به طور عادی کشف شود.
این نکته شاید جالب ترین و هیجان انگیز ترین امکانی باشد که مدل های زبانی بزرگ با خود می آورند. باید منتظر شد و دید چگونه افراد مختلف ایده های جدیدی را برای عملی کردن آن می یابند.

