یک توزیع احتمال تابعی است که به هر رویداد یک احتمال نسبت می دهد مانند انداختن یک سکه با رویدادهای شیر یا خط و احتمال هر کدام هم 0.5 است. پس کافی است داده ها را جمع آوری کرده و احتمال روی دادن اتفاقاتی که می خواهیم را حساب کنیم. مثلا اگر داده هایمان تصاویر ساحل باشند. احتمال اینکه یک پیکسل خاص ساحل را نشان دهد را به صورت مجموع پیکسل های ساحل در تمام عکس ها تقسیم بر تمام پیکسل های تمام عکس ها میکنیم. به این نحوه دید به محاسبه ی احتمال، روش فرکانسی گفته می شود. به این ترتیب با داشتن حجم زیادی از داده می توان یک توزیع احتمال تجربی به دست آورد. به جای عکس ها یک مثال ساده تر را در نظر بگیرید. فرض کنید من قد تعدادی افراد را یادداشت کرده ام. دراین صورت می توان توزیع احتمال تجربی به صورت زیر داشته باشم:
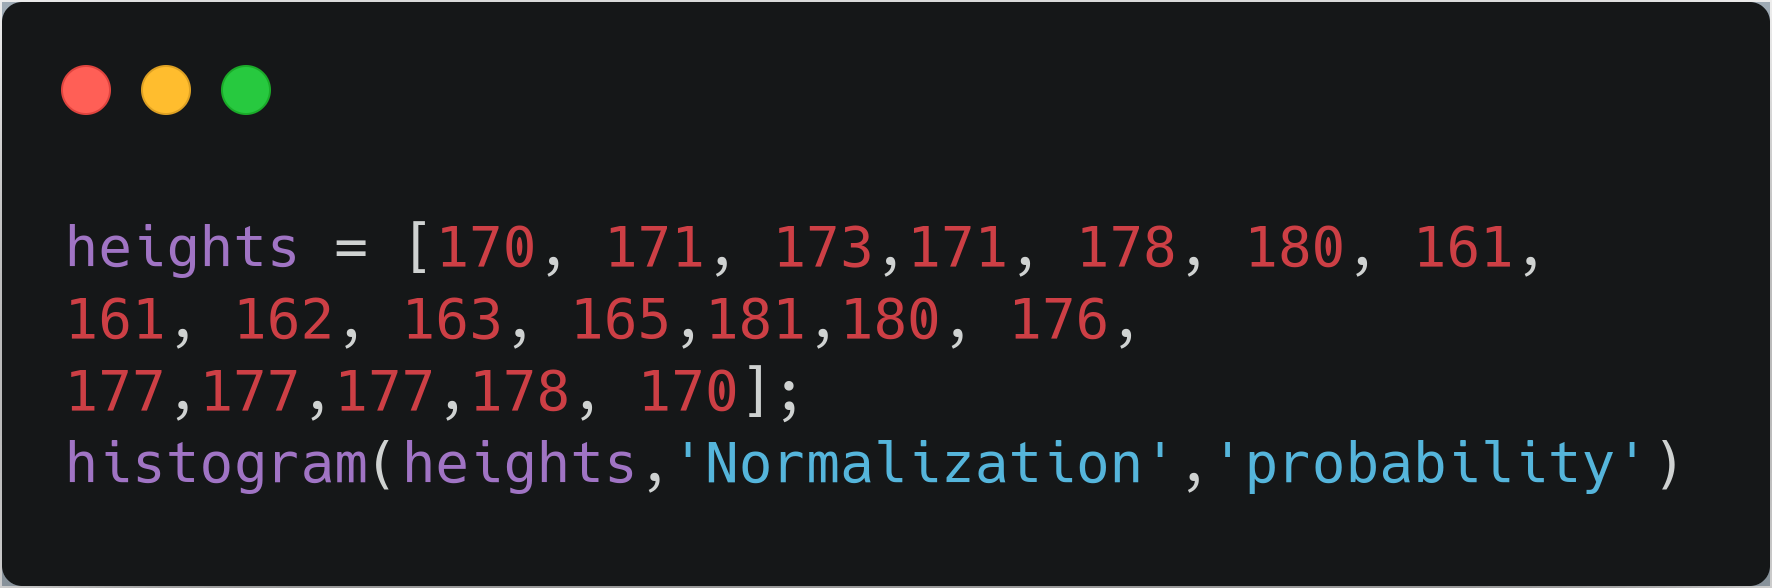
که به صورت زیر است:
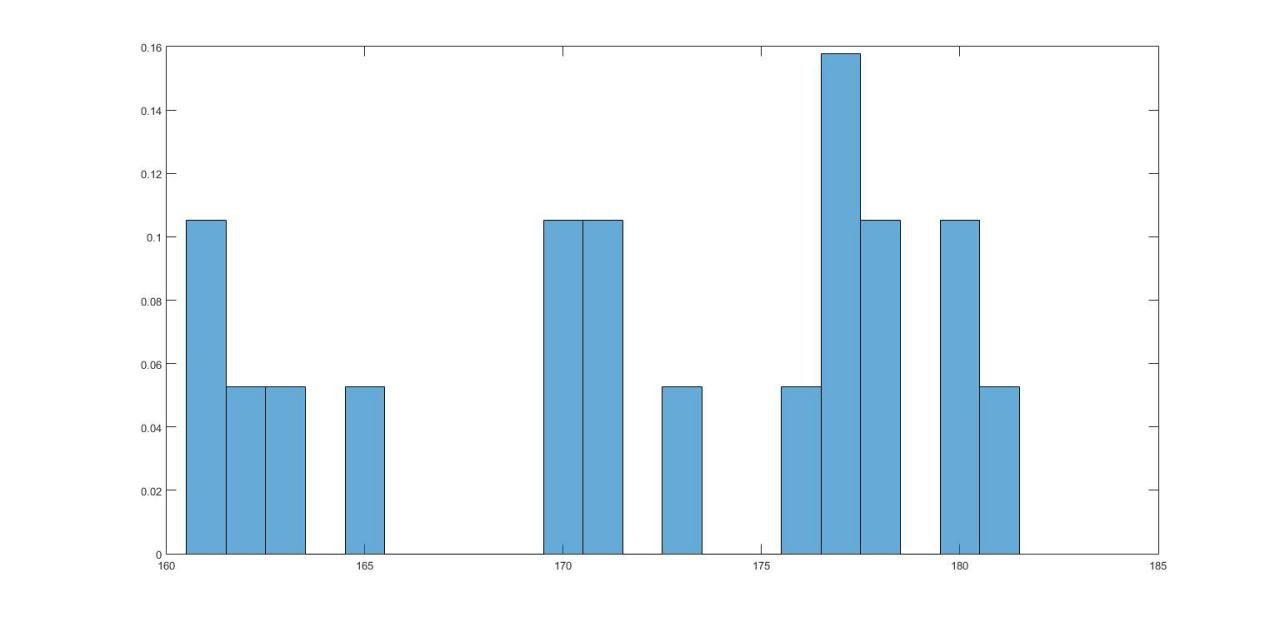
مشکلی که ممکن است تاکنون متوجه شده باشید این است که ما همواره با داده های محدودی سر و کار داریم و معلوم نیست احتمال داشتن قد 180 تقریبا برابر با 0.1 باشد. در این جاست که باید از یک مدل علمی مانند تمامی شاخه های دیگر علم استفاده کنیم. مدل آماری(statistical model) یک قانون ریاضی است که ما فرض می کنیم داده ها از آن می آیند. مدل آماری ما را قادر می سازد نمونه های جدید بر اساس نمونه های اندکی که دیده ایم ایجاد کنیم!(مانند پست های قبلی که نمونه های جدید از نمره های افراد را ایجاد می کردیم) این نمونه های جدید برای پیش بینی مورد استفاده قرار می گیرند. اما مدل ها خود به دو دسته تقسیم می شوند: مدل های پارامتریک و غیر پارامتریک. مدل های پارامتریک دارای تعداد محدودی پارامتر هستند مانند توزیع گاوسی (نرمال) که دارای دو پارامتر میانگین و واریانس است. اما مدل های غیر پارامتریک دارای تعداد بی نهایت پارامتر هستند و فراتر از مباحث اینجا می باشند(در آینده به آن ها می پردازیم).
نرم افزار متلب روشی ساده برای ایجاد بسیاری از توزیع های شناخته شده و معروف در اختیار ما می گذارد. به طور مثال می توان توزیع نرمال را به صورت زیر تعریف و از آن نمونه گرفت:
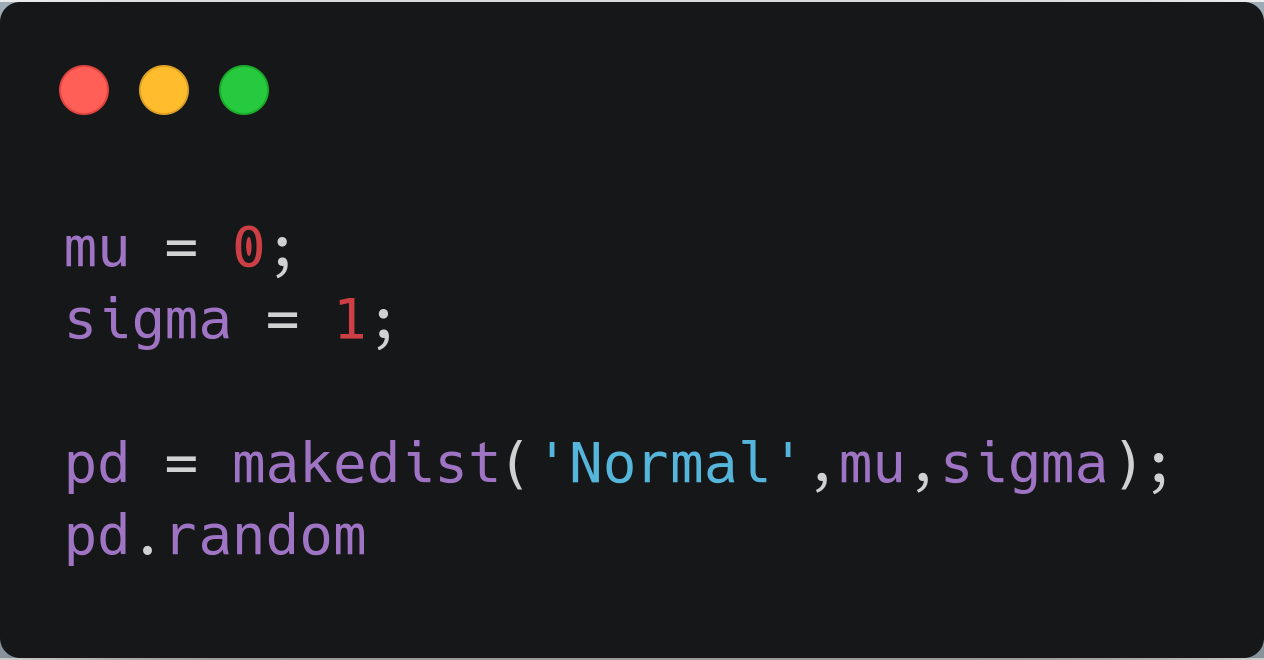
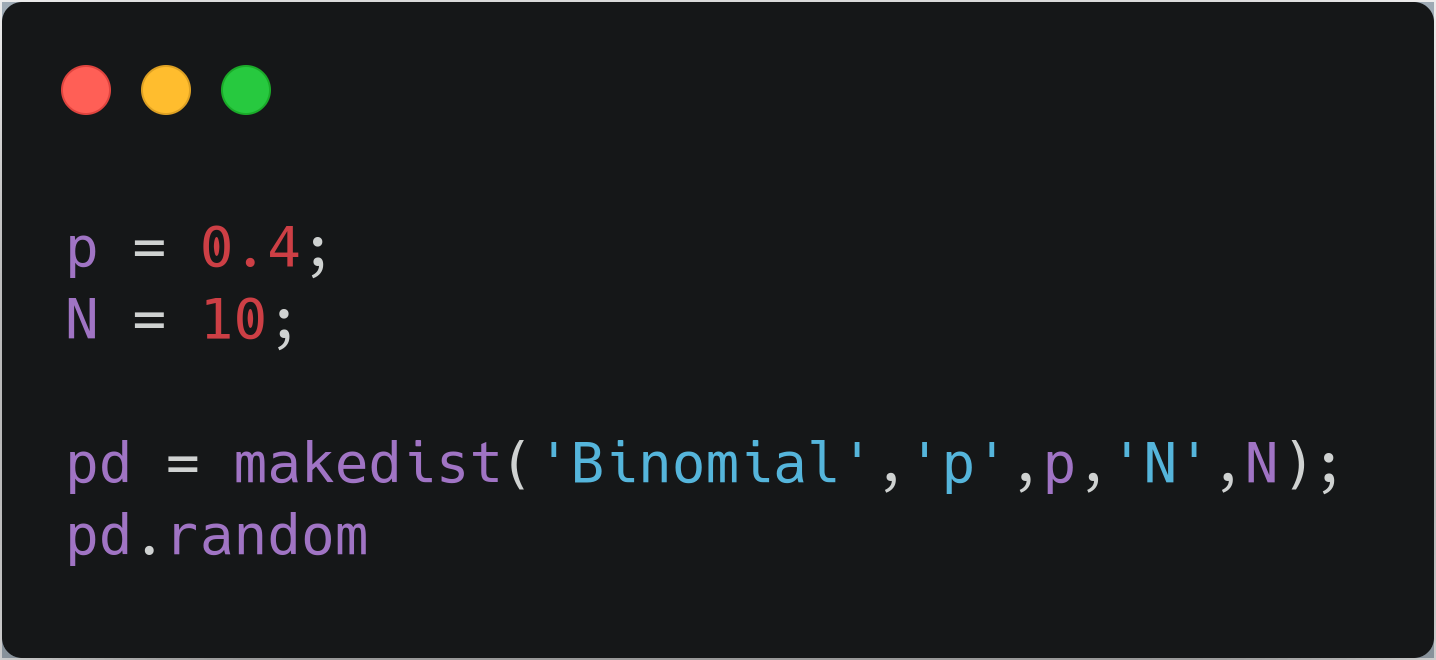
شاید تصور کنید که روش ساده تری هم برای این کار وجود دارد که همان استفاده از تابع randn است. اما باید توجه کرد با روش بالا تقریبا هر توزیعی را می توان مورد استفاده قرار داد. به طور مثال توزیع دو جمله ای با پارامتر های احتمال 0.4 و تعداد تکرار 10 به صورت زیر می توان نمونه گرفت:
توزیع چند جمله متناظر با احتمال k موفقیت در N آزمایش با احتمال موفقیت p است. با تابع چگالی احتمال:
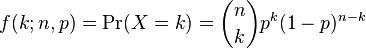
مثلا برای همین توزیع بالا احتمال 5 موفقیت و 3 موفقیت به صورت زیر حساب می شوند:
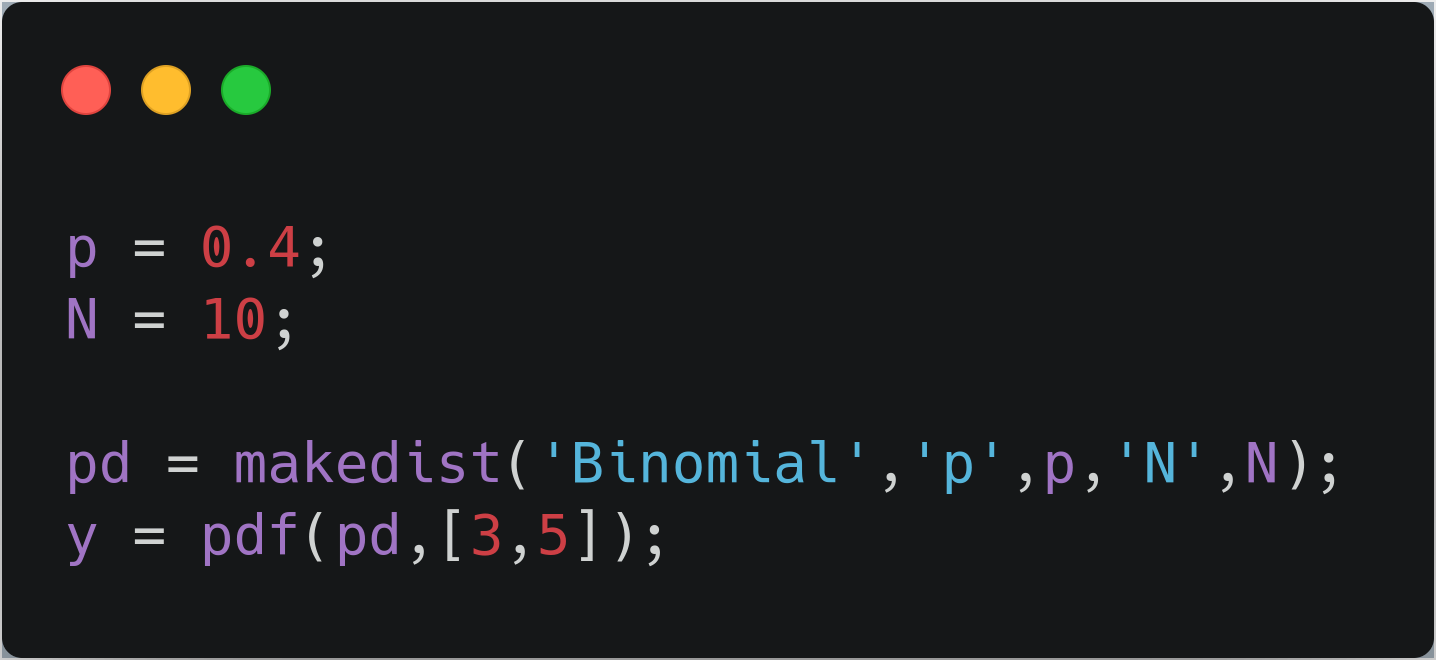
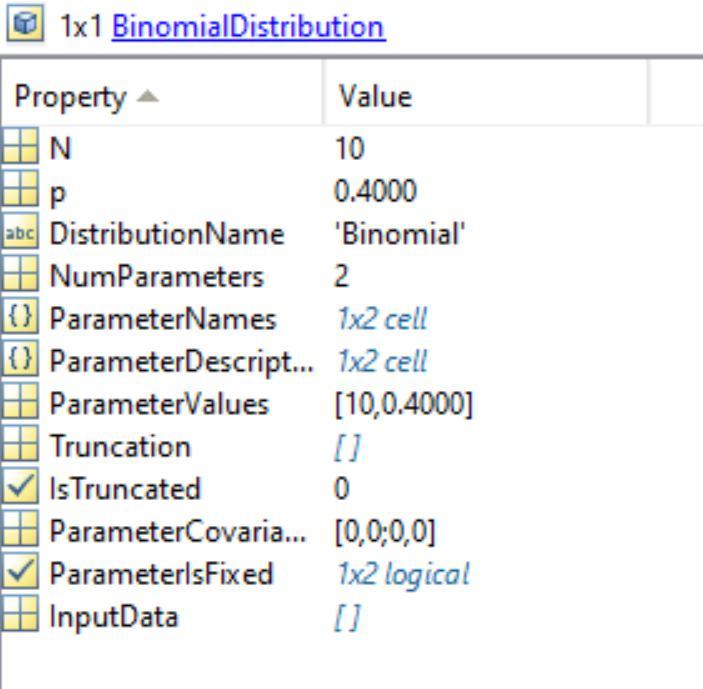
که در آن pdf تابع توزیع احتمال است. همین جا بهتر است متوقف شوید. دو مفهوم توزیع احتمال(probability distribution) و تابع چگالی احتمال (probability density function) را با هم اشتباه نگیرید. اولی در اصل همان مدل آماری ماست که استفاده می کنیم و شامل پارامتر ها وتنظیمات دیگر است در حالی که دومی فقط تابع ریاضی نشان دهنده احتمال هر پیش آمد است. در متلب می توانید توزیع احتمال چند جمله ای را به صورت زیر ببینید:
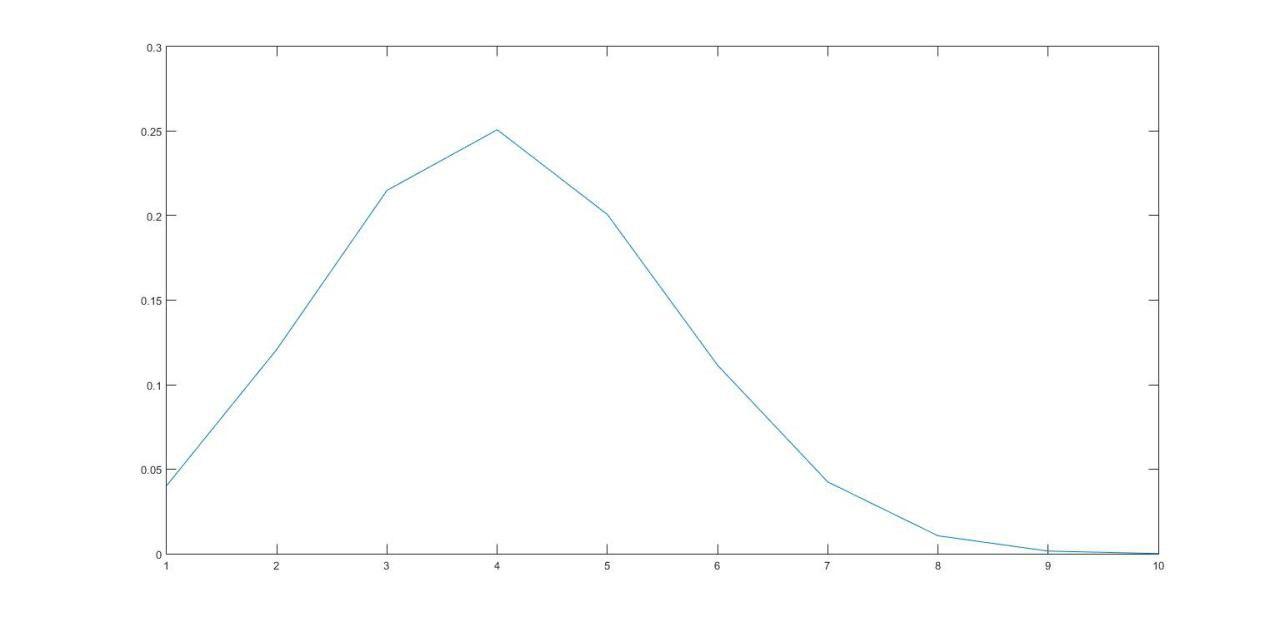
در نهایت می توان به صورت زیر این توزیع را رسم کرد:
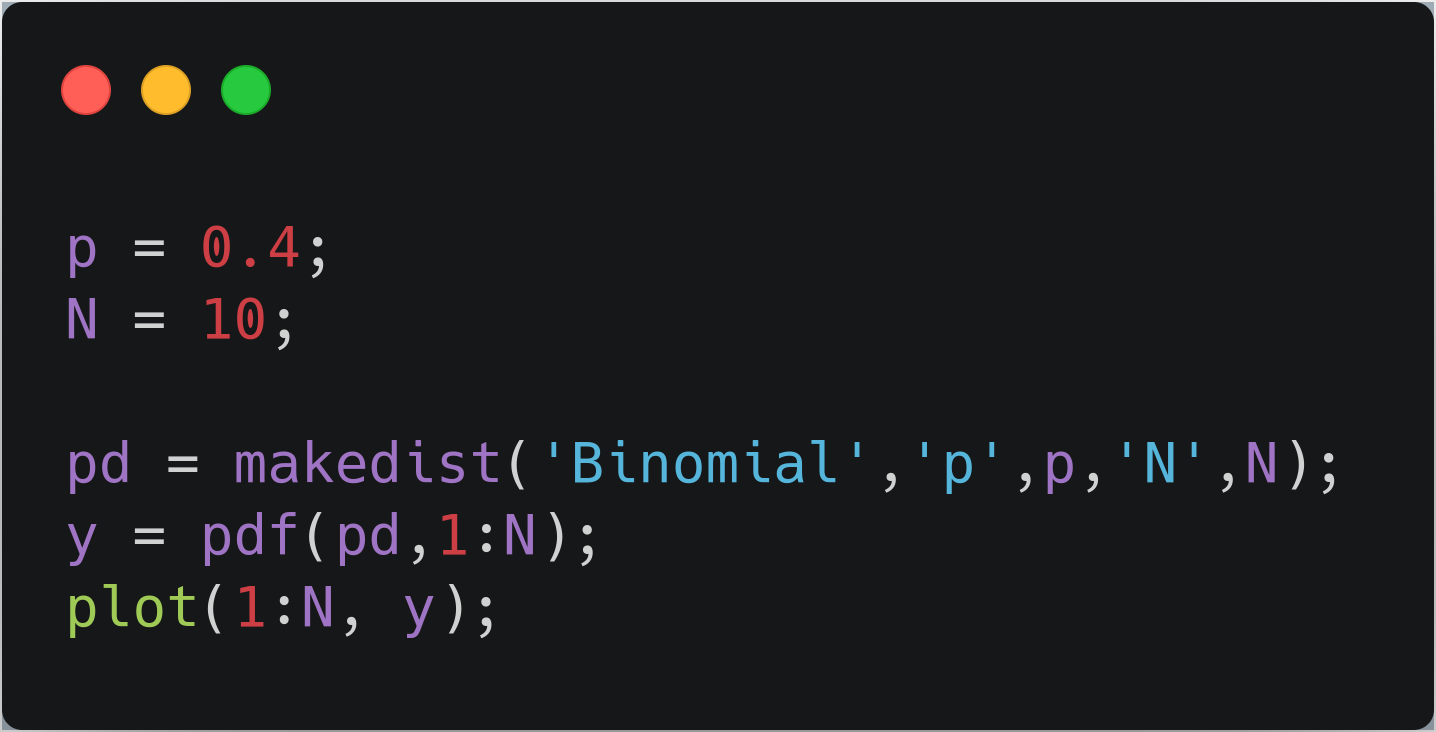
نمودار زیر خروجی را نشان میدهد.