
کامپیوتر های چند هسته ای و تکنولوژی مولتی ترد(Multi-thread) به نرم افزار ها و سیستم عامل های امروزی کمک کرده است که بتوانند چندین کار را به صورت همزمان انجام دهند. این همزمانی تا جایی که مربوط به استفاده از هسته های مختلف برای محاسبه است موازی و بیش از آن یک مساله زمان بندی برای همزمان به نظر رسیدن است. به طور مشخص تر اگر شما یک CPU با چهار هسته دارید می توانید چهار کار را همزمان به معنای واقعی کلمه انجام دهید یک ترد به ازای هر هسته اما بیش از آن ترد های اضافه تنها در زمان بندی ای که توسط سیستم عامل کنترل می شوند به هسته های مختلف برای اجرا می روند. بنابراین برای محاسبات علمی مولتی ترد فقط تا حدودی می تواند کمک کند.
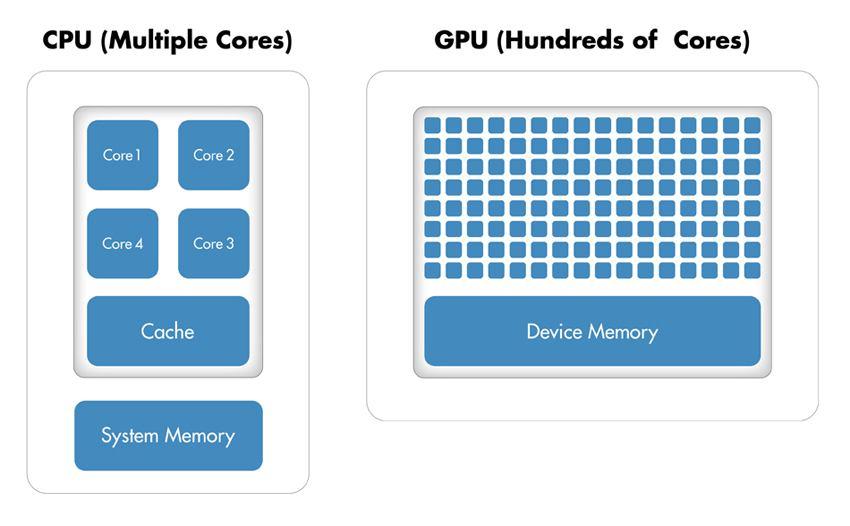
همه ما در کامپیوتر های شخصی خود یک پردازنده گرافیکی (GPU) داریم که از وجود آن غافل هستیم. صد البته که بازی ها و ویدیو هایی که می بینیم توسط این بخش رندر می شوند اما آیا می توان از توان محاسباتی GPU برای محاسبات خودمان استفاده کنیم؟ پاسخ مثبت است. اما چه مزایایی در این محاسبات هست. واحد پردازنده گرافیکی به صورت ذاتی برای انجام محاسبات ماتریسی با حجم بسیار بالا طراحی شده است. دلیل این مورد استفاده بسیار از جبر خطی در محاسبات گرافیکی است. همانطور که در شکل زیر می بینید. GPU بر خلاف CPU ساختار متفاوتی دارد و معمولا چند صد هسته دارد. علاوه بر آن یک حافظه اختصاصی پر سرعت هم در کنار آن وجود دارد. نحوه محاسبه در GPU به صورت زیر است:
1- ابتدا داده هایتان از حافظه اصلی (RAM) به حافظه GPU کپی می شود. این مرحله از همه زمانبر تر است و برای محاسبات کم حجم باعث می شود که سرعت آن در مقایسه با CPU کاهش پیدا کند.
2- پردازندهCPU به واحد GPU دستور یک محاسبه خاص را می دهد.
3- عملیات به صورت موازی در چندین هسته GPU انجام شده و نتیجه در حافظه GPU باقی می ماند.
4- مقدار نتیجه به حافظه اصلی کپی می شود.
پردازنده گرافیکی Nvidia یک سکوی نرم افزاری به نام CUDA معرفی کرده است که به برنامه نویسان اجازه می دهد به راحتی با زبان های C، C++ و Fortran بر روی GPU برنامه نویسی کنند. شرکت Mathwork توانسته با ارائه یک wrapper استفاده از CUDA را بسیار ساده کند. سینتکس استفاده از GPU در متلب به حدی ساده است که در نوع خود مثال زدنی است.( با توجه به حجم پیچیدگی کار با GPU در C).
به طور مثال فرض کنید می خواهیم دو ماتریس تصادفی را در GPU در هم ضرب کنیم. برای این منظور کافی است که از تابع gpuArray استفاده کنید تا ماتریستان از RAM به حافظه GPU منتقل شود. در مرحله بعد به صورت عادی آن ها را در هم ضرب می کنید:
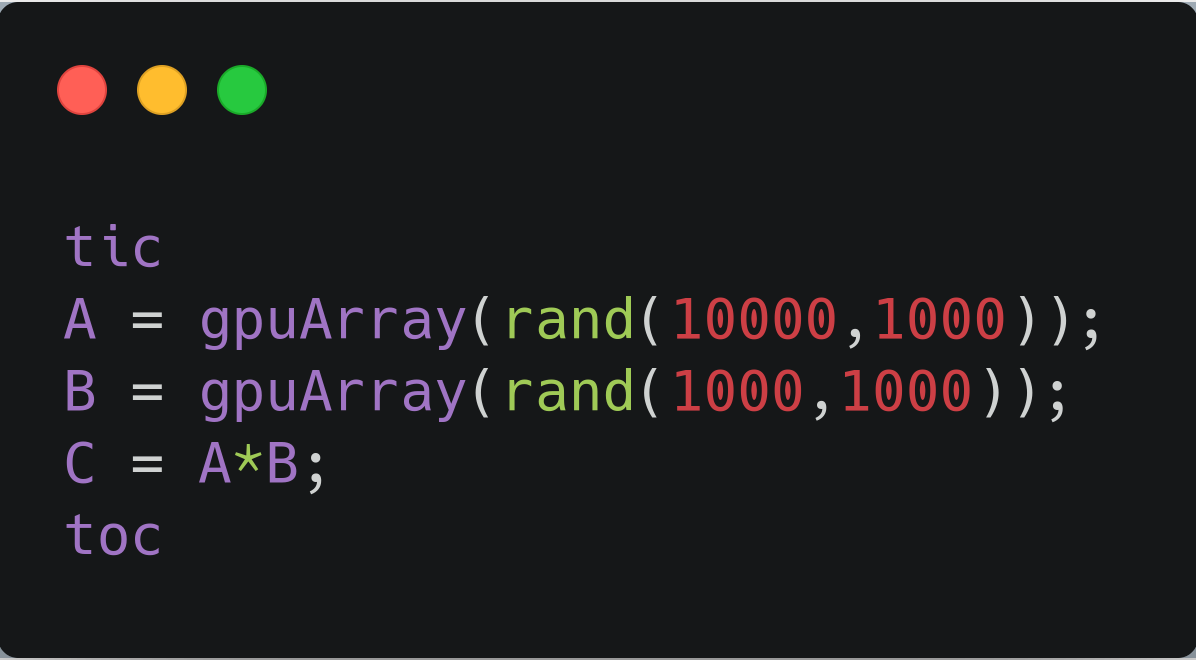
که نتیجه آن بر روی ماشین من 0.926980 ثانیه است. توجه کنید که متلب بسیاری از توابع را برای gpuArray ، overload کرده است. یعنی تابع ضرب در متلب اگر ورودی از جنس gpuArray ببنید آن را در GPU اجرا می کند در غیر این صورت در RAM کل عملیات را انجام میدهد. حال همین محاسبه را بر روی CPU انجام می دهیم:
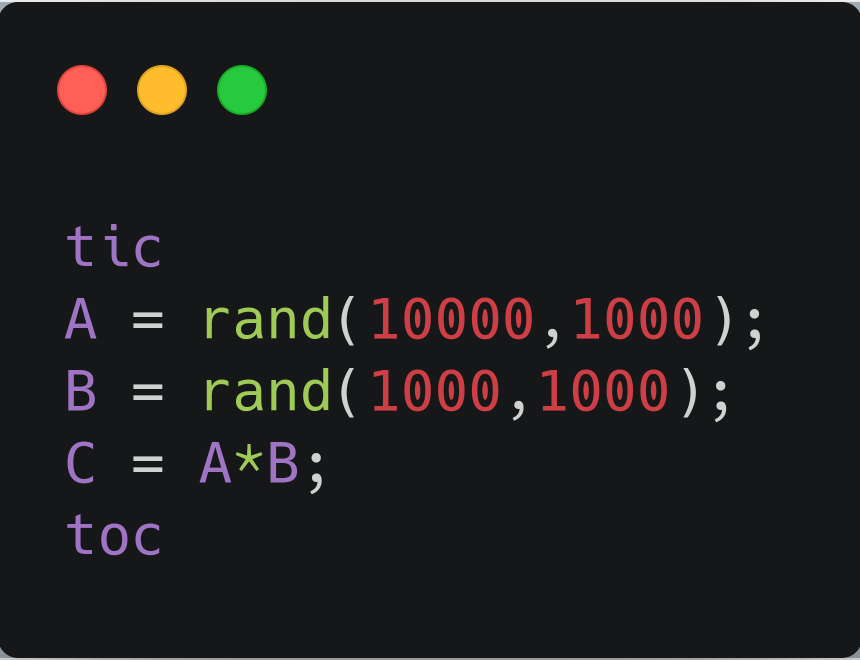
که زمان آن بر روی ماشین من 2.111759 ثانیه است. در این جا کاملا متوجه میزان اختلاف زمان می شوید. هرچند بر روی حجم بزرگتر داده این اختلاف می تواند اختلاف بین چند دقیقه و چند هفته شود!!
وقتی کد اولی را اجرا می کنید C به صورت gpuArray است و این بدان معناست که خروجی هنوز بر روی حافظه GPU قرار دارد. برای برگرداندن آن به RAM کافی است دستور زیر را اجرا کنیم:
D=gather(C)
در این صورت D همان C است که در حافظه قرار دارد. بیاد داشته باشید که بسیاری از توابع متلب مانند fft، fft2، abs، cos و غیره برای GPU پیاده سازی و overload شده اند. بنابراین قبل از برگرداندن نتایجتان به حافظه اصلی که بسیار زمانبر تر است بهتر است بیشتر عملیات خود را انجام داده باشید. در زیر لیست کامل تری از توابع پیاده سازی شده را می بینید.
http://uk.mathworks.com/help/distcomp/run-built-in-functions-on-a-gpu.html

