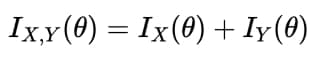یکی از مشکلات و بدفهمی هایی که دانشجویان و حتی اساتید در درک بخش های زیادی از مفاهیم هوش مصنوعی مانند تشخیص الگوی آماری و یادگیری ماشین دارند، تشخیص ندادن تفاوت دو رویکرد کاملا متفاوت در آمار و احتمال به روش شناسی(Methodology) و معرفت شناسی (Epistemology) بنیادی ترین مفاهیم آمارو احتمال است. در اساس در میان تفاسیر گوناگون احتمال دو رویکرد مهم و متفاوت به تفسیر احتمال وجود دارد: احتمال بیزین و احتمال فرکانسی.
احتمال بیزین مقداری است که به یک حالت از دانش(state of knowledge) یا حالتی از باور(state of belief) اختصاص داده می شود. می توان احتمال بیز را به عنوان ادامه ی منطق گزاره ای دانست که ما را قادر می کند با فرضیات (Hypothesis) استدلال کنیم. فرضیات گزاره هایی می شوند که درستی و غلطی آن ها نامشخص است. از دیدگاه بیزی یک احتمال به فرضیه اختصاص داده می شود، در حالی که در احتمال فرکانسی یک فرضیه بدون هیچ احتمالی، مورد آزمون قرار می گیرد.
بنیادی ترین تفاوت این دو تفسیر در معرفت شناسی آن هاست: فرکانسی ها عینی گرا هستند به این معنا که احتمال را به صورت معقول بودن یک گزاره قابل تفسیر می دانند. به عبارت دیگر، احتمال یک گزاره متناظر است با یک باور معقول بین همه ی افراد (حتی یک ربات) که مجموعه ای از دانش مشترک دارند. این باور معقول باید مطابق با قوانین احتمال که خود با معیار های عقلانیت و سازگاری قابل توجیه اند، باشد. اما بیزین ها ذهنی گرا هستند بیزین ها قبول دارند که معیار های عقلانیت و سازگاری احتمال هایی که یک شخص دارد را محدود می کند اما این معیار ها باعث نمی شوند همه به یک نتیجه در مورد احتمال رویداد ها برسند زیرا معیارهای عقلانیت هنوز اجازه تغییرات زیادی در محاسبه احتمال می دهند. این تفاوت خود را در محاسبه احتمال های پیشینی(prior probabilities) نشان می دهد.
اگر زیاد اهل فلسفه نباشید شاید نتوانید با پاراگراف قبل ارتباط برقرار کنید اما باز هم راه های زیاد وجود دارد که بدانیم این تفاوت ها چیست. بسیاری از دوره های درسی در دنیا(از جمله ایران) مفهوم احتمال را با شمارش حالات و نیز مباحث ترکیبیات شروع می کنند اما تقریبا تمام آن چیزی که در آمار و احتمال کاربردی مانند مباحث هوش مصنوعی وجود دارد با این مفاهیم سر و کاری ندارد و حتی جالب تر از آن درک روزمره ما از احتمال هم بیشتر بیزینی است. تحقیقات زیادی در علوم شناختی نشان داده اند که ما انسان ها(و حتی بیشتر جانوران دیگر) مادرزادی بیزینی به دنیا می آییم. همانطور که بزودی در ادامه مبحث می بینیم این مزیت فوق العاده ای برای ماست.
قبل از آنکه پیش تر برویم بهتر است سعی کنیم قدری فرکانسی فکر کنیم. احتمال ها در تفسیر فرکانسی فقط زمانی تعریف می شوند که بتوان "آزمایشات تصادفی"(random experiment) درستی تعریف کرد. تمامی حالت های ممکن یک آزمایش تصادفی، فضای نمونه نامیده میشود. یک رویداد(event) به عنوان یک زیر مجموعه از این فضا تعریف می شود.به طور مثال فضای نمونه انداختن یک تاس S={1,2,3,4,5,6} است و احتمال یک رویداد مانند آمدن 2 برابر با نسبت فرکانسی آن رویداد به تمامی رویداد هاست. بنابراین اگر n_t تعداد تمامی آزمایشات تصادفی باشد و n_x تعداد آزمایشاتی که رویداد x رخ می دهد P(x) می تواند توسط کسر زیر تخمین زده شود:
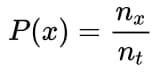
به طور واضح هر چه تعداد آزمایشات افزایش یابد احتمال به مقدار واقعی نزدیک می شود. به عبارتی:
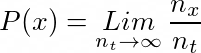
یکی از مشکلاتی که فورا پیش می آید این است که اصولا هیچ تضمینی نیست که این احتمال در هر دنباله آزمایشی تصادفی به طول بی نهایت به یک عدد همگرا شود، حتی اگر اصولا بتوان بی نهایت بار آزمایش تصادفی را اجرا کرد. اما مشکل اساسی حتی این هم نیست: در بسیاری از مواقع ما نیاز به محاسبه احتمال هایی داریم که قابل تکرار نیستند. به طور مثال احتمال اینکه فردا بارانی شود را نمی توان تکرار کرد و این کاملا بی معنی است که فضای نمونه را برای چنین حالاتی را ایجاد کرد. در حالی که چنین احتمالاتی بسیار کاربردی و مهم هستند.
در ادامه بحث بر روی آمار پارامتری تمرکز می کنیم. آمار پارامتری به شاخه ای از آمار گفته می شود که فرض می کند نمونه ها از توزیع های احتمال مشخصی می آیند و این توزیع احتمالات دارای یک سری پارامتر هستند.
به طور مثال "میانگین" یک پارامتر برای جمعیت محسوب می شود. فرض کنید می خواهیم میانگین قد تمام ایرانی ها را حساب کنیم. یک روش این است که قد تمام افراد را آمار گیری کرده و میانگین حسابی آن را بدست بیاوریم. اما این کار در بیشتر مواقع ممکن نیست زیرا تعداد نمونه ها بسیار زیاد یا در عمل بی نهایت است. به طور مثال میانگین شدت امواج الکترومغناطیسی در آسمان شب را نمی توان با میانگین عادی محاسبه کرد. از دیدگاه فرکانسی حتی چنین میانگینی یک مقدار ثابت و معین دارد(به خاطر عینی بودن معرفت شناسی) اما ما آن را نمی دانیم بنابراین تنها راه این است بازه اطمینان از مقدار "واقعی" پارامتر بدست آورد. این بازه اطمینان با یک احتمال (مثلا 95 درصد) ارائه می شود. احتمال 95 درصد به معنای این نیست که پارامتر با احتمال 95 درصد در آن بازه قرار دارد یا بازه با احتمال 95 درصد پارامتر را پوشش می دهد. وقتی آزمایش انجام شد یک بازه محاسبه می شود و بازه یا شامل پارامتر می شود یا نمی شود. احتمال 95 درصد به قابل اطمینان بودن روند تخمین بر می گردد.
اما دیدگاه بیزین برعکس معتقد است که پارامتر نامشخص خود یک متغیر تصادفی است که از یک توزیع احتمال پیروی می کند. این توزیع احتمال همان احتمال پیشینیِ (احتمال قبل از دیدن نمونه ها) ما در مورد پارامتر است. به عبارتی در دیدگاه بیزین:
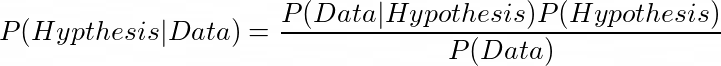
که اگر به صورت ساده فرضیات را پارامتر های مدل آماری که به عنوان فرضیه خود در نظر گرفته ایم، بدانیم:
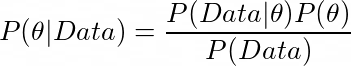
از دیدگاه بیزینی داده ها ثابت هستند و پارامتر ها هستند که مقادیر نامتعین و دارای توزیع احتمال هستند. برعکس، از دیدگاه فرکانسی ها داده ها ثابت نیستند و داده ها بر اساس پارامتر ثابت(که مقدارش را نمی دانیم) تغییر می کند. به طور مثال پارامتر p_i و داده X_j را در زیر می بینیم که چطور در دو دیدگاه متفاوت تفسیر می شوند.
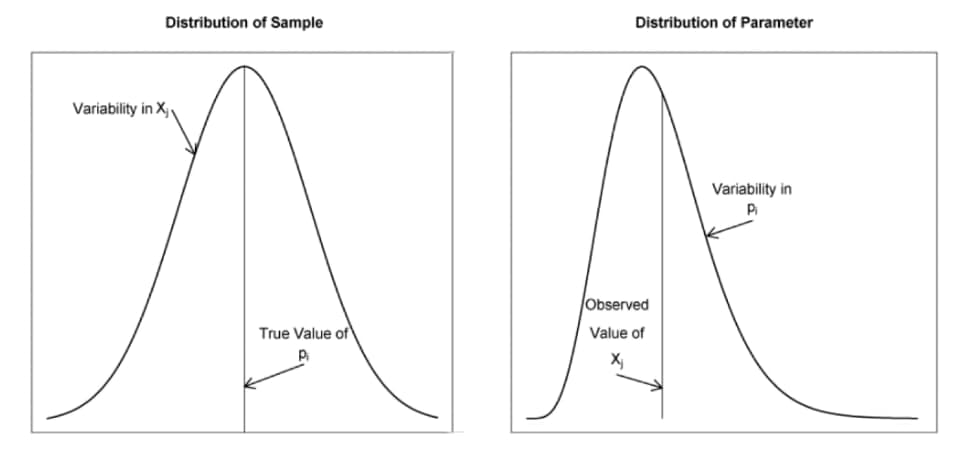
بنابراین در احتمال فرکانسی از احتمال داده به شرط فرضیه یعنی P(Data|Hypothesis) سخن به میان می آید. به این احتمال توزیع نمونه (Sampling distribution) هم گفته می شود. اگر این احتمال از یک آستانه alpha بزرگتر باشد فرضیه را می پذیریم و در غیر این صورت رد می کنیم. به این فرآیند بسیار مهم در احتمال فرکانسی، آزمون فرضیه آماری (Statistical hypothesis testing) گفته می شود.
خواننده چابک می تواند سریع سوال کند که اگر ما می گوییم در احتمال بیزین داده ثابت است و از احتمال آن نمی توان حرف زد پس عبارت P(Data|\theta ) در تعبیر بیزین چیست؟ باید گفت چیزی به اسم احتمال داده به شرط پارامتر نداریم بلکه باید از تابع درستنمایی (likelihood) سخن به میان آورد. . تابع درستنمایی گاها به اشتباه به احتمال داده ها به شرط داشتن پارامتر ها تعبیر می شود. اما تابع درست نمایی تابعی از پارامتر ها است. باید توجه کرد که تابع درستنمایی یک تابع احتمال بر روی پارامتر ها نیست و انتگرال آن بر روی پارامتر ها هم لزوما برابر با یک نمی شود(Bishop p22). هرگز نگویید احتمال داده ها(likelihood of data) بلکه بگویید تابع درستنمایی پارامتر ها(likelihood of parameters).(Information Theory, Inference, and Learning Algorithms 29). به همین خاطر تابع درستنمایی را به صورت زیر می نویسند:
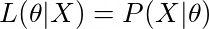
برای درک بهتر این موضوع باید به نقش داده در برابر پارامتر(که شاید کلیدی ترین موضوع این سلسله بحث باشد) تاکید کنیم. کلمه احتمال زمانی استفاده می شود که داده هنوز نیامده است و می خواهیم نتایج ممکن آینده را بر اساس پارامتر های ثابتی پیش بینی کنیم. کلمه درستنمایی زمانی استفاده می شود که داده ها موجود و ثابت هستند و می خواهیم تابعی از پارامتر را برای یک نتیجه موجود محاسبه کنیم.
قبل از آنکه به این بپردازیم که اساسا چگونه باید این احتمال ها(پیشینی، پسینی) و تابع درستنمایی را محاسبه کرد. به مساله دیگری می پردازیم. فرض کنید تمامی این مقادیر را حساب کردیم و به احتمال پسینی رسیدیم. احتمال پسینی احتمال پارامتر به شرط داده هاست. اما وقتی پارامتری که به دنبال آن هستیم خود یک متغیر تصادفی با توزیع احتمال مشخصی است چگونه مقدار "واقعی" پارامتر را بدست بیاوریم؟ اگر از دیدگاه بیزینی به مساله نگاه کنید متغیر تصادفی خود به اندازه کافی "واقعی" است و نیازی به کار بیشتری نیست چون کار بیشتری نمی توان انجام داد. دیدگاه بیزینی بر آن است که اساسا پارامتر های طبیعت متغیر های تصادفی(احتمال پسینی) هستند و هرگز نمی توان مقدار دقیق آن ها را دانست. تنها می شود نسبت به مقدار آن ها قدری مطمئن تر شد(با داده های بیشتر). اما با این روش نمی توانیم کار کنیم چرا که در نهایت باید مدلمان را با مقادیری ایجاد کنیم و از آن برای کار خود(مثلا دسته بندی) استفاده کنیم. روش های زیادی برای این کار توسعه یافته اند.
احتمال پسینی P(\theta |X) تمام آن چیزی را که می خواهیم در مورد theta بدانیم به ما می گوید. در اینجا به چند روش برای خلاصه کردن این احتمال می پردازیم:
تخمین MAP: براحتی می توان "تخمین نقطه ای"(point estimation) theta را با میانگین، میانه و مود احتمال پسینی بدست آورد.به طور معمول میانگین و میانه بهترین انتخاب برای یک پارامتر حقیقی هستند. با این حال بدست آوردن مود که به عنوان تخمین MAP شناخته می شود بسیار محبوب است زیرا به یک رویه بهینه سازی تابع پسینی ختم می شود.(یافتن قله یا بالاترین مقدار تابع) که معمولا الگوریتم های خوبی برای آن وجود دارد. هرچند این روش خوب است اما مشکلاتی هم دارد اولین مشکل این است که این روش(یا تمام روشهای تخمین نقطه ای) معیاری برای عدم تعین(uncertainty) به ما نمی دهند. در خیلی از کاربردها بسیار مهم است بدانیم که چقدر می شود به مقادیر پارامتر اعتماد کرد. یک تابع احتمال پسینی بسیار پخش قاعدتا زیاد قابل اعتماد نیست.
یکی از مشکلات مد این است که چون اندازه فضا را به حساب نمی آورد ممکن است نتایج جالبی را به ما ندهد. مثلا در شکل زیر میانگین بسیار بهتر نشان دهنده احتمال پسینی است تا مد.
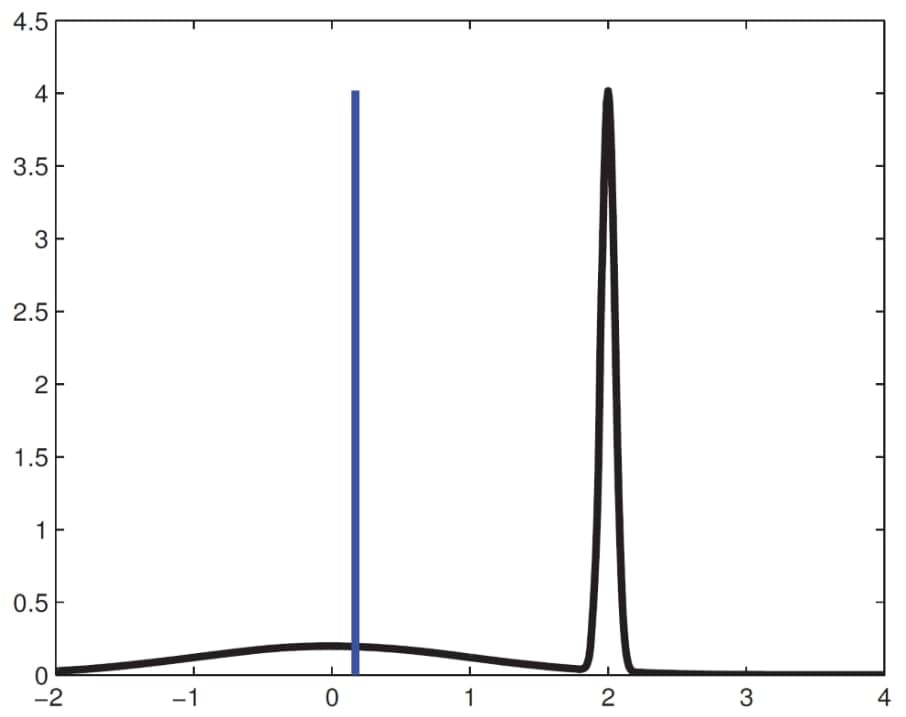
در این شکل خط آبی نشان دهنده میانگین است که به صورت واضح بهتر است.
پس چگونه می توانیم احتمال پسینی را خلاصه کنیم. جواب در "نظریه تصمیم گیری" (decision theory) نهفته است ایده اساسی این است که یک تابع هزینه (loss function) تعریف کنیم که در آن

برابر با میزان هزینه ای است که مقدار واقعی theta از میزان تخمین زده شده

فاصله داشته باشد. اگر از تابع هزینه 0-1 استفاده کنیم داریم
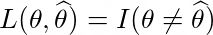
که در این حالت بهینه ترین تخمین زننده(estimator) مد احتمال پسینی برای تخمین پارامتر است. هزینه 0-1 به این معناست که شما یا پارامتر را درست تخمین می زنید یا این که کاملا ضرر می کنید. هیچ امتیازی برای حالت تقریبی قائل نیست. البته این تخمین زیاد واقعی نیست در بسیاری از مواقع از تابع هزینه مربع خطا استفاده می شود:
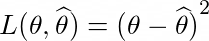
که در این حالت در این حالت بهترین تخمین زننده میانگین تابع احتمال پسینی برای پارامتر است. و در نهایت اینکه تابع
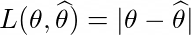
به بهترین تخمین زننده میانه ختم می شود.
مورد دیگر یافتن بازه اطمینان (credible interval) است. بازه اطمینان میزان اعتماد ما به تخمین نشان می دهد. برای بدست آوردن100(1-alpha) بازه اطمینان باید بازه ای به صورت (l,u) بدست آورد که شامل 1-alpha از تابع احتمال پسینی است یعنی:
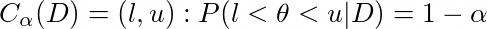
تعداد زیادی بازه به این شکل وجود دارند اما ما بازه ای را بر می گزینیم که
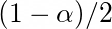
در هر سمتش باشد. یکی از اشتباهات رایج این است ک بازه اطمینان را با بازه اعتماد(confidence interval) اشتباه گرفته می شود. مطالعات نشان داده این اشتباه را حتی دانشمندان بزرگ هم مرتکب می شوند. یک بازه اعتماد 95 درصد به این معنا نیست که با احتمال 95 درصد پارامتر در آن بازه قرار دارد و حتی به این معنا نیست که به احتمال 95 درصد بازه جمعیت پارامتر را پوشش می دهد.وقتی مشاهدات جمع آوری شد و بازه محاسبه شد دیگر در مورد احتمال حرف نمی زنیم. احتمال 95 درصد در واقع میزان اعتماد ما به روش تخمین است نه یک بازه خاص از آن(که می توانست از یک آزمایش به آزمایش دیگر متفاوت باشد). اما بازه اطمینان دقیقا به معنای احتمال بازه برای داشتن یک مقدار پارامتر خاص با توجه به داده ها و دیگر اطلاعات است. در حالی بازه اعتماد تنها به روش نگاه می کند بدون توجه به داده ها.دید بازه اعتماد دیدی فرکانسی است و اعتقاد دارد پارامتر مقدار ثابتی دارد و معین است بنابراین احتمال برای آن بی معنی است.
یکی از روش های تخمین معمول استفاده از تخمین Maximum likelihood یا به اختصار ML است. در روش ML به دنبال یافتن پارامتر به صورتی است که داده های مشاهده شده (همان X) محتمل ترین نتایج ممکن با توجه به مدل باشند. به عبارتی دیگر در ML میزان "توافق" (agreement) بین مدل انتخاب شده(پارامترها) و داده های مشاهده شده به حداکثر می رسد.
فرض کنید N نمونه از مشاهدات به صورت
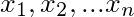
داریم که مستقل از هم اند و به صورت معادل از یک توزیع آمده اند(idependent and identically distributed). این توزیع به صورت یک تابع است با پارامتری که نمی دانیم

اما می دانیم(چگونه؟) که متعلق به خانواده ای از توابع با پارامتر theta است. این خانواده به صورت مجموعه زیر نشان می دهیم:
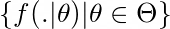
ما به دنبال تخمین پارامتر

هستیم. در روش ML احتمال joint تمامی مشاهدات به شرط پارامتر را ب صورت زیر نشان می دهیم:
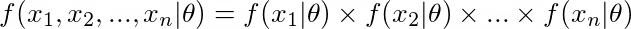
حالا اگر از دیدگاه تابع درستنمایی به این معادله بنگریم متغیر اصلی در این معادله پارامتر آن است یعنی:
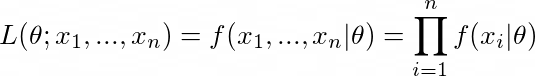
در عمل بیشتر با لگاریتم طبیعی تابع درستنمایی کار می کنند زیرا محاسبات را بسیار ساده تر می کند. به این تابع جدید Log-likelihood می گویند.
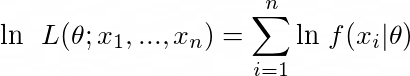
همچنین از میانگین log-likelihood هم استفاده می شود. در هر صورت نتیجه فرقی ندارد و این کارها صرفا برای ساده تر شدن محاسبات است. پس از یافتن این تابع باید با استفاده از مشتق گیری یا روش های بهینه سازی بهترین مقدار log-likelihood پیدا شود. یک مثال اولیه و خوب برای این مورد یافتن بهترین پارامتر ها برای توزیع نرمال است. فرض کنید که نمونه ها از یک توزیع نرمال به شکل زیر می آیند:
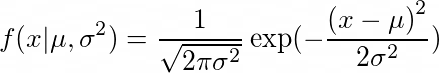
که تابع درستنمایی برای تعداد نمونه های N تایی و مستقل به صورت زیر می شود:
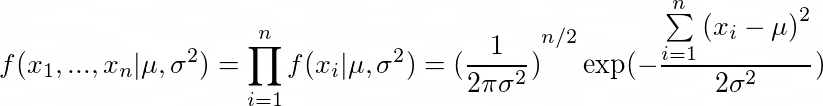
حالا اگر لگاریتم آن را محاسبه کنیم:
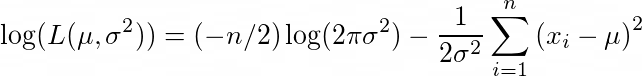
و حالا نسبت به پارامتر میانگین مشتق بگیریم:
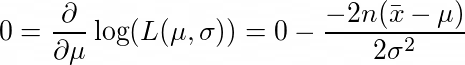
که در نهایت منجر می شود به:
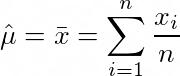
و به طور مشابه برای پارامتر واریانس
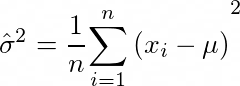
اگر احتمال پیشینی را در ML دخالت دهیم به تخمین MAP تبدیل می شود(یا به صورت برعکس اگر احتمال پیشینی در MAP را به صورت uniform درنظر بگیریم تخمین MAP به تخمین ML تبدیل می شود)
روش های بسیار دیگری برای تخمین پارامتر ها وجود دارد که در اینجا قصد بررسی همه آن ها را هم نداریم.
اگر بخواهیم مطالب بالا را خلاصه کنیم باید گفت ما به دنبال تخمین زدن پارامتر ها بودیم. و برای این کار از تخمین زننده ها(estimator) استفاده کردیم. این کار به صورت کلی در نظریه تخمین(estimation theory) بررسی می شود. ساخت و مقایسه تخمین زننده ها موضوع نظریه تخمین است. در بحث نظریه تصمیم گیری(decision theory) یک تخمین زننده یک قاعده تصمیم گیری(decision rule) است و میزان خوب بودن آن از طریق توابع loss function محاسبه می شود. توجه کنید یک قاعده تصمیم گیری بسیار کلی تر است اما در مورد تخمین پارامتر های مدل آن قاعده تصمیم گیری یک تخمین زننده است و loss function آن تابعی است که میزان تفاوت مقدار واقعی پارامتر $\theta $ و میزان تخمینی $\hat{\theta }$ را محاسبه می کند. نمونه هایی از این توابع را در بخش قبل دیدیم.
در واقع اگر داده های مشاهده ای ما x باشد. آنگاه تخمین به صورت $\hat{\theta }(x)$ است که یک مقدار ثابت است. علاوه بر تخمین های نقطه ای(point estimation) که تا کنون بررسی کردیم. برخی از تخمین ها به صورت تخمین بازه ای(interval estimation) هستند به این معنا که به جای یک نقطه یک بازه را خروجی می دهند. این بازه ها همان credible interval هستند که به آن ها اشاره شد. تخمین زننده های زیادی وجود دارند. دسته مهمی از آن ها تخمین زننده های بیزین هستند که آماره (statistic) های احتمال پسینی مانند میانگین، میانه و مود را تخمین می زند.(ML تخمین زننده بیزینی نیست).
تخمین زننده های نقطه ای مانند حداقل طول پیام (Minimum message length) بر اساس نظریه اطلاعات بیزینی است و مستقیما با توزیع پسینی مرتبط نیست. دراین دیدگاه حتی فیلتر کالمن(calman filter) و فیلتر وینر(weiner filter) هم تخمین زننده های بیزین هستند.
حالا بر روی یک مثال کامل متمرکز می شویم. فرض کنید که من درس جبر را در یک کلاس تدریس می کنم. از بد شانسی بچه ها من بیشتر روز ها کویز و امتحان می گیرم! 30 دانشجو در کلاس هست و امروز که امتحان گرفتم میانگین نمره هایشان

بوده است با انحراف معیار sigma =10. میانگینِ میانگین نمره ها تا کنون mu =70 بوده است با انحراف معیار tau =5 . نمرات امروز قطعا در این میانگین تاثیر می گذارند. میخواهم بدانم چطور می توانم این مقدار را بروز کنم.
اگر بیزینی به قضیه نگاه کنیم پارامتری که به دنبال آن هستم mu است. و چیزی که می خواهیم پیدا کنیم توزیع این پارامتر مجهول به شرط داده هایی است که تا کنون دیده ایم.
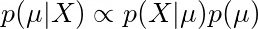
با فرض اینکه نمرات از توزیع نرمال با میانگین mu و انحراف معیار sigma پیروی میکنند. توجه کنید که در فرمول بالا مقدار زیر کسر را ننوشتیم. دلیل اصلی این کار این است که با توجه به متغیر بودن پارامتر و ثابت بودن داده میزان زیر کسر که برابر است با p(X) ثابت و تنها برای آن است که طرف سمت چپ معادله بالا به صورت تابع احتمال باشد یعنی انتگرال آن برابر با یک شود. پس می توان از محاسبه آن صرفنظر کرد و بقیه کار ها را انجام داد و در نهایت آن را نرمالایز(یعنی تقسیم بر ثابتی کنیم که تضمین کند انتگرال آن یک می شود) کرد. تابع درستنمایی به صورت زیر می شود:
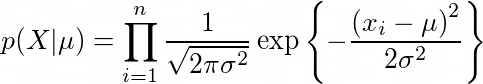
همچنین فرض می کنیم که احتمال پیشینی ما هم از یک توزیع نرمال با میانگین M و انحراف معیار sigma می آید:
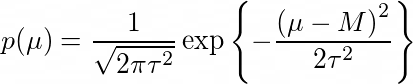
حال اگر این دو را در فرمول بیز (بالا) قرار دهیم داریم:
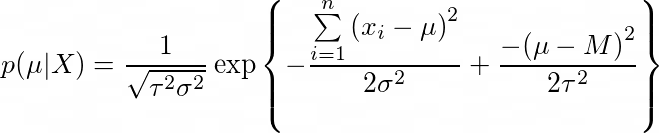
این فرمول قابل بیان به صورت یک توزیع نرمال است. برای اینکار فقط باید توجه کنید که عبارت توان را به فرمی تبدیل می کنیم که به صورت نرمال باشد. مراحل این کار به خاطر اختصار حذف شده اند(می توانید به صورت تمرین این کار را انجام دهید). فرمول نهایی یک توزیع نرمال به میانگین :
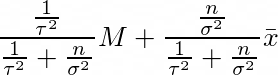
و واریانس:

این مقادیر به سادگی قابل تعبیر هستند: میانگین احتمال پسینی به دو فاکتور بستگی دارد: میانگین پیشینی و میانگین داده هایی که تاکنون جمع آوری کرده ایم(یک میانگین وزن دار از هر دو است). هرقدر ما نسبت به احتمال پیشینی مطمئن تر باشیم یعنی انحراف معیار آن کمتر و ضریب M بزرگ تر است. از طرفی هرچه تعداد داده ها بیشتر و انحراف معیار آن کمتر باشد تاثیر داده ها بیشتر هستند.
به طور مثال فرض کنید من امروز امتحان سختی از بچه ها گرفتم و نمرات آن ها به شدت پایین آمد. در این صورت پارامتر میانگین کلاس تغییر می کند و من باید در مورد آن تجدید نظر کنم. کد زیر این واقعیت را نشان می دهد.
این مثال نشان می دهد که چگونه احتمال پسینی پارامتر ها با داده ها تغییر می کند. اگر سعی کنید کد بالا را دستکاری کنید و مثلا تعداد یا مقدار نمرات را عوض کنید متوجه می شوید که چگونه در نهایت داده بر احتمال پیشینی پیروز می شود. با این حال انتخاب احتمال پیشینی درست محاسبات را کمتر و ساده تر می کند. در برخی مواقع انتخاب نادرست تابع پیشینی ممکن است مشکل زا باشد.
تا به این جا چند سوال اساسی ممکن است برایتان پیش آمده باشد. اول اینکه چرا احتمال پیشینی را به صورت نرمال گرفتیم؟ جواب به این سوال را به چند طریق می توان انجام داد اولین پاسخ این است وقتی در مورد متغیری نامطمئن باشیم ولی بدانیم در یک محدوده مشخص قرار میگیرد با میانگین و واریانسی بهترین گزینه توزیع نرمال است. اما پاسخ بهتر این است که ما از احتمال پیشینی ای استفاده کردیم که در خانواده احتمال پسینی قرار بگیرد. به این انتخاب conjugate prior گفته می شود. این انتخاب به تابع درستنمایی وابسته است. در مثال بالا ما از تابع نرمال برای درستنمایی استفاده کردیم که از آنجایی که خانواده گاوسی conjugate خودش است پس برای احتمال پیشینی هم از تابع نرمال استفاده می کنیم.(کلمات گاوسی و نرمال به جای هم استفاده می شود) این کار محاسبات را بسیار ساده می کند زیرا می توان احتمال پسینی را به صورت closed form یا فرم بسته نوشت. توزیع های زیادی وجود دارند که conjugate آن ها محاسبه شده و جدول های آن موجود است.
یک مشکل عملی اما این است که همیشه نمی توان به همین راحتی تابع conjugate را پیدا کرد و محاسبات را به صورت تحلیل انجام داد. متاسفانه بیشتر مواقع همین طور است. همین مشکل یکی از موانع بزرگ بر سر راه پیشرفت احتمال بیزینی شد. اما کشف یک الگوریتم مهم نقطه عطفی در حل مسائل به این طریق شد. این الگوریتم در رده مهمترین الگوریتم های قرن بیستم هم قرار گرفته است. دسته روش های MCMC یا مونت کارلو زنجیر مارکو در سال 1953 با مقاله ی متروپولیس معرفی شد. هرچند روش های دیگری مانند روش Gibbs هم برای این کار وجود دارند که در رده MCMC قرار می گیرند. این روش ها در واقع روش های نمونه گیری از یک تابع احتمال هستند. با نمونه گیری شما می توانید تابع احتمال را به صورت "توزیع نمونه گیری"(sampling distribution) بسازید. توزیع نمونه گیری در یک بعد همان هیستوگرام است. چون ما در این جا همواره با آماره ها یا پارامتر ها سر و کار داریم توزیع نمونه گیری یک پارامتر را در نظر می گیریم.
اما سوال دوم در مورد مثال بالا این است که اگر الزامی بر انتخاب conjugate prior وجود نداشته باشد(که در اکثر مواقع هم وجود ندارد چون روش های عددی مانند MCMC می توانند از پس آن بر بیایند) پس طبق چه معیاری باید احتمال پیشینی را انتخاب کرد؟
احتمال پیشینی میزان عقیده ما در مورد پارامتری است که قرار است توزیع آن را به دست بیاوریم پیش از آن که به شواهد نگاه کنیم(داده ها را در نظر بگیریم). احتمال پیشینی می تواند بر اساس تجربه گذشته بنا شده باشد یا کاملا شخصی باشد. همچنین نظر متخصص می تواند بسیار مفید باشد. یک احتمال پیشینی uninformative بین نتایج مختلف یک تعادل بر قرار می کند زمانی که اطلاعاتی در دسترس نیست. به طور مثال تابع توزیع یکنواخت در یک بازه می تواند یک احتمال پیشینی uninformative باشد. اما ساختن احتمال پیشینی همیشه هم به همین سادگی نیست. علاوه به تعادل بین نتایج مختلف گاه سعی می شود که از اصولی مانند تقارن و میزان آنتروپی استفاده شود. پیشینی های جفری(Jeffry’s prior) چنین هستند.
خود احتمال پیشینی هم می تواند پارامتر داشته باشد که به این پارامتر ها ابر پارامتر(hyperparameter) گفته می شود. ابرپارامتر ها خود می توانند از یک توزیع بیایند که به آن Hyper prior گفته می شود. به این حالت که احتمال پیشینی بیش از یک رده می شود مدل بیز سلسه مراتبی(hierarchical bayes model) گفته می شود. خوبی این روش این است که حساسیت نتایج به Hyperparameter ها بسیار کمتر است.
زمانی است که ما اطلاعاتی(هر چند ناقص) در مورد مساله داریم به طور مثال اگر بخواهیم دمای هوای فردا را بخواهیم مدل کنیم. میتوان از یک مدل نرمال با میانگین 12 ظهر برای گرمترین زمان و یک واریانس دلخواه استفاده کرد.
ساده ترین و قدیمی ترین اصل در این زمینه "اصل بی تفاوتی"(principle of indifference) است که توسط برنولی و لاپلاس کشف شد. این اصل احتمال یکسانی به حالت هایی می دهد که اطلاعی در مورد آن نداریم. در احتمال پیشینی سعی می کنیم که قضاوتی از قبل در مورد مقادیر پارامتر ها نداشته باشیم و بگذاریم که داده ها سخن بگویند. در اینجا یک احتمال پیشینی معروف را بررسی می کنیم.
روش جفری یک روش عمومی برای ساختن پیشینی های غیرمطلع است. ایده کلی این است که اگر

غیرمطلع باشد هر تغییر پارامتربندی(Reparametrization) از آن به صورت
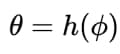
هم باید غیر مطلع باشد باشد. در واقع چون داریم:
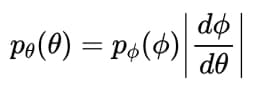
ما احتمال پیشنی را به صورت زیر انتخاب می کنیم:
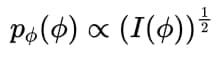
که در آن

اطلاعات فیشر(fisher information) است:
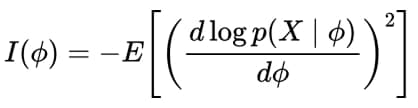
این معیاری است از میزان خمش منفی میانگین log-likelihood و بنابراین متناظر است با میزان هموار بودن MLE. حالا:
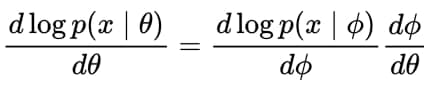
پس از به توان دو رساندن و امید ریاضی گرفتن بر روی x داریم:
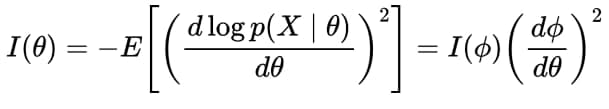
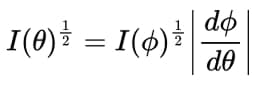
که در نهایت احتمال پسینی تغییر پارامتر یافته می شود:
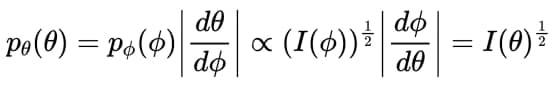
اطلاعات فیشر
اطلاعات فیشر یک راه برای اندازه گیری میزان اطلاعاتی است که یک متغیر تصادفی مشاهده شدنی X در مورد پارامتر theta دارد که توزیع X را مدل می کند، است. اطلاعات فیشر با تابع درستنمایی ارتباط نزدیکی دارد. می توان نشان داد که گشتاور اول تابع امتیاز(مشتق Log-likelihood) برابر با صفر است:
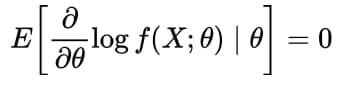
اما دومین گشتاور اطلاعات فیشر است:
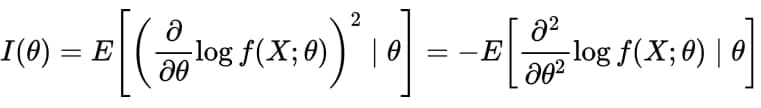
اطلاعات می تواند به صورت اندازه میزان "خمش" در نزدیک تخمین بیشترین درستنمایی از theta اندازه گیری شود. یک تابع درستنمایی پخ با بیشینه کم ارتفاع دارای میانگین مشتق دوم کمی است و بنابراین اطلاعات کمی دارد. از طرفی یک تابع درستنمایی تیز با ارتفاع زیاد بیشنه اطلاعات زیادی با خود دارد.
اطلاعاتی که به این طریق محاسبه می شود "جمع شدنی"(additive) است. یعنی اطلاعاتی که از دو آزمایش جدا به دست می آید برابر با اطلاعات مجموع تک تک آزمایش ها به صورت جداگانه است.