
داستان ازونجا شروع شد که من علاقه داشتم Probabilistic Graphical Models رو پیاده سازیش رو یادبگیرم که یه کتابخونه دیدم به اسم pgmpy باهاش یه مقداری کار کردم و دوست داشتم اگه کسی نمیدونه چنین کتابخونه ای وجود داره دیگه بدونه و استفاده کنه. لذا این نوشته توضیحات پایه این موضوع نیست واگه کسی بخواد بیشتر و عمیق در مورد این موضوع بدونه قسمت آخر نوشتم یه سری منابع معرفی کردم . اینجا فقط من یه مقدمه بسیار کوچک از این موضوع میگم بعد کدنویسی پایه با این کتابخونه رو میگم و در پست های بعد اگر عمری باشه پیاده سازی یه نمونه عملی رو توضیح میدم . راستی من خیلی اعتقادی به ترجمه تحت الفظی ندارم و هر جا دوست داشتم به زبان سلیس فینگلیش نوشتم توضیحات رو :)
در اصل دو نوع اصلی از این مدلها وجود داره:
مدلهای گرافی بیزین (Bayesian Models)
این مدلها از گراف بدون دور جهت دار یا همون directed acyclic graph یا همون DAG ها تشکیل شدند.این نوع از مدلها علیت بین متغیرهای رندم رو نمایش میدن.
مدل های مارکوف (Markov Models)
این مدلها گراف های بدون جهت هستند که روابط غیر علت و معلولی رو نشون میدن .
من در این آموزش یه نمونه از مدل نوع اول یعنی شبکه بیزین رو توضیح میدم.
برای کار با این نوع مدلها یک کتابخونه پایتون به اسم pgmpy وجود داره . انواع مدلهای گرافی و الگوریتمهای inference در این فریمورک وجود داره . بعلاوه میتونید با کمک این کتابخونه الگوریتمهای inference خودتون رو هم ایجاد کنید . حالا بریم سر کد نویسیش.
من یه فایل reqirements.txt تو کد قرار داده شده در گیت هاب گذاشتم . نسخه پایتون مورد استفاده من هم Python 3.8.10 هست.
همونطور که در ابتدا گفتم در این آموزش میخوام یه شبکه بیزین ایجاد کنم. شبکه های بیزین از احتمال شرطی برای نمایش هر نود استفاده میکنند. در حقیقت این احتمالات همون پارامترهای شبکه هستند. برای مثال هر نود به شکل مقابل نمایش داده میشه:
P(node| Pa(node))
که در اون منظور از Pa(node) والد اون نود هست.
یه مثال معروف تو این زمینه مثال دانش آموز هست(شکل ۱) که میخوایم همینو با pgmpy پیادش کنیم:
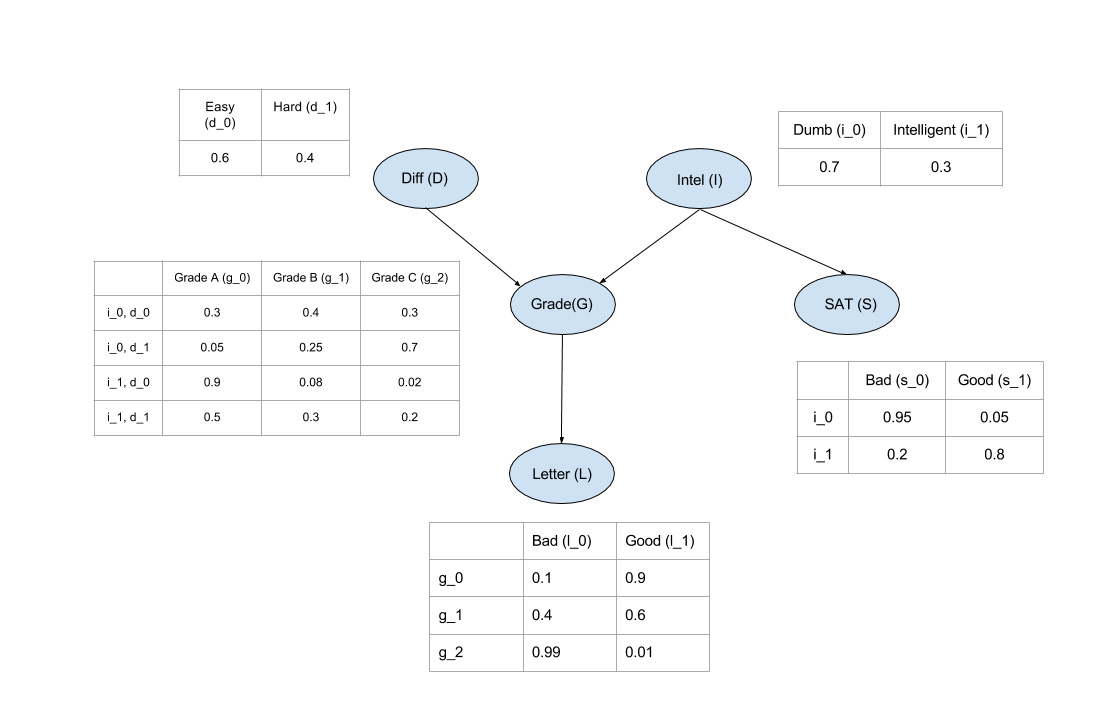
این جداولی که در شکل میبینید همون CPD ها یا همون Conditional Probability Distribution یا همون توزیع های احتمال شرطی هستند.خب بریم سر اصل مطلب
مراحل:
۱) اول متد های زیر رو ایمپورت میکنیم :
from pgmpy.models import BayesianModel
from pgmpy.factors.discrete import TabularCPD
۲) مدل رو با ارسال لیست یالها به صورت زیر مقدار دهی اولیه میکنیم:
model = BayesianModel([('D', 'G'), ('I', 'G'), ('G', 'L'), ('I', 'S')])
۳) جداولی که توی شکل نشون داده شده یعنی همون CPD ها رو به کمک تابع TabularCPD تعریف میکنیم:
cpd_d = TabularCPD(variable='D', variable_card=2, values=[[0.6], [0.4]])
cpd_i = TabularCPD(variable='I', variable_card=2, values=[[0.7], [0.3]])
cpd_g = TabularCPD(variable='G', variable_card=3,
values=[[0.3, 0.05, 0.9, 0.5],
[0.4, 0.25, 0.08, 0.3],
[0.3, 0.7, 0.02, 0.2]],
evidence=['I', 'D'],
evidence_card=[2, 2])
cpd_l = TabularCPD(variable='L', variable_card=2,
values=[[0.1, 0.4, 0.99],
[0.9, 0.6, 0.01]],
evidence=['G'],
evidence_card=[3])
cpd_s = TabularCPD(variable='S', variable_card=2,
values=[[0.95, 0.2],
[0.05, 0.8]],
evidence=['I'],
evidence_card=[2])
به ازای هر نود یک TabularCPD نیازه ساخته بشه . ورودی هاشم که مشخصه چیه:
۴) حالا cpd های ساخته شده رو به مدل اولیه اضافه میکنیم:
model.add_cpds(cpd_d, cpd_i, cpd_g, cpd_l, cpd_s)
۵)مدل رو چک میکنیم که آیا درست پیش رفتیم یا نه : به این شکل که اگه جمع احتمالات شد ۱ یعنی cpd ها درست تعریف شدند.و تابع زیر مقدار True رو برمیگردونه.
model.check_model()
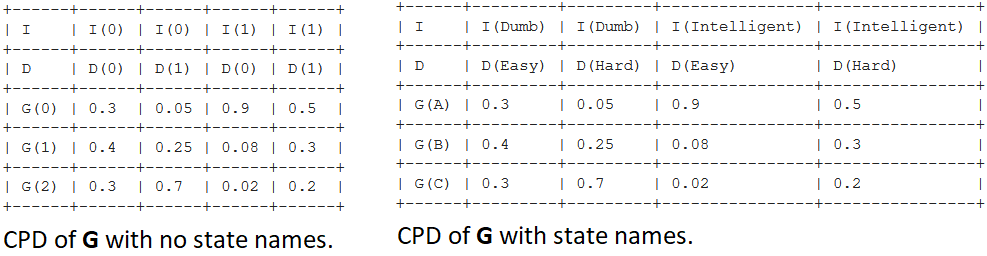
۶) در مراحل بالا ما اسم state ها رو ننوشتیم لذا خود pgmpy از 0 شروع میکنه و اسم state هارو به صورت عددی میذاره .اگه بخوایم دستی خودمون به state ها اسم بدیم باید این کارو کنیم :
cpd_g_sn = TabularCPD(variable='G', variable_card=3,
values=[[0.3, 0.05, 0.9, 0.5],
[0.4, 0.25, 0.08, 0.3],
[0.3, 0.7, 0.02, 0.2]],
evidence=['I', 'D'],
evidence_card=[2, 2],
state_names={'G': ['A', 'B', 'C'],
'I': ['Dumb', 'Intelligent'],
'D': ['Easy', 'Hard']})
۸) توی این مرحله میخوایم متغیرهایی که از هم مستقل هستند رو دربیاریم . قبلش باید بدونیم که انواع استقلال های تعریف شده توسط شبکه های بیزین چیا هستن؟
نوع اول : استقلالهای محلی (Local Independencies)
متغیری که به شرط داشتن نود والد یا والدهاش از نودهای غیرنوه خودش مستقله. به صورت فرمالش میشه این :
P( X ⊥ NonDesc(X) | Pa(X))
که در اون NonDesc(X) متغیرهایی هستند که نوادگان X نیستند و Pa(X) هم والدین X هست.
برای فهمیدن اینکه چه متغیرهایی به صورت محلی از یه متغیر مستقل هست از دستور زیر استفاده میکنیم :
model.local_independencies('G')
اگه بخوایم همه مستقلات محلی رو شبکه بفهمیم هم باید اسم همه نوهارو بدیم !
model.local_independencies(['D', 'I', 'S', 'G', 'L'])
نوع دوم : استقلالهای سراسری (Global Independencies)
واقعیت اینه که ساختارهای ممکن زیادی برای استقلال سراسری وجود دارد.برای دو نود دو راه برای اتصال بین اون دو نود وجود داره :

در هر دو مورد بالا مشخصه که تغییر در یه نود روی اونیکی اثر داره . برای تعداد نود بالاتر مثلا سه نودهم همینطور :
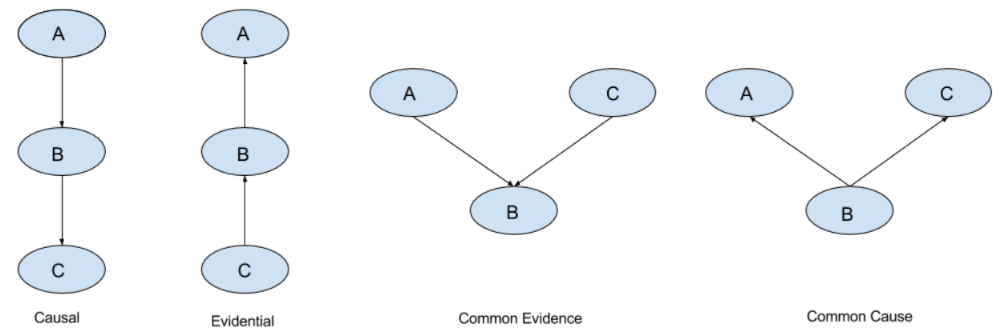
۹) حالا تو این مرحله هدف پیش بینی مقادیر به کمک استنتاج از روی مدلهایی هست که صحبتشو کردیم. برای این منظور از یه روش پایه برای استنتاج به نام Variable Elimination استفاده میکنیم . برای مثال ما احتمال G رو با مارجینایز کردن اون حول سایر متغیرها محاسبه میکنیم :
from pgmpy.inference import VariableElimination
infer = VariableElimination(model)
g_dist = infer.query(['G'])
print(g_dist)
حالا اگه بخوایم یه توزیع شرطی مثل اینو(P(G | D=0, I=1)) محاسبه کنیم باید یه سری آرگومان اضافه هم به این تابع query از شی infer پاس بدیم :
g_dist = infer.query(['G'], evidence={'D': 'Easy', 'I': 'Intelligent'})
۱۰) در این مرحله میخوایم مقادیر رو برای نقاط دیتای جدید پیش بینی کنیم.تفاوت این مرحله با مرحله قبل اینه که الان میخوایم محتمل ترین استیت یک متغیر رو داشته باشیم به جای اینکه توزیع احتمالاتیش رو محاسبه کنیم. در pgmpy این کار با map_query انجام میشه :
infer.map_query(['G'])
یا
infer.map_query(['G'], evidence={'D': 'Easy', 'I': 'Intelligent'})
۱۱) حالا اگه یکی بخواد الگوریتم استنتاج خودشو بسازه چه باید بکنه ؟ pgmpy کلاسهای زیر رو برای این منظور داره:
برای اضافه کردن یه ویژگی جدید کافیه یه کلاس ایجاد کنید از کلاس های پایه گفته شده ارث بری کنید .
به نمونه ازین کار رو با هم انجام میدیم . مثلا میخوایم الگوریتم استناج اینجوری باشه که همه ی CPD های شبکه رو ضرب کنیم و حول همه متغیرها مارجینایز کنیم:
import itertools
from pgmpy.inference.base import Inference
from pgmpy.factors import factor_product
class SimpleInference(Inference):
# By inheriting Inference we can use self.model, self.factors and self.cardinality in our class
def query(self, var, evidence):
# self.factors is a dict of the form of {node: [factors_involving_node]}
factors_list = set(itertools.chain(*self.factors.values()))
product = factor_product(*factors_list)
reduced_prod = product.reduce(evidence, inplace=False)
reduced_prod.normalize()
var_to_marg = set(self.model.nodes()) - set(var) - set([state[0] for state in evidence])
marg_prod = reduced_prod.marginalize(var_to_marg, inplace=False)
return marg_prod
تامام!
حالا چطور استفادش کنیم ؟ هیچی مدلو عین قبل مقداردهی اولیه و تعریف CPD میکنیم و در ادامه از استنتاج تعریف شده خودمون استفاده میکنیم :
# Defining a model
from pgmpy.models import BayesianModel
from pgmpy.factors.discrete import TabularCPD
model = BayesianModel([('A', 'J'), ('R', 'J'), ('J', 'Q'), ('J', 'L'), ('G', 'L')])
cpd_a = TabularCPD('A', 2, values=[[0.2], [0.8]])
cpd_r = TabularCPD('R', 2, values=[[0.4], [0.6]])
cpd_j = TabularCPD('J', 2, values=[[0.9, 0.6, 0.7, 0.1],
[0.1, 0.4, 0.3, 0.9]],
evidence=['A', 'R'], evidence_card=[2, 2])
cpd_q = TabularCPD('Q', 2, values=[[0.9, 0.2], [0.1, 0.8]],
evidence=['J'], evidence_card=[2])
cpd_l = TabularCPD('L', 2, values=[[0.9, 0.45, 0.8, 0.1],
[0.1, 0.55, 0.2, 0.9]],
evidence=['J', 'G'], evidence_card=[2, 2])
cpd_g = TabularCPD('G', 2, values=[[0.6], [0.4]])
model.add_cpds(cpd_a, cpd_r, cpd_j, cpd_q, cpd_l, cpd_g)
# Doing inference with our SimpleInference
infer = SimpleInference(model)
a = infer.query(var=['A'], evidence=[('J', 0), ('R', 1)])
سخن کوتاه
حالا که تموم شد کدهای مورد استفاده رو میتونید توی آدرس زیر بیابید :
https://github.com/HaveFunWithCode/pgm-pgmpy-play
لازم به ذکره که من این آموزش رو از سایت زیر ترجمه کردم
https://analyticsindiamag.com/guide-to-pgmpy-probabilistic-graphical-models-with-python-code/
ولی خب یه سری اشکالات هم یه جاهایی از متنش بود که برطرف کردم تو ترجمه.
اگه میخواید عمیق تر و بیشتر با این کتابخونه کار کنید کتاب موجود برای این منظور این کتابه :
https://www.amazon.co.uk/Mastering-Probabilistic-Graphical-Models-Python-ebook/dp/B00ZXFCJP6
اگه میخواید علمی پیش برید و خیلی خیلی عمیق بشید در سطح دانشگاهی یه کورس هست تو کورسرا خیلی عالیه برید ببینید :
https://www.coursera.org/specializations/probabilistic-graphical-models
اگه نمونه کدهای بیشتری میخواید این لینک مال خود کتابوخونس و خوبه
https://github.com/pgmpy/pgmpy
من یه پروژه دارم انجام میدم .اونو به مرور اینجا میزارم و توضیحش میدم اگه عمری بود .ولی اگه کسی هم دوست داشت با هم پروژه انجام بدیم تو این زمینه به ایمیل زیر یه ندا بده :)
اگه نظر انتقاد و ایرادی هم در این ترجمه دیدید بسی خوشحال خواهم شد اگه بهم بگید . حالا یا تو کامنتها یا با ایمیل .
امیدوارم که به دردتون خورده باشه:)

