
منبع اصلی این پست، دوره NLP استنفورد (CS224N) از کانال یوتیوب Stanford Online است. لطفاً برای حفظ حقوق منتشر کننده اصلی، ویدیوهارو از منبع اصلی دنبال کنید. همچنین، در انتهای هر جلسه، به ویدیو مربوط به آن جلسه ارجاع داده شده است.
سعی کردم هرچیزی که از ویدیوها فهمیدم رو به صورت متن در بیارم و در این پلتفورم با بقیه به صورت کاملاً رایگان به اشتراک بذارم. کل ویدیوها 23 تاست که سعی میکنم ماهی حداکثر یک الی دو جلسه رو منتشر کنم. تا جایی که تونستم سعی کردم خوب و کامل بنویسم، اما اگر جایی ایرادی داشت، حتما تو کامنتها بهم بگید تا درستش کنم. لازم به ذکره که برای فهم بهتر مباحث این دوره، دونستن مفاهیم پایهای در یادگیری ماشین، جبر خطی و آمار و احتمال پیشنهاد میشه.
قبل اینکه وارد بحث مدلهای زبانی و شبکههای عصبی بازگشتی (RNN) بشیم، پرونده پارسرها که از جلسه قبلی باقی مونده رو میبندیم. بعد جزییات بیشتری از شبکههای عصبی رو مورد بررسی قرار میدیم و در نهایت میریم سراغ مدلهای زبانی و شبکههای عصبی بازگشتی.
جلسهی قبلی با پارسرها آشنا شدیم و دیدیم که چطور کامپیوترها تحلیل نحوی انجام میدن، چطور ویژگی استخراج میکنن و اصلاً بهصورت کلاسیک یک پارسر چطور نوشته میشه. حتی با یک تحلیلگر نحوی حریصانه هم آشنا شدیم.
اما این روشهای قدیمی، مخصوصاً در بخش استخراج ویژگی، یک سری ایراداتی دارن که باعث شد بعدها پارسرهای مبتنی بر شبکههای عصبی معرفی بشن.
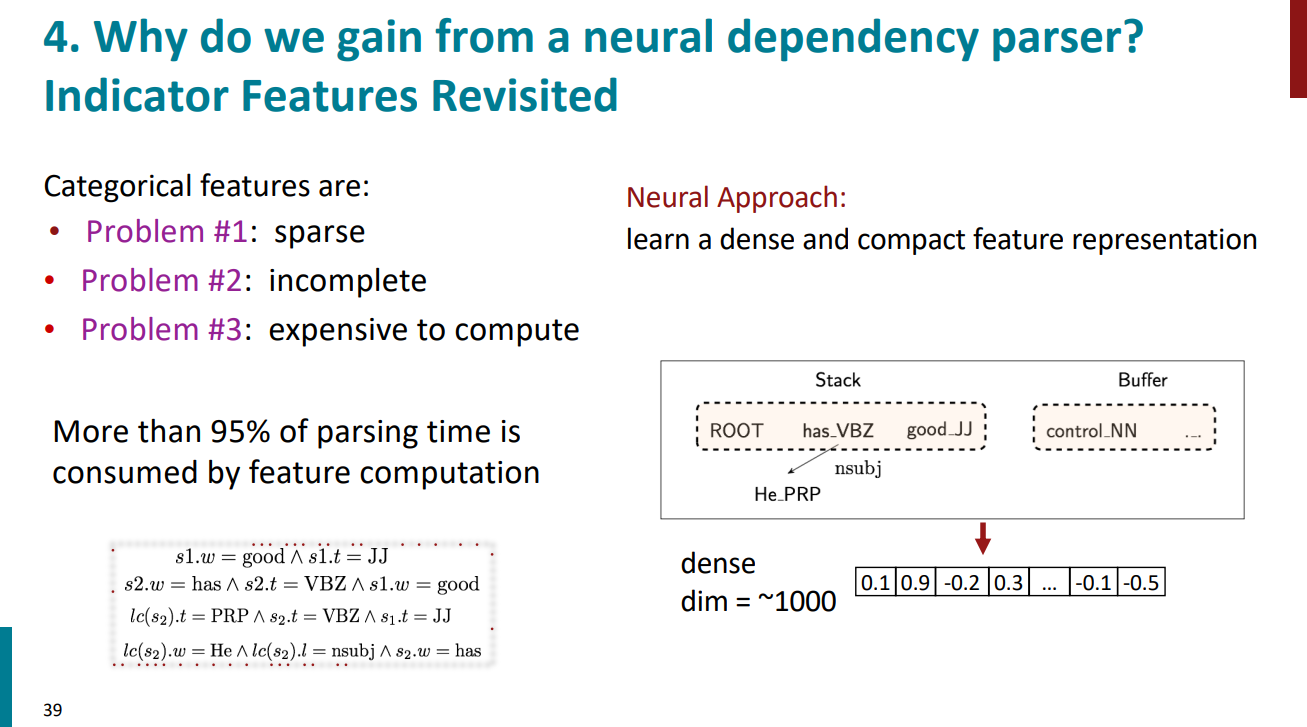
یکی از این ایرادها پراکندگی بیش از حد (sparsity) ویژگیهاست. به این صورت که ویژگیها معمولاً به شکل ترکیبهای دقیق تعریف میشن. مثلاً ممکنه یکی از فیچرها این باشه که "کلمه بعد از اسم باید فعل باشه". اما احتمال داره اصلاً چنین ترکیبی توی دادهها دیده نشه، برای همین ماتریس ویژگیها خیلی اسپارس میشه.
ایراد دوم ناقص بودن ویژگیهاست. هرچقدر هم موقع train کردن ترکیبهای زیادی رو استخراج کنیم، باز هم ممکنه در زمان تست و استفاده به ترکیبی برخورد کنیم که اصلاً ندیدیم و برامون کاملاً جدید باشه.
مورد آخر هم پر هزینه بودن محاسبهی ویژگیهاست. جوری که بیش از 95 درصدِ زمان پارسرها صرف محاسبهی همین ویژگیها میشه، نه خودِ کارِ پارس کردن.
به خاطر همین مشکلات، بعدترها پارسرهای مبتنی بر شبکههای عصبی معرفی شدن. این مدلها یه نمایش با سایز ثابت، مثلاً یه بردار با سایز هزار، میسازن که فشردهتره، خودش یاد میگیره چی مهمه و چی نه، و عملاً مشکلاتی که بالاتر بهش اشاره کردیم رو نداره.
یکی از معروفترین پارسرهای مبتنی بر شبکههای عصبی سال 2014 توسط Chen و Manning معرفی شد. لازم به ذکره که جناب Manning همین استادی هستن که این کورس رو ارائه میدن و تمام مطالب این بلاگ پست بر اساس ویدیوها و اسلایدهای ایشون نوشته شده!
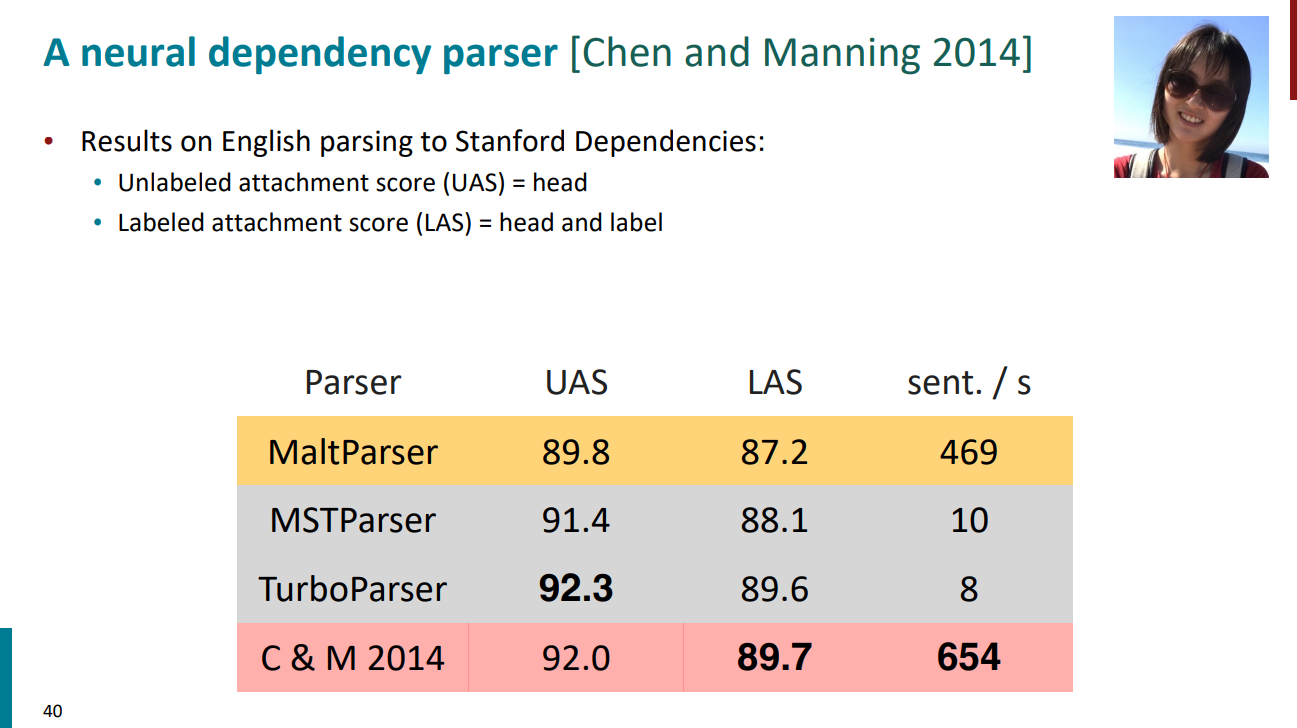
بگذریم! این دوستان برای ارزیابی کارشون از دو معیار UAS و LAS استفاده کردن. با معیار اول (UAS)، فقط چک میکردن که آیا برای هر جمله کلمه head درست انتخاب شده یا نه. با معیار دوم (LAS) علاوه بر تشخیص صحیح head، باید نوع رابطه هم درست تشخیص داده میشد.
یکی از مهمترین ویژگیهای این پارسر، سرعت فوقالعادهاش بوده. مدل Chen & Manning تونست در هر ثانیه 654 جمله رو پردازش کنه، در حالیکه پارسرهای کلاسیک، حتی اونایی که دقت خوبی هم داشتن، در بهترین حالت حدود 469 تا جمله رو در ثانیه پردازش میکردن. یعنی پارسری که این دوستانمون تو دانشگاه استنفورد نوشتن، هم سریعتر بوده و هم از نظر دقت با تقریب خیلی خوبی در حد بهترین پارسرهای اون زمان عمل میکرده.
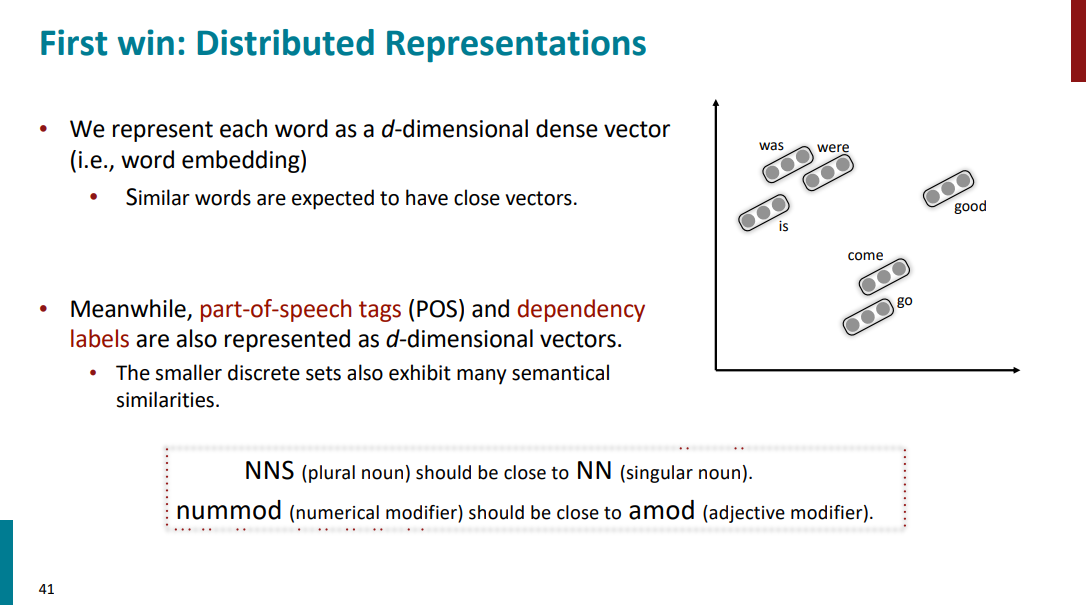
اینکه پارسرهای مبتنی بر شبکههای عصبی (نمونهش همین کار Chen و Manning) تونستن اینقدر دقت و سرعت خوبی ارائه بدن، دو تا دلیل اصلی داشت. اولین دلیل، نحوهٔ نمایش کلمات و نقشهاشون بود. دلیل دوم رو یکم جلوتر بررسی میکنیم.
توی این مدلها، تمام کلمات و نقشهای دستوری به صورت یک سری بردارهای d بعدی نمایش داده میشن؛ یعنی از embedding برای کلمات و حتی برای تگهای دستوری استفاده کردن. این کار باعث میشه کلماتی که از نظر معنا یا کاربرد به هم نزدیکن، توی فضای برداری هم نزدیک هم قرار بگیرن. نه فقط برای کلمات، بلکه برای تگهای دستوری هم همین اتفاق میافته! مثلاً بعد از امبد کردن نقشها، نقش "NNS" (اسم جمع) توی نزدیکی نقش "NN" (اسم مفرد) قرار میگیره، چون از نظر کارکرد خیلی بهم شبیهان.
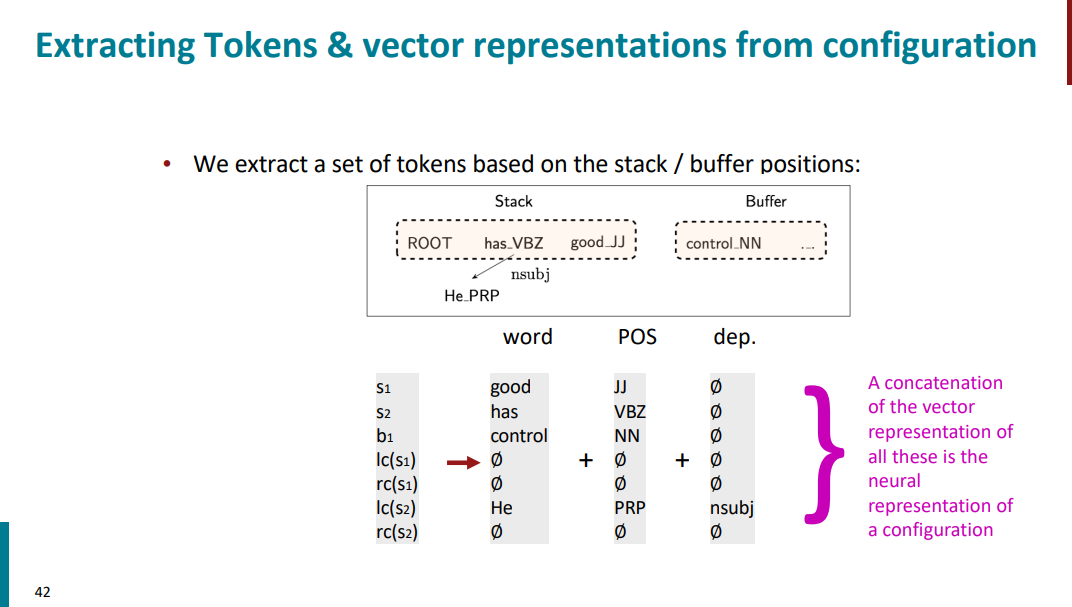
مشابه پارسر حریصانه که جلسه قبلی بررسی کردیم، اینجا هم یک استک و بافر داریم و در نهایت شبکه عصبی که مدلمونه قراره تصمیم بگیره که گام بعدی چیه (بین دو اکشن shift و reduce کدوم رو انجام بده). استک حاوی کلمات در حال پردازش هست و بافر شامل کلماتی هست که هنوز بررسی نشدن.
برای هر کلمه سه تا بردار embedding در نظر گرفته میشه. اول embedding خود کلمه، دوم embedding نقش کلمه در جمله و سوم embedding وابستگی اون کلمه (به عبارت دیگه آخرین رابطهای که برای اون کلمه برقرار شده). در نهایت تمام embeddingها با هم الحاق میشن و به صورت یک embedding نهایی که هر سه امبدینگ دیگه رو در بر داره، به خورد شبکه عصبی داده میشن.
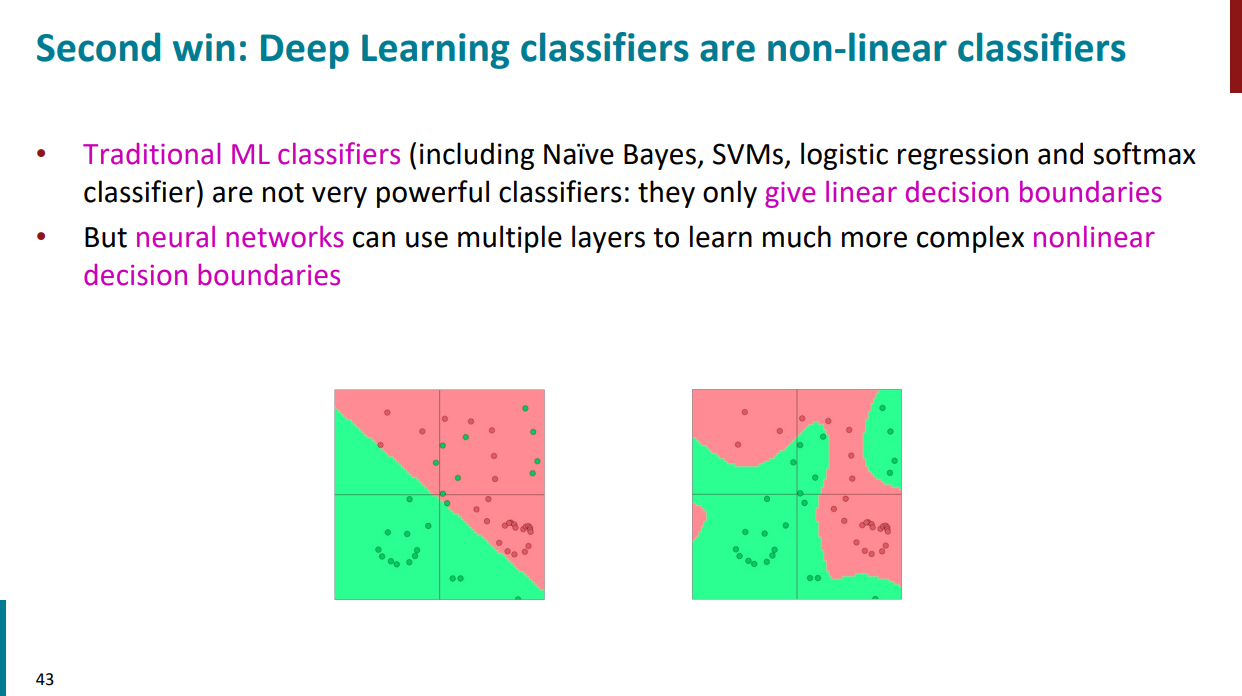
دومین دلیلی که باعث شد پارسرهای مبتنی بر شبکههای عصبی بهتر از روشهای کلاسیک کار کنن، این بود که به کمک شبکههای عصبی روابط پیچیدهتر و غیر خطی هم تشخیص داده میشد، چیزی که مدلهای کلاسیک از کشفشون عاجزن و فقط توانایی کشف رابطههای خطی رو دارن.
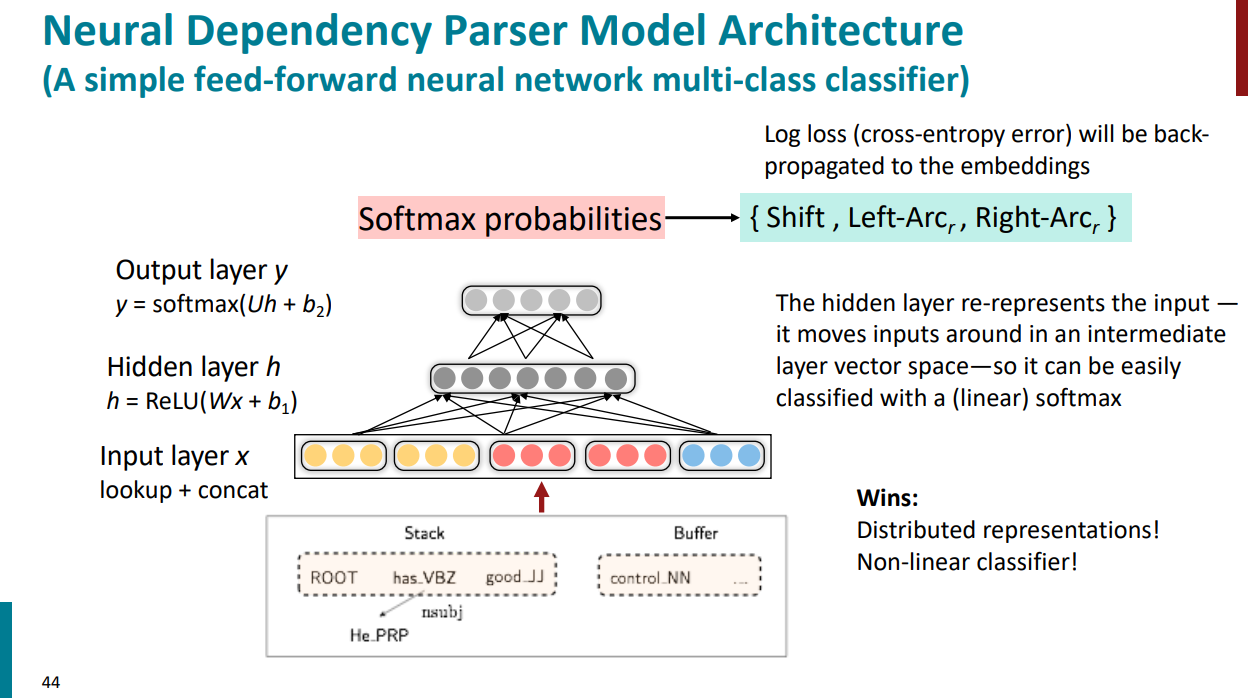
در ادامه میبینیم که چطور شبکه عصبی ساده چند کلاسه feed-forward ای که برای پارسر طراحی کردن کار میکنه. منظورمون از چند کلاسه اینکه شبکه عصبی در نهایت تو خروجی تصمیم میگیره که برای هر کلمه از بین چند تا اکشن (shift و left-arc و right-arc) کدوم رو انتخاب کنه.
لایه اول ورودیهامون هست که اینجا میشه همون الحاق embedding هر کلمه. لایه بعدی میاد ورودیهارو میگیره و روش عملیات جمع و ضرب ماتریسی انجام میده و بعد هم به کمک ReLU دنبال روابط غیرخطی میگرده. در نهایت تو لایه آخر یک softmax زده میشه و مشخص میشه که برای هر اکشن چه احتمالی در نظر گرفته شده. در هر مرحله برای یادگیری back-propagate هم انجام میشه و برای خطا اینجا لگاریتم خطای cross-entropy در نظر گرفته شده.
خلاصه که سال 2014 چِن و مَنینگ تونستن نشون بدن که چطور با یک شبکه عصبی خیلی ساده میشه تسک parsing رو با سرعت خیلی بیشتر و دقت قابل قبول انجام داد.
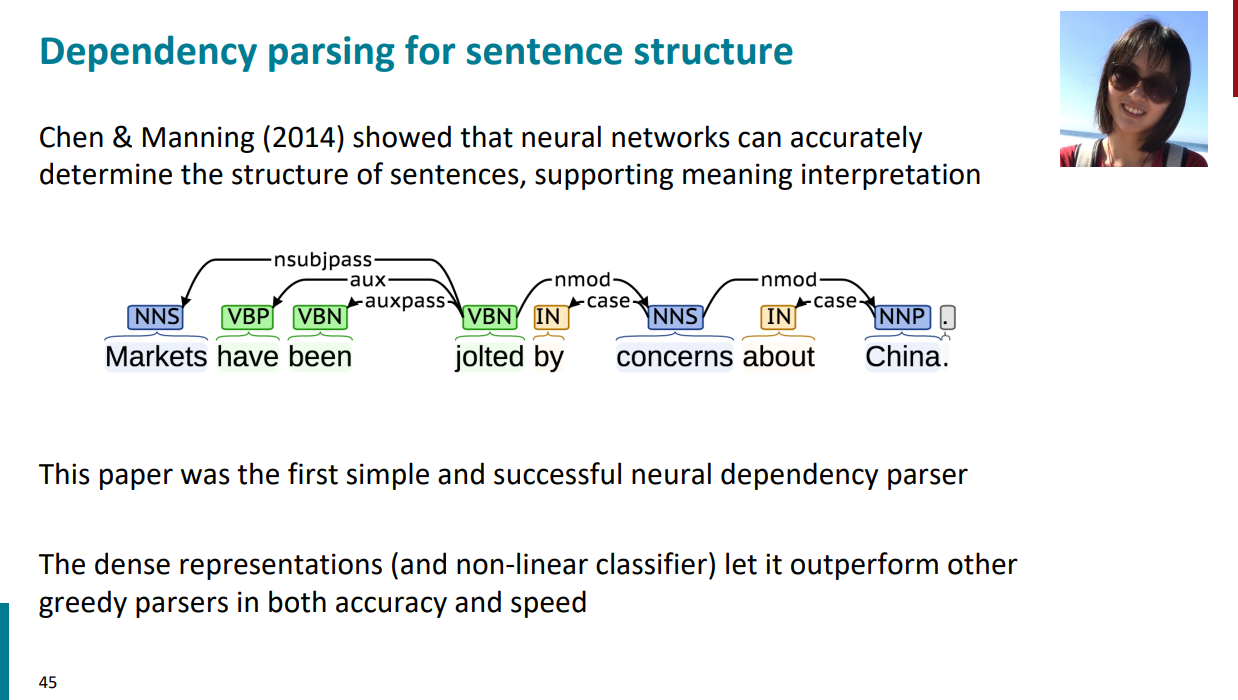
یکی دو سال بعد از این کار، خیلی افراد دیگه، از جمله گوگل، همین ایده رو برداشتن و روی همین تسک و تسکهای متفاوت اپلای کردن و مدل شبکه عصبی رو تغییر دادن و تونستن در نهایت به نتایج بهتری هم تو همین تسک مشابه دست پیدا کنن.
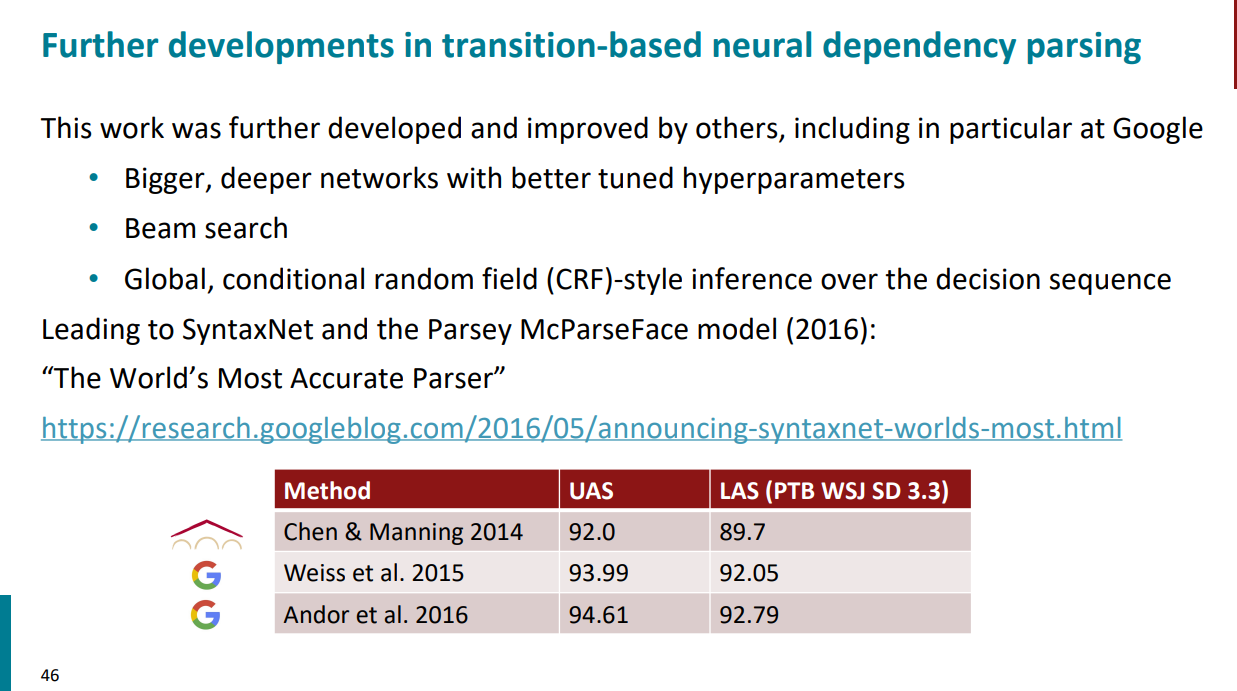
برای پارس کردن، به جز روشهایی که تا اینجا باهاشون آشنا شدیم و بهشون روشهای مبتنی بر جابجایی گفته میشه (Transition-based parser)، یک روش مبتنی بر گراف هم داریم که باهاش میتونیم تسک مشابه رو انجام بدیم. کل کار به این صورت انجام میشه که برای تمامی وابستگیها بین کلماتِ یک جمله، یک امتیازی در نظر گرفته میشه و در نهایت وابستگیای که بیشترین امتیاز رو داشته باشه انتخاب میشه. مثلاً اسلاید زیر رو در نظر بگیرید. دنبال head کلمه big هستیم. برای تک تک کلمات میایم امتیاز وابستگی محاسبه میکنیم و در نهایت کلمه cat با امتیاز 2 بعنوان head کلمه big انتخاب میشه.
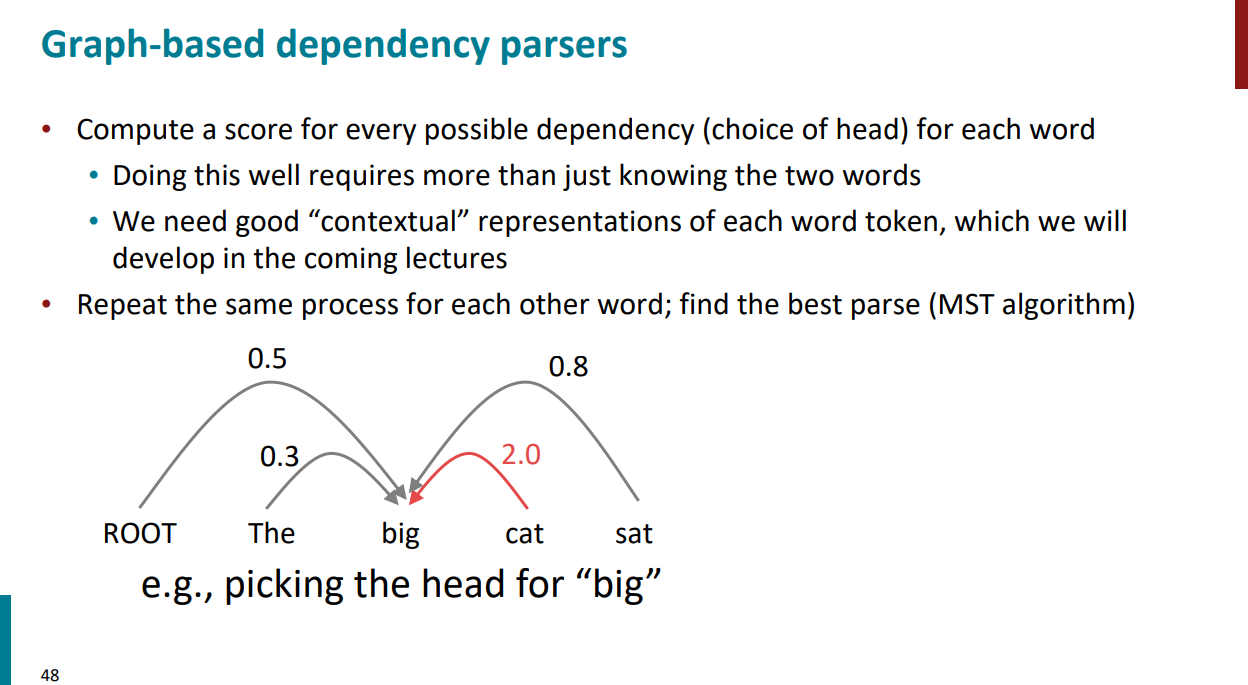
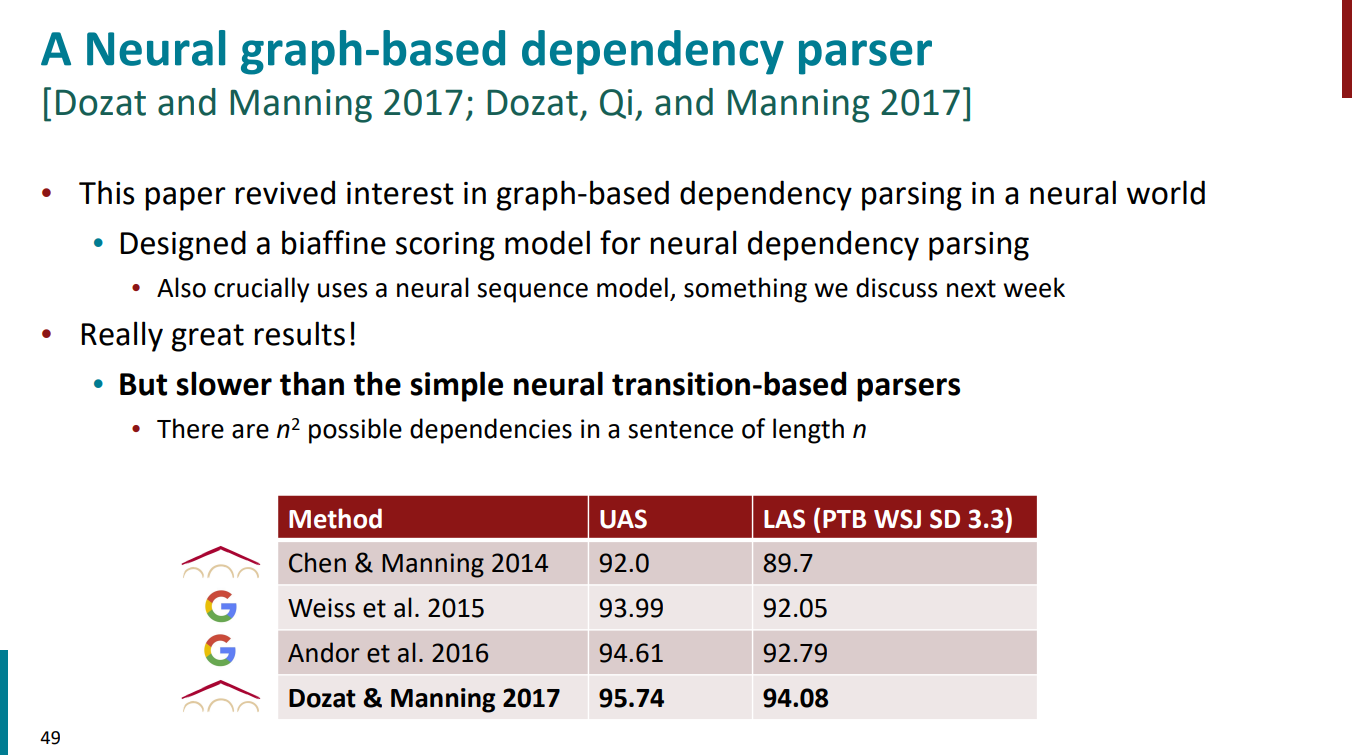
به صورت مشابه برای همین تسک هم مجدداً آقای Manning و این دفعه یک دانشجوی دیگه به اسم Dozat به کمک شبکههای عصبی یک راه حل ارائه دادن که تونست معیارهای UAS و LAS رو خیلی بیشتر بهبود بده. اما از نظر زمانی چون به صورت ذاتی روش مبتنی بر گراف یک تسک زمانگیره و هر دفعه باید بیاد برای تمام کلمات امتیاز وابستگی حساب کنه، به اندازه روشهای مبتنی بر جابجایی سریع نیست.
پرونده پارسرها اینجا بسته میشه و از اینجا به بعد وارد مباحث جدیدی میشیم. اولین مبحثی که در ادامه مورد بررسی قرار میدیم بحث regularization و یا به فارسی منظم سازی هست.
به صورت فرمولی و ریاضی، regularization یک ترم اضافهست که به تابع هزینهی شبکههای عصبی اضافه میکنیم و با کمکش سعی میکنیم پارامترهای مدل و در نتیجه پیچیدگی مدل رو کنترل کنیم.
یک نگاه کلاسیک و کمی قدیمیتر نسبت به regularization اینه که میگه regularization جلوی overfit شدن مدل رو میگیره. منظور از overfit شدن هم به زبان ساده اینه که انگار مدل به جای اینکه الگوهای کلی موجود در داده رو یاد بگیره، بیش از حد خودش رو با دادههای train تطبیق داده، به عبارتی دادههای آموزش رو حفظ کرده و در نتیجه روی دادهی آموزش خیلی خوب عمل میکنه، ولی روی دادههای جدید عملکرد خوبی نداره. اما نگاه جدیدتر، مخصوصاً با توجه به چیزی که در شبکههای عصبی خیلی بزرگ میبینیم، کمی متفاوته. اتفاقاً در مدلهای بزرگ ممکنه خطای آموزش حتی به صفر برسه و این لزوماً مسئلهی اصلی ما نیست. مسئله اینجا اینکه مدل در مورد دادههایی که هنگام آموزش ندیده چطور عمل میکنه. به این مفهوم generalization گفته میشه و به این معنیه که مدلی که روی دادههای آموزش یاد گرفته، چقدر میتونه روی دادههای مستقل و جدیدی که در طول آموزش ندیده هم عملکرد خوبی داشته باشه.
نمودار اسلاید زیر رو برای مثال در نظر بگیرید. نمودار آبی خطای دادههای آموزش و نمودار قرمز خطای دادههای تست رو نشون میده. از یه جایی به بعد میبینیم که خطای آموزش همچنان کاهش پیدا میکنه، ولی خطای تست شروع میکنه به افزایش پیدا کردن و فاصلهی این دو نمودار زیاد میشه. این دقیقاً نشون میده که مدل داره بیش از حد خودش رو با دادههای آموزش تطبیق میده و در نتیجه generalization خوبی نداره؛ یا به اصطلاح، مدل overfit شده.
حالت ایدهآل این نیست که نمودار قرمز دقیقاً روی نمودار آبی قرار بگیره؛ چون معمولاً انتظار داریم خطای دادههای دیدهنشده از خطای دادههای آموزش بیشتر باشه. چیزی که میخوایم اینه که با ادامهی آموزش، عملکرد مدل روی دادهی تست هم در جهت بهبود پیش بره و شکاف بین خطای آموزش و تست بیش از حد زیاد نشه. اینجاست که regularization وارد داستان میشه. Regularization با اضافه کردن یک ترم جریمه به تابع هزینه، به ما اجازه میده پیچیدگی مدل رو کنترل کنیم و در بسیاری از موارد به بهبود generalization کمک کنیم.
این ارتباط معمولاً با پارامتری به اسم λ کنترل میشه. اما نکتهی مهم اینه که رابطهی λ و generalization مستقیم و خطی نیست. اگر λ خیلی کوچک باشه، regularization ضعیفه و احتمال overfitting بیشتر میشه. اگر λ خیلی بزرگ باشه، مدل بیش از حد محدود میشه و ممکنه دچار underfitting بشه. بنابراین معمولاً یک مقدار میانی و مناسب برای λ وجود داره که بهترین generalization رو ایجاد میکنه.
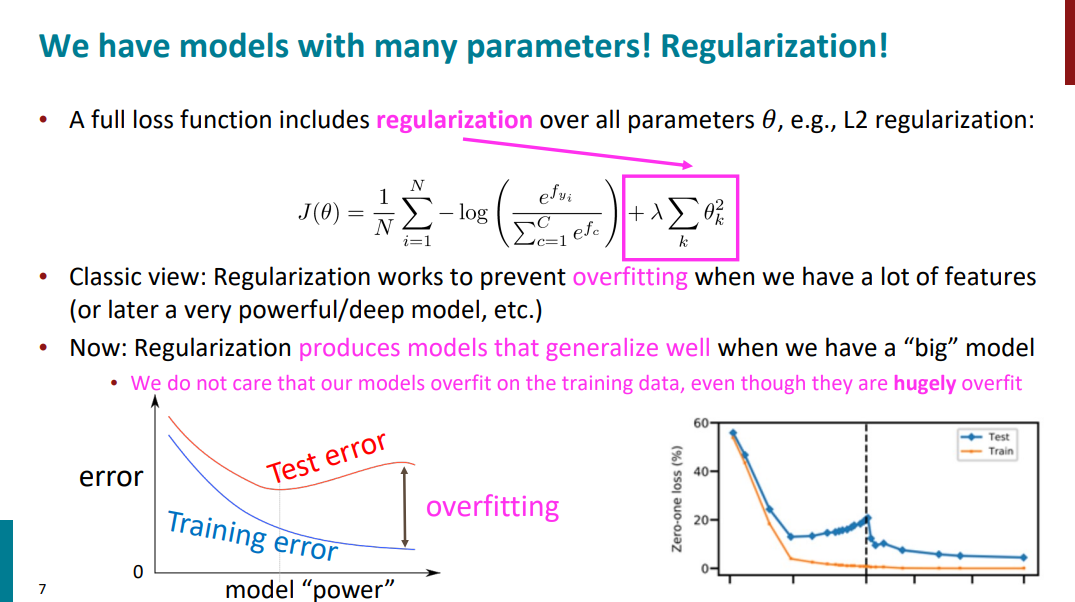
برای regularization تکنیکهای مختلفی وجود داره و برای مثال تو اسلاید بالا به L2 regularization اشاره شده، به این صورت که تمام پارامترهای مدل رو اول به توان دو میرسونه و بعد همهرو باهم جمع میکنه. نکتهی مهم اینه که این ترم به خود دادههای آموزشی و تعداد نمونهها وابسته نیست؛ یعنی برای هر نمونهی آموزشی جداگانه محاسبه نمیشه، بلکه بر اساس پارامترهای فعلی مدل محاسبه میشه.
تکنیک دیگهای به اسم dropout وجود داره که به خصوص در شبکههای عصبی خیلی ازش استفاده میشه. ایده کلی این روش به این صورته که در طول آموزش بخشی از فیچرها (که با یه احتمالی و به صورت رندوم انتخاب میشن) عمداً صفر میشن و این کار باعث میشه تا در هر مرحله از آموزش، مدل یک شبکه متفاوتتر از دفعه قبلی رو یاد بگیره.
برای مثال اسلاید زیر رو در نظر بگیرید. تو این مثال احتمال صفر شدن هر فیچر 0.5 در نظر گرفته شده. به عبارتی دیگه، هر بار که training اتفاق میفته، 50 درصد فیچرها به صورت تصادفی صفر میشن. لازم به ذکره که موقع فرایند تست دیگه dropout نداریم و همه فیچرها وجود دارند.
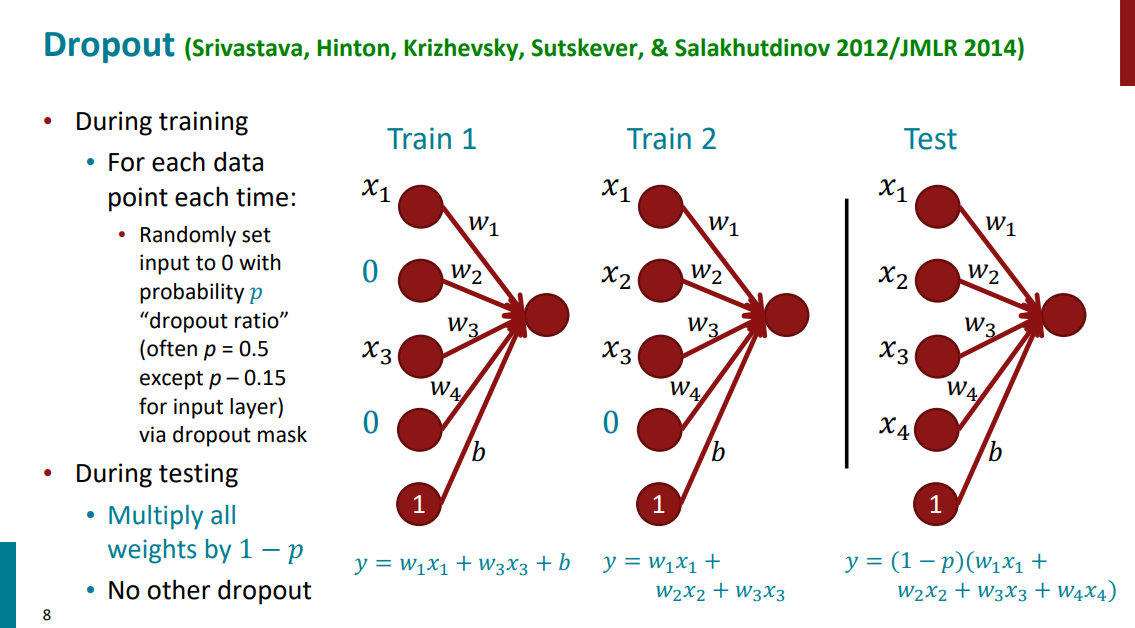
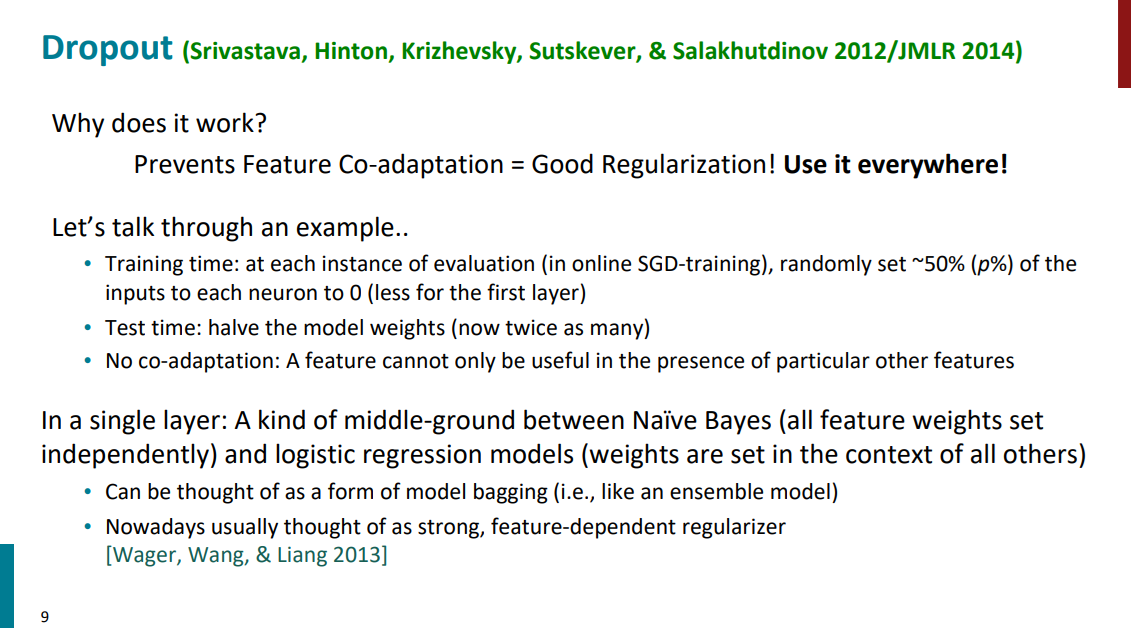
این تکنیک باعث میشه که مدل از ارتباط بین فیچرها باهم کمتر استفاده کنه یا اصلاً استفاده نکنه. به عبارتی دیگه، feature co-adaptation رو کاهش میده و باعث میشه که regularization بهتری اتفاق بیفته. مثلاً اگر مدل همواره فیچر قد و وزن رو بیش از حد باهم ببینه و سعی کنه از ارتباط بین این دو فیچر برای پیشبینی استفاده کنه، dropout میاد و وابستگی مدل به وجود هر دو فیچر همزمان رو از بین میبره و باعث میشه که مدل یاد بگیره با فیچرهای مستقل از هم خروجی خوبی داشته باشه.
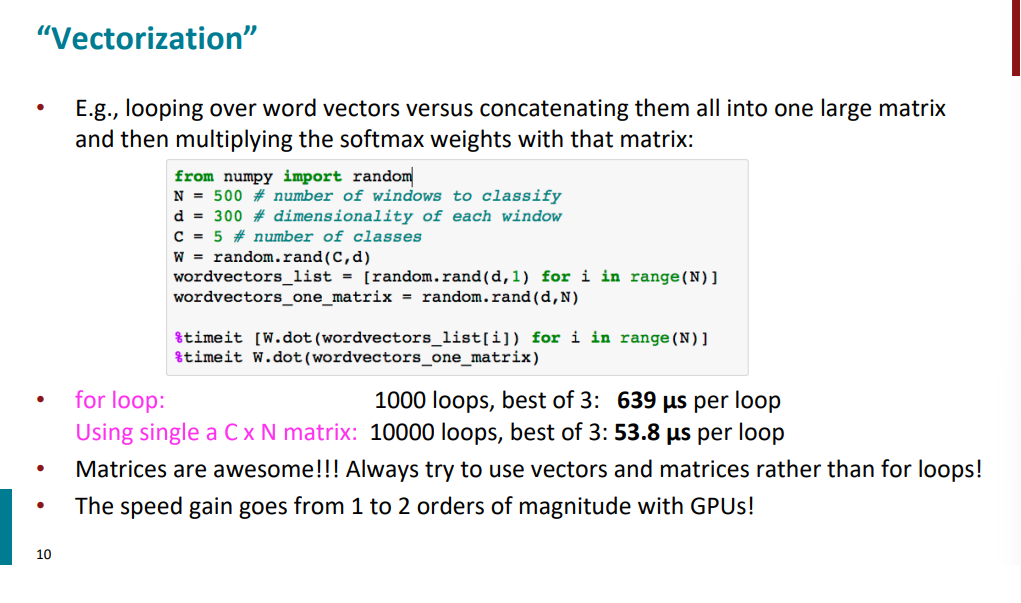
موضوع بعدی که زمان پیادهسازی باید بهش توجه داشت، بحث vectorization یا بردارسازی هست. به این منظور که به جای استفاده از حلقهها وقتی که داریم کد میزنیم، بیایم از بردارها و ماتریسها استفاده کنیم و سرعت پردازش کدهارو به صورت چشمگیری افزایش بدیم.
یکی از ویژگی شبکههای عصبی اینکه به صورت لایه لایه هستن. اگر این لایهها خطی باشن در نهایت collapse میشن به یک لایه و اصلاً مفهوم لایه لایه بودن رو از بین میبرن. برای همین نیازه که در شبکههای از مفهوم غیر خطی بودن استفاده بکنیم تا هر لایه بتونه بدون اینکه از بین بره کار خودش رو انجام بده. به عبارتی دیگه، اگه بخوایم با شبکههای عصبی کارهای خفن بکنیم، مثلاً پترنهای جذاب در بیاریم به کمک غیرخطی بودن لایهها میتونیم انجامش بدیم.
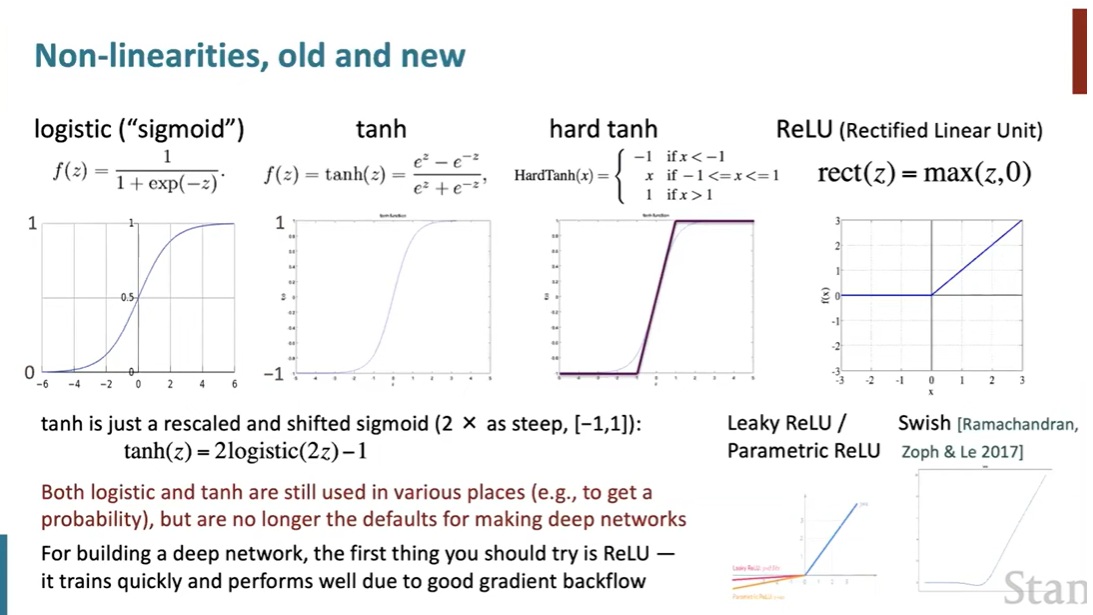
یکی از کلاسیکترین توابع غیرخطی تابع سیگمویده که همه اعداد حقیقی رو بین 0 تا 1 مپ میکنه. یکی از معایب این تابع اینکه همه چیز رو تو بازه مثبت نگه میداره. اگه بازه منفی بخوایم چی؟ برای رفع این مشکل اومدن یه تابع غیرخطی دیگه از روی خود سیگموید به اسم tanh معرفی کردن که رفتارش خیلی شبیه سیگمویده ولی بازه مپ کردنش از منفی 1 تا مثبت یکه.
همین تابع tanh رو گرفتن و یکم درجه غیرخطی بودنش رو کمتر کردن و یه تابع غیرخطی جدید به وجود آوردن به اسم hard tanh. یه تابع دیگه هم وجود داره به اسم ReLU یا رلیو که کمترین درجه غیرخطینگی رو داره که وقتی ورودی کمتر از 0 باشه هیچ کاری نمیکنه و وقتی ورودی بیشتر از 0 باشه به صورت خطی فعال میشه.
ممکنه سوال پیش بیاد که اصلاً چرا از این تابع استفاده میشه اگه درجه غیرخطی بودنش اینقدر کمه؟ جواب اینکه از اونجایی که تابع رلیو خیلی سریع train میشه و عملکرد خوبی توی شبکههای عصبی داره، وقتی یه شبکه عصبی جدیدی میسازن دم دستیترین تابع غیرخطی که اتفاقاً پرفورمنس خوبی هم داره همین تابع رلیو عه که ازش استفاده میکنن. خلاصه که نباید اصلاً دست کم گرفته بشه.
یه سری توابع غیرخطی دیگه از روی ReLU معرفی شده که تفاوتهای اندکی باهاش داره و یکم ویژگیهاش فرق داره. مثلاً یکیشون اسمش Leaky ReLU عه و یکی دیگه Swish که تو اسلاید زیر هم آورده شده. هر کدوم ویژگیهای خاص خودشون رو دارن، حتی تو paper مربوط بهشون هم ذکر شده که تو تسکای مشابه از ReLU عملکرد بهتری دارن، اما همچنان خیلیا استفاده از ReLU رو به این توابع ترجیح میدن.
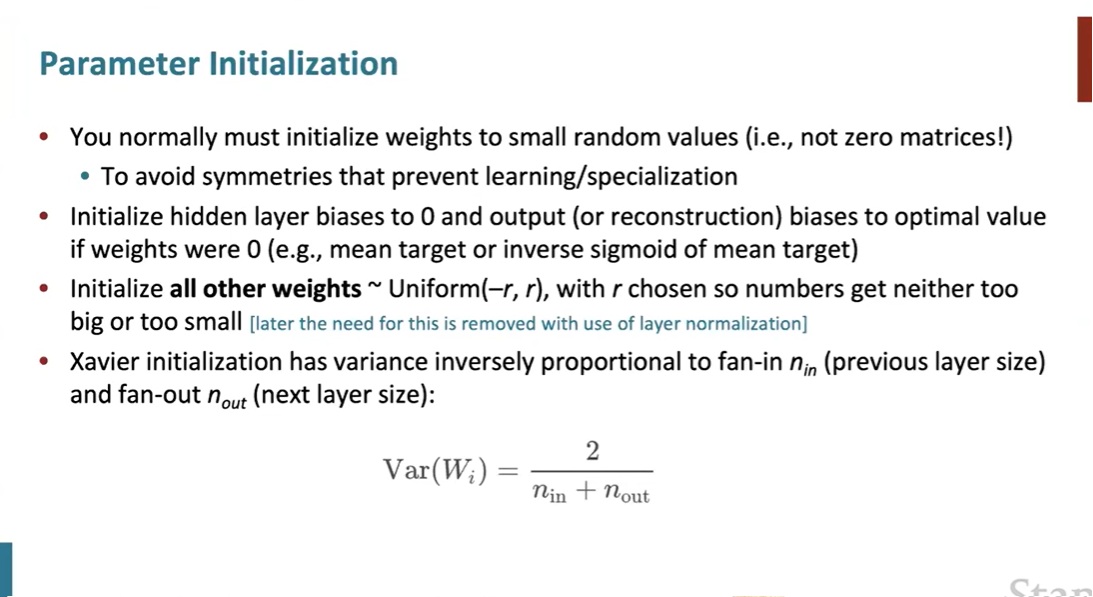
موضوع بعدی که در بحث شبکههای عصبی باید بهش توجه کنیم بحث مقداردهی اولیه پارامترهاست. هر شبکه عصبی در واقع یک سری ماتریسه که عملیات ریاضی روش انجام میشه و این موضوع مهمیه که مقدار اولیه ماتریسها (که معمولاً مقادیر خیلی کوچیک و رندوم هستن) چی باشه و چطور مقداردهی بشه. مثلاً نمیتونیم مقدار اولیه رو برابر با صفر بذاریم. چون همه چیز قرینه میشه و اصلاً هیچ اطلاعات خاص و به درد بخوری از اون شبکه عصبی بیرون نمیاد.
یکی از روشهایی که پیشنهاد شده اینکه بیایم یه بازه (عددی مثل r) در نظر بگیریم و از توزیع یکنواخت بین منفی تا مثبت اون عدد استفاده کنیم برای مقداردهی رندوم اولیه پارامترها. این کار باعث میشه اعدادی که انتخاب میشن با اینکه رندوم هستن ولی دیگه خیلی خیلی بزرگ یا خیلی خیلی کوچیک نباشن.
یه روش دیگهای داریم به اسم مقداردهی Xavier (یا خاویِر) که تو پایتورچ هم از همین روش معمولاً برای مقداردهی اولیه پارامترها استفاده میشه، و بر اساس میزان اتصالات هر لایه تو شبکه عصبی مقداردهی رو انجام میده. هر لایه تو شبکه عصبی تعدادی ورودی که در واقع سایز لایه قبلیشه (fan in) و تعدادی خروجی که سایز لایه بعدیشه (fan out) داره. روش Xavier با در نظر گرفتن fan in و fan out، مقدار اولیه وزنها رو طوری انتخاب میکنه که واریانس مقادیر در طول شبکه خیلی بزرگ یا خیلی کوچیک نشن. به عبارتی دیگه، Xavier سعی میکنه مقدار اولیه پارامترها (وزنها) رو متناسب با تعداد اتصالات لایهها مشخص کنه، یعنی هرچی تعداد ورودیها و خروجیهای یک لایه بیشتر باشه، وزنهای اولیه معمولاً با مقادیر کوچکتری انتخاب بشن.
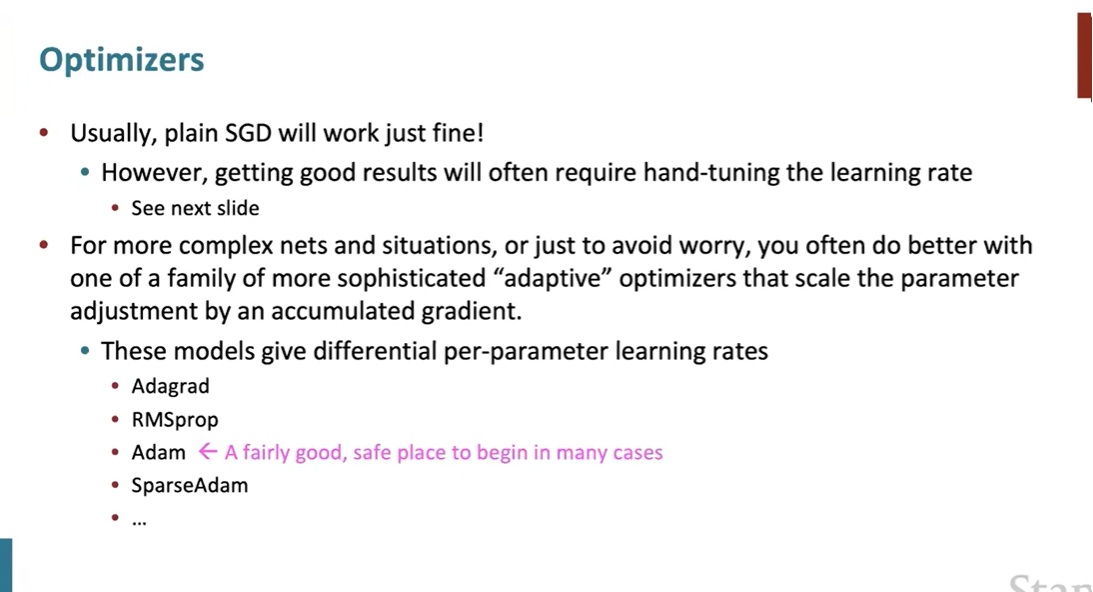
مبحث بعدی که بهش میرسیم، training یا آموزش مدل هست. یکی از روشهای پایهای برای آموزش شبکههای عصبی، Stochastic Gradient Descent یا SGD هست که در خیلی از مسائل میتونه عملکرد خوبی داشته باشه. یکی از چالشهای مهم در استفاده از SGD، انتخاب و تنظیم learning rate عه، چون مقدار نامناسبش میتونه باعث بشه آموزش خیلی کند انجام بشه یا حتی مدل نتونه به خوبی یاد بگیره. یکم جلوتر در مورد learning rate و نحوه تنظیمش بیشتر توضیح میدیم. اگه با الگوریتم گرادیان کاهشی و یا اصلاً با مفهوم گرادیان آشنایی ندارید، پیشنهاد میکنم یه نگاهی به این پست بندازید.
اگه شبکه عصبیمون پیچیدهتر باشه، میتونیم از adaptive optimizerها استفاده کنیم. این optimizerها علاوه بر گرادیان فعلی، از اطلاعات گرادیانهای قبلی هم استفاده میکنن و میتونن نحوه و اندازه تغییر هر پارامتر رو خودشون به صورت adaptive تنظیم کنن. از معروفترین این روشها میشه به Adagrad، RMSprop و Adam اشاره کرد.
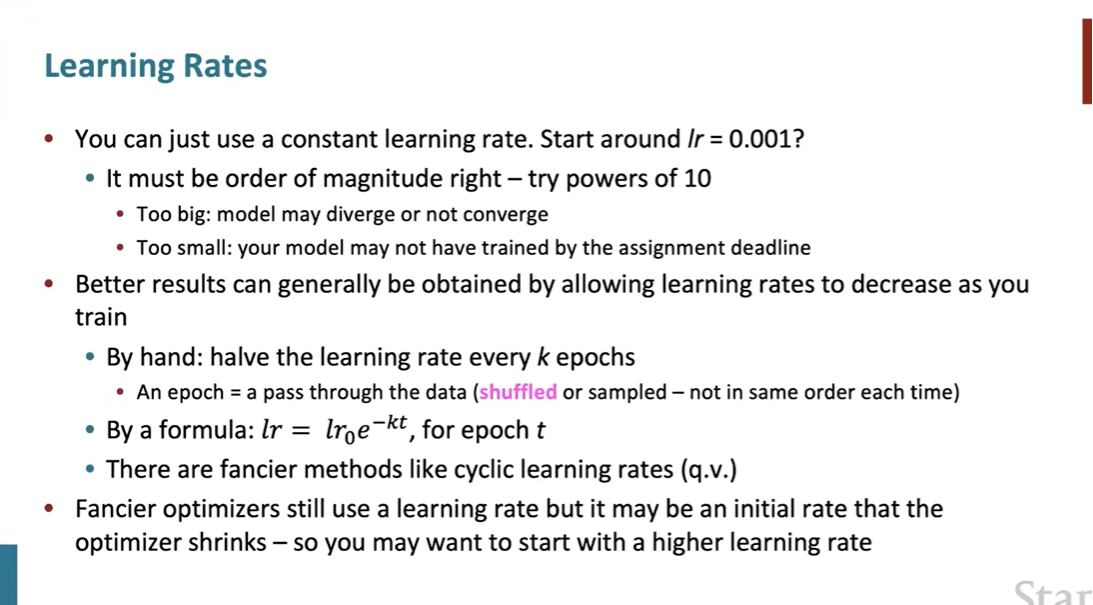
نرخ یادگیری یا گام یادگیری تو الگوریتم گرادیان کاهشی سایز گامهاییه که الگوریتم در هر مرحله برمیداره. اگه یه عدد ثابت در نظر بگیریم براش از اول تا آخر با همون اندازه ثابت مسیر رو پیش میبره. بهترین کار اینکه اوایل کار سایز قدمها بزرگتر باشه و هرچقدر جلوتر میره سایز قدمها کوچیک و کوچیکتر بشه. اگه learning rate بیش از حد بزرگ باشه باعث میشه که الگوریتم هیچوقت به اون نقطه بهینهای که باید برسه نرسه، اگه هم بیش از هم کوچیک باشه باعث میشه که پروسه یادگیری مدل خیلی خیلی طولانی بشه. خلاصه که روشهای مختلفی وجود داره برای این موضوع ولی یکی از بهترین متدها براش اینکه هر k ایپوکی که از آموزش گذشت، نرخ یادگیری رو نصف مقدار قبلیش بکنیم. ایپوک چیه؟ هربار که تمام نمونههای دیتای ترین تموم میشن بهش یه ایپوک میگن.
تا اینجای کار با شبکههای عصبی آشنا شدیم در حد یک مقدمه و دیدیم که کلیات به چه صورته. اگه مفاهیم گنگه یا بعضی جاها ناآشناست یا به اندازه خوبی وارد جزییات نشده، بخاطر اینکه این کورس پیش فرضش اینکه مخاطب الردی یه دانش پایهای از یادگیری ماشین و جبر خطی و حدودی ریاضیات پایه داره و اصلاً هدفش این نبوده که از پایه مفاهیم شبکههای عصبی رو باز کنه، فقط میخواسته یه مقدمه و کلیات بگه. از اینجا به بعد قراره با مدلهای زبانی و شبکههای عصبی بازگشتی RNN آشنا بشیم.
مدل کردن زبان یا language modeling در پردازش زبان طبیعی یه تعریف خیلی دقیق و فنی داره و به این معناست که کلمه بعدی رو پیشبینی کنیم. فرض کنید یه context داریم مثلاً یه جمله مثل the students opened their ... به این میگیم context و تسکمون اینجا اینکه بفهمیم کلمه بعدی (بعد از their) که قراره توی جای خالی بیاد چیه.
یکم تکنیکالتر اگه بخوایم صحبت کنیم، انگار که یک رشته از کلمات داریم و قراره توزیع احتمال کلمه بعدی رو محاسبه کنیم. پس language model یک توزیع احتمالاتی بر روی کلمه بعدیه به صورتی که context فعلی رو داریم (given رشته کلمات فعلی).
حالا سیستمی که میاد و این کار رو برامون انجام میده مدل زبانی یا language model بهش میگن.
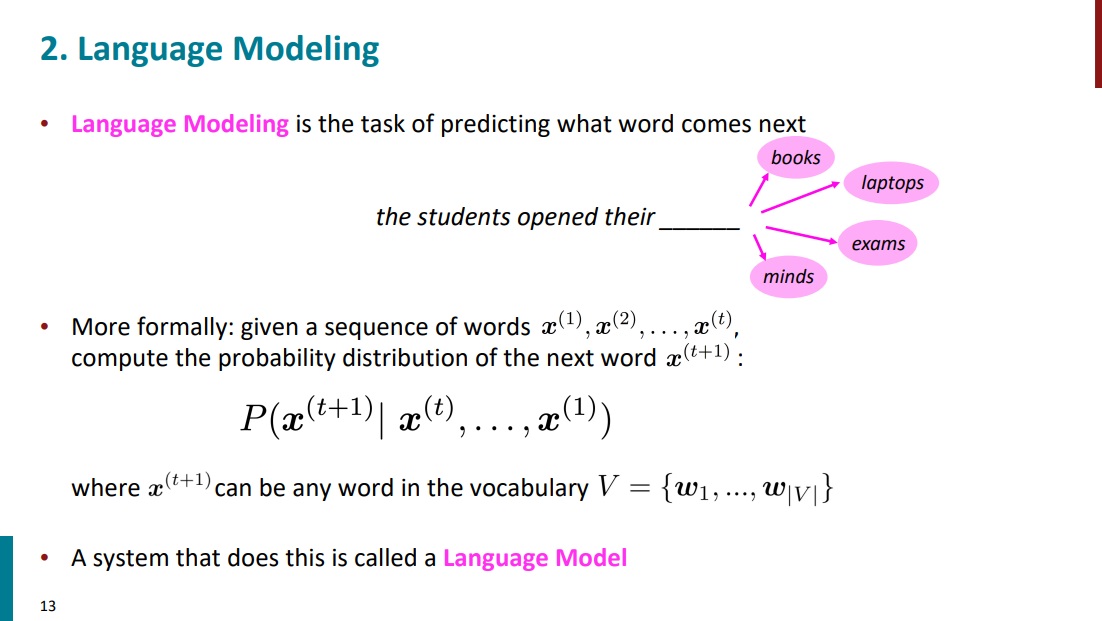
همین موضوع رو میشه به متنها هم نسبت داد. به جای اینکه تعدادی کلمه بهمون بدن و تسکمون این باشه که کلمه بعدی رو پیشبینی کنیم، تعدادی متن بهمون بدن و تسکمون این باشه که متن یا تکست بعدی رو پیشبینی کنیم.
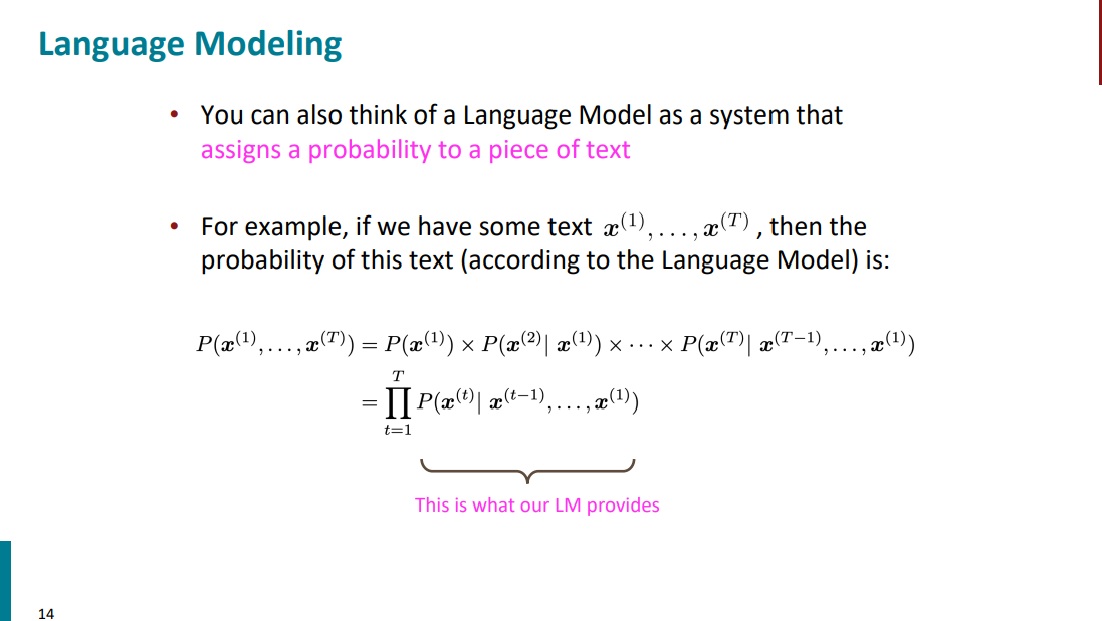
کاربردهای مدلهای زبانی رو تقریباً همه جا دیدیم. مثلاً تو کیبورد گوشیهامون، وقتی داریم تایپ میکنیم بر اساس کلماتی که نوشتیم کلمات بعدی رو خودش بهمون پیشنهاد میکنه، یا وقتی که داریم تو گوگل سرچ میکنیم و خودش میاد عبارتی که دنبالش هستیم رو کامل میکنه یا عبارات دیگه بهمون پیشنهاد میده. حالا یه تفاوتی که اینجا وجود داره اینکه مدل زبانیای که روی کیبورد گوشیمون هست مدل خیلی کوچیک و محدودیه و در مقایسه با مدلی که گوگل استفاده میکنه، برای همین هم پیشنهاداتی که میده عموماً خیلی ساده هستن.
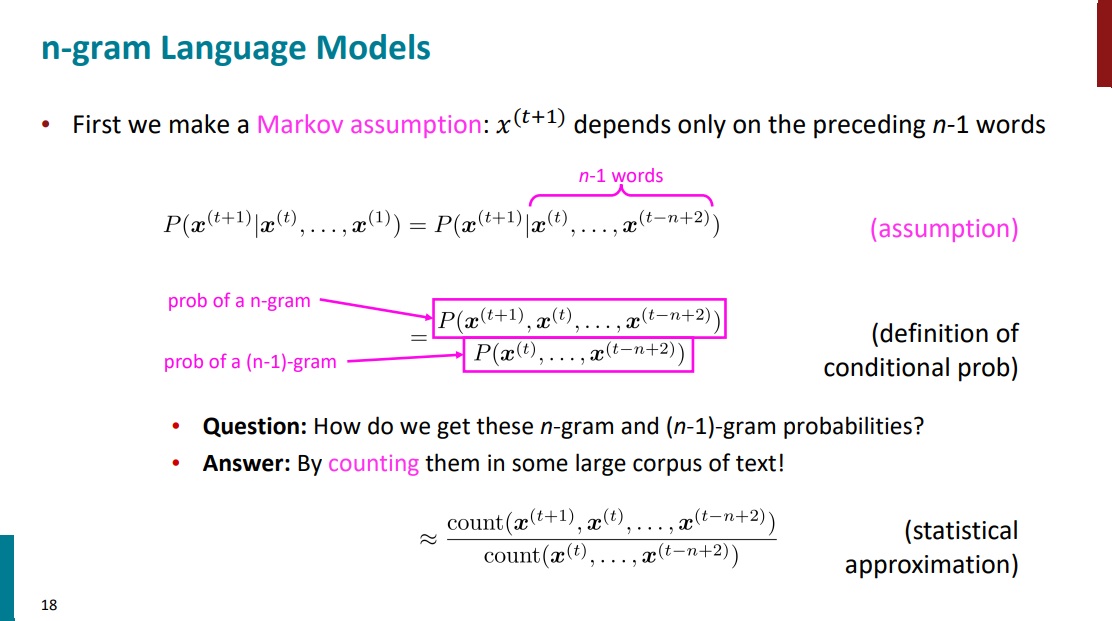
به مدت دو الی سه دهه، خیلی قبلتر از اینکه شبکههای عصبی اینقدر فراگیر بشن و مدلهایی مثل GPT بیان، برای ساخت مدلهای زبانی از روشی به اسم n-gram استفاده میکردن. n-gram در حقیقت یک روش آماری برای مدلسازی زبان بوده که ایده کلیش این بود که بررسی کنه توالیهای مختلف از کلمات با چه فراوانیای در یک متن یا مجموعه داده اتفاق میفتن و بر اساس اون، احتمال رخ دادن کلمات (کلمه بعدی) رو تخمین بزنه. به جای n اعداد مختلف میان. مثلاً unigram یعنی کلمات رو تکی بررسی کنیم. bigram یعنی جفت جفت کلمات رو بررسی کنیم. trigram یعنی کلمات رو سه تایی بررسی کنیم و 4-gram یعنی چهار تا کلمه رو کنار هم در نظر بگیریم و بررسی کنیم.
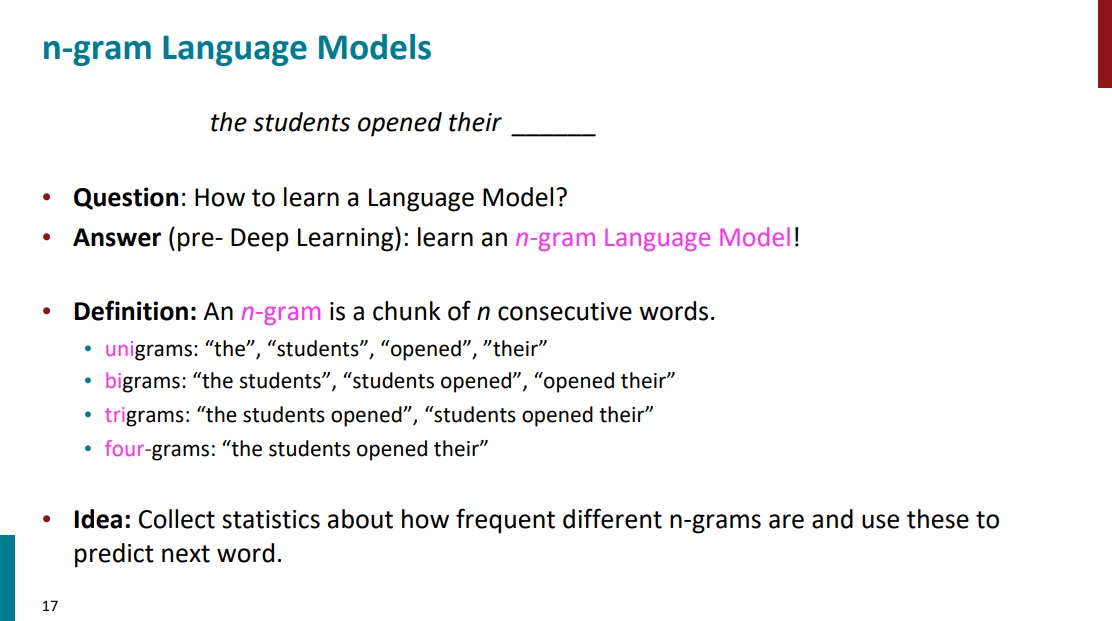
برای انجام محاسبات n-gram، اول از همه یک فرض مهم داریم که بهش Markov assumption میگیم. این فرض میگه برای پیشبینی اتفاق بعدی، لازم نیست کل تاریخچه رو در نظر بگیریم و فقط به تعداد محدودی از اتفاقهای قبلی نگاه میکنیم. مثلاً اگر بخوایم کلمه هفتم رو پیشبینی کنیم و از bigram استفاده کنیم، فرض میکنیم کلمه هفتم فقط به کلمه ششم وابستهست و کاری با کلمات قبلتر نداریم. به صورت کلیتر، در یک n-gram model فرض میکنیم کلمه بعدی فقط به (n-1) کلمه قبلی وابسته است. حالا گام بعدی اینه که از تعریف احتمال شرطی استفاده کنیم. برای مثال، در bigram میخوایم احتمال یک کلمه رو با توجه به کلمه قبلیش محاسبه کنیم. طبق تعریف احتمال شرطی، میتونیم این احتمال رو با تقسیم احتمال رخ دادن جفت کلمات بر احتمال رخ دادن کلمه قبلی به دست بیاریم.
حالا این احتمالات رو چطور محاسبه کنیم؟ میتونیم از روشهای آماری استفاده کنیم و در سادهترین حالت، تعداد رخدادها یا شمارش کلمات و n-gramها در دادههای آموزشی رو به دست بیاریم و از این شمارشها برای تخمین احتمال استفاده کنیم.
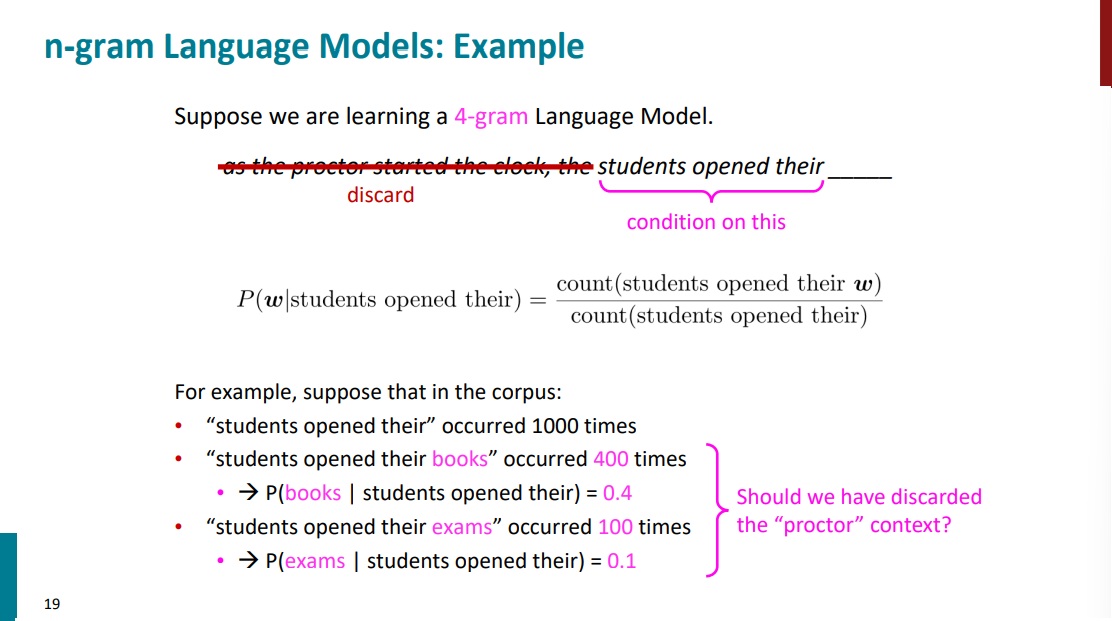
در ادامه یه مثال ببینیم تا همه چیزایی که گفتیم بهتر جا بیفته. فرض کنید یه مدل زبانی 4-gram داریم. جملهای هم که داریم اینه:
as the proctor started the clock, the students opened their ...
تو اینجا n برابره با 4 پس طبق فرض مارکف فقط میایم 3 تا کلمه آخر قبل از جای خالی رو در نظر میگیریم و بقیه کلمات رو دور میریزیم. بعد باید بیایم احتمال کلمات مختلف به صورتی که بعد از جمله students opened their میان رو حساب کنیم. حالا فرض کنید تو کل پیکرهای که داریم (تعداد زیادی متن که قراره توشون بگردیم) این ترکیب که جمله students opened their اومده باشه هزار بار رخ داده باشه. حالا میخوایم ببینیم چه کلماتی بعد از their میتونن بیان و احتمال اومدن اونا به چه شکله. بعد از شمارش مشخص میشه 400 بار books بعد از their تو همون ترکیب اومده، یا کلمه exams صد بار اومده و همینطور الی آخر. این تعداد رو به تعداد کل که 1000 بود تقسیم میکنیم و احتمال رو برای هر کلمه محاسبه میکنیم. حالا اگر روش انتخابمون بزرگترین احتمال باشه در نهایت بین همه احتمالات اون کلمهای که از همه احتمالش بیشتر بوده (اینجا books) رو انتخاب میکنیم.
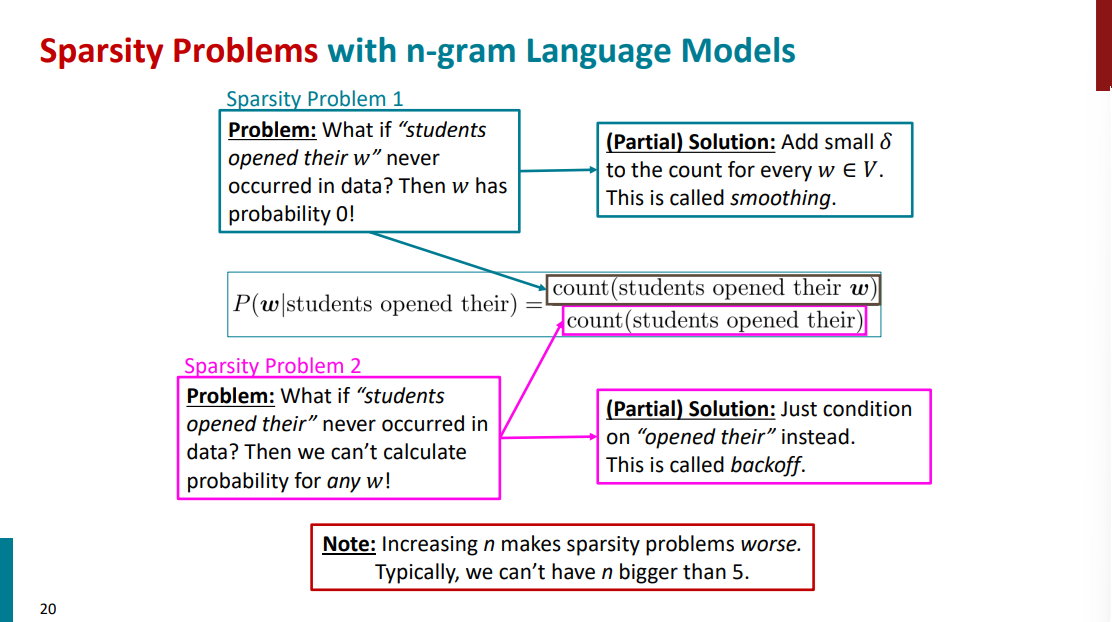
گفتیم که برای محاسبه احتمال میایم از شمارش کلمات استفاده میکنیم. حالا این وسط دو تا حالت پیش میاد. اولین حالت اینکه اگه صورت کسر صفر بشه چی؟ مثالی که زدیم رو در نظر بگیرید. مثلاً هیچوقت ترکیب students opened their w وجود نداشته باشه. در این صورت باعث میشه که احتمالی که حساب میکنیم صفر بشه و همین مشکل sparsity ایجاد میکنه. یه روش دم دستی برای حل این مشکل اینکه اومدن یه عدد خیلی کوچیک مثل دلتارو تو صورت کسر با احتمال جمع کردن و به این کار smoothing میگن.
در مورد sparsity اگه بخوام خیلی کلی توضیح بدم، مثلاً یه ماتریس 10 در 10 رو در نظر بگیرید. فرض کنید از این 100 تا خونه نهایتا چهار تاش یه مقدار غیر صفر داشته باشه و بقیه 96 تا خونه مقدارش صفر باشه. این ماتریس اصطلاحاً اسپارسه. چون فقط چهار تا خونهش مقدار غیر صفر دارن و برای ذخیره کردن اون صفرها هم حافظه مصرف شده. مدل زبانی n-gram هم در نهایت برای اینکه تو کامپیوترها ذخیره بشه به نحوی از ماتریسها براشون استفاده میکنن و اینجاست که صفرها دردسر میشن و هرچقدر مقدار n تو مدل زبانی n-gram بزرگتر باشه اسپارسیتی بدتر هم میشه. در عمل اصلاً نمیشه n رو بزرگتر از 5 در نظر گرفت مثلاً.
حالا مسئله بعدی اینکه اگه مخرج کسر صفر بشه چی؟ این مشکل خیلی حادتره و به این معنیه که ترکیبی از کلمات که دنبالش هستیم کلاً از بیخ تو پیکرهمون نبوده. برای این حالت هم یه روش دم دستی که backoff نام گذاری شده اینکه یکی از کلمات ترکیب رو حذف کنیم دنبال ترکیب بعدیش بگردیم. مثلاً اگر دنبال همه ترکیبهایی به صورت students opened their هستیم و این ترکیب کلا نیست، students رو حذف کنیم و دنبال ترکیب opened their بگردیم.
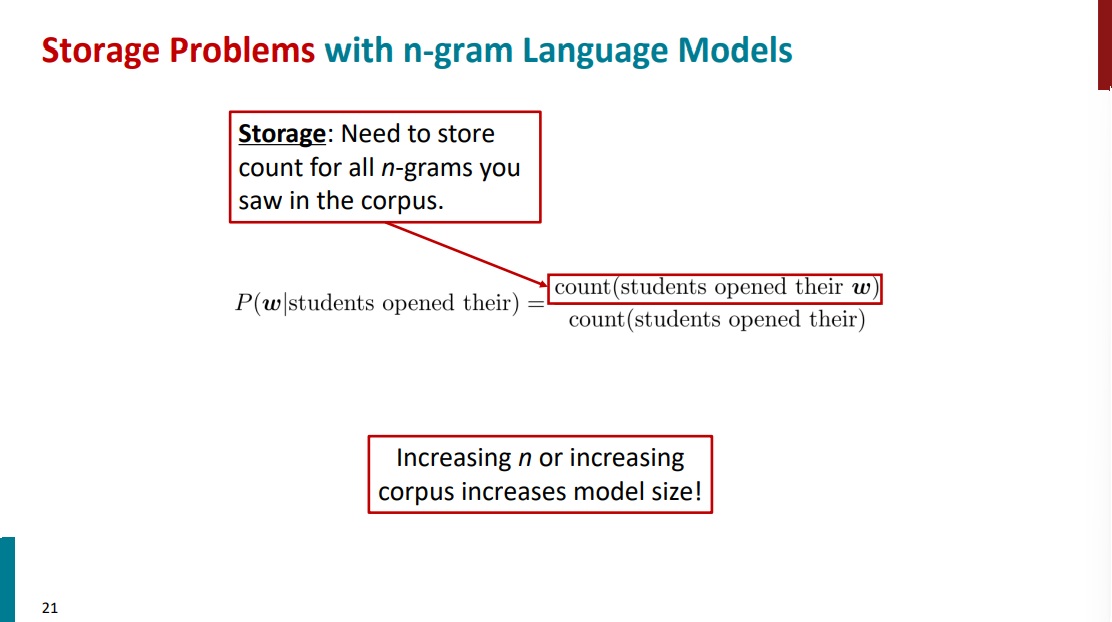
مشکل دیگهای که مدلهای زبانی n-gram دارن بحث حافظهای هست که مصرف میکنن. چه سایز n رو زیاد بکنیم چه سایز پیکرهای که از کلمات داریم رو زیاد بکنیم، جفتشون روی سایز مدل تاثیر میذارن و باعث میشن که زیادی بزرگ بشه و در نهایت حافظه خیلی زیادی مصرف کنه. خلاصه که بخاطر همین مشکلات، کم کم این روشهای کلاسیک منسوخ شدن و جاشون رو به روشهای جدیدتر دادن.
یه مزیتی که مدل زبانی n-gram در مقایسه با مدلهای زبانی مبتنی بر شبکههای عصبی داره اینکه خیلی سریع به کمک یک لپتاپ شخصی آموزش داده میشه. مثلاً در عرض چند ثانیه میشه یه مدل زبانی trigram با یک پیکره حاوی 1.7 میلیون کلمه رو به سادگی آموزش داد و بعد ازش استفاده کرد.
فرض کنید میخوایم یه متن رو به کمک یه مدل زبانی trigram بسازیم. فقط دو تا کلمه اول متن رو داریم به این صورت:
today the ...
و قراره بقیه متن رو به کمک یک مدل زبانی trigram جنریت کنیم.
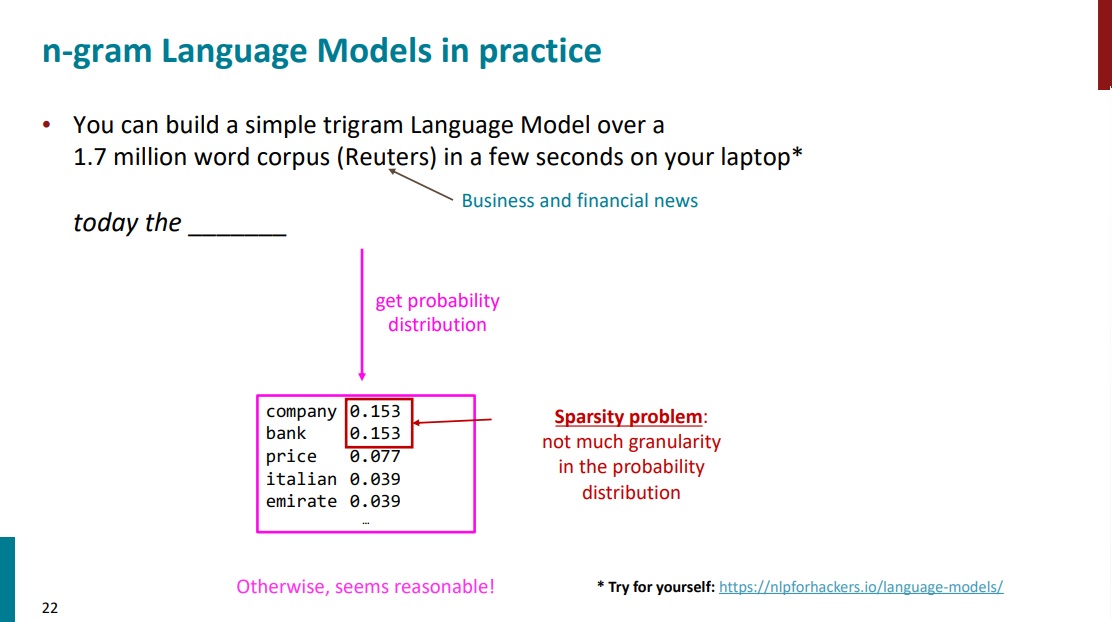
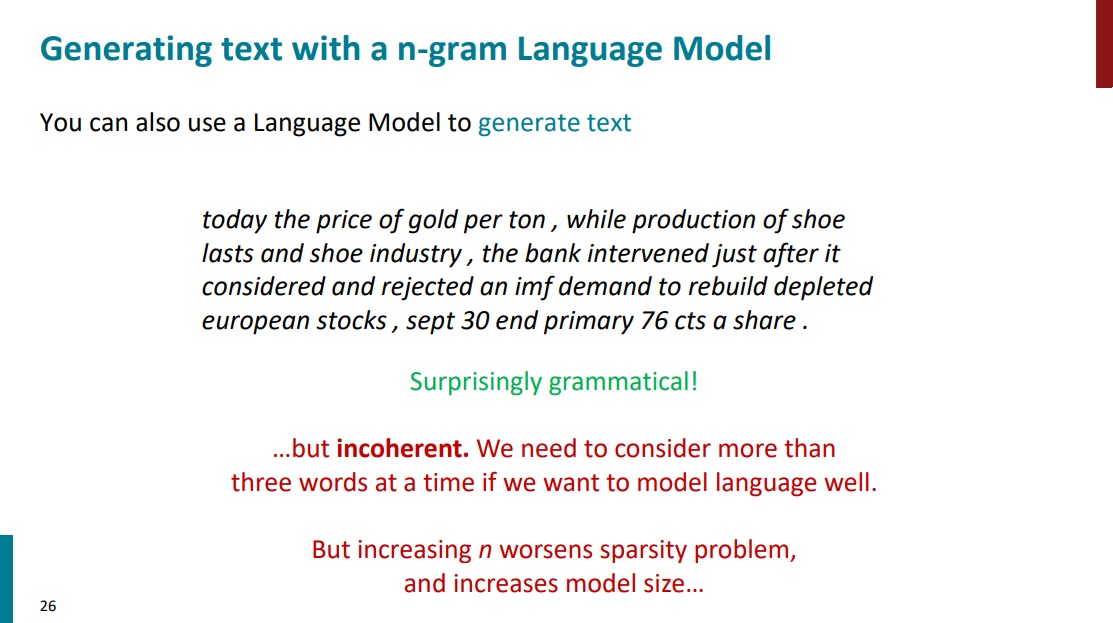
تو مرحله اول بعد اینکه توزیع احتمالاتی رو محاسبه کردیم سمپل برمیداریم و یکی از کلمههارو بعنوان کلمه بعدی انتخاب میکنیم. مثلاً از لیست کلماتی که محتمل بوده بیاد کلمه price انتخاب شده. حالا دوباره همین کار رو تکرار میکنیم و انقدر ادامه میدیم تا متن مورد نظرمون تموم بشه. چند تا اسلاید بعدی نشون میده که چطور در هر مرحله یکی از کلمات انتخاب شده تا در نهایت به متن خروجی رسیدیم.
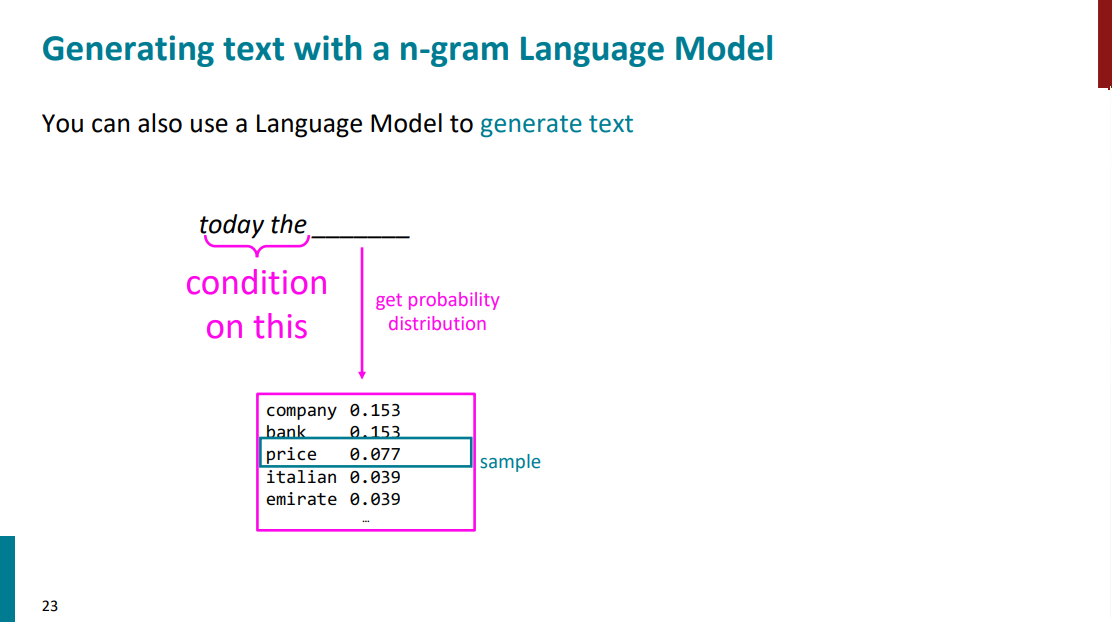
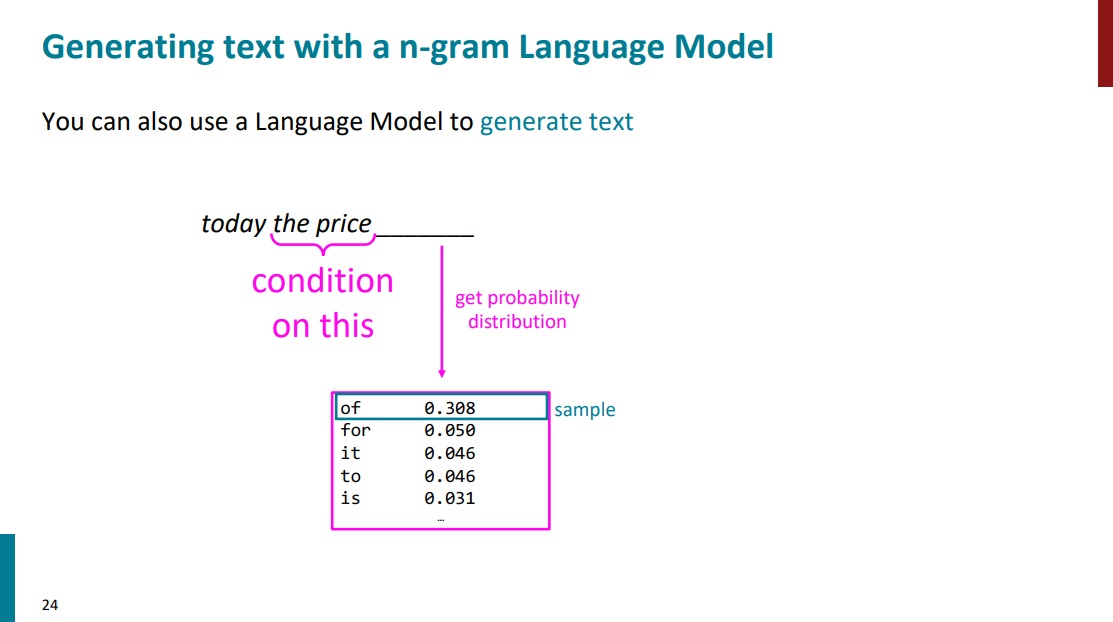
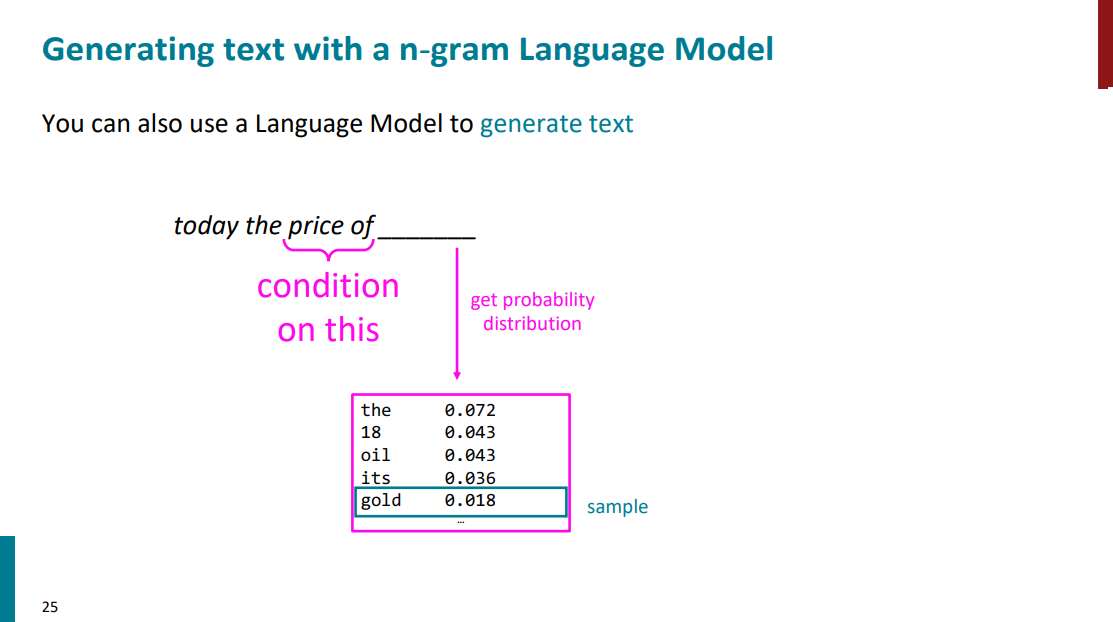
در نهایت متنی که تولید میشه به طرز عجیبی از نظر قواعد دستور زبان و گرامری درسته ولی ایرادات معنایی داره و منسجم نیست. برای اینکه منسجمتر بشه نیازه که در هر لحظه بیشتر از 3 تا کلمه رو ببینیم (مدلمون اینجا trigram بود) اما از طرفی دیگه افزایش n باعث به وجود اومدن مشکلاتی میشه که بالاتر بررسی کردیم. در نهایت نمیشه مدلهای n-gram رو از اینی که هست بهتر کرد و همین باعث شده که از شبکههای عصبی بعنوان یک روش دیگه استفاده کنن.
گفتیم تسک مدل کردن یک زبان اینکه تعدادی واژه در یک جمله داریم و وظیفه مدل اینکه واژه بعدی رو پیشبینی کنه. پس ورودی یه رشته کلمهست و خروجی یک توزیع احتمالاتی از کلمه بعدی.
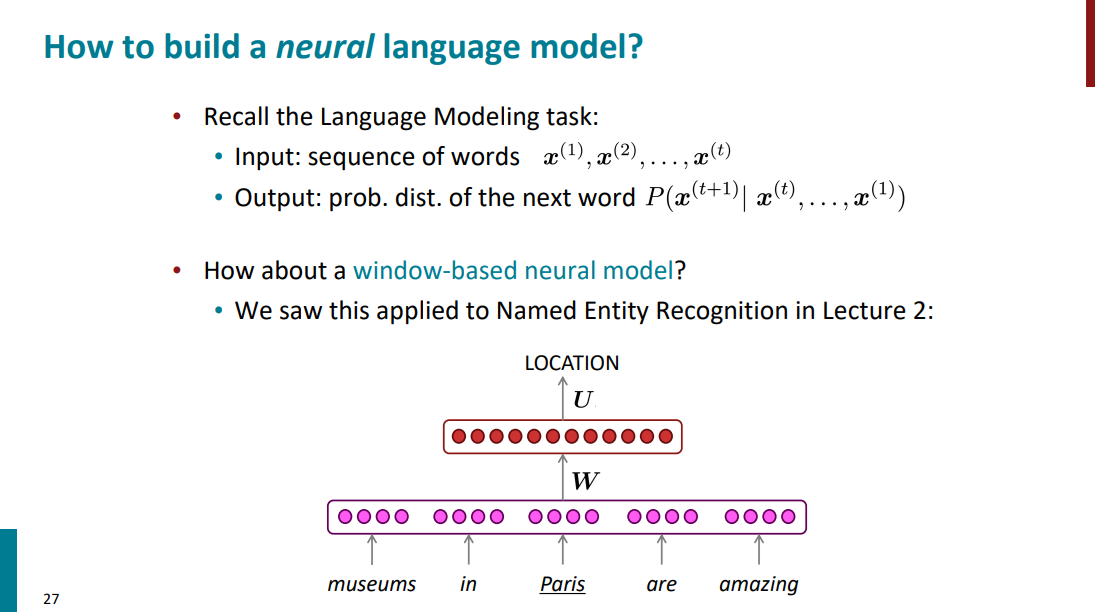
در جلسات قبلی با window based classifier ها آشنا شدیم و دیدیم که چطور کار میکنن. اگر بخوایم از همین دستهبند استفاده کنیم تا language modeling انجام بدیم چطور میشه؟
روش کار به این صورته که یک context ورودی داریم که شامل چند کلمهست. امبدینگهای این کلمه رو میدیم به یک شبکه عصبی خیلی ساده، بعد امدینگهارو باهم concat میکنیم و بعد یک کلمه رو بعنوان خروجی (دستهبند) پیشبینی میکنه برامون. (ماترس W امبدینگهای concat شده رو داره و مستطیل قرمز لایه hidden شبکه عصبیه.)
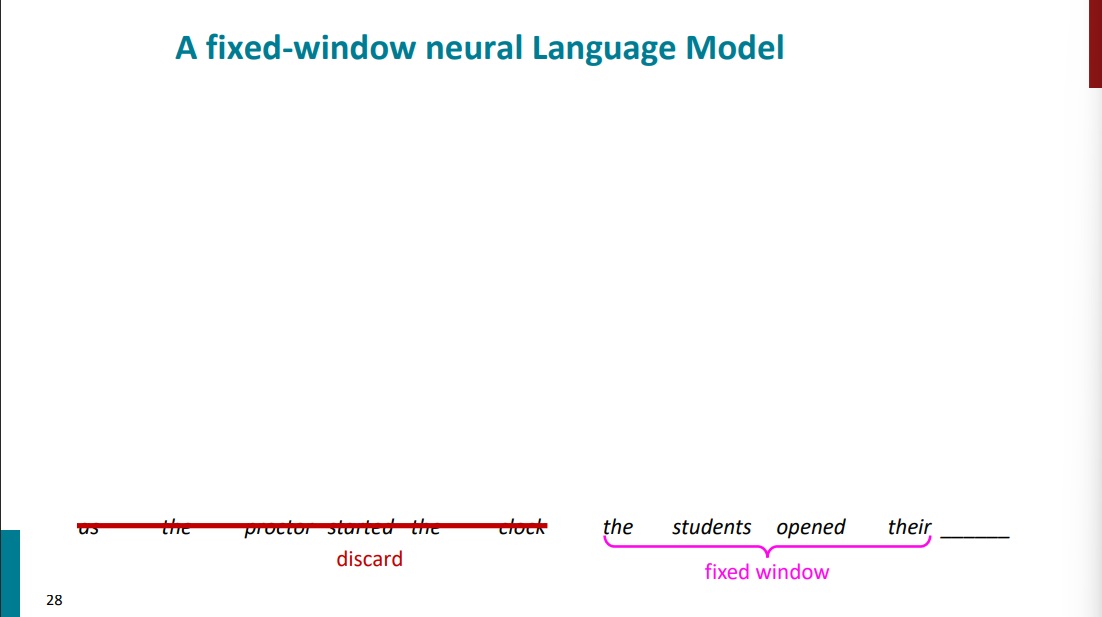
این کاری که تو اسلاید قبلی کردیم دقیقاً عین میمونه که بیایم جمله ورودی رو که داریم یک بازهای ازش رو بعنوان پنجره ورودی در نظر بگیریم و بقیه جمله رو discard کنیم بریزیم دور. تا اینجای کار دقیقاً شبیه کاریه که با مدلها n-gram میکردیم.
حالا ورودی رو میدیم به یک شبکه عصبی، و مراحل شبیه همون چیزیه همین الان یکم بالاتر دیدیم. فقط در نهایت به جای اینکه یه کلمه مثل LOCATION رو در خروجی داشته باشیم، اینطوره که یه softmax classifier داریم روی همه واژگانی که داریم (شبیه یک توزیع احتمالاتی روی همه واژگان) و بعد بر اساس این classifier کلمه بعدی انتخاب میشه که چی باشه.
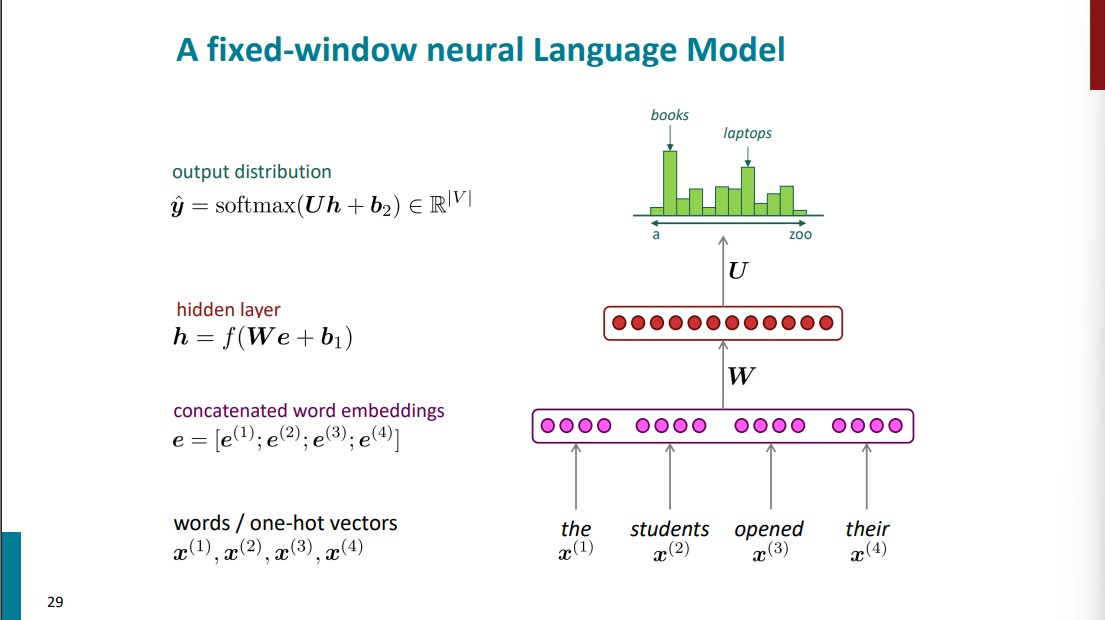
این روشی که دیدیم جزو اولین کارها در حوزه مدل کردن زبان به کمک شبکههای عصبی بوده هرچند از نظر شبکه عصبی بودن خیلی کار خفنی نیست اما باز هم کار ارزشمندی بوده. در مقایسه با مدلهای n-gram دیگه مشکل sparsity رو که قبلاً دیدیم نداره.
همچنین اگر یک واژه جدید در ورودی باشه که در واژگان وجود نداره، چون داره از امبدینگها استفاده میکنه میتونه بره واژه شبیه بهش رو پیدا کنه و بر اساس اون کار رو انجام بده، دقیقاً چیزی که مدلهای n-gram نمیتونستن انجامش بدن. مثلاً تو جمله the students opened their که اینجا ورودی بوده اگه به جای students واژه pupils رو داشتیم و pupils تو واژگانی که از قبل دیده وجود نداشت، خیلی راحت بخاطر نزدیک بودن امبدینگ students و pupils میتونست تشخیص بده که درسته pupils رو ندیدم ولی students رو دارم و شبیه همینه و کار رو با students ادامه بده.
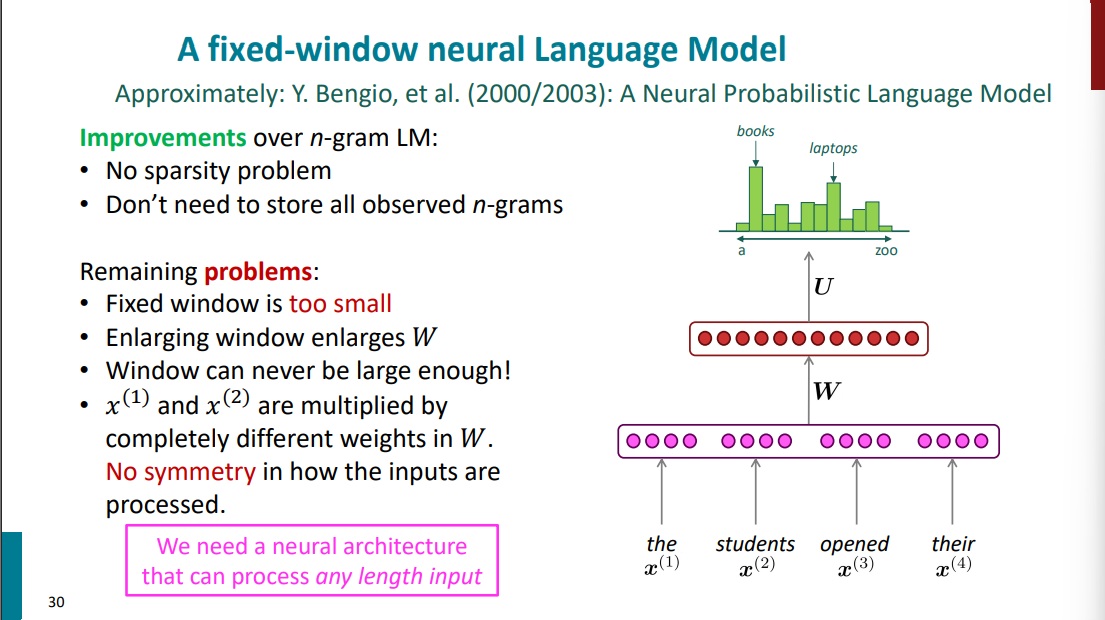
اما همچنان یک سری ایرادات داره که باعث میشه نیاز باشه مدلهای دیگهای از شبکههای عصبی بعدترها بوجود بیان. اولین مسئله سایز پنجرهست که معمولاً خیلی کوچیکه. میشه سایز پنجره ورودی رو بزرگتر کرد اما هرچقدر که بزرگتر بشه روی سایز ماتریس وزنها تاثیر میذاره و اون رو هم بزرگتر میکنه.
مشکل بعدیای که این مدل داره برمیگرده به جایگاه کلمات. هر پوزیشن وزن مخصوص به خودش رو داره. مثلاً کلمه اول ورودی با یک سری وزن پردازش میشه، کلمه دوم با یک سری وزن دیگه و همینطور الی آخر. این قضیه باعث میشه اگر یک کلمه یکسان، مثلاً students، جایگاهش در جمله تغییر کنه، با توجه به وزنهای متفاوت هر جایگاه، نمایشی که شبکه از اون کلمه میسازه هم تغییر کنه. در حالی که چیزی که ما میخوایم اینه که مدل بتونه دانشی که دربارهی هر کلمه یاد گرفته رو تا حد ممکن فارغ از جایگاهی که اون کلمه در ورودی داره استفاده کنه. چون خود کلمه تغییر نکرده و فقط جایگاهش عوض شده.
خلاصه که این مشکلات به خصوص مشکل ثابت بودن طول پنجره (چون تو این دست مدلها هرچقدر هم که طول پنجره رو بزرگتر کنیم باز کافی نیست) باعث شده که بریم سراغ ساختن مدلهای دیگه مثل RNNها یا LSTMها که در ادامه این کورس و در جلسات آینده مفصلاً باهاشون آشنا میشیم.
تو شبکه عصبی قبلی دیدیم که فقط یک لایه مخفی داشتیم (مستطیل قرمز) که وسط شبکه قرار گرفته بود. در شبکههای عصبی بازگشتی یا RNN هم این لایه مخفی رو داریم، با این تفاوت که در طول زمان، وضعیت لایه مخفی یا hidden state رو حفظ میکنیم و به گام زمانی بعد منتقل میکنیم. دلیل اینکه به این مدل شبکهها بازگشتی میگیم هم همینه؛ چون اطلاعاتی که از گام قبلی به دست آوردیم، دوباره در محاسبات گام بعدی استفاده میشه.
حالا پروسه کار اینطوریه که بر اساس کلمه اول و hidden state اول، یک hidden state جدید محاسبه میکنیم. بعد این hidden state رو همراه با کلمه دوم وارد محاسبات میکنیم و hidden state جدیدی به دست میاریم. همین پروسه رو برای کلمههای بعدی تکرار میکنیم تا در نهایت به آخرین کلمه برسیم و بتونیم کلمه مورد نظرمون رو پیشبینی کنیم.
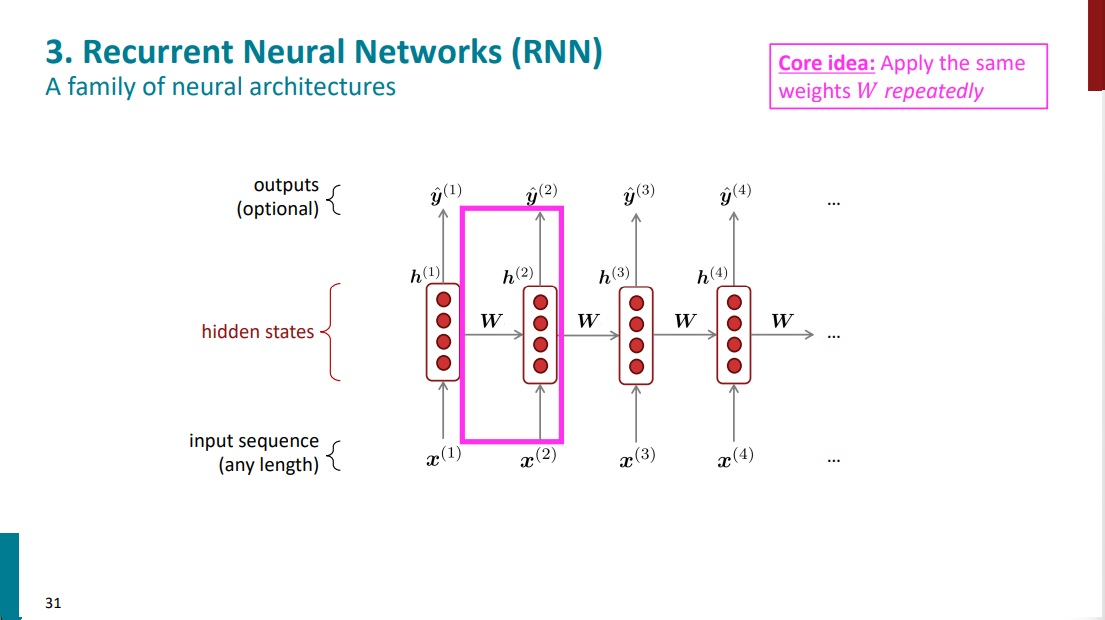
با این مدل معماری، اطلاعات از اولین کلمه جمله تا لحظه فعلی، بهصورت فشرده در قالب hidden stateها منتقل میشه. بنابراین RNN میتونه هنگام پردازش یک کلمه، از اطلاعاتی که از کلمههای قبلی به دست آورده هم استفاده کنه و دیگه مشکل window داشتن رو تا حدی حل کرده و ورودی میتونه تا حد خوبی طولانیتر باشه.
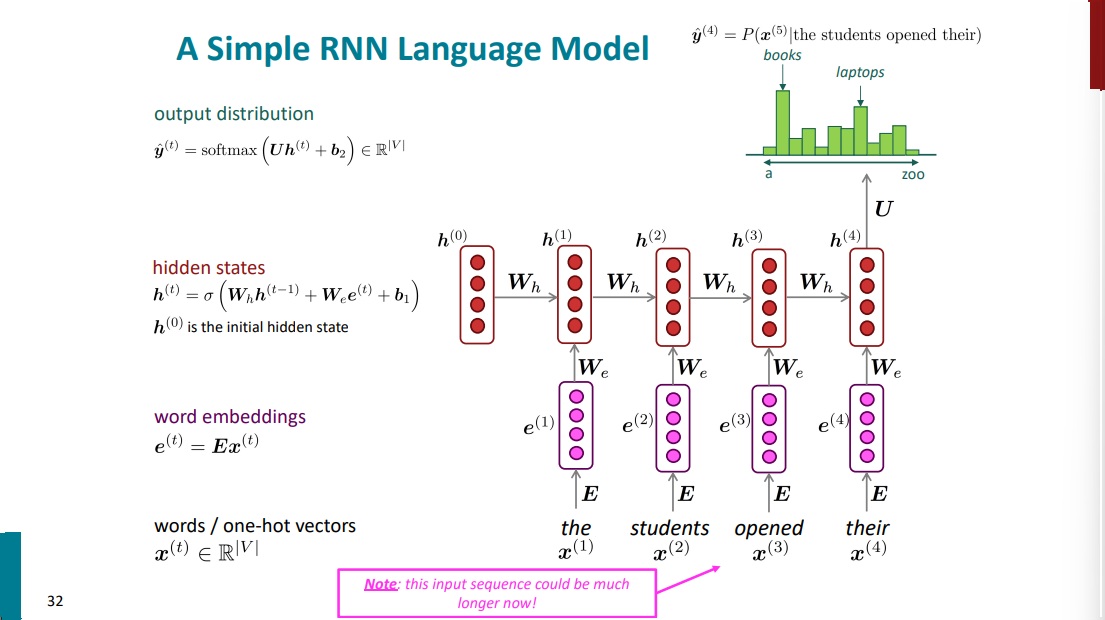
اگه یه دور دیگه بخوایم روند کار رو توضیح بدیم به این صورته که اول امبدینگهای مربوط به هر کلمه رو به دست میاریم. بعد قراره لایههای مخفی یا hidden stateها رو محاسبه کنیم.
اولین hidden state رو میتونیم با مقدار صفر مقداردهی اولیه کنیم. پس h(0) یک برداره که داره لایه مخفی اولیه رو نشون میده و با 0 مقداردهی شده.
قراره بیایم لایه مخفی بعدی (یعنی h(1)) رو محاسبه کنیم. برای این کار، تو گام بعدی میایم بردار امبدینگ کلمه اول رو (که از قبل داریم) در ماتریس وزن We (که وزن مربوط به امبدینگها هست) ضرب میکنیم. با این کار داریم اطلاعات مربوط به کلمه اول رو وارد لایه بازگشتی میکنیم.
بعد، باید بیایم لایه مخفی قبلی (تو این مرحله h(0)) رو هم وارد محاسبات کنیم. چرا؟ چون گفتیم شبکه عصبی RNN باید بتونه اطلاعات گذشته رو هم در خودش نگه داره. لایههای مخفی هم وزن مربوط به خودشون رو دارن که درش ضرب میشه و با Wh نشون داده شده. پس برای محاسبه لایه مخفی h(1) در نهایت داریم:
h(1) = σ(Wh h(0) + We e(1) + bh)
پس برای محاسبه لایه مخفیِ اول باید بیایم از لایه مخفیِ استیت قبلی و امبدینگ لایه اول و یک بایاس که مربوط به لایه مخفیه استفاده کنیم. برای درک بهتر هرچیزی که تو فرمول بالا اومده رو مجدد لیست میکنم:
h(1) -> لایه مخفی اول که قراره حساب کنیم
Wh -> وزن مربوط به لایههای مخفی که یک ماتریسه
h(0) -> لایه مخفی مرحله قبلی (اینجا مرحله صفر) که یک برداره با مقدار اولیه صفر
We -> وزن مربوط به امبدینگ کلمات ورودی که یک ماتریسه
e(1) -> امبدینگ کلمه اول که یک برداره
bh - > بایاس مربوط به لایههای مخفی که یک برداره
σ -> تابع غیر خطی سیگموید (قبلتر بررسی کردیم چرا در یک شبکه عصبی به توابع غیر خطی نیاز داریم)
به همین منوال در هر مرحله محاسبات انجام میشه و در نهایت از hidden stateای که در مرحله آخر حساب کردیم استفاده میکنیم و به کمک softmax یک توزیع احتمالاتی برای هر کلمه در واژگان رو به دست بیاریم و بعد کلمهی خروجی رو بر اساس احتمالی که براش محاسبه شده انتخاب کنیم.
شبکههای عصبی بازگشتی هم یک سری مزایا و معایب دارن که در ادامه بررسیشون میکنیم.
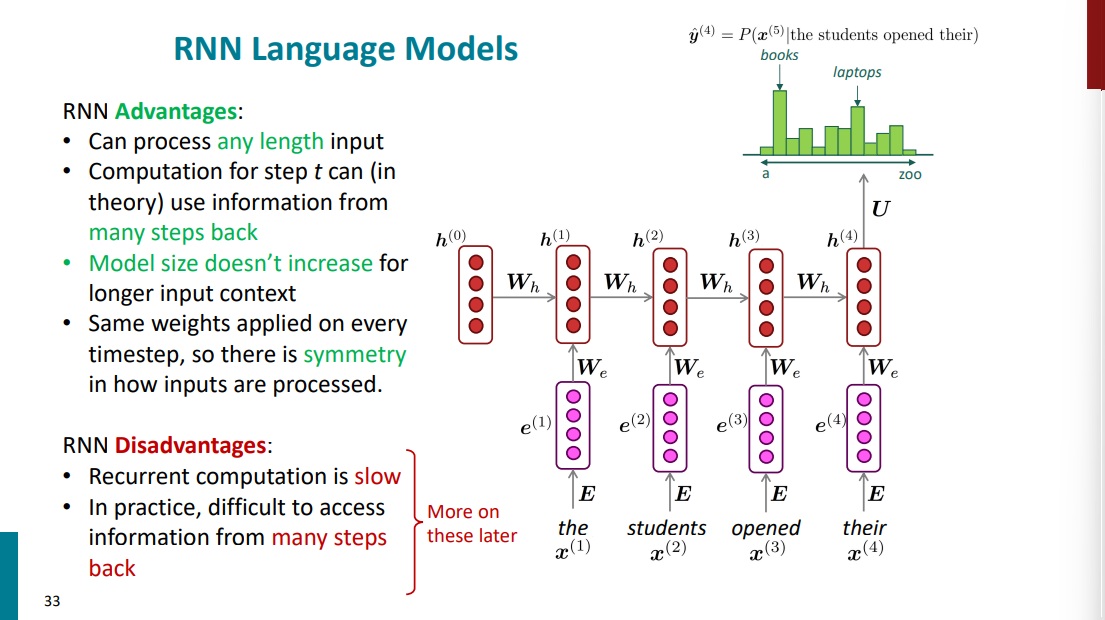
از مزایاشون میشه به این اشاره کرد که ورودی با هر تعداد کلمه رو میتونن هندل کنن و سایز مدل ثابت میمونه و با افزایش طول ورودی بزرگتر نمیشه. مورد بعدی اینکه مشکل جایگاه کلمات رو که شبکه عصبی قبلی داشت اینجا دیگه نداریم. یک کلمه یکسان در جایگاههای مختلف در جمله وزنهای مختلف نمیگیره. به عبارتی دیگه symmetry یا تقارن در نحوه پردازش ورودیها وجود داره.
یکی از معایب RNNها سرعت پردازششونه که نسبتاً کنده و همین مشکل ایجاد میکنه. مورد بعدی هم بر میگرده به بازیابی اطلاعات مربوط به لایههای قدیمیتر و این کار براش خیلی سخته. مثلاً اگر ورودی تعداد خیلی زیاد کلمه داشته باشه و در مرحله آخر نیاز باشه که هنوز اطلاعاتی از کلمه اول داشته باشیم این کار رو نمیتونه به خوبی انجام بده و انتقال اطلاعات از ابتدای توالی تا انتها برای RNN به شدت دشواره.
فرض کنید ورودی چنین جملهای باشه:
مهسا چند روز پیش به بازار رفت تا برای تولد دوستش کادو بگیرد و [یک عالمه اتفاقات دیگه این وسط افتاده و مهسا در مسیر تصادف کرده]. این تصادف باعث شد تا از ... رفتنش پیشمان شود.
حالا اگر تسک این باشه که جای خالی آخر رو پر کنیم، برای درست انجام دادن این کار، نیازه که مدل همچنان در مورد کلمه بازار که اول کار دیده بود اطلاعات داشته باشه. این اطلاعات رو RNN از طریق لایههای مخفی از هر لایه به لایه بعدی منتقل میکنه. هرچقدر فاصله بین لایههای مخفی بیشتر بشه، حفظ و استفاده از اطلاعات اولیه سختتر میشه و ممکنه اطلاعات مهم مربوط به ابتدای جمله در لایه مخفی آخر بهخوبی باقی نمونده باشه.
همین مسئله در خصوص RNNها باعث شده که معماریها و مدلهای دیگهای مثل LSTM بوجود بیان تا بتونن اطلاعات مهم رو برای مدت طولانیتری حفظ کنن که در جلسات آینده مفصل بهشون خواهیم پرداخت.
بحث پارسرها رو تکمیل کردیم و خیلی کلی با مقدمات شبکههای عصبی آشنا شدیم. دیدیم که مدلهای زبانی چی هستن و در ابتدای کار مدلهای زبانی کلاسیک چطور بودن و چه مشکلاتی داشتن و در نهایت مقدمهای از RNNها یا شبکههای عصبی بازگشتی رو مورد بررسی قرار دادیم. جلسه بعدی RNNها رو تکمیل میکنیم و با LSTMها هم آشنا میشیم.
اگر جایی ایراد یا مشکلی بود، حتماً بهم بگید تا تصحیح کنم. اگر هم پست رو دوست داشتید و محتواش به دردتون خورد، میتونید یه قهوه مهمونم کنید!
جزوه جلسه بعدی (جلسه ششم) - به زودی

