
منبع اصلی این پست، دوره آمار و احتمال مهندسی دکتر علی شریفی زارچی از آکادمی مکتبخونه میباشد. لطفاً برای حفظ حقوق منتشر کننده اصلی، ویدیوهارو از منبع اصلی دنبال کنید. همچنین، در انتهای هر جلسه، به ویدیو مربوط به آن جلسه ارجاع داده شده است.
سعی کردم هرچیزی که از ویدیوها فهمیدم رو به صورت متن در بیارم و در این پلتفورم با بقیه به اشتراک بذارم. کل ویدیوها 27 تاست که سعی میکنم هفتهای یک الی دو جلسه رو منتشر کنم. تا جایی که تونستم سعی کردم خوب و کامل بنویسم، اما اگر جایی ایرادی داشت، حتما تو کامنتها بهم بگید تا درستش کنم.
پیشنهاد میکنم قبل از خوندن ادامه مطلب، یک کاغذ و قلم جلو دستتون باشه تا بتونید روابط ارائه شده رو در جاهایی که لازم هست برای خودتون تو کاغذ بنویسید و محاسبات لازم رو خودتون هم انجام بدین تا بهتر متوجه بشید که در هر مرحله چه اتفاقی میفته.
تا به این جلسه با توزیعهای مختلفی آشنا شدیم. دو توزیع دیگر با عنوان توزیع بتا و توزیع گاما نیز وجود دارند که فعلا مورد بررسی قرار نگرفتهاند و در آینده با آنها آشنا خواهیم شد. در ادامه قراره با ذکر چند مثال شهود اعداد تولید شده از توزیعهایی که تا به اینجا خوندیم رو بررسی کنیم.
فرض کنید 1000 تا عدد داریم که میدونیم با سایز 10 و p=0.25 از توزیع دو جملهای اومدن. هر کدوم از این عددها چه چیزی رو بهمون نشون میدن؟ این رو نشون میدن که انگار هر دفعه یک سکهای رو 10 بار انداختیم و احتمال رو اومدن سکه 0.25 بوده و شمردیم که از این 10 دفعه چند بار سکه رو اومده.
حالا، فرض کنید 1000 تا عدد داریم که از توزیع پوآسون تولید شدن و لامبدا هم براش 12 در نظر گرفته شده:
13, 10, 14, 12, 9, ...
هر کدوم از این عددا چیو بهمون نشون میدن و چه شهودی دارن؟
وقتی میگیم لامبدا 12 در نظر گرفته شده، مثل این میمونه که انگار یه خیابون داشته باشیم که به طور متوسط در هر دقیقه 12 تا ماشین ازش رد بشه. حالا تو هر یک دقیقه اومدیم تعداد ماشینهایی که رد میشن رو شمردیم. تو اولین یک دقیقه 13 تا ماشین رد شده، تو دومین یک دقیقه 10 تا ماشین رد شده، تو سومین یک دقیقه 14 تا ماشین رد شده و ...
حالا اگر 1000 تا عدد داشته باشیم که از توزیع نمایی با نرخ 1/3 بیان، چه چیزی رو بهمون نشون میدن؟ مثلاً چند تا نمونه از اعدادی که داریم به این صورت باشه:
0.23, 0.11, 1.04, 2.88, ...
انگار که یک خیابون داریم و هر سه دقیقه یک بار یک ماشین ازش رد میشه (چون نرخ 1/3 هست). حالا، هر دفعه تایمر رو استارت میزنیم و نگاه میکنیم که هر ماشین تو چه زمانی میاد (به عبارتی دیگه، چند دقیقه طول میکشه تا یک ماشین از خیابون رد بشه). عدد 0.23 داره میگه دفعه اولی که تایمر رو استارت زدیم 0.23 دقیقه طول کشید تا یک ماشین رد بشه. 0.11 داره میگه دفعه دومی که تایمر رو استارت زدیم 0.11 دقیقه طول کشید تا یک ماشین رد بشه و ...
حالا اگر بیایم متوسط 1000 تا عدد تولید شده رو حساب کنیم انتظار داریم که به چه عددی برسیم؟ عدد 3. چون هر سه دقیقه یک بار یک ماشین رد میشه.
اگر علاقهمند هستین که نمودار توزیعهای مختلف رو با اعداد دلخواه ببینید و شهود عمیقتری به دست بیارید، سایت Seeing Theory رو چک کنید.
دو متغیر تصادفی قد و وزن رو در خصوص انسانها در نظر بگیرید. میدونیم که هر دو متغیر تصادفی به صورت جدا از یک توزیع نرمال تبعیت میکنن. حالا اگه بیایم و این دو توزیع رو باهم ادغام بکنیم توزیعشون به چه صورت میشه؟ در ادامه قراره این موضوع رو در قالب مثالهای مختلف بررسی کنیم.
فرض کنید از بین خانوادههایی که هیچ فرزند، یک پسر یا یک دختر، دو پسر یا دو دختر دارند اومدیم نمونه گیری کردیم و جدول زیر خروجی کارمون شده:
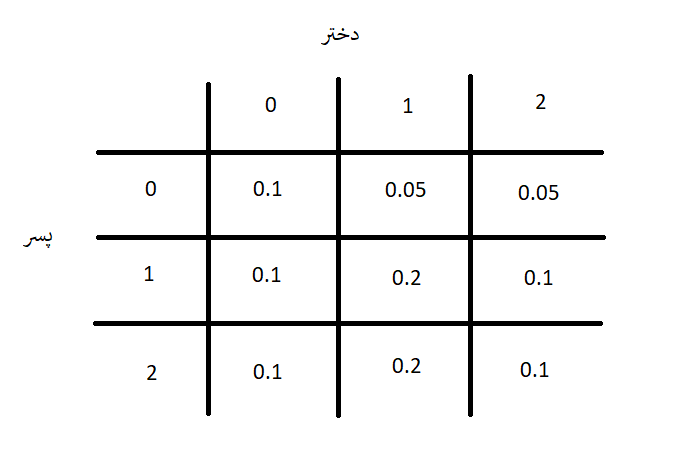
طبق جدول بالا، مثلاً خانوادههایی که هیچ فرزندی نداشتن 10 درصد نمونههارو تشکیل دادن.
اعدادی که تو جدول اومدن یک توزیع توأم (joint) رو نشون میدن. حالا، اگر بیایم متغیر تصادفی تعداد دختر رو با X و متغیر تصادفی تعداد پسر رو با Y نشون بدیم، میشه توزیع توأم اونهارو به صورت زیر نمایش داد:
P_XY(x, y) = P(X=x, Y=y)

P_XY(0, 0) = 0.1
P_XY(2, 2) = 0.1
P_XY(1, 1) = 0.2
همچنین داریم:
F_XY(x, y) = P(X ⩽ x, Y ⩽ y)

F_XY(2, 1) = 0.6
اگر براتون سوال شده که چجوری به عدد 0.6 رسیدیم، جدول زیر رو ببینید:
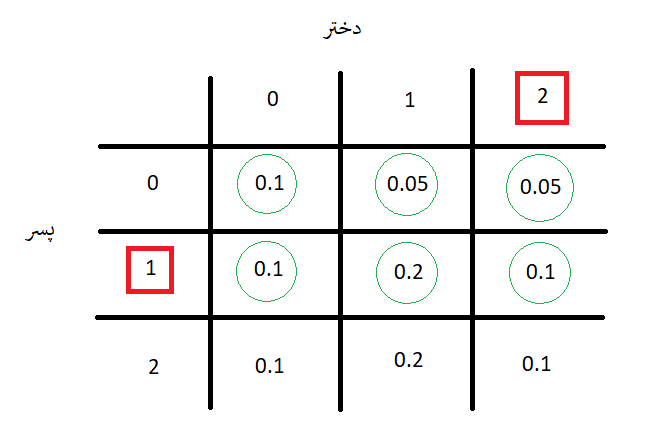
عبارت F_XY(2, 1) داره میگه X هایی رو میخوام که کوچیکتر مساوی 2 باشن و Y هایی رو میخوام که کوچیکتر مساوی 1 باشن. در نهایت جمع خونههایی که با دایره سبز مشخص شدن مارو به عدد 0.6 میرسونه.
حالا یه سوال. تو مثالی که دیدیم، آیا دو متغیر تصادفی X و Y از هم مستقل هستن یا بهم وابستهن؟
تعریف مستقل بودن دو متغیر تصادفی چی بود؟
P(X=x | Y=y) = P(X = x)
رابطه مستقل بودن دو متغیر تصادفی به ما این رو میگفت که با قائل شدن یک مقدار برای Y، مقدار Y هیچ تاثیری تو مقدار X نذاره. مثلاً دختر داشتن یک خانواده هیچ تاثیری در پسردار شدن اون خانواده نداشته باشه. چیزی که تو مثال ما صدق نمیکنه و باعث میشه X و Y در این مثال نسبت بهم وابستگی داشته باشن. چطور اینو میگیم؟ با یه مثال نشون میدیم.
اگه بهمون بگن یه خانوادهای دو تا دختر داره، چقدر احتمال داره که هیچ فرزند پسری نداشته باشه؟ داریم:
P(Y=0 | X=2) = 0.05 / (0.05 + 0.1 + 0.1) = 0.2
به همین ترتیب، اگر بهمون بگن یه خانوادهای یک دختر داره، چقدر احتمال داره که هیچ فرزند پسری نداشته باشه؟ داریم:
P(Y=0 | X=1) = 0.05 / (0.05 + 0.2 + 0.2) = 1/9
در جدول زیر چگونگی انجام محاسبات مشخص شده:
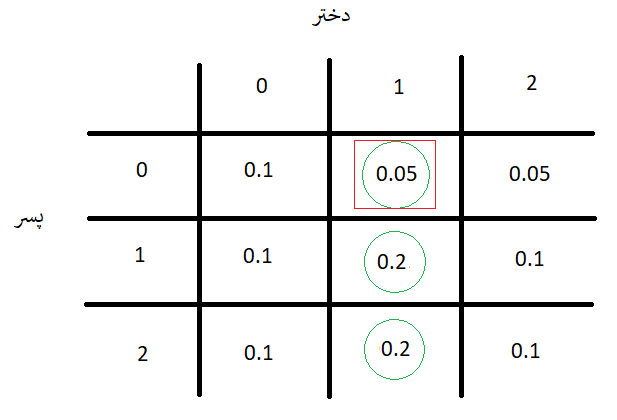
با محاسبات و مثالهای بالا نشون دادیم که احتمال اینکه یک خانوادهای هیچ فرزند پسری نداشته باشه، بسته به اینکه چه تعداد فرزند دختر داره، تغییر میکنه. تو یک حالت به عدد 0.2 رسیدیم و تو حالت دیگه به عدد 1/9.
یک روش دیگه برای چک کردن اینکه آیا دو متغیر تصادفی X و Y نسبت بهم مستقل هستن یا نه وجود داره. در ادامه به توضیح این روش خواهیم پرداخت.
فرض کنید PMF توأم زیر رو بهمون دادن:
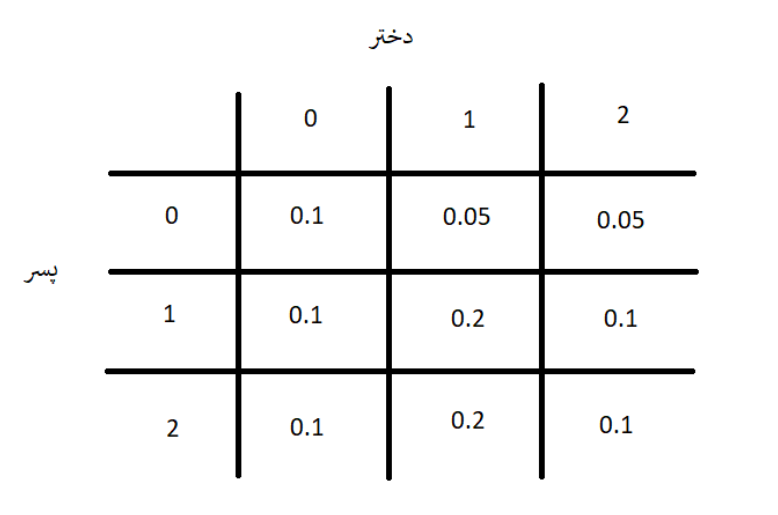
قراره این رو بررسی کنیم که آیا دو متغیر تصادفی X (تعداد فرزند دختر) و Y (تعداد فرزند پسر) از هم مستقل هستن یا نه. قراره به کمک به دست آوردن توزیع marginal به این سوال پاسخ بدیم.
در مرحله اول قراره احتمال X=0 و X=1 و X=2 رو محاسبه کنیم. طبق قانون احتمال کل که در جلسات گذشته باهاش آشنا شدیم، میدونیم که برای محاسبه احتمال X=0 داریم:
P(X=0) = P(X=0, Y=0) + P(X=0, Y=1) + P(X=0, Y=2)
پس برای محاسبه P(X=0) کافیه بیایم ستونی که تعداد دختر برابر با 0 داره رو جمع بزنیم:
P(X=0) = P(X=0, Y=0) + P(X=0, Y=1) + P(X=0, Y=2) = 0.1 + 0.1 + 0.1 = 0.3
به همین ترتیب برای محاسبه احتمال P(X=1) و P(X=2) داریم:
P(X=1) = P(X=1, Y=0) + P(X=1, Y=1) + P(X=1, Y=2) = 0.05 + 0.2 + 0.2 = 0.45
P(X=2) = P(X=2, Y=0) + P(X=2, Y=1) + P(X=2, Y=2) = 0.05 + 0.1 + 0.1 = 0.25
در گام بعدی میریم سراغ محاسبه احتمال Y=0 و Y=1 و Y=2 به همین ترتیبی که برای X انجام شد، با این تفاوت که به جای جمع زدن ستونها، سطری عملیات جمع رو انجام میدیم:
P(Y=0) = P(Y=0, X=0) + P(Y=0, X=1) + P(Y=0, X=2) = 0.1 + 0.05 + 0.05 = 0.2
P(Y=1) = P(Y=1, X=0) + P(Y=1, X=1) + P(Y=1, X=2) = 0.1 + 0.2 + 0.1 = 0.4
P(Y=2) = P(Y=2, X=0) + P(Y=2, X=1) + P(Y=2, X=2) = 0.1 + 0.2 + 0.1 = 0.4
به شش تا عددی که تا اینجا محاسبه شدن و به دست اومدن احتمال marginal یا حاشیهای گفته میشه.
حالا، داریم:
∀_(xi, yj) P_XY(xi, yj) = P_X(xi) P_Y(yj)
عبارت بالا رو اینطور بخونید:
به ازای هر xi و yj تابع PMF توأم X و Y برابر هست با حاصل ضرب PMF حاشیهای روی X و PMD حاشیهای روی Y.
حالا، اگر عبارت بالا به ازای هر x و y برابر باشه، میتونیم بگیم که دو متغیر تصادفی X و Y نسبت بهم مستقل هستن.
مثلا به ازای i=0 و j=1 داریم:
P_XY(X=0, Y=1) = 0.1
P_X(X=0) P_Y(Y=1) = 0.3 * 0.4 = 0.12
از اونجایی که دو مقدار محاسبه شده باهم برابر نیستن، پس X و Y بهم وابستهن.
حالا، اگر بخوایم X و Y تو همین مثالی که دیدیم از هم مستقل باشن چجوری میتونیم اعداد جدول رو تغییر بدیم؟
کافیه به ازای هر سلول احتمال حاشیهای اون سطر و ستون رو در هم ضرب کنیم. مثلاً سلولی که X=0 و Y=0 داره، مقدارش برابر میشه با:
P(X=0) * P(Y=0) = 0.3 * 0.2 = 0.06
در نهایت مقادیر به صورت جدول زیر در میاد:
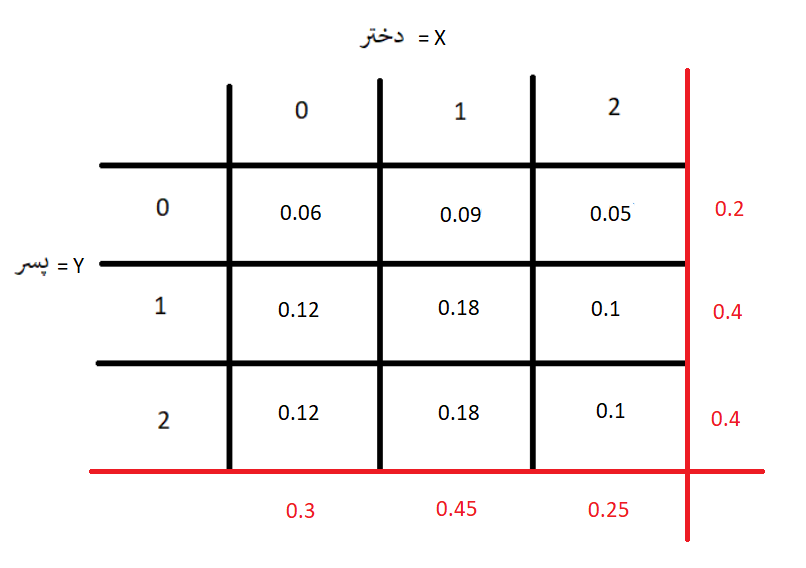
طبق مقادیر جدول بالا، الان میشه گفت که X و Y از هم مستقل هستن. مثلاً اگر بخوایم احتمالات زیر رو محاسبه کنیم داریم:
P(X = 0 | Y = 0) = 0.06 / 0.2 = 0.3
P(X = 1 | Y = 0) = 0.09 / 0.2 = 0.45
P(X = 2 | Y = 0) = 0.05 / 0.2 = 0.25
نمودار زیر تابع چگالی احتمال توزیع توأم پیوسته X و Y رو داره نشون میده:
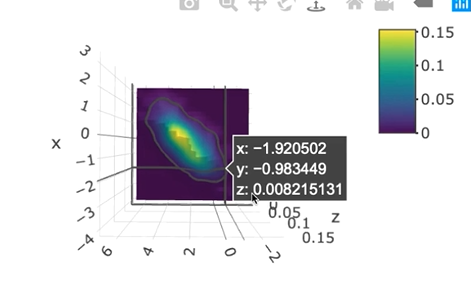
یعنی دو متغیر تصادفی X و Y ورودی هستن و z هم خروجی:
f_XY(x, y)
طبق تعاریفی که از قبل خونده بودیم، برای CDF داریم:
P(X ⩽ x, Y ⩽ y) = F_XY(x, y)
حالا در توزیع توأم چه شرایطی باید برای CDF وجود داشته باشه؟
F_XY(-∞, -∞) = 0
F_XY(+∞, +∞) = 1
یه شرط دیگه هم اینکه کل حجم زیر نمودار CDF برابر با 1 بشه.
نموداری که بالاتر آورده شده در واقع داره PDF رو نشون میده. اگه قرار بود CDF اون رو رسم کنیم به چه صورتی میشد؟ یک صفحه رو در نظر بگیرید که انگار از 0 شروع شده و در نهایت به 1 میرسه:
حالا چه ارتباطی بین f_XY و F_XY وجود داره؟ در توزیعهای تک متغیره مشتق F_X بهمون f_X رو میداد. حالا میخوایم این رو بررسی کنیم که چطور میشه از روی F_XY مقدار f_XY رو به دست آورد.
برای به دست آوردن f_XY از روی F_XY داریم:
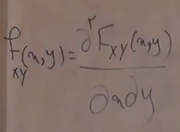
رابطه بالا داره چی میگه؟ با یه مثال توضیح میدیم. فرض کنید داریم:
F_XY(x, y) = X^3 + y cos(x)
مشتق F نسبت به x میشه:
= 3X^2 - y sin(x)
حالا اگر بیایم از عبارتی که بالا به دست اومده نسبت به y مشتق بگیریم خواهیم داشت:
= - sin(x)
برای به دست آوردن f_XY از روی F_XY باید همین مراحلو طی کرد و دوبار مشتق گرفت.
برای به دست آوردن F_XY از روی f_XY هم داریم:
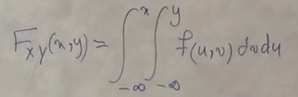
حالا، یک سوال. فرض کنید بهمون تابع f_XY(x, y) رو دادن و میخوایم ببینیم که دو متغیر تصادفی X و Y نسبت بهم وابسته هستن یا مستقلاند. چجوری بفهمیم؟
یکم بالاتر تو متغیر تصادفی گسسته دیدیم که چطور احتمال حاشیهای حساب کردیم و در نهایت به کمک اون تونستیم مستقل بودن یا وابسته بودن دو متغیر تصادفی رو نسبت بهم بسنجیم. تو متغیر تصادفی پیوسته هم میتونیم کار مشابهی رو انجام بدیم.
در قدم اول میتونیم مقدار زیر رو محاسبه کنیم؛ عبارت زیر چی داره میگه؟ داره میگه بیا Y رو تغییر بده، انتگرال بگیر. در واقع همون تابع حاشیهای روی X رو بهمون میده:
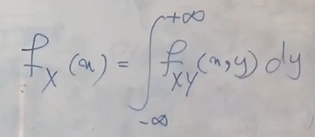
به صورت مشابه مقدار زیر رو هم میشه محاسبه کرد؛ یعنی X رو تغییر بدیم و انتگرال بگیریم. در واقع همون تابع حاشیهای روی Y رو بهمون میده:
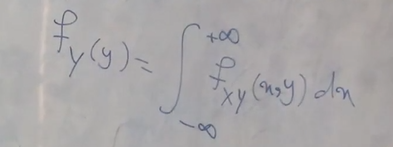
بعنوان مثال، نمودار زیر رو در نظر بگیرید:
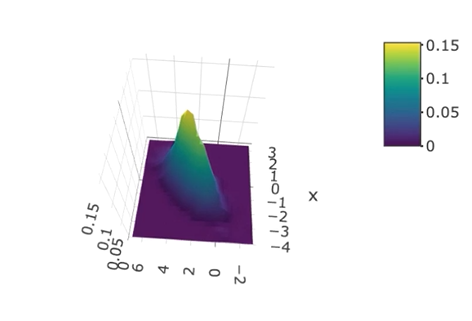
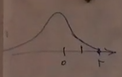
دنبال این هستیم که تابع حاشیهای X رو محاسبه کنیم. هر دفعه مقدار X رو برابر با یک عددی در نظر میگیریم و بعد مقدار Y رو به ازای اون مقادیر X حساب میکنیم. مثلاً به ازای X = 2، سطح زیر نمودار 0 میشه و به ازای X = 0، سطح زیر نمودار به مقدار اوج میرسه. فرض کنید تابع حاشیهای مثال بالا برای X در نهایت، به صورت زیر در میاد:
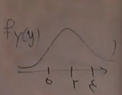
حالا، میخوایم تابع حاشیهای Y رو محاسبه کنیم. طبق نمودار داده شده در نقطه Y=2 سطح زیر نمودار به مقدار اوج میرسه و در مقادیر دیگه کم و کمتر میشه تا اینکه در نهایت به صفر میرسه. پس اگر تابعشو حساب کنیم در نهایت داریم:
حالا، در چه صورتی f_X(x) و f_Y(y) از هم دیگه مستقل هستن؟ در صورتی که رابطه زیر برقرار باشه:
∀_(x, y) f_XY(x, y) = f_X(x) f_Y(y)
رابطه بالا رو به این صورت بخونید: به ازای هر x و y (که متعلق به R هستن)، f_XY(x, y) برابر بشه با حاصل ضرب تابع حاشیهای X در تابع حاشیهای Y.
حالا، برگردیم به همین مثالی که نمودارش رو دیدیم. اگر X و Y از هم مستقل بودن نمودار مثالمون چه شکلی باید میداشت؟ شبیه یک دایره یا بیضی میشد. نمودار زیر رو ببینید:
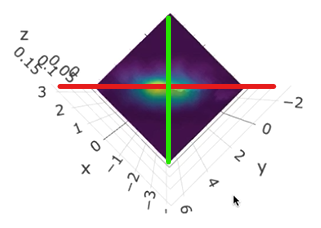
اگر نموداری که داشتیم محور Xش خط قرمز و محور Yش خط سبز میبود، اون موقع مقادیر طوری بودن که X وY از هم مستقل بودن. منظور از اینکه شبیه دایره یا بیضی میشد شکل بالاست.
در ادامه مثالهای بیشتری از توزیعهای توأم پیوسته از هم رو خواهیم دید.
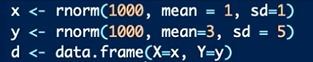
فرض کنید X و Y از هم مستقل هستن و هر دو از یک توزیع نرمال با پارامترهای زیر میان:
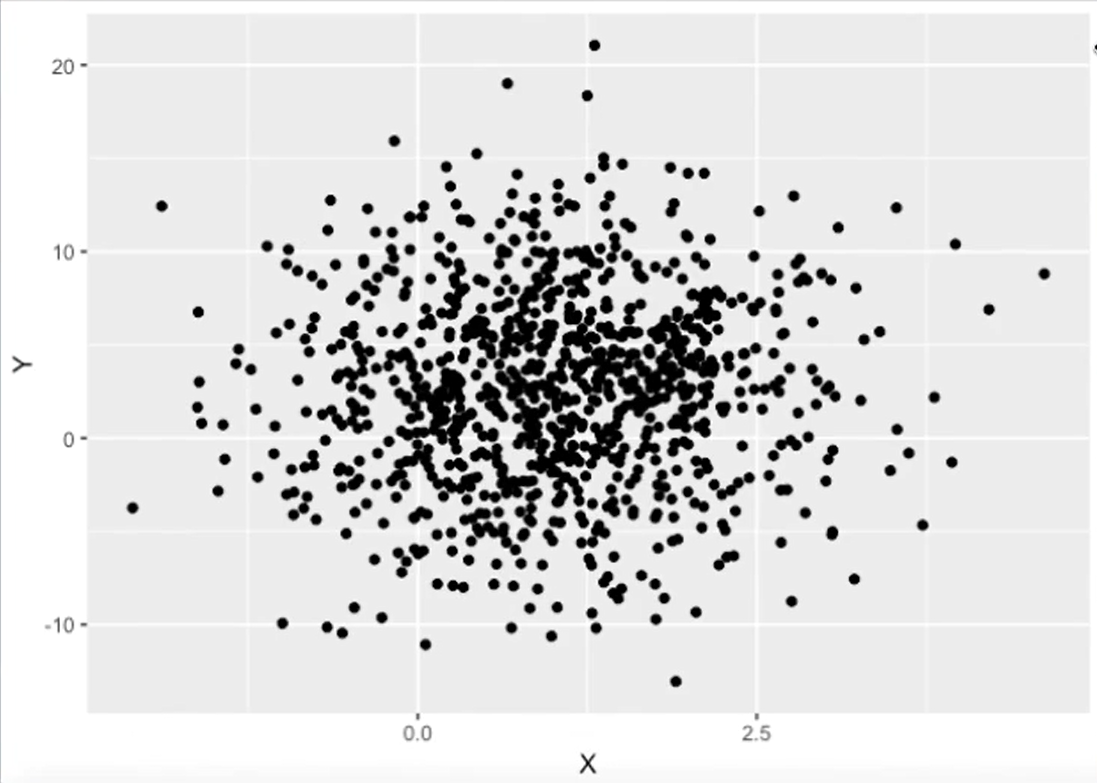
اگر نمودار توزیع توأمشون رو رسم کنیم داریم:
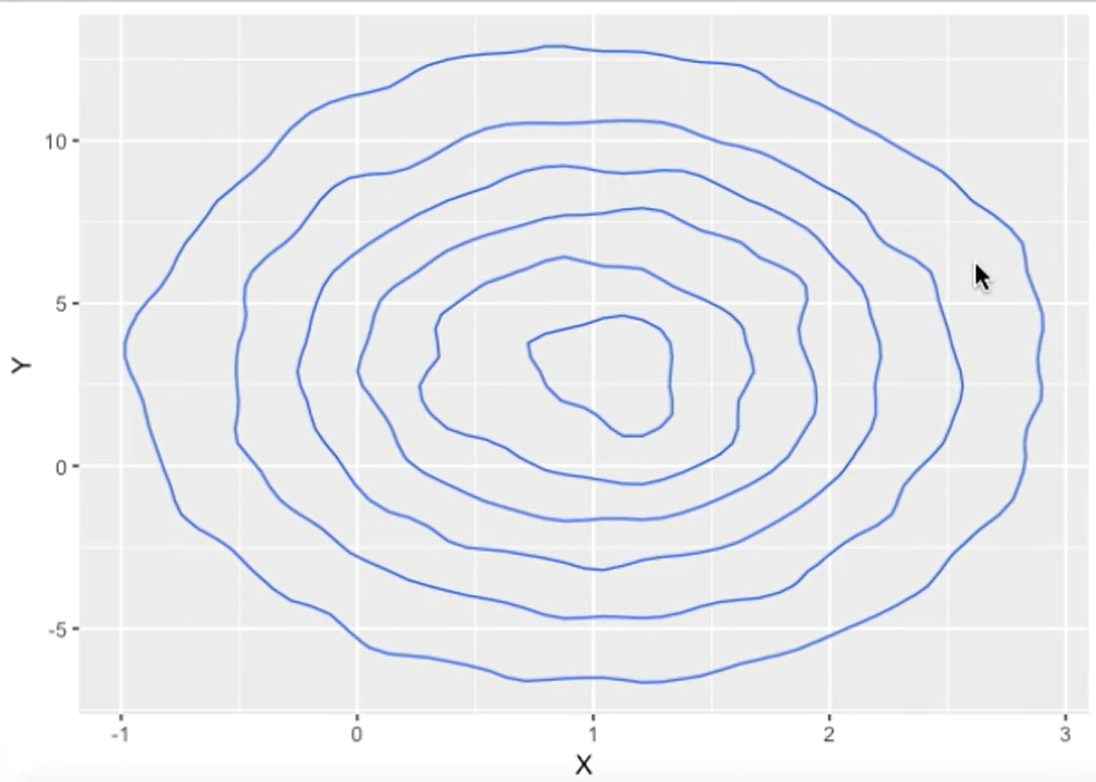
به صورت دیگهای هم میشه نشون داد خروجی رو:
حالا، اگر X و Y بهم وابسته باشن، نمودارشون به صورت زیر میشه:
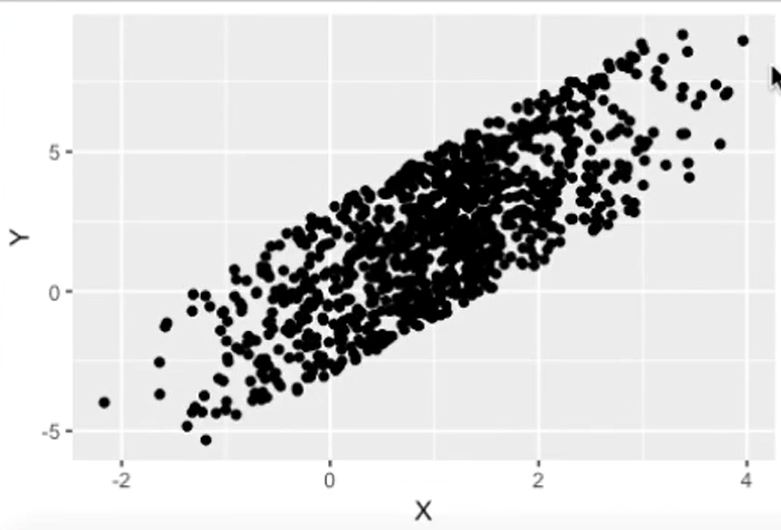
تو مثال بالا X از یک توزیع نرمال میاد و Y نسبت به X وابستگی داره و مقدارش برابر هست با:
Y = 2X + noise
منظور از noise یک عدد رندومه که از توزیع یکنواخت میاد.
حالا اگر noise رو جوری تغییر بدیم که یک عدد رندوم از توزیع نرمال باشه، نمودار توزیع توأم X و Y به صورت زیر میشه:
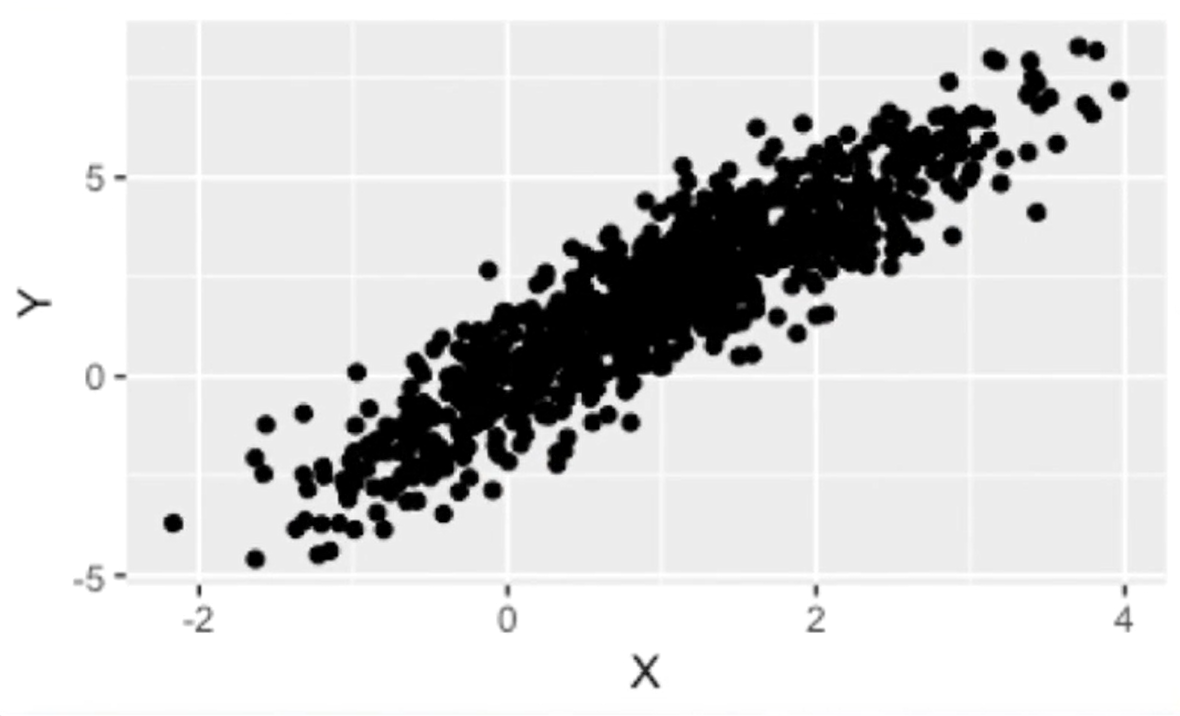
همین نمودار بالا رو میشه به صورت دیگهای هم نمایش داد:
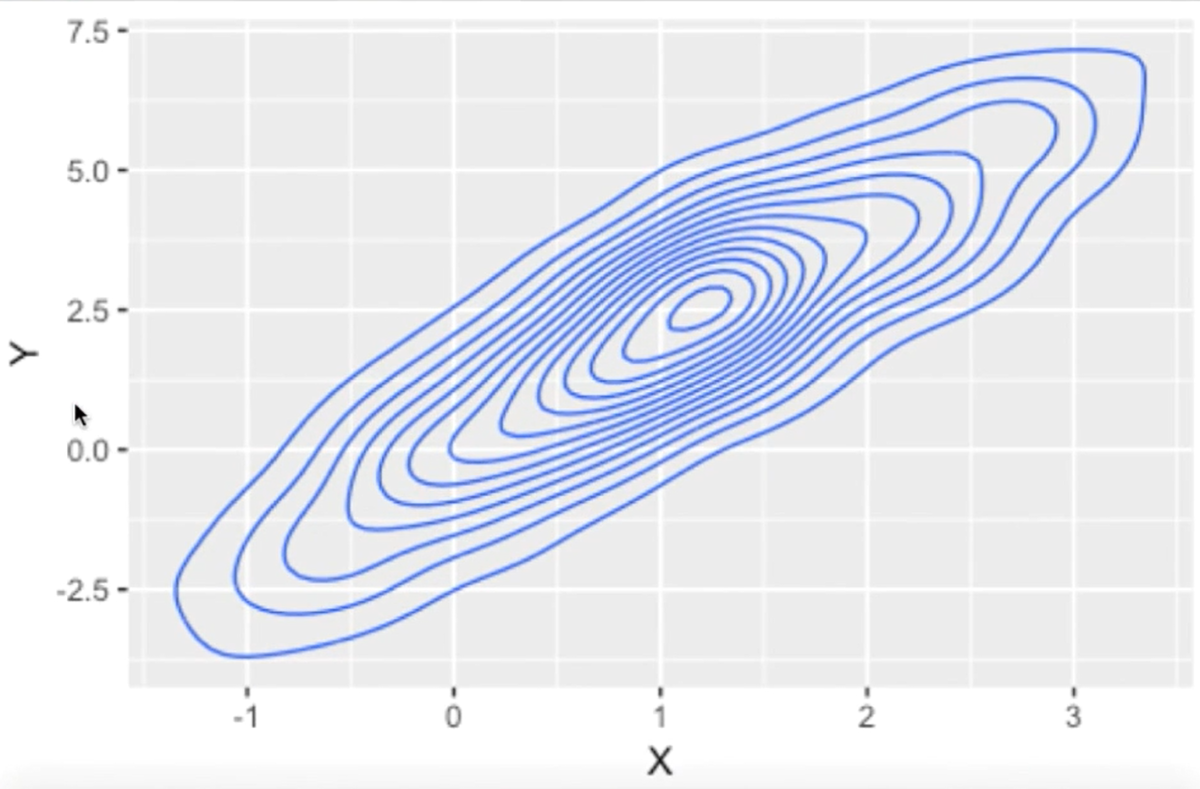
با توزیع توأم گسسته و پیوسته آشنا شدیم و فهمیدیم که تعریف تابع حاشیهای و احتمال حاشیهای چی هست و چجوری میتونیم به کمک اون در مورد استقلال یا وابستگی متغیرهای تصادفی X و Y در توزیعهای توأم نظر بدیم.
اگر جایی ایراد یا مشکلی بود، حتما بهم بگید تا تصحیحش کنم. همچنین، پیشنهاد میکنم که حتماً صفحه گیتهاب این دوره رو مورد بررسی قرار بدین. حتماً به دردتون میخوره.

