
وقتی از تاریخ هوش مصنوعی در ایران حرف میزنیم، ممکن است ذهنمان به نخستین رایانهها، اتاقهای بزرگ محاسباتی یا دانشگاههایی برود که بعدها رشته علوم رایانه را توسعه دادند. اما اینها را نباید با آغاز پژوهش هوش مصنوعی یکی گرفت. رایانه ابزار انجام محاسبه بود؛ هوش مصنوعی، حوزهای پژوهشی است که میکوشد بعضی تواناییهای مرتبط با ادراک، یادگیری، زبان و تصمیمگیری را در سامانههای محاسباتی بازسازی کند.
در ایران نیز مسیر این فناوری نه با یک اختراع یا یک تاریخ قطعی، بلکه بهتدریج شکل گرفت: از گسترش رایانش و آموزش علوم رایانه، به پژوهشهای دانشگاهی در حوزههایی مانند هوش مصنوعی و یادگیری ماشین، و سپس به استفاده عملی از این روشها در صنعت، خدمات و محصولات دیجیتال. این مسیر به تحولات جهانی وابسته بود، اما شرایط آموزش عالی، زیرساختهای محاسباتی، دسترسی به داده و ارتباط پژوهش با بازار کار نیز بر آن اثر گذاشت.
در این مقاله، بهجای معرفی یک «اولین» نامطمئن، میپرسیم: چه زمینههایی باعث شد هوش مصنوعی در ایران شکل بگیرد، پژوهشهای آن چگونه توسعه یافت و چرا امروز همزمان با فرصتهای فراوان، محدودیتهایی جدی دارد؟
برای فهم این تاریخ، باید دو مفهوم را از هم جدا کنیم. رایانش به استفاده از رایانه برای انجام محاسبات، ذخیرهسازی و پردازش اطلاعات اشاره دارد. هوش مصنوعی به روشهایی گفته میشود که در آنها رایانه برای حل مسئلههایی به کار میرود که معمولاً به تواناییهایی مانند یادگیری از داده، تشخیص الگو یا تحلیل زبان نیاز دارند.
این تفکیک مهم است، چون وجود رایانه در یک نهاد یا دانشگاه بهخودیخود به معنی فعالیت هوش مصنوعی نیست. ممکن است رایانه برای محاسبات مهندسی، امور اداری یا پردازش داده به کار رفته باشد، بیآنکه پژوهشی در زمینه هوش مصنوعی انجام شود. در سوی دیگر، بخشی از پژوهشهای مرتبط با این حوزه میتواند در رشتههایی چون برق، ریاضی، مهندسی کامپیوتر، زبانشناسی یا پزشکی پیش برود و الزاماً از ابتدا با عنوان مستقل «هوش مصنوعی» شناخته نشده باشد.
بنابراین تاریخ این حوزه را بهتر است تاریخ شکلگیری یک مجموعه دانش و کاربرد بدانیم، نه صرفاً تاریخ ورود یک دستگاه یا تأسیس یک گروه دانشگاهی.
پیش از آنکه هوش مصنوعی به موضوعی شناختهشده در دانشگاهها و رسانهها تبدیل شود، رایانه باید به ابزار در دسترس پژوهش، آموزش و سازمانها بدل میشد. ورود و گسترش رایانههای بزرگ، آموزش برنامهنویسی و شکلگیری واحدهای مرتبط با علوم رایانه، زیرساختی فراهم کرد که پژوهشهای بعدی بتوانند بر آن تکیه کنند.
در این مرحله، موضوع اصلی معمولاً خودِ محاسبه و برنامهنویسی بود: چگونه مسئلهای را به دستورهای قابلاجرا تبدیل کنیم؟ چگونه دادهها را ذخیره و پردازش کنیم؟ و چگونه از روشهای ریاضی برای حل مسائل علمی و مهندسی بهره ببریم؟ این پرسشها با هوش مصنوعی بیارتباط نبودند، اما معادل آن هم محسوب نمیشدند.
وجود رشتهها و درسهای علوم رایانه، تربیت برنامهنویس و مهندس، و دسترسی به سختافزار محاسباتی، بهمرور امکان پرداختن به مسئلههای پیچیدهتر را ایجاد کرد. با این حال، درباره اینکه نخستین رایانه دقیقاً چه زمانی و در کدام نهاد وارد شد یا نخستین فعالیتی که میتوان آن را «هوش مصنوعی» نامید چه بوده، بدون اتکا به اسناد دانشگاهی و سازمانی نباید ادعای قطعی کرد.
با گسترش علوم رایانه، دانشگاهها و پژوهشگران امکان بیشتری برای پرداختن به شاخههایی یافتند که بعدها در خانواده هوش مصنوعی جای گرفتند. این شاخهها از همان ابتدا یکدست نبودند: برخی بر منطق و حل مسئله تکیه داشتند، برخی بر بازنمایی دانش و سیستمهای خبره، و برخی بر روشهای آماری و تحلیل داده.
سیستم خبره برنامهای است که میکوشد بخشی از دانش یک حوزه تخصصی را به شکل قواعد قابلاستفاده بازنمایی کند. برای مثال، بهجای آنکه سامانه از حجم بزرگی از دادهها الگو بیاموزد، قواعدی را اجرا میکند که متخصصان تعریف کردهاند. این رویکرد در دورههایی از تاریخ جهانی هوش مصنوعی اهمیت داشت و در آموزش و پژوهش رایانه نیز زمینهای برای طرح پرسش درباره چگونگی بازنمایی دانش فراهم میکرد.
در ایران نیز توسعه آموزش و پژوهش رایانه، مسیر پرداختن به موضوعات مرتبط را هموار کرد؛ اما برای سنجش دامنه و زمان دقیق این فعالیتها باید به برنامههای درسی، پایاننامهها، مقالههای علمی و سوابق گروههای دانشگاهی رجوع کرد. صرف اشاره به «پژوهشهای هوش مصنوعی در دانشگاهها» برای تعیین نخستین مرکز یا نخستین پروژه کافی نیست.
یکی از دگرگونیهای مهم در هوش مصنوعی، رشد یادگیری ماشین بود. در این رویکرد، بهجای نوشتن همه قواعد بهدست برنامهنویس، سامانه با استفاده از دادهها الگوهایی میآموزد و بر اساس آنها پیشبینی یا دستهبندی میکند. برای نمونه، میتوان الگوریتمی را با مجموعهای از نمونهها آموزش داد تا در دادههای تازه، الگوهای مشابه را تشخیص دهد.
یادگیری ماشین به داده و توان محاسباتی وابستگی دارد. افزایش ظرفیت رایانهها، گسترش اینترنت و رشد حجم دادههای دیجیتال در سطح جهانی، این حوزه را از فضای عمدتاً تخصصی به عرصهای با کاربردهای گستردهتر سوق داد. در ایران نیز توسعه دسترسی به رایانه و اینترنت، شکلگیری گروههای پژوهشی و رشد انتشار علمی، زمینه فعالیت در این شاخهها را بیشتر کرد.
در این مرحله، پژوهشهایی با موضوعاتی چون دادهکاوی، تشخیص الگو، پردازش تصویر، بازیابی اطلاعات و پردازش زبان طبیعی در مدار علمی و دانشگاهی قرار گرفتند. بااینحال، این فهرست را نباید به معنای آن گرفت که همه این حوزهها در زمانی واحد یا با یک سرعت در ایران توسعه یافتهاند. هرکدام به تخصص، داده و زیرساخت متفاوتی نیاز داشتند.
یکی از مسیرهای مهم در هوش مصنوعی ایران، کار روی زبان فارسی است. پردازش زبان طبیعی، یعنی ساخت روشهایی برای تحلیل، جستوجو، دستهبندی یا تولید زبان انسانی، برای فارسی مسئلههای ویژهای دارد. تفاوتهای نوشتاری، شکلهای گوناگون فاصلهگذاری، نیمفاصله، وامواژهها و تنوع زبانی از عواملی هستند که میتوانند کیفیت ابزارهای زبانی را تحت تأثیر قرار دهند.
برای آموزش سامانههای زبانی، داده باید هم از نظر حجم کافی باشد و هم از نظر کیفیت و مجوز استفاده قابلبررسی. دادههای نامنظم یا دارای خطا، و مجموعههایی که نماینده تنوع واقعی زبان نیستند، ممکن است نتیجههایی偏دار یا کمدقت تولید کنند. به همین دلیل، ساخت پیکرههای متنی و ابزارهای فارسی بخشی از زیرساخت پژوهش به شمار میآید، نه کاری فرعی در حاشیه آن.
کار روی زبان فارسی همچنین یادآوری میکند که توسعه هوش مصنوعی صرفاً خرید سختافزار یا استفاده از مدلهای آماده نیست. کیفیت داده، تخصص زبانشناختی، ارزیابی علمی و شناخت نیاز کاربران، همگی در ساخت ابزارهای قابلاعتماد نقش دارند.
با رشد فناوریهای دیجیتال، کاربرد هوش مصنوعی از فضای آزمایشگاهی و دانشگاهی فراتر رفت. در بسیاری از کشورها، و از جمله ایران، شرکتها و سازمانها بهتدریج از تحلیل داده، تشخیص الگو و ابزارهای پیشبینی برای بهبود برخی خدمات استفاده کردند. نمونههای کلی این کاربردها میتواند شامل پیشنهاد محتوا، دستهبندی خودکار، پشتیبانی مشتری، تحلیل تصویر یا پیشبینی برخی روندها باشد.
اما وجود یک قابلیت هوشمند در محصول، بهتنهایی نشان نمیدهد که آن محصول بر پایه پژوهش بومی ساخته شده یا از نظر علمی ارزیابی شده است. گاهی یک شرکت از ابزارهای آماده استفاده میکند؛ گاهی مدل را با دادههای محلی تنظیم میکند؛ و گاهی هم پژوهش و توسعه فنی از ابتدا در داخل انجام میشود. این تفاوتها برای فهم میزان توسعه واقعی یک صنعت اهمیت دارند.
پیوند دانشگاه و صنعت نیز مسئلهای کلیدی است. پژوهش دانشگاهی معمولاً بر تولید دانش و ارزیابی روشها تمرکز دارد، درحالیکه محصول باید نیاز کاربر، هزینه، نگهداری، امنیت و پایداری را هم در نظر بگیرد. تبدیل پژوهش به خدمت موفق، به همکاری میان پژوهشگران، مهندسان، مدیران و کاربران نیاز دارد؛ و این تبدیل در همه حوزهها به یک اندازه آسان نیست.
در دهه ۱۳۹۰ خورشیدی، گسترش کسبوکارهای اینترنتی، تلفنهای هوشمند و خدمات آنلاین، تقاضا برای تحلیل داده و خودکارسازی را افزایش داد. این تحول جهانی بود، اما در ایران نیز فضای تازهای برای شرکتهای فناوری و نیروی متخصص ایجاد کرد. سامانههای جستوجو و پیشنهاد، تشخیص تقلب، تحلیل رفتار کاربر و ابزارهای گفتوگومحور از نمونههایی هستند که در این فضای گستردهتر مطرح شدند.
با این همه، بهتر است از روایت خطی «هر دهه پیشرفت قطعی و یکنواخت» دوری کنیم. توسعه فناوری ممکن است در یک حوزه سریع باشد و در حوزهای دیگر کند بماند. شمار مقالهها یا حضور در یک رویداد، بهتنهایی نشاندهنده کیفیت محصول، دسترسی گسترده به زیرساخت یا اثر اقتصادی پایدار نیست.
تحریمها، محدودیت دسترسی به برخی خدمات و سختافزارها، دشواری انتقال فناوری، نوسان سرمایهگذاری و مهاجرت نیروی متخصص از عواملیاند که در تحلیل وضعیت فناوری ایران باید بررسی شوند. اما وزن هر عامل در هر دوره و در هر بخش یکسان نیست و برای سنجش آن به دادههای مشخص نیاز است. توضیح توسعه هوش مصنوعی ایران با یک علت واحد، تصویر را ساده و گمراهکننده میکند.
ظهور ابزارهای هوش مصنوعی مولد، از تولید متن و تصویر تا کمک به برنامهنویسی، توجه عمومی به این حوزه را بهسرعت افزایش داد. این ابزارها میتوانند در کارهایی مانند خلاصهسازی، ایدهپردازی یا پاسخگویی به پرسشها مفید باشند، اما خروجی روان آنها همیشه درست نیست. مدل ممکن است اطلاعات نادرست را با لحنی مطمئن بیان کند یا در موضوعات حساس، سوگیریهای دادههای آموزشی را بازتولید کند.
برای کاربران و سازمانهای ایرانی، پرسشهای مهمی مطرح است: آیا ابزار با زبان فارسی خوب کار میکند؟ دادههای کاربر چگونه پردازش و نگهداری میشوند؟ آیا استفاده از آن با قوانین و مجوزها سازگار است؟ و در چه موقعیتهایی باید پاسخ سامانه را حتماً با منبع مستقل سنجید؟
این پرسشها نشان میدهند که توسعه امروزی هوش مصنوعی فقط رقابت بر سر ساخت مدل بزرگتر نیست. امنیت داده، شفافیت، پاسخگویی، کیفیت زبان، ارزیابی منصفانه و اثر فناوری بر مشاغل و آموزش نیز بخشی از بحثاند. استفاده مفید از این ابزارها مستلزم شناخت محدودیتهایشان است، نه اعتماد بیقیدوشرط یا رد کلی آنها.
چه چیزی را میتوان درباره مسیر ایران با اطمینان گفت؟
با نگاه کلی، مسیر هوش مصنوعی در ایران را میتوان در چند روند بههمپیوسته دید: گسترش رایانه و آموزش محاسبات؛ توسعه علوم رایانه و پژوهشهای نزدیک به هوش مصنوعی؛ افزایش توجه به یادگیری ماشین و داده؛ و رشد کاربردهای دیجیتال و ابزارهای مولد. این چارچوب برای فهم تحولات مفید است، اما جای گاهشمار مستند و تاریخگذاری دقیق هر رویداد را نمیگیرد.
برای ساختن تاریخ دقیقتر، باید چند نوع شاهد را کنار هم گذاشت: آرشیو دانشگاهها و گروههای آموزشی، سرفصلهای درسی، پایاننامهها، مقالههای علمی، اسناد مربوط به مراکز محاسباتی، گزارشهای شرکتها و مصاحبههای تاریخ شفاهی. هرکدام محدودیتهایی دارند. برای مثال، مقاله علمی فعالیت پژوهشی را نشان میدهد، اما لزوماً تصویری کامل از شرایط زیرساختی یا اثر اجتماعی آن ارائه نمیکند. خاطره پژوهشگر هم ارزشمند است، اما باید با اسناد همزمان و روایتهای دیگر سنجیده شود.
از همین رو، ادعای «نخستین هوش مصنوعی ایران» نیازمند تعریف روشن است: نخستین درس؟ نخستین مقاله؟ نخستین پایاننامه؟ نخستین گروه دانشگاهی؟ یا نخستین محصول تجاری؟ پاسخ هر پرسش ممکن است متفاوت باشد. تا زمانی که این معیار مشخص و مستند نشده، بهتر است بهجای یک نقطه آغاز قطعی، از روند شکلگیری تدریجی این حوزه سخن بگوییم.
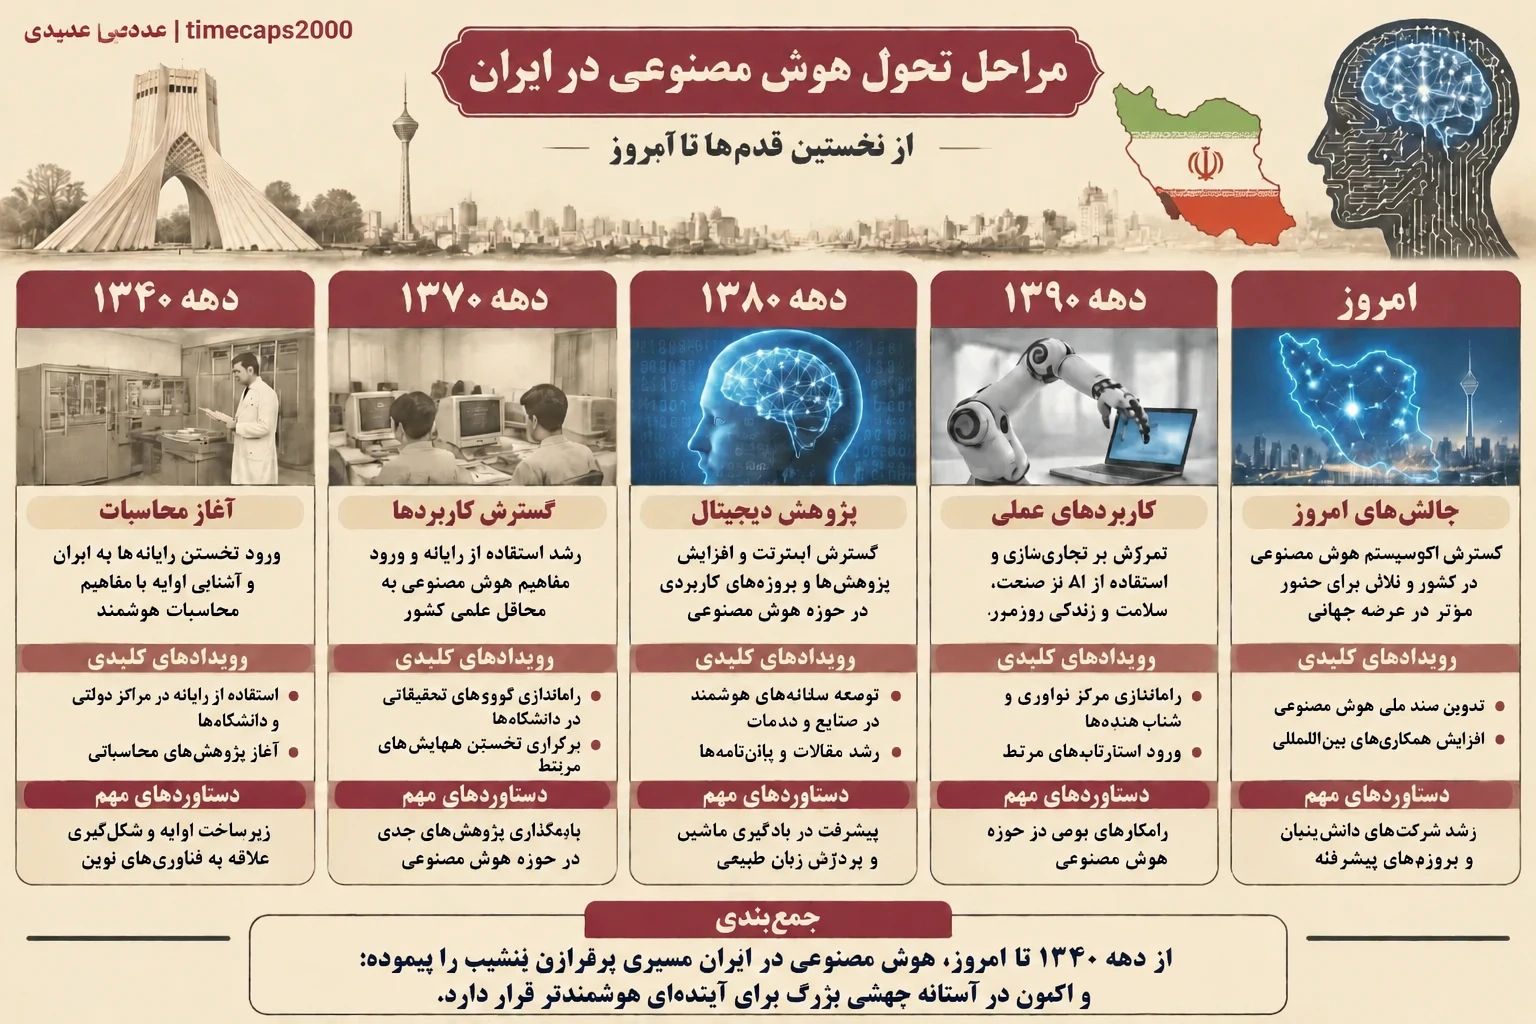
هوش مصنوعی در ایران را نمیتوان به ورود یک رایانه یا تأسیس یک مرکز فروکاست. این حوزه بر بستری از آموزش، پژوهش، داده، زیرساخت و نیازهای اجتماعی رشد کرده است. در این مسیر، علوم رایانه و رایانش مقدمات لازم را فراهم کردند؛ دانشگاهها امکان پژوهش در شاخههای مختلف را گسترش دادند؛ و دیجیتالیشدن خدمات، زمینه استفاده عملی را بیشتر کرد.
توسعه امروز نیز با فرصت و محدودیت همزمان روبهروست. ابزارهای مولد میتوانند کارهای روزمره را آسانتر کنند، اما کیفیت زبان فارسی، دسترسی به زیرساخت، حفاظت از داده و ارزیابی مستقل همچنان اهمیت دارند. مهمتر از همه، روایت تاریخی این فناوری باید بر اسناد و تعریفهای روشن تکیه کند: تا وقتی معلوم نیست منظور از «آغاز» کدام نوع فعالیت است، تعیین نخستین تاریخ یا نخستین نهاد، بیشتر ادعایی جذاب است تا نتیجهای مستند.
اسماعیل سعیدی، پژوهشگر تاریخ ایران و جهان و سازنده محتوای تاریخی «تایمکپس» است. او در این مجموعه تلاش میکند رویدادها، شخصیتها و تحولات تاریخی را با روایتی جذاب و با تکیه بر پژوهش و منابع معتبر بررسی کند.
برای دنبالکردن روایتهای تاریخی بیشتر، به صفحه اینستاگرام تایمکپس بپیوندید:
اینستاگرام: @timecaps2000
بهنظر شما در نوشتن تاریخ هوش مصنوعی ایران، کدام نقطه آغاز مهمتر است: ورود رایانه، شکلگیری آموزش دانشگاهی علوم رایانه، نخستین پژوهشهای تخصصی یا پیدایش کاربردهای روزمره؟

