
با گذشت ربع قرن از ظهور اینترنت دیگر نمیتوان برآورد دقیقی از حجم دادههای موجود در اینترنت بدست آورد اما طبق برآورد شرکت سیسکو که بزرگترین تولیدکنندهی تجهیزات زیرساخت اینترنت است، ترافیک سالانهی اینترنت تا سال 2021 به 3.3 زتابایت خواهد رسید. براساس آمار همین شرکت، 82 درصد کل این ترافیک صرف انتقال ویدیو خواهد شد. سرویسهای بزرگی همچون یوتوب برای نمایش ویدئو و ساند کلود برای پخش موسیقی و پادکست در اینترنت در هر ساعت در حال ذخیرهسازی حجم سرسام آوری از اینگونه فایلهای چندرسانهای هستند. به عنوان مثال تنها در یوتوب در هر دقیقه 300 ساعت ویدیو بارگذاری میشود.
چنین وضعیتی، فرصتهایی برای کسبوکارها پدید میآورد. برای نمونه، با توجه به نرخ بالای رشد اینگونه محتواهای چندرسانهای، در آینده به احتمال زیاد شاهد پیدایش نوپاها و سرویسهایی خواهیم بود که این نوع فایل های تصویری و صوتی را جستوجو و نمایهگذاری میکنند. از ویژگیهای این سرویسها، جستوجو در میان صداها و یافتن کلمات مورد جستوجوی کاربر خواهد بود. اگر ادعا کنیم که این نوپاها، رخدادی تازه را در اینترنت رقم میزنند، پرسشی پیش میآید: تفاوت اساسی این سرویسها با موتورهای جستوجوی کنونی در چیست؟
آنچه موتورهای جستوجو در آینده را نسبت به نیاکان امروزی آنها متمایز خواهد کرد، تفاوت ماهیت ورودی با محتوای مورد جستوجو است. امروز در موتور جستوجوی گوگل، متن داده میشود و محتواهای متنی جستوجو میشوند یا در سایتی مثل تاینیآی و جستوجوی وارونِ تصویر در گوگل، یک عکس به عنوان ورودی داده میشود و تصاویر همانند با ورودی، جستوجو میشوند و یا در نمونهی امروزی دیگر که برنامهی محبوب شازم است، کاربری که این برنامه را نصب کرده است، گوشی موبایل خود را در جایی قرار میدهد که موزیک قابل شنیدن است و این برنامه با ضبط آهنگِ در حالِ پخش و جستوجو در پایگاه دادههای آهنگهای خود، مشخصات آهنگ در حال پخش را پیدا میکند. در این حالت، هم ورودی و هم محتوای مورد جستوجو، موسیقی هستند.
ما باید بتوانیم فایل صوتی، تصویری یا چندرسانهی مورد نظر خود را پیدا کنیم و ممکن است به آن، دسترسی هم نداشته باشیم و فقط بخشی از محتوای آن را به یاد داشته باشیم. در موتورهای جستوجوی آینده که ویدیوها و پادکستها را جستوجو خواهند کرد، یک متن به عنوان ورودی داده میشود و سیستم باید این متن را از درون صداها بیابد و لازمهی این کار، آن است که پادکستها از قبل پردازش شده و محتوای متنی آنها استخراج و نمایهگذاری شده باشد.
انجام این کار، در عمل، بسیار دشوار است و تاکنون سرویس جامعی برای جستوجو در همه پادکستها به زبانهای مختلف ساخته نشده است. مشکلی مشابه در مورد فرمتهای متنی پیدیاف یا تصاویر متنی وجود دارد. بخشی از این مشکل به پردازشنشده بودن محتواهای چندرسانهای باز میگردد. به هر حال، از بین سرویسهای رایگان امروزی که در مسیر فردا گام بر میدارند، میتوان به پایگاه اینترنتی ماتولا اشاره کرد. با این حال، موتور جستوجوی این پایگاه تنها در زبان انگلیسی به جستوجو میپردازد و نتایج جستوجوی آن نیز بسیار محدود است.
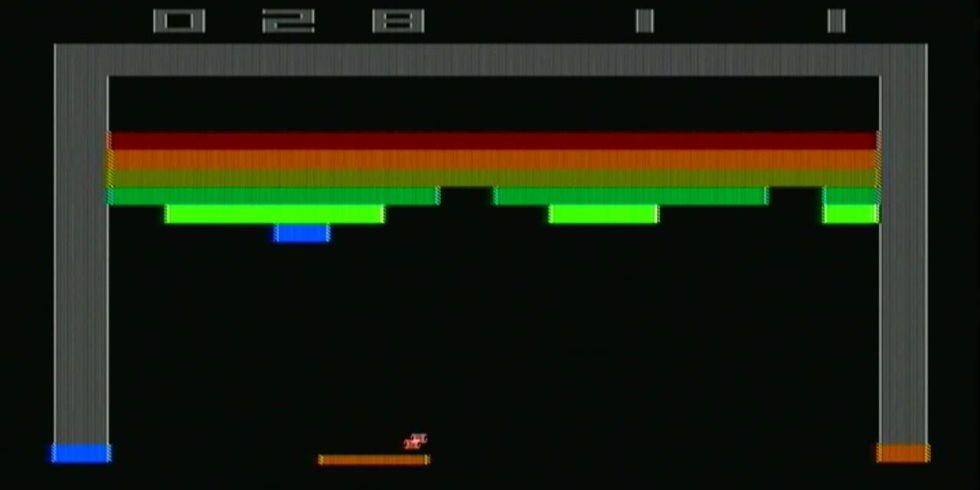
به نظر می رسد در آیندهی نزدیک، راه رسیدن به موتورهای جستوجوی چندرسانهای با داشتن واژگان یا نتهایی محدود از محتوای آنها فراهم شود. پیشران رسیدن به چنین سرویسهایی، توسعهی هوش مصنوعی است. در سالهای اخیر، الگوریتمهای هوش مصنوعی پیشرفتهای شگفتانگیزی داشتهاند. در سال 2014 شرکتدیپمایند که در همین سال توسط گوگل خریداری شد، نامهای به مجلهی نیچر فرستاد و آنجا از الگوریتم جدیدی به نام آموزش عمیق کیو رونمایی کرد. کار این الگوریتم چیزی جز بازی کردن با بازیهای قدیمی آتاری نبود. بازی نمونه که مورد بررسی قرار گرفت، بازی معروف سقفشکن بود. مهندسان تنها چیزی که به این الگوریتم به عنوان ورودی دادند، تصویر صفحه نمایش بازی به همراه یک دستور بود که میگفت امتیاز گوشهی بالای تصویر باید به حداکثر مقدار خود برسد.
هیچ گزاره و حتی دانش دیگری به الگوریتم داده نشد یعنی الگوریتم درکی از مفهوم توپ در بازی یا دکمههای کنترل بازی نداشت. نتیجه به این صورت بود:
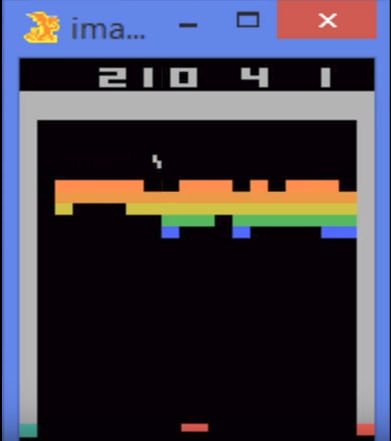
این موضوع، امیدی بسیار بزرگ پدید آورد چون این عمل، نزدیک به تشخیص بود و نه تنها محاسبه. آیا الگوریتم پیشرفت کرده بود و در مراحل رشد قرار داشت؟ آیا خودبهخود تشخیص داده بود که چنین روشی وجود دارد و بنابراین، ممکن بود روشهای تازهای را هم دریابد؟ همچنین، میشد چنین پدیدهای را بدبینانه نیز نگریست. تصور کنید یک نوزاد به دنیا بیاید و بعد از دو ساعت با پزشکان خود که او را به دنیا آوردهاند آتاری بازی کند و آنها را شکست دهد. قدری ترسناک به نظر می رسد. اینطور نیست؟
به هر حال، از این الگوریتم پیشرفته میتوان در موارد بسیاری استفاده کرد. در حال حاضر، از این الگوریتم به صورت آزمایشی در چند بیمارستان در انگلستان برای تشخیص بیماریها کمک گرفته میشود. یکی دیگر از کاربردهای این تکنولوژی کمک به ناشنوایان است به این ترتیب که نرم افزارهایی ساخته خواهد شد که به کاربر این امکان را میدهد تا متن گفتگوهای درون یک فایل صوتی یا تصویری را بدست بیاورند. در مورد خاص بحث ما، نرمافزارهای هوش مصنوعی نسل جدید خواهند توانست فایلهای صوتی و تصویری را پردازش کنند و متن گفتار آنها را استخراج کنند. به این ترتیب موتورهای جستجو میتوانند خروجی این نرمافزارها را که از نوع متن است پردازش و نمایهگذاری کنند.
با وجود چنین فناوریهایی، راه برای رسیدن به سرویسهای پیشرفتهی جستوجوگر گشودهتر خواهد بود. کارآفرینان و جوانانی که به دنبال یافتن ایدههایی نو برای راهاندازی کسبوکاری نوپا هستند، میتوانند به تحقیق و توسعه در این زمینه بپردازند.
به نظر میرسد در آینده، حرفهها و شغلهای جدیدی با توجه به پیشرفت هوش مصنوعی پدید آیند. یکی از این شغلها احتمالا بهینهسازی یا تنظیم الگوریتمهای هوش مصنوعی خواهد بود. در آینده الگوریتمهای هوش مصنوعی نیاز به نیروی کار در بسیاری از زمینهها را رفع میکنند و باید منتظر محو شدن بسیاری از کارها در بازار بود اما نیاز است کارهای تخصصی توسط متخصصان هر حرفه اعتبارسنجی شود.
هنوز فاصلهی زیادی با جایگزینی کامل انسانها توسط هوش مصنوعی داریم اما به نظر میرسد که نحوهی کار متخصصان در حرفههای مختلف، دگرگون خواهد شد و بیشتر، حالت نظارت بر نرمافزارها را خواهد داشت. به عنوان مثال، در آیندهی نزدیک، جستوجو درون محتوای فایلهای تصویری و صوتی، پیشرفت قابل ملاحظهای خواهد داشت اما قطعا نیاز به ناظر برای بازبینی و تایید صحت الگوریتمهای پردازش صوت و تصویر رفع نخواهد شد.
با کسب توانایی تبدیل گفتار به نوشتار در آینده و همچنین پیشرفت الگوریتمهای هوش مصنوعی در درک جملهها و متنهای انسانی و فهم آنها، ممکن است در آینده گفتوگوها و ارتباطات میان کامپیوترها از طریق زبان انسانی صورت بگیرد. به این ترتیب، اطلاعات رد و بدل شده بین کامپیوترها توسط انسانها نیز به سادگی قابل فهم خواهد بود. علاوه بر راههای ارتباطی کنونیِ کامپیوترها که بر بستر کابل، بلوتوث، وایرلس و مانند آنها است میتوان راه ارتباطی از طریق صدا و زبان انسانها را نیز اضافه کرد.
اما گسترش هوش مصنوعی در آینده ممکن است به پیدایش فراهوش بینجامد که به مراتب از بهترین مغزهای کنونی انسانی هوشمندتر است. در حال حاضر، پژوهشگران در مورد چگونگی ایجاد یک سیستم هوشمند فراتر از هوش کنونی انسانها اختلاف نظر دارند. برخی استدلال میکنند که پیشرفتهای صورت گرفته در هوش مصنوعی احتمالا منجر به این میشود که سیستمهای جامع هوشمندی به وجود بیاید که محدودیتهای شناختی ذهن انسان را نداشته باشد. این استدلال بر این مبنا است که سلولهای ذهن انسان، بهطور تدریجی و بر اساس انتخاب طبیعی که فرایندی برگشتناپذیر و غیرقابل اصلاح است به وجود آمدهاند و هوش انسانی سرانجام یک فرآیند مکانیکی است که در ذهن انسان اتفاق میافتد، اما هیچ دلیلی وجود ندارد که فرض کنیم هوش انسانی تنها شکل ممکن هوش میتواند باشد.
برخی دیگر معتقدند که انسان میتواند تکامل یابد و مستقیما سازوارهی خود را تغییر دهد و به این وسیله به هوشی که به طور اساسی از هوش کنونی پیشرفتهتر است دست یابد. رویکردهای مختلف دیگری نیز وجود دارند اما بر اساس این رویکرد گفتهشده، احتمالا دو حالت فراهوش به وجود خواهد آمد. در حالت اول، یک نوع رابط میان مغز و کامپیوتر ایجاد میشود به این صورت که راه ارتباطی مستقیمی مانند جاگذاری میکروچیپ بین مغز و دستگاه خارجی ساخته میشود تا ظرفیتهای محاسباتی انسانها افزایش پیدا کند.
در حالت دوم، ممکن است ذهن انسان را به طور کامل درون یک کامپیوتر بارگذاری کنند تا یک سیستم فراهوش درون یک کامپیوتر شکل بگیرد. در این صورت، زندگی با تصور جسمانی شگرفی همراه خواهد بود و جهانی بهکلی متفاوت خواهیم داشت. به این ترتیب ممکن است فناوری پردازش متن صدا و تصویر، بستری فراهم آورد برای این که سیستمهای فراهوش آینده بتوانند ذهن انسان را بخوانند و آنچه در فکر ما هست را یادداشت کنند و در جای دیگر برای مصارف دیگری استفاده کنند. همهی اینها تنها برخی از حالتهای ممکن است و هستند دانشمندانی که میاندیشند هنوز هوش مصنوعی در مرحلهی محاسباتی است و چیزی به نام تشخیص در آن پدید نیامده است و برخی نیز میگویند که نخواهد آمد.
منتشر شده در ماهنامه پیشران - شماره 13
اردیبهشت 1397

