در این مقاله به سه سؤال اصلی پاسخ میدهیم:
کلاینت چطور متوجه میشود که یک فایل تغییر کرده است؟
تغییرات یک فایل بزرگ چطور به سرور منتقل میشوند؟
کلاینتهای دیگر چطور از این تغییر مطلع میشوند و فرایند Sync چگونه انجام میشود؟
این مقاله، قسمت اول از یک مجموعه ۳۰ قسمتی است که در آن سیستمهای واقعی را یکییکی بررسی میکنیم. برای شروع، Dropbox را انتخاب کردم، چون چند اصل مهم در طراحی سیستم را به شکلی بسیار ملموس و قابلدرک نشان میدهد.
یک نکته قبل از شروع: معماریای که در این مقاله میبینید، معماری رایجی است که در منابع System Design و مصاحبههای فنی برای مسئلهای مانند Dropbox بررسی میشود و لزوماً نقشهی دقیق زیرساخت داخلی Dropbox نیست. برای مثال، Dropbox سالها پیش سیستم ذخیرهسازی اختصاصی خودش به نام Magic Pocket را ساخت و بهجای Amazon S3 از آن استفاده کرد. اما منطق اصلی سیستم همچنان مشابه است.
در این مجموعه میخواهم سیستمهایی را بررسی کنم که هر روز از آنها استفاده میکنیم، اما پشت یک تجربهی کاربری ساده، معماری پیچیدهای قرار دارد.
برای اولین مقاله، انتخاب من یک سیستم اشتراکگذاری و همگامسازی فایل است: Dropbox.
در نگاه اول مسئله ساده به نظر میرسد:
یک فایل روی لپتاپ تغییر میکند و چند لحظه بعد همان تغییر باید روی لپتاپ دیگر، موبایل کاربر و دستگاه همکارانی که به فایل دسترسی دارند، دیده شود.
اما وقتی تعداد کاربران، دستگاهها و فایلها زیاد میشود، سؤال اصلی دیگر این نیست:
چطور یک فایل را Upload کنیم؟
سؤال اصلی این است:
چطور نسخهی صحیح فایل را نگه داریم و تغییرات آن را با کمترین تأخیر به سایر دستگاهها برسانیم؟
معماری Dropbox وقتی از این زاویه به آن نگاه کنیم، منطقی میشود.
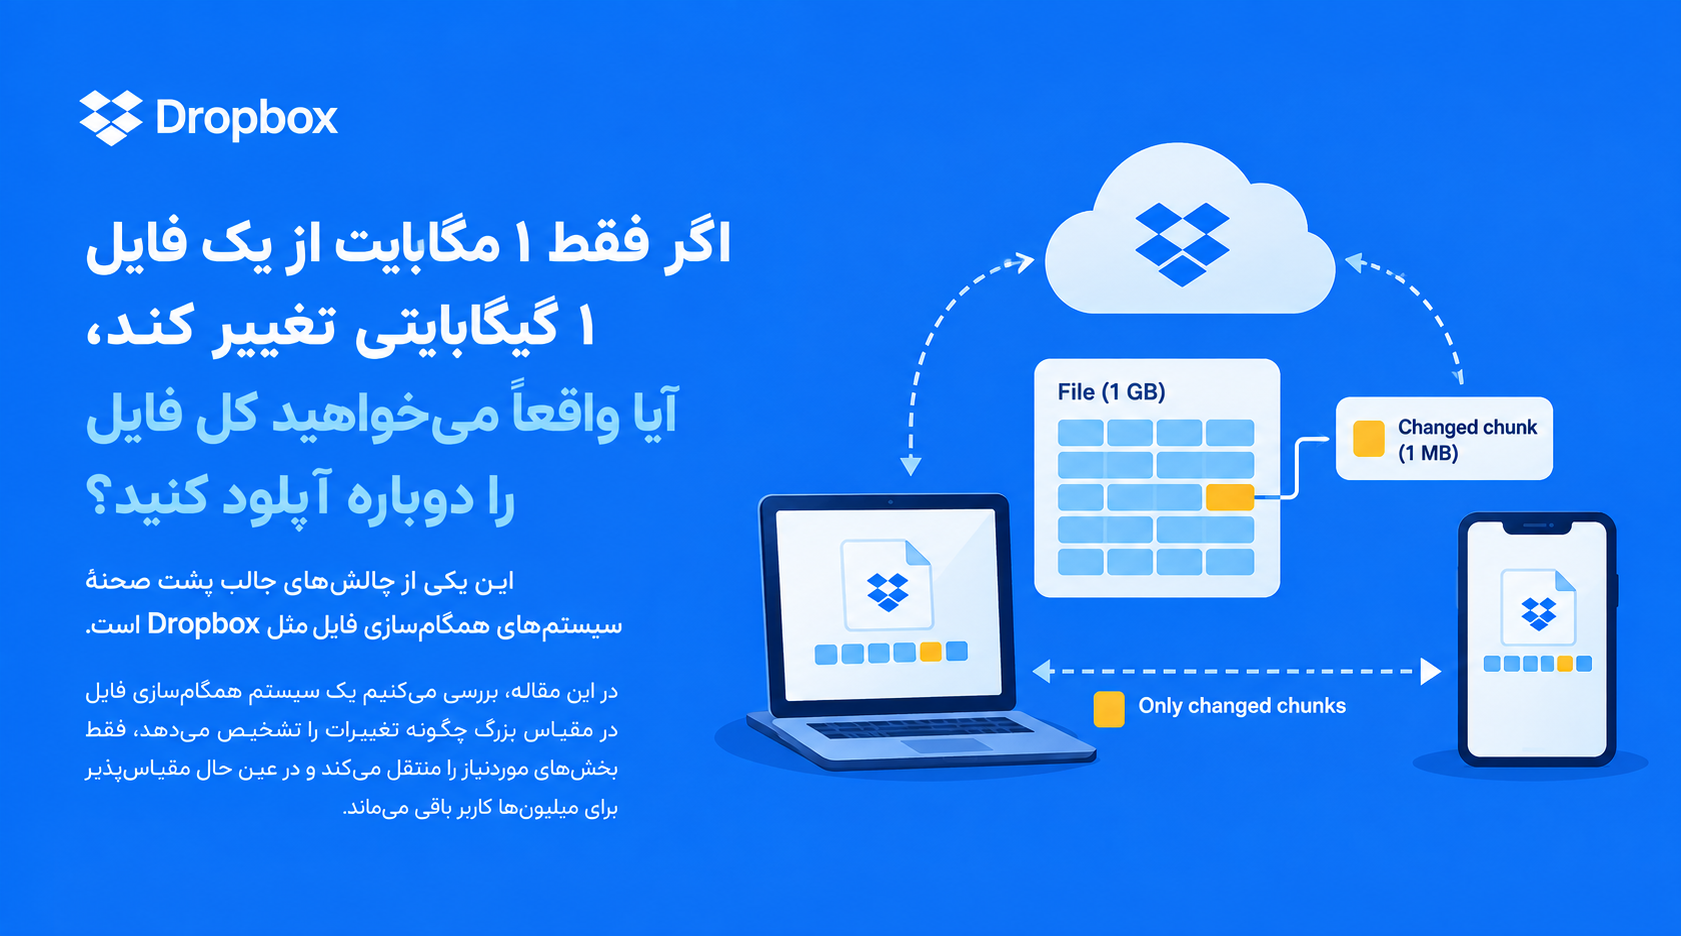
فرض کنید یک فایل چند گیگابایتی دارید و فقط بخش کوچکی از آن تغییر کرده است.
اگر سیستم هر بار کل فایل را دوباره Upload کند، با سه مشکل مواجه میشویم:
مصرف پهنای باند افزایش پیدا میکند.
زمان Sync بیشتر میشود.
Backend مجبور میشود حجم زیادی از دادهی تکراری را دوباره پردازش و ذخیره کند.
راهحل این است که فایل را قبل از Upload به قسمتهای کوچکتری به نام Chunk تقسیم کنیم.
برای هر Chunk نیز یک Hash تولید میکنیم.
در نتیجه، بهجای اینکه سرور بپرسد:
آیا این فایل تغییر کرده است؟
میتواند بپرسد:
کدام Chunkهای این فایل تغییر کردهاند؟
همین تغییر کوچک، اساس کل معماری Sync را تغییر میدهد.
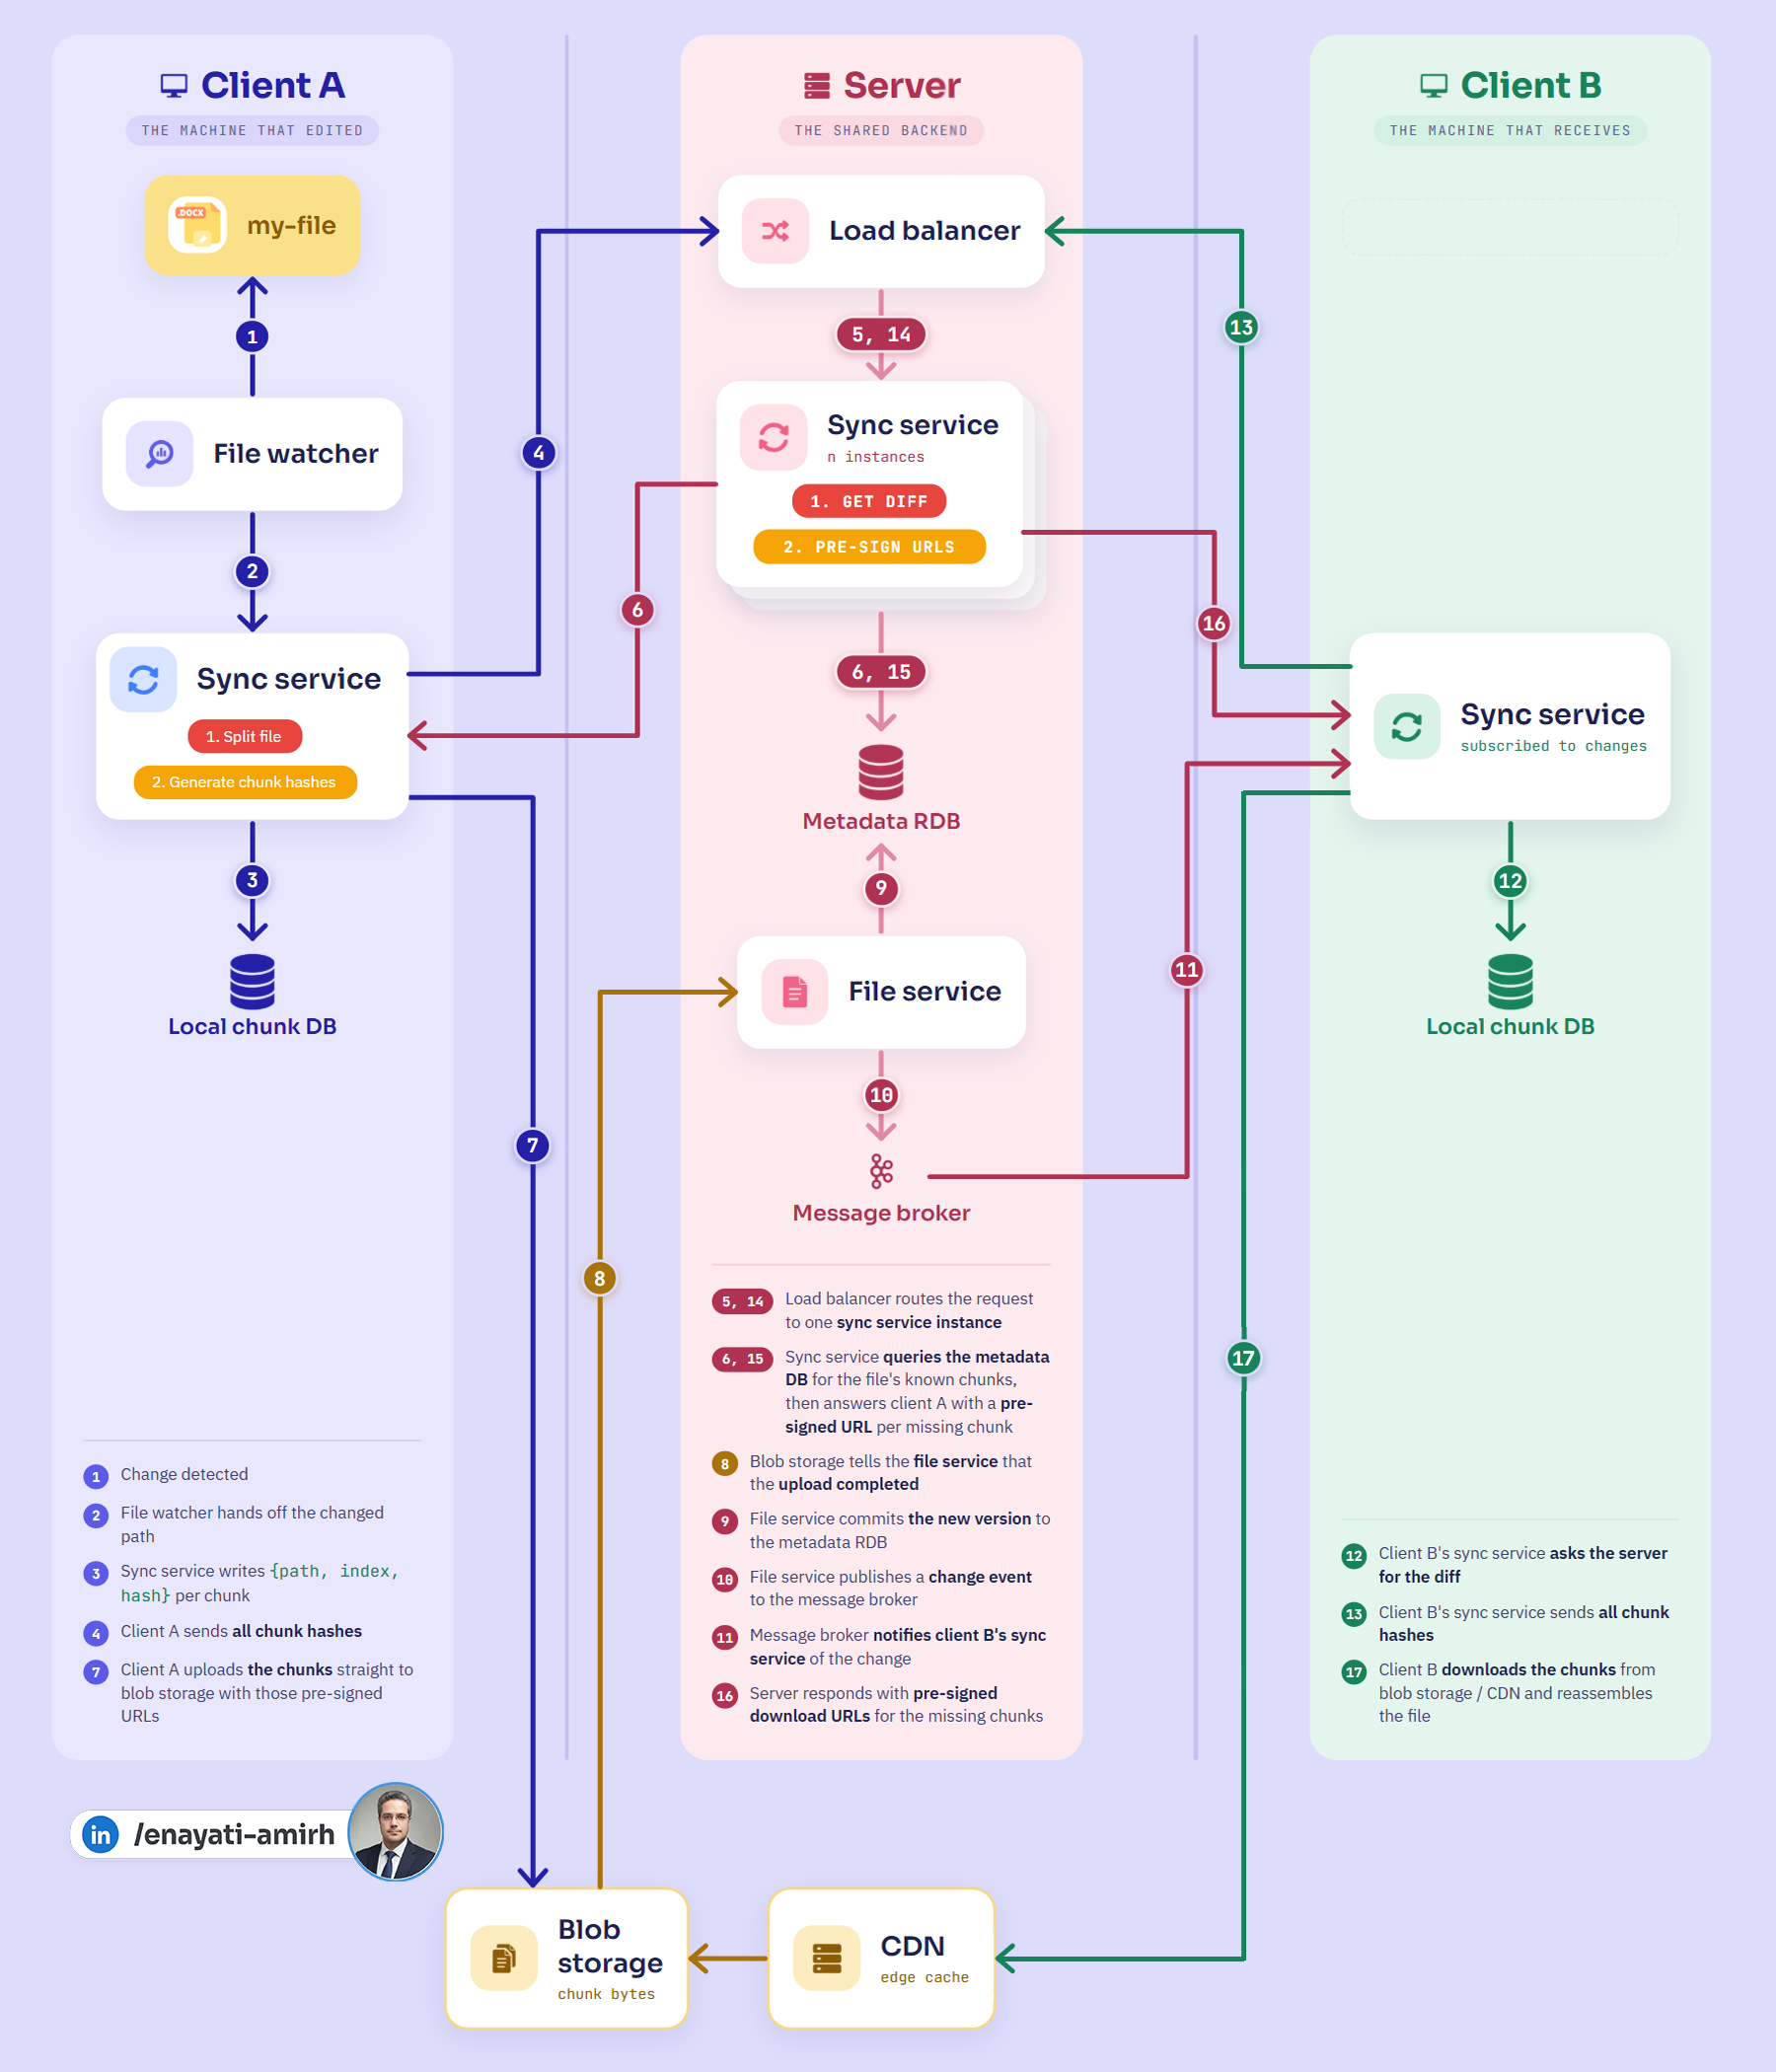
روی Client A یک File Watcher در پسزمینه اجرا میشود و فایلسیستم را زیر نظر دارد.
کاربر نیازی ندارد دکمهی Sync را فشار دهد.
بهمحض اینکه فایلی ایجاد، حذف یا ویرایش شود، Watcher این تغییر را تشخیص میدهد.
Watcher نباید خودش مسئول Upload فایل باشد.
وظیفهی آن فقط تشخیص تغییر است.
بنابراین مسیر فایل تغییرکرده را به Sync Service روی همان Client میدهد.
این جداسازی اهمیت زیادی دارد. هر کامپوننت یک مسئولیت مشخص دارد:
Watcher: پیدا کردن تغییر
Sync Service: تصمیمگیری درباره اینکه چه چیزی باید Sync شود
Sync Service فایل را به Chunkهای کوچکتر تقسیم میکند.
برای هر Chunk یک Hash محاسبه میشود و اطلاعاتی شبیه این در Local Chunk DB ذخیره میشود:
{ path, index, hash }
در نتیجه Client میداند:
این Chunk متعلق به کدام فایل است.
مربوط به کدام قسمت فایل است.
Hash محتوای فعلی آن چیست.
حالا برای تشخیص تغییر، Client و Server دیگر لازم نیست کل فایل را با هم مقایسه کنند.
مقایسهی Hashها کافی است.
همین ایده یکی از پایههای Deduplication نیز محسوب میشود و باعث میشود Chunkهایی که از قبل وجود دارند، دوباره Upload نشوند.
اینجا یکی از مهمترین تصمیمهای طراحی اتفاق میافتد.
وقتی Sync شروع میشود، Client خود فایل را به Backend ارسال نمیکند.
در ابتدا فقط لیست Hash تمام Chunkها را میفرستد.
چرا؟
چون Server میتواند با استفاده از Metadata موجود تشخیص دهد:
کدام Chunkها را از قبل دارد.
کدام Chunkها را ندارد.
به عبارت دیگر، قبل از اینکه دادهی سنگین منتقل شود، یک مذاکرهی سبک روی Metadata انجام میشود.
در سمت Server، درخواست ابتدا به Load Balancer میرسد.
وقتی تعداد Clientها زیاد باشد، نمیتوان تمام درخواستها را به یک Sync Service ارسال کرد.
Load Balancer درخواستها را بین چندین Instance تقسیم میکند.
در نتیجه Sync Layer میتواند بهصورت Horizontally Scalable توسعه پیدا کند؛ یعنی با اضافهکردن Instanceهای بیشتر، ظرفیت سیستم افزایش پیدا کند.
حالا Server-side Sync Service Hashهایی که Client ارسال کرده را با اطلاعات موجود در Metadata RDB مقایسه میکند.
خروجی چیزی شبیه این خواهد بود:
این Chunk را دارم.
این یکی را هم دارم.
این سه Chunk جدید هستند.
بنابراین فقط Chunkهای گمشده باید Upload شوند.
این قلب اصلی سیستم است:
هزینهی Sync باید تا حد امکان متناسب با اندازهی تغییرات باشد، نه اندازهی کل فایل.
تصور کنید میلیونها Client فایلهایی با حجم صدها مگابایت یا چند گیگابایت را از طریق Sync Service ارسال کنند.
در این حالت Sync Service به یک Network و CPU Bottleneck تبدیل میشود.
به همین دلیل، Control Plane را از Data Plane جدا میکنیم.
اطلاعات Metadata و تصمیمگیریها از طریق Backend Serviceها انجام میشوند.
اما خود Byteهای فایل مستقیماً به Blob Storage منتقل میشوند.
برای انجام این کار، Server میتواند برای هر Chunk گمشده یک Pre-signed URL ایجاد کند.
این URL به Client اجازهی موقت میدهد که Chunk مشخصشده را مستقیماً در Blob Storage Upload کند.
در نتیجه، Application Server مجبور نیست تمام Byteهای فایل را از خودش عبور دهد.
Client A حالا Chunkهای گمشده را با استفاده از Pre-signed URL مستقیماً در Blob Storage Upload میکند.
مزیت اصلی این طراحی این است که Sync Service دیگر در مسیر انتقال دادههای حجیم قرار ندارد.
وظیفهی آن هماهنگی و Coordination است، نه جابهجایی چندین گیگابایت داده.
بعد از اینکه Chunkها با موفقیت در Storage ذخیره شدند، Backend باید متوجه شود که Upload به پایان رسیده است.
در این معماری، Blob Storage به File Service اعلام میکند که Upload کامل شده است.
این مرحله مهم است، چون صرفاً ذخیرهشدن Byteها به این معنی نیست که نسخهی جدید فایل منتشر شده است.
Metadata نیز باید Commit شود.
File Service نسخهی جدید فایل را در Metadata RDB ثبت میکند.
اینجا تفاوت بین دو نوع داده کاملاً مشخص میشود:
خود Byteهای فایل که در قالب Chunk ذخیره شدهاند.
اطلاعاتی مانند:
مسیر فایل
Version
Chunkها
Owner
وضعیت Sync
بنابراین:
Metadata در Database قرار میگیرد و File Content در Object Storage.
تا اینجا Client A فایل را تغییر داده و نسخهی جدید روی Server ثبت شده است.
اما Client B هنوز از این تغییر اطلاعی ندارد.
یک روش ساده این است که Client B دائماً از Server بپرسد:
آیا چیزی تغییر کرده است؟
اما اگر میلیونها Client هر چند ثانیه این سؤال را تکرار کنند، تعداد بسیار زیادی Request بیفایده ایجاد خواهد شد.
راهحل بهتر، استفاده از Event-Driven Architecture است.
بعد از Commit شدن نسخهی جدید، File Service یک Change Event در Message Broker منتشر میکند.
Message Broker به Sync Service روی Client B اطلاع میدهد که فایلی که Client به آن Subscribe شده، تغییر کرده است.
نکتهی مهم این است که:
Message Broker خود فایل را منتقل نمیکند.
فقط میگوید:
چیزی تغییر کرده است.
این موضوع باعث میشود مسیر Notification سبک باقی بماند.
محتوای واقعی فایل بعداً از مسیر مناسب دریافت میشود.
حالا Client B میداند که نسخهی جدیدی وجود دارد.
اما دوباره کل فایل را Download نمیکند.
Local Sync Service ابتدا وضعیت فعلی خودش را بررسی میکند و سپس از Server میخواهد تفاوت بین نسخهی محلی و نسخهی جدید را مشخص کند.
Client B Hash مربوط به Chunkهایی را که در حال حاضر روی دستگاه دارد، برای Server ارسال میکند.
Server میتواند مشخص کند:
کدام Chunkها از قبل روی Client وجود دارند.
کدام Chunkها هنوز معتبر هستند.
دقیقاً کدام Chunkها برای ساخت نسخهی جدید موردنیاز هستند.
همان اصل دوباره تکرار میشود:
ابتدا Metadata را مقایسه کن، سپس فقط دادهی موردنیاز را منتقل کن.
در این مرحله درخواست از طریق Load Balancer به یکی از Instanceهای Sync Service هدایت میشود.
Server Hashهای Client را با Metadata موجود مقایسه میکند و Diff را محاسبه میکند.
Server Diff را محاسبه کرده و برای هر Chunk موردنیاز یک Pre-signed Download URL برمیگرداند.
بنابراین Client B لازم نیست کل فایل را Download کند.
فقط Chunkهایی را دریافت میکند که برای رسیدن به نسخهی جدید نیاز دارد.
Client B میتواند Chunkها را مستقیماً از Blob Storage دریافت کند.
در یک معماری مناسب، این دادهها میتوانند از طریق CDN نیز ارائه شوند.
CDN داده را از نقطهای نزدیکتر به کاربر سرو میکند و بار مستقیم روی Storage اصلی را کاهش میدهد.
بعد از دریافت Chunkها، Client آنها را طبق Metadata کنار هم قرار میدهد و نسخهی جدید فایل را بازسازی میکند.
در نهایت Local Chunk DB نیز با وضعیت جدید بهروزرسانی میشود.
Sync کامل شد.
نکتهی اصلی این است:
Dropbox یک کامپوننت جادویی ندارد.
این سیستم مجموعهای از تصمیمهای کوچک است که باعث میشوند بار از مسیرهای گران و حساس دور شود.
Chunking باعث میشود فقط بخشهایی که تغییر کردهاند منتقل شوند.
سیستم ابتدا متوجه میشود دقیقاً چه چیزی موردنیاز است.
Pre-signed URL اجازه میدهد داده مستقیماً بین Client و Blob Storage منتقل شود.
Database برای Query و Versioning استفاده میشود و Object Storage مسئول نگهداری Byteهای فایل است.
Message Broker اجزای مختلف سیستم را از یکدیگر جدا میکند و به سایر Clientها اطلاع میدهد که تغییری رخ داده است.
Load Balancer درخواستها را بین چندین Sync Service تقسیم میکند.
این کار Latency را کاهش میدهد و بار روی Origin Storage را کمتر میکند.
در سیستمهای بزرگ، Scaling همیشه به معنی سریعتر منتقلکردن داده نیست.
خیلی وقتها بهترین طراحی این است که:
دادهای را که اصلاً نیازی به انتقال نداشته، از ابتدا منتقل نکنیم.
این همان ایدهای است که در معماری Dropbox بارها تکرار میشود:
Compare first. Move later.
در قسمتهای بعدی، سیستمهای مختلف را با همین رویکرد بررسی میکنیم:
از Requirements و Bottlenecks
تا Database، Cache، Queue و Consistency
و در نهایت Trade-offهای واقعی معماری
و در پایان، دو نکتهی کوتاه:
سعی کردم دیاگرام را طوری طراحی کنم که کسلکننده نباشد.
برای این مقاله از منابع زیر استفاده کردم:
Hello Interview — Design a File Storage Service Like Dropbox
Santosh P. — System Design of Dropbox
Educative — Grokking the System Design Interview
Educative — Grokking the Low Level Design Interview Using OOD Principles
System Design & Software Architecture: AWS + Microservices
Mastering System Design: From Basics to Cracking Interviews
#SystemDesign #SoftwareArchitecture #DistributedSystems #BackendEngineering #DropboxArchitecture