
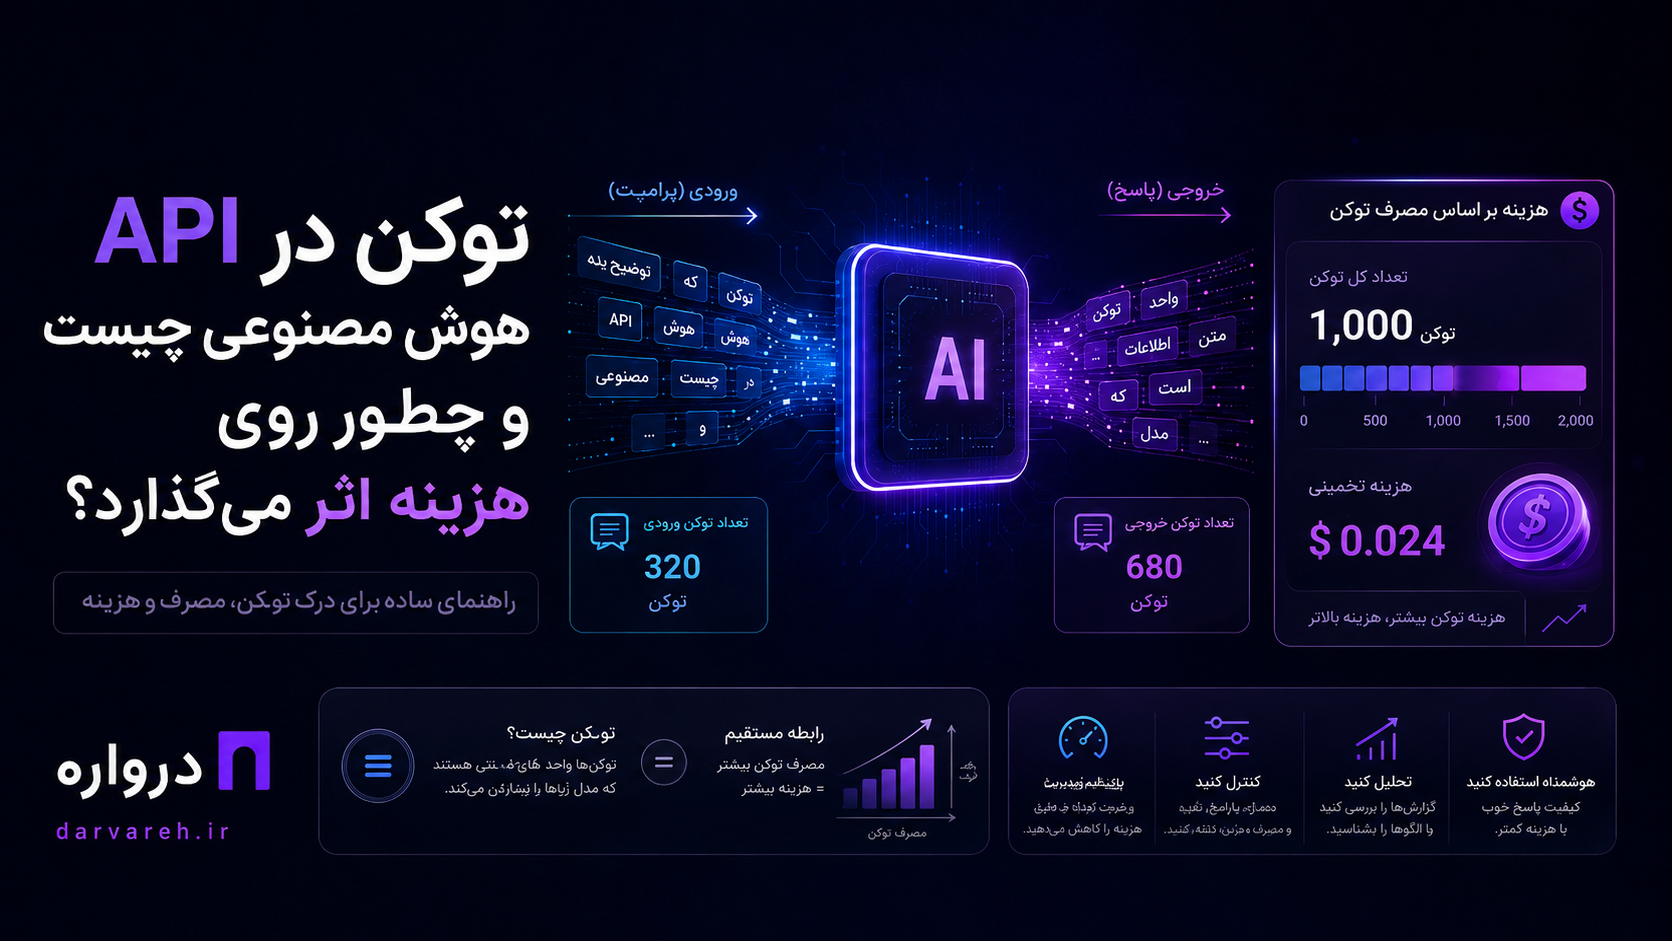
اگر از API هوش مصنوعی برای ساخت چتبات، تولید محتوا، خلاصهسازی، ترجمه، برنامهنویسی، تحلیل متن یا پاسخگویی خودکار استفاده کرده باشید، احتمالاً با واژۀ «توکن» روبهرو شدهاید.
در بیشتر سرویسهای هوش مصنوعی، هزینه فقط بر اساس تعداد پیامها محاسبه نمیشود؛ بلکه معمولاً بر اساس میزان مصرف توکن محاسبه میشود. به همین دلیل، اگر میخواهید هزینه API هوش مصنوعی را کنترل کنید، باید بدانید توکن چیست، چطور محاسبه میشود و چه عواملی باعث افزایش مصرف آن میشوند.
در این مقاله به زبان ساده توضیح میدهیم توکن در API هوش مصنوعی چیست، چه تفاوتی با کلمه و کاراکتر دارد، چرا روی هزینه اثر میگذارد و چگونه میتوان مصرف توکن را کاهش داد.
توکن واحدی است که مدلهای زبانی برای خواندن، پردازش و تولید متن از آن استفاده میکنند.
مدل هوش مصنوعی متن را دقیقاً مثل انسان، کلمهبهکلمه نمیخواند. قبل از پردازش، متن به بخشهای کوچکتری تقسیم میشود. به این بخشها «توکن» گفته میشود.
یک توکن ممکن است:
یک کلمه کامل باشد.
بخشی از یک کلمه باشد.
یک علامت نگارشی باشد.
بخشی از یک عدد باشد.
یک فاصله یا ترکیب خاصی از کاراکترها باشد.
برای مثال، یک جمله کوتاه ممکن است به چندین توکن تبدیل شود. هرچه متن طولانیتر باشد، تعداد توکنها بیشتر میشود و هرچه تعداد توکن بیشتر شود، مصرف و هزینه API هم افزایش پیدا میکند.
خیلیها در شروع فکر میکنند یک توکن یعنی یک کلمه؛ اما این تصور دقیق نیست.
در بعضی موارد، یک کلمه ممکن است یک توکن باشد. اما در موارد دیگر، یک کلمه میتواند به چند توکن تقسیم شود.
برای مثال، کلمات طولانی، واژههای ترکیبی، کدهای برنامهنویسی، آدرسهای اینترنتی، اعداد، نشانهها و متنهای چندزبانه ممکن است به توکنهای بیشتری تقسیم شوند.
بنابراین اگر یک متن ۱۰۰ کلمهای داشته باشید، الزاماً به معنی ۱۰۰ توکن نیست. ممکن است کمتر یا بیشتر باشد.
در زبان فارسی هم بهدلیل وجود نیمفاصله، پسوندها، پیشوندها، علائم نگارشی و ساختار نوشتاری، تعداد توکنها ممکن است با تعداد کلمات برابر نباشد.
مدلهای زبانی برای پردازش متن، باید آن را به شکلی عددی و قابل فهم برای ماشین تبدیل کنند. توکنسازی یکی از مراحل اصلی این فرایند است.
وقتی شما یک متن را به API ارسال میکنید، ابتدا متن به توکن تبدیل میشود. سپس مدل این توکنها را پردازش میکند و پاسخ را نیز بهصورت توکن تولید میکند. در نهایت، این توکنها دوباره به متن قابل خواندن برای انسان تبدیل میشوند.
به زبان ساده، توکنها زبان میانی بین متن انسانی و پردازش مدل هستند.
در API هوش مصنوعی، معمولاً با دو نوع توکن سروکار داریم:
توکن ورودی و توکن خروجی.
توکن ورودی یعنی متنی که شما به مدل ارسال میکنید. این متن میتواند شامل پیام کاربر، دستورالعمل سیستم، تاریخچۀ مکالمه، اطلاعات محصول، متن مقاله، دادههای پایگاه دانش یا هر محتوای دیگری باشد.
توکن خروجی یعنی پاسخی که مدل تولید میکند. هرچه پاسخ مدل طولانیتر باشد، توکن خروجی بیشتر میشود.
بنابراین هزینه معمولاً از مجموع توکنهای ورودی و خروجی تأثیر میگیرد.
برای مثال، اگر یک متن طولانی به مدل بدهید و بخواهید یک پاسخ مفصل تولید کند، هم توکن ورودی بالا میرود و هم توکن خروجی.
اما اگر ورودی را خلاصه کنید و از مدل بخواهید پاسخ کوتاه بدهد، مصرف توکن کمتر میشود.
فرض کنید یک چتبات پشتیبانی دارید و کاربر میپرسد:
«چطور میتوانم کلید API دریافت کنم؟»
اگر فقط همین سؤال را به مدل ارسال کنید، مصرف توکن کم است.
اما اگر همراه همین سؤال، اطلاعات زیر را هم در هر درخواست بفرستید:
توضیح کامل برند
تمام قوانین پاسخگویی
کل تاریخچۀ مکالمه
لیست کامل محصولات
چند صفحۀ مستندات
نمونههای متعدد پاسخ
مصرف توکن بسیار بیشتر میشود.
حتی اگر سؤال کاربر ساده باشد، ورودی طولانی باعث افزایش هزینه میشود.
به همین دلیل در طراحی سیستمهای مبتنی بر API، فقط سؤال کاربر مهم نیست؛ بلکه تمام دادههایی که همراه سؤال به مدل ارسال میشوند هم روی هزینه اثر دارند.
بسیاری از مدلهای هوش مصنوعی بر اساس تعداد توکن قیمتگذاری میشوند. یعنی هرچه متن ورودی و خروجی بیشتر باشد، هزینه هم بیشتر میشود.
معمولاً هزینه شامل این بخشهاست:
هزینۀ توکنهای ورودی
هزینۀ توکنهای خروجی
گاهی هزینۀ پردازش، کش، ابزارها یا قابلیتهای جانبی
برای مثال، اگر یک درخواست کوتاه ارسال کنید و پاسخ کوتاه بگیرید، هزینه کم خواهد بود. اما اگر یک متن طولانی ارسال کنید و پاسخ مفصل بخواهید، هزینه افزایش پیدا میکند.
به همین دلیل دو درخواست ظاهراً مشابه ممکن است هزینههای متفاوتی داشته باشند.
مثلاً این درخواست:
«برای این محصول یک عنوان کوتاه بنویس.»
هزینۀ کمی دارد.
اما این درخواست:
«این سند ۲۰ صفحهای را بخوان، تحلیل کن، خلاصه کن، ریسکها را استخراج کن، پیشنهاد بده و یک گزارش کامل بنویس.»
مصرف توکن بسیار بیشتری دارد و در نتیجه هزینه بالاتری ایجاد میکند.
بعضی کاربران فقط به طول متن ورودی توجه میکنند، اما توکن خروجی هم بسیار مهم است.
اگر از مدل بخواهید پاسخ طولانی بدهد، هزینه افزایش پیدا میکند.
برای مثال، این پرامپت خروجی زیادی تولید میکند:
«همه چیز را کامل، جامع و با جزئیات توضیح بده.»
اما این پرامپت خروجی را کنترل میکند:
«در حداکثر ۵ بولت کوتاه پاسخ بده.»
یا:
«پاسخ را در کمتر از ۱۰۰ کلمه بنویس.»
یا:
«فقط یک پاراگراف کوتاه بنویس.»
کنترل خروجی یکی از سادهترین روشهای کاهش مصرف توکن و کنترل هزینه API است.
در چتباتها، مدل معمولاً برای پاسخ بهتر به زمینۀ مکالمه نیاز دارد. به همین دلیل، بخشی از پیامهای قبلی همراه درخواست جدید ارسال میشود.
اما اگر کل تاریخچۀ مکالمه در هر درخواست ارسال شود، مصرف توکن بهسرعت بالا میرود.
برای مثال، در پیام اول شاید مصرف کم باشد. اما در پیام دهم، اگر تمام پیامهای قبلی هم ارسال شوند، هر درخواست جدید شامل حجم زیادی از متن خواهد بود.
این یعنی هرچه مکالمه طولانیتر شود، هزینه هر پیام هم ممکن است بیشتر شود.
برای حل این مشکل، میتوان:
فقط چند پیام آخر را ارسال کرد.
پیامهای قدیمی را خلاصه کرد.
اطلاعات مهم را جداگانه ذخیره کرد.
بخشهای غیرضروری مکالمه را حذف کرد.
برای هر درخواست فقط زمینۀ مرتبط را فرستاد.
مدیریت تاریخچۀ مکالمه یکی از مهمترین کارها برای کاهش هزینه چتباتهای هوش مصنوعی است.
مصرف توکن در زبانهای مختلف یکسان نیست. ساختار نوشتاری، نوع کاراکترها، فاصلهگذاری، نیمفاصله، علائم نگارشی و نحوۀ توکنسازی مدل میتواند باعث شود یک متن فارسی نسبت به متن انگلیسی مشابه، تعداد توکن متفاوتی داشته باشد.
در فارسی، مواردی مثل نیمفاصله، پسوندها، پیشوندها، کلمات ترکیبی، اعداد فارسی، علائم نگارشی و نوشتار غیراستاندارد میتوانند روی توکنسازی اثر بگذارند.
برای مثال، ممکن است دو متن از نظر تعداد کلمات مشابه باشند، اما بهدلیل تفاوت در نگارش، تعداد توکن متفاوتی داشته باشند.
به همین دلیل برای محصولات فارسی، تست واقعی مصرف توکن اهمیت زیادی دارد. بهتر است مدلهای مختلف را با متنهای فارسی واقعی آزمایش کنید و فقط به تخمینهای عمومی تکیه نکنید.
کدها معمولاً میتوانند مصرف توکن بالایی داشته باشند، چون شامل نام متغیرها، علامتها، فاصلهها، تورفتگیها، براکتها، رشتهها، توضیحات و ساختارهای خاص هستند.
برای مثال، ارسال یک فایل کد طولانی به مدل میتواند توکن زیادی مصرف کند؛ مخصوصاً اگر همراه آن از مدل بخواهید توضیح کامل، اصلاح، بازنویسی یا تست تولید کند.
برای کاهش هزینه در کاربردهای برنامهنویسی بهتر است:
فقط بخش مرتبط کد را ارسال کنید.
فایلهای بزرگ را کامل نفرستید.
خطا و هدف را دقیق توضیح دهید.
خروجی را محدود کنید.
از مدل قوی فقط برای بخشهای پیچیده استفاده کنید.
Context Window یا پنجرۀ زمینه، حداکثر تعداد توکنی است که مدل میتواند در یک درخواست پردازش کند.
این مقدار شامل توکنهای ورودی و گاهی بخشی از ظرفیت خروجی هم میشود. هر مدل یک ظرفیت مشخص دارد. بعضی مدلها متنهای کوتاهتر را پشتیبانی میکنند و بعضی مدلها میتوانند اسناد بسیار طولانیتری را پردازش کنند.
اگر مجموع متن ورودی، تاریخچۀ مکالمه، دستورالعملها و خروجی مورد انتظار از محدودیت مدل بیشتر شود، ممکن است درخواست خطا بدهد یا لازم باشد متن کوتاهتر شود.
بنابراین Context Window فقط روی توانایی مدل اثر ندارد؛ روی هزینه هم اثر دارد. چون هرچه متن بیشتری داخل زمینه قرار دهید، توکن بیشتری مصرف میشود.
نه لزوماً.
مدلهای مختلف ممکن است از روشهای متفاوتی برای توکنسازی استفاده کنند. به همین دلیل، یک متن ثابت ممکن است در دو مدل مختلف تعداد توکن متفاوتی داشته باشد.
همچنین قیمت توکن در مدلهای مختلف یکسان نیست. ممکن است یک مدل برای هر میلیون توکن ارزانتر باشد و مدل دیگر گرانتر. علاوه بر آن، قیمت توکن ورودی و خروجی هم ممکن است متفاوت باشد.
بنابراین هزینه نهایی فقط به تعداد توکن بستگی ندارد؛ به مدل انتخابشده هم بستگی دارد.
به بیان ساده:
هزینه نهایی = تعداد توکن × قیمت مدل
البته در عمل ممکن است جزئیات بیشتری هم وجود داشته باشد، اما این فرمول ساده کمک میکند منطق کلی هزینه را بفهمیم.
برای کاهش مصرف توکن و کنترل هزینه API هوش مصنوعی، چند روش عملی وجود دارد.
بهجای ارسال متنهای طولانی و مبهم، فقط اطلاعات لازم را به مدل بدهید.
مثلاً بهجای اینکه چند صفحه توضیح بدهید، خلاصۀ هدف، محدودیتها و دادههای ضروری را ارسال کنید.
در پرامپت مشخص کنید پاسخ چقدر طولانی باشد.
مثلاً:
«در حداکثر ۱۰۰ کلمه پاسخ بده.»
یا:
«فقط ۵ پیشنهاد کوتاه بده.»
یا:
«خروجی را در یک پاراگراف بنویس.»
در چتباتها لازم نیست همیشه کل مکالمه ارسال شود. میتوانید پیامهای قدیمی را خلاصه کنید یا فقط بخشهای مرتبط را نگه دارید.
اگر در هر درخواست یک متن ثابت طولانی ارسال میکنید، آن را خلاصهتر و ساختاریافتهتر کنید.
اگر بخشهایی از پرامپت ثابت و تکراری هستند، Prompt Caching میتواند کمک کند هزینه پردازش تکراری کاهش پیدا کند.
اگر کاربران سؤالهای مشابه میپرسند، میتوانید پاسخهای پرتکرار را ذخیره کنید و همیشه به مدل درخواست جدید نفرستید.
همیشه به قویترین مدل نیاز ندارید. برای کارهای ساده از مدلهای اقتصادیتر استفاده کنید و مدلهای قویتر را برای کارهای مهمتر نگه دارید.
اگر سند بسیار طولانی دارید، بهتر است آن را به بخشهای کوچکتر تقسیم کنید، هر بخش را جداگانه پردازش کنید و سپس خلاصۀ نهایی بسازید.
پرامپت مبهم باعث میشود مدل پاسخ طولانیتر یا نامرتبط تولید کند. پرامپت دقیق معمولاً خروجی کوتاهتر و قابل استفادهتری میدهد.
بدون گزارش مصرف، نمیتوان هزینه را کنترل کرد. باید بدانید کدام مدل، کدام کاربر، کدام قابلیت یا کدام پرامپت بیشترین توکن را مصرف میکند.
پرامپت پرهزینه:
«این متن را کامل بررسی کن و هر چیزی که لازم است بگو. اگر پیشنهادی داری کامل توضیح بده و همه نکات ممکن را بنویس.»
این پرامپت مبهم است و احتمالاً خروجی طولانی تولید میکند.
پرامپت بهینه:
«این متن را از نظر نگارش بررسی کن. فقط ۵ ایراد مهم را بگو و برای هرکدام یک پیشنهاد کوتاه بده. پاسخ کمتر از ۱۵۰ کلمه باشد.»
در پرامپت دوم، هدف مشخص است، تعداد موارد محدود شده و طول پاسخ کنترل شده است. در نتیجه هم خروجی کاربردیتر میشود و هم مصرف توکن کاهش پیدا میکند.
فرض کنید یک چتبات پشتیبانی برای سایت خود ساختهاید.
اگر در هر پیام، کل راهنمای محصول، همۀ قوانین شرکت، تمام تاریخچۀ مکالمه و توضیحات کامل خدمات را به مدل بفرستید، هزینه بالا میرود.
راه بهتر این است که:
سؤال کاربر تحلیل شود.
فقط بخش مرتبط از راهنما انتخاب شود.
چند پیام آخر مکالمه ارسال شود.
دستورالعملها کوتاه و ثابت باشند.
پاسخ مدل محدود شود.
به این ترتیب، چتبات همچنان پاسخ خوب میدهد، اما مصرف توکن بسیار کمتر میشود.
در تولید محتوا هم مصرف توکن اهمیت زیادی دارد.
اگر برای هر پست، یک پرامپت طولانی با توضیحات تکراری برند، لحن، مخاطب، خدمات، مثالها و قوانین ارسال شود، هزینه بالا میرود.
برای کاهش هزینه، میتوانید:
راهنمای برند را خلاصه کنید.
فقط اطلاعات مربوط به همان محتوا را ارسال کنید.
طول خروجی را مشخص کنید.
برای پیشنویس اولیه از مدل اقتصادیتر استفاده کنید.
برای ویرایش نهایی از مدل قویتر استفاده کنید.
این روش مخصوصاً برای تولید انبوه محتوا بسیار مؤثر است.
مصرف توکن فقط یک طرف ماجراست. طرف دیگر، قیمت مدل است.
ممکن است دو مدل برای یک درخواست دقیقاً تعداد توکن مشابهی مصرف کنند، اما قیمت نهایی آنها متفاوت باشد.
برای مثال، یک مدل قویتر ممکن است برای هر میلیون توکن چند برابر یک مدل اقتصادی هزینه داشته باشد. بنابراین اگر درخواستهای ساده را به مدل قوی ارسال کنید، هزینه بیدلیل بالا میرود.
بهتر است مدلها را بر اساس نوع کار انتخاب کنید:
کارهای ساده: مدل اقتصادی و سریع کارهای متوسط: مدل متعادل کارهای حساس یا پیچیده: مدل قویتر
این ساختار کمک میکند بهترین نسبت کیفیت به هزینه را پیدا کنید.
Auto Router یا مسیریاب هوشمند میتواند بر اساس نوع درخواست، مدل مناسب را انتخاب کند.
برای مثال، اگر درخواست کوتاه و ساده باشد، آن را به مدل ارزانتر میفرستد. اگر درخواست طولانی، تخصصی یا حساس باشد، مدل قویتری انتخاب میشود.
این روش باعث میشود همۀ درخواستها به گرانترین مدل ارسال نشوند.
Auto Router میتواند در کنترل هزینه API نقش مهمی داشته باشد، چون انتخاب مدل را بر اساس نیاز واقعی هر درخواست انجام میدهد.
Fallback یعنی اگر مدل اصلی خطا داد، کند شد یا کیفیت مناسب نداشت، درخواست به مدل جایگزین ارسال شود.
از نظر هزینه، Fallback باید با دقت طراحی شود. اگر همیشه ابتدا از مدل ارزان استفاده کنید و سپس بدون دلیل درخواست را به مدل گرانتر هم بفرستید، ممکن است هزینه دو برابر شود.
اما اگر Fallback فقط در صورت خطا، محدودیت یا نیاز واقعی فعال شود، میتواند پایداری سرویس را افزایش دهد بدون اینکه هزینه را بیدلیل بالا ببرد.
بنابراین Fallback باید هوشمندانه و کنترلشده باشد.
درواره بهعنوان پلتفرم دسترسی به مدلهای مختلف هوش مصنوعی با API، به تیمهای فنی کمک میکند انتخاب مدل و مدیریت هزینه را سادهتر انجام دهند.
وقتی از طریق یک API به مدلهای مختلف دسترسی دارید، میتوانید برای هر نوع درخواست، مدل مناسبتری انتخاب کنید. این موضوع مستقیماً روی هزینه توکن اثر میگذارد.
برای مثال:
برای درخواستهای ساده از مدل اقتصادیتر استفاده کنید.
برای تحلیلهای مهم از مدل قویتر استفاده کنید.
برای کاربردهای فارسی، مدلهای مختلف را تست کنید.
برای کاهش ریسک، Fallback تعریف کنید.
برای کنترل هزینه، مصرف مدلها را مقایسه کنید.
برای محصول خود، سیاست مصرف هوشمندانه طراحی کنید.
درواره کمک میکند بهجای وابستگی به یک مدل، از یک مسیر واحد به مدلهای مختلف دسترسی داشته باشید و بر اساس کیفیت، سرعت و هزینه تصمیم بهتری بگیرید.
در بسیاری از پروژهها، هزینه API بهدلیل چند اشتباه ساده بالا میرود.
گاهی سیستم اطلاعات زیادی به مدل میدهد که برای پاسخ لازم نیست.
این کار معمولاً هزینۀ زیادی ایجاد میکند، مخصوصاً وقتی درخواستها ساده باشند.
اگر طول پاسخ را مشخص نکنید، مدل ممکن است بیش از نیاز متن تولید کند.
در چتباتها، ارسال کل مکالمه در هر درخواست میتواند هزینه را بهسرعت افزایش دهد.
پاسخها یا پرامپتهای تکراری نباید همیشه از صفر پردازش شوند.
اگر ندانید کجا توکن مصرف میشود، نمیتوانید هزینه را کاهش دهید.
اگر در حال ساخت محصول واقعی با API هوش مصنوعی هستید، بهتر است از همان ابتدا سیاست مدیریت توکن داشته باشید.
این سیاست میتواند شامل موارد زیر باشد:
تعیین حداکثر طول پیام کاربر
تعیین حداکثر طول پاسخ مدل
محدودیت توکن برای هر پلن کاربری
انتخاب مدل بر اساس نوع درخواست
خلاصهسازی تاریخچۀ مکالمه
کش پاسخهای پرتکرار
مانیتورینگ مصرف مدلها
هشدار برای مصرف غیرعادی
محدودیت استفاده از مدلهای گران
گزارش هزینه برای هر قابلیت محصول
اگر این موارد از ابتدا طراحی نشوند، بعداً کنترل هزینه سختتر میشود.
توکن یکی از مهمترین مفاهیم در استفاده از API هوش مصنوعی است. اگر ندانید توکن چیست و چگونه مصرف میشود، کنترل هزینه API دشوار خواهد بود.
توکن واحد پردازش متن در مدلهای زبانی است. هم متن ورودی و هم پاسخ خروجی مدل به توکن تبدیل میشوند و معمولاً هزینه API بر اساس تعداد همین توکنها محاسبه میشود.
برای کاهش مصرف توکن باید:
ورودیها را کوتاه و مرتبط نگه دارید.
خروجی مدل را محدود کنید.
تاریخچۀ مکالمه را مدیریت کنید.
اطلاعات ثابت را خلاصه یا کش کنید.
مدل مناسب هر کار را انتخاب کنید.
درخواستهای تکراری را ذخیره کنید.
مصرف توکن را مانیتور کنید.
از Auto Router و Fallback به شکل هوشمندانه استفاده کنید.
در نهایت، هدف فقط کم کردن مصرف نیست؛ هدف این است که بهترین تعادل بین کیفیت، سرعت و هزینه را پیدا کنید.
درواره با فراهم کردن دسترسی به مدلهای مختلف از طریق یک API، این امکان را فراهم میکند که تیمهای فنی مدل مناسب هر کاربرد را انتخاب کنند و هزینه API هوش مصنوعی را بهتر مدیریت کنند.
درواره؛ یک API برای دسترسی به مدلهای مختلف هوش مصنوعی.
توکن واحدی است که مدلهای زبانی برای پردازش متن از آن استفاده میکنند. متن ورودی و خروجی مدل به توکن تبدیل میشود و معمولاً هزینه API بر اساس تعداد توکنها محاسبه میشود.
خیر. یک توکن میتواند یک کلمه، بخشی از یک کلمه، علامت نگارشی یا ترکیبی از کاراکترها باشد. بنابراین تعداد توکنها همیشه با تعداد کلمات برابر نیست.
توکن ورودی مربوط به متنی است که شما به مدل ارسال میکنید. توکن خروجی مربوط به پاسخی است که مدل تولید میکند.
در زبان فارسی، نیمفاصله، علائم نگارشی، ساختار کلمات و نحوۀ نوشتار میتواند روی توکنسازی اثر بگذارد. بنابراین بهتر است مصرف واقعی متنهای فارسی در مدلهای مختلف بررسی شود.
با کوتاه کردن ورودی، محدود کردن خروجی، مدیریت تاریخچۀ مکالمه، کش کردن پاسخهای تکراری، انتخاب مدل مناسب و بهینهسازی پرامپت میتوان مصرف توکن را کاهش داد.
بله. مدلهای مختلف قیمت متفاوتی برای توکن دارند. حتی اگر تعداد توکن یکسان باشد، هزینه نهایی میتواند بسته به مدل متفاوت باشد.
درواره با فراهم کردن دسترسی به مدلهای مختلف از طریق یک API، به شما امکان میدهد برای هر نوع درخواست مدل مناسبتری انتخاب کنید و مصرف و هزینه API را بهتر مدیریت کنید.

