
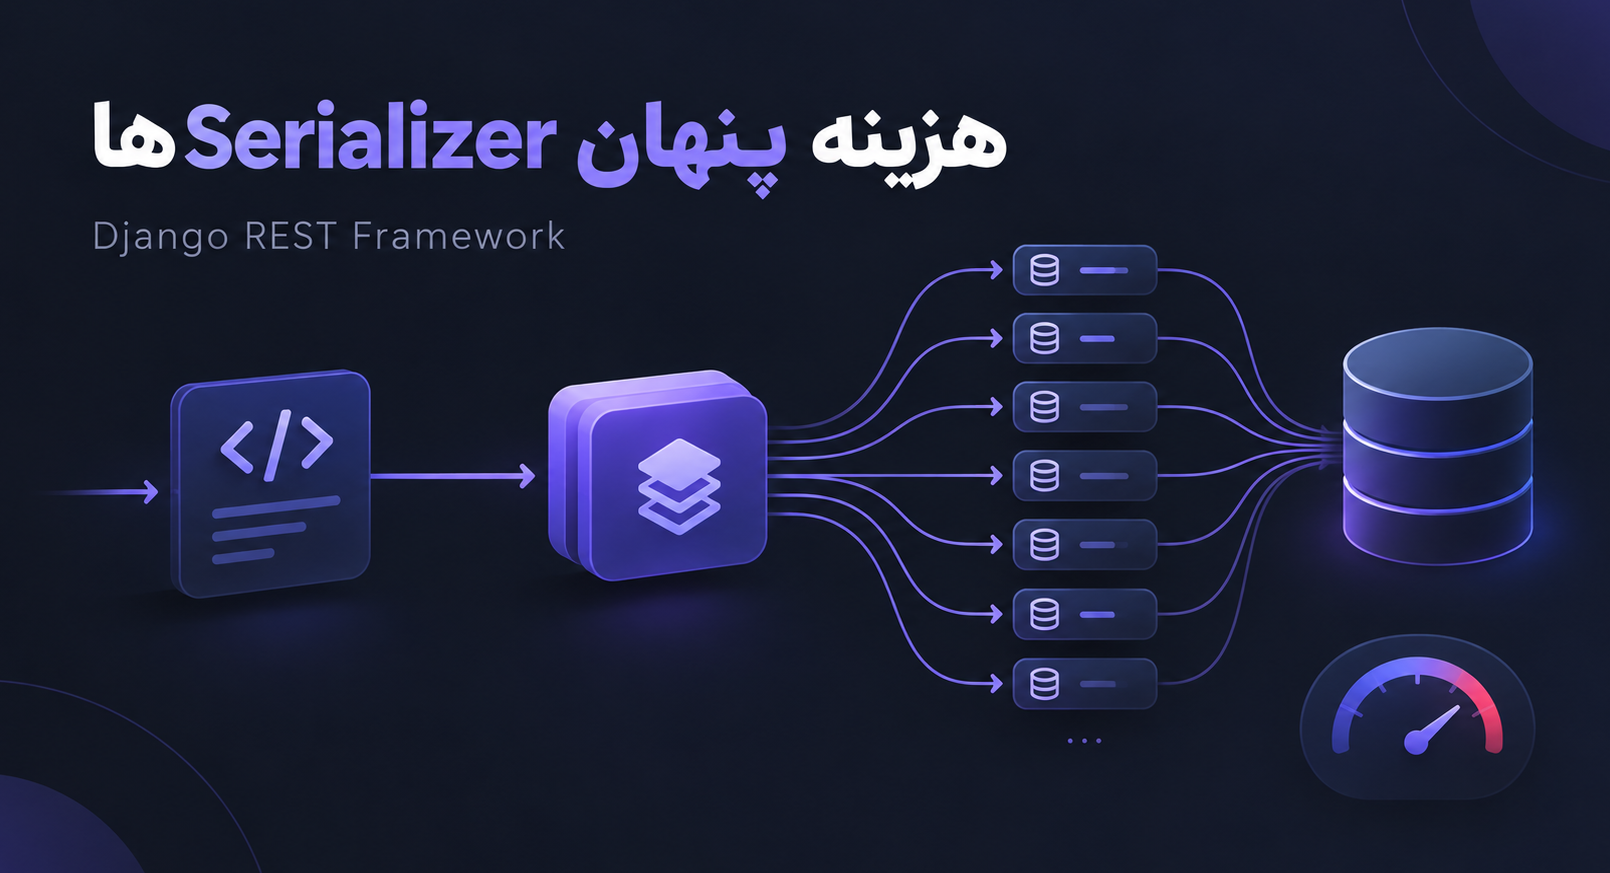
تا حالا برایتان پیش آمده که یک API در Django داشته باشید که Query آن خیلی سریع اجرا میشود، اما خود API همچنان کند باشد؟
PostgreSQL مشکلی ندارد.
Queryها سریع هستند.
View هم ظاهراً کار خاصی انجام نمیدهد.
اما Response همچنان چند صد میلیثانیه یا حتی چند ثانیه طول میکشد.
یکی از جاهایی که معمولاً در بررسی Performance فراموش میشود، Serializer است.
در Django REST Framework، Serializer فقط وظیفه تبدیل Object به JSON را ندارد. ممکن است هنگام Serialization، Query جدید اجرا شود، Relationshipها خوانده شوند، محاسبات Python انجام شوند و حتی Serializerهای تو در تو باعث اجرای Queryهای بیشتری شوند.
و اینجاست که مشکلات Performance شروع میشوند.
معمولاً معماری را اینطور تصور میکنیم:
Database → Serializer → JSON Response
پس طبیعی است که فکر کنیم Serializer هزینه زیادی ندارد.
اما فرض کنید چنین Serializerای داریم:
class VehicleSerializer(serializers.ModelSerializer):
    customer_name = serializers.SerializerMethodField()

    class Meta:
        model = Vehicle
        fields = (
            "id",
            "plate_number",
            "customer_name",
        )

    def get_customer_name(self, obj):
        return obj.customer.name
کد کاملاً ساده و منطقی به نظر میرسد.
اما یک سؤال مهم وجود دارد:
obj.customer از قبل Load شده است؟
اگر نه، Django ممکن است برای دسترسی به customer یک Query جدید اجرا کند.
حالا اگر ۱۰۰ خودرو داشته باشیم:
1 Query   → دریافت خودروها
100 Query → دریافت Customerها

مجموع: 101 Query
این همان مشکل معروف N+1 Query است.
مشکل اینجاست که در ظاهر، هیچ Queryای داخل Serializer نوشته نشده است.
اما Serializer باعث اجرای آن شده است.
SerializerMethodField یکی از قابلیتهای بسیار کاربردی Django REST Framework است.
اما استفاده نادرست از آن میتواند Performance API را بهشدت کاهش دهد.
مثلاً:
class ServiceSerializer(serializers.ModelSerializer):
    last_service = serializers.SerializerMethodField()

    def get_last_service(self, obj):
        return (
            Service.objects
            .filter(
                ownership=obj.ownership,
            )
            .order_by("-created_at")
            .first()
        )
این کد برای هر Object یک Query اجرا میکند.
اگر ۵۰۰ Service را Serialize کنیم:
1 Query
+
500 Query
=
501 Query
کد درست کار میکند.
اما درست کار کردن با Performance خوب یکسان نیست.
یکی از مهمترین نکات در بهینهسازی Django API این است:
Serializer نباید دادهای را کشف کند که QuerySet میتوانسته از قبل آماده کند.
به جای اینکه برای هر Object یک Query جداگانه اجرا کنیم، میتوانیم داده را در QuerySet آماده کنیم.
برای مثال با استفاده از Subquery:
from django.db.models import OuterRef, Subquery

last_service = Service.objects.filter(
    ownership=OuterRef("ownership"),
).order_by("-created_at")

queryset = Vehicle.objects.annotate(
    last_service_id=Subquery(
        last_service.values("id")[:1]
    )
)
حالا دیتابیس میتواند این اطلاعات را در همان Query اصلی آماده کند.
در نتیجه Serializer سادهتر میشود:
class VehicleSerializer(serializers.ModelSerializer):
    last_service_id = serializers.IntegerField(
        read_only=True,
    )

    class Meta:
        model = Vehicle
        fields = (
            "id",
            "plate_number",
            "last_service_id",
        )
یعنی به جای:
Database
   ↓
Serializer
   ↓
Query
   ↓
Query
   ↓
Query
به چیزی شبیه این میرسیم:
Database
   ↓
Optimized QuerySet
   ↓
Annotation
   ↓
Serializer
   ↓
JSON
اگر با Django کار میکنید، احتمالاً بارها با این دو متد روبهرو شدهاید:
select_related()
prefetch_related()
اما استفاده درست از آنها اهمیت زیادی دارد.
برای Relationshipهایی مثل:
ForeignKey
OneToOneField
معمولاً از select_related() استفاده میکنیم.
مثلاً:
vehicles = Vehicle.objects.select_related(
    "customer",
)
در این حالت Django میتواند اطلاعات Customer را با استفاده از SQL JOIN همراه با Vehicle دریافت کند.
اما برای Relationshipهایی مثل:
ManyToManyField
Reverse ForeignKey
معمولاً prefetch_related() مناسبتر است.
مثلاً:
services = Service.objects.prefetch_related(
    "products",
)
یک قانون ساده برای به خاطر سپردن:
ForeignKey / OneToOne
        ↓
select_related()

ManyToMany / Reverse FK
        ↓
prefetch_related()
Nested Serializerها بسیار کاربردی هستند.
مثلاً:
class ProductSerializer(serializers.ModelSerializer):
    class Meta:
        model = Product
        fields = (
            "id",
            "name",
        )


class ServiceSerializer(serializers.ModelSerializer):
    products = ProductSerializer(
        many=True,
    )

    class Meta:
        model = Service
        fields = (
            "id",
            "products",
        )
در نگاه اول مشکلی وجود ندارد.
اما تصور کنید API شما ۱۰۰۰ Service برمیگرداند.
هر Service تعدادی Product دارد.
اگر Relationshipها به درستی Prefetch نشده باشند، تعداد Queryها میتواند بهشدت افزایش پیدا کند.
و اگر این ساختار عمیقتر شود:
Service
 ├── Customer
 │    └── Address
 └── Products
      └── Category
مشکل پیچیدهتر میشود.
یک JSON ساده ممکن است پشت صحنه تعداد زیادی Query ایجاد کرده باشد.
یکی دیگر از اشتباهات رایج این است که یک Serializer را برای تمام Endpointها استفاده کنیم.
مثلاً:
VehicleSerializer
هم برای:
List
Detail
Create
Update
Search
Admin
استفاده شود.
با گذشت زمان Serializer بزرگ و پیچیده میشود.
بهتر است بر اساس نیاز Endpoint، Serializerهای متفاوت داشته باشیم.
مثلاً برای List:
class VehicleListSerializer(serializers.ModelSerializer):
    class Meta:
        model = Vehicle
        fields = (
            "id",
            "plate_number",
            "color",
        )
اما برای Detail میتوانیم اطلاعات بیشتری برگردانیم:
class VehicleDetailSerializer(serializers.ModelSerializer):
    customer = CustomerSerializer()

    class Meta:
        model = Vehicle
        fields = (
            "id",
            "plate_number",
            "color",
            "customer",
        )
این کار فقط برای تمیزتر شدن Code نیست.
میتواند مستقیماً روی Performance API تأثیر بگذارد.
یکی از اشتباهات دیگر، برگرداندن حجم زیادی از اطلاعات در هر Response است.
مثلاً:
{
  "id": 1,
  "customer": {
    "id": 10,
    "name": "...",
    "phone": "...",
    "vehicles": [],
    "services": [],
    "invoices": [],
    "payments": []
  }
}
ممکن است چنین Responseای از نظر Frontend جذاب باشد.
اما هر Relationship هزینه دارد.
هزینه میتواند شامل این موارد باشد:
Queryهای بیشتر
Serialization بیشتر
مصرف Memory بیشتر
Response بزرگتر
انتقال داده بیشتر
پردازش بیشتر در Frontend
یک API خوب قرار نیست همه چیزهایی که Database میداند را برگرداند.
باید چیزی را برگرداند که Client واقعاً نیاز دارد.
یکی از بدترین اشتباهات در Performance Optimization این است که بر اساس حدس عمل کنیم.
مثلاً:
«فکر کنم Serializer کند است.»
شاید.
اما باید اندازهگیری کنیم.
برای بررسی Performance یک API، مواردی مثل اینها مهم هستند:
تعداد Queryها
مدت اجرای Queryها
زمان Serialization
زمان کل Request
حجم Response
مصرف CPU و Memory
ابزارهایی مثل Django Debug Toolbar و Django Silk میتوانند برای پیدا کردن Queryهای تکراری و Requestهای کند بسیار مفید باشند.
چون همیشه Database مشکل اصلی نیست.
مثلاً:
Database:       40 ms
View Logic:     30 ms
Serialization: 650 ms
JSON Rendering: 80 ms

Total:          800 ms
در این شرایط اگر PostgreSQL را از ۴۰ میلیثانیه به ۳۰ میلیثانیه برسانیم، هنوز مشکل اصلی باقی است.
مشکل اصلی Serialization است.
وقتی یک API در Django REST Framework کند میشود، این موارد را بررسی کنید:
چند Query برای تولید Response اجرا میشود؟
آیا داخل get_<field_name>() دیتابیس Query میشود؟
آیا کدی مثل این دارید؟
obj.customer
obj.owner
obj.category
obj.products.all()
برای ForeignKey و OneToOneField آیا Relationshipها به شکل مناسب Load شدهاند؟
برای ManyToMany و Reverse Relationshipها چطور؟
آیا میتوان محاسبهای را به جای Python در Database انجام داد؟
آیا Frontend واقعاً به تمام این اطلاعات نیاز دارد؟
آیا List Endpoint واقعاً به همان اطلاعات Detail Endpoint نیاز دارد؟
بعد از تغییرات، دوباره Performance را اندازه بگیرید.
Before
   ↓
Optimize
   ↓
Measure Again
Serializerهای Django REST Framework ذاتاً کند نیستند.
مشکل معمولاً نحوه استفاده ما از آنهاست.
یک Serializer زمانی میتواند گران شود که:
بارها Query اجرا کند.
به Relationshipهای Load نشده دسترسی پیدا کند.
محاسبات سنگین Python انجام دهد.
Nested Serializerهای زیادی داشته باشد.
اطلاعات غیرضروری برگرداند.
دسترسی به Database را داخل Methodها پنهان کند.
در بسیاری از مواقع، بهترین راهحل این نیست که Serializer را تغییر دهیم.
بلکه باید QuerySet پشت Serializer را بهینه کنیم.
معماری ایدهآلتر چیزی شبیه این است:
Request
   ↓
View
   ↓
Optimized QuerySet
   ↓
Database
   ↓
Serializer
   ↓
Minimal JSON Response
نه اینکه:
Request
   ↓
View
   ↓
Huge QuerySet
   ↓
Serializer
   ↓
Query
   ↓
Query
   ↓
Query
   ↓
N+1
   ↓
Slow API
دفعه بعد که یک API در Django REST Framework کند شد، فقط SQL را بررسی نکنید.
چیزی که بعد از اجرای QuerySet اتفاق میافتد را هم بررسی کنید.
ممکن است Query دیتابیس شما فقط ۵۰ میلیثانیه زمان ببرد، اما Serializer چند صد میلیثانیه دیگر به زمان Response اضافه کند.
پس اگر با Django و Django REST Framework کار میکنید، همیشه این سه مورد را کنار هم ببینید:
QuerySet + Database + Serializer
بهینهسازی واقعی زمانی اتفاق میافتد که هر سه را با هم بررسی کنید.
من نسخه کاملتر و فنیتر این موضوع، همراه با مثالهای بیشتر درباره select_related، prefetch_related، Subquery، SerializerMethodField و N+1 Query را در سایت شخصیام منتشر کردهام!
اگر با Django API کار میکنید، پیشنهاد میکنم قبل از اینکه یک Serializer بزرگتر بنویسید، اول ببینید دقیقاً چه چیزی پشت آن در حال Query شدن است.

