
بچه هایی که با Database زیاد سر و کار دارن خیلی با این اصطلاحات برخورد میکنن. ممکنه این سوال پیش بیاد که پس فرقش با UTF-32 چیه؟ خوب بهتره یک بار برای همیشه تکلیف خودمون رو با UTF-8 روشن کنیم.
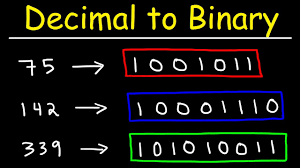
کامپیوتر که زبون آدم سرش نمیشه! یعنی منظورم اینه که هر چی Data میخاد ذخیره کنه به صورت Binary (بچه ها منظور از Binary همون نمایش ۰ و ۱ عه. مثلا 010000101 یک مقدار Binary هست) ذخیره میکنه. خوب ما آدم ها عادت داریم که اعداد رو در مبنای ۱۰ بنویسیم. مثلا ۴۷ یعنی ۴ ضربدر در ۱۰ به علاوه ۷. حالا میشه با تقسیم های متوالی هر عددی در مبنای ۱۰ رو به مقدار متناظرش در مبنای ۲ (یا به عبارتی مقدار Binary اش) تبدیل کرد. این از این! ولی کامپیوتر زبون بسته چطوری باید مقادیری مثل G یا مثلا # رو ذخیره کنه؟! G رو که نمیشه به مبنای ۲ تبدیل کرد!
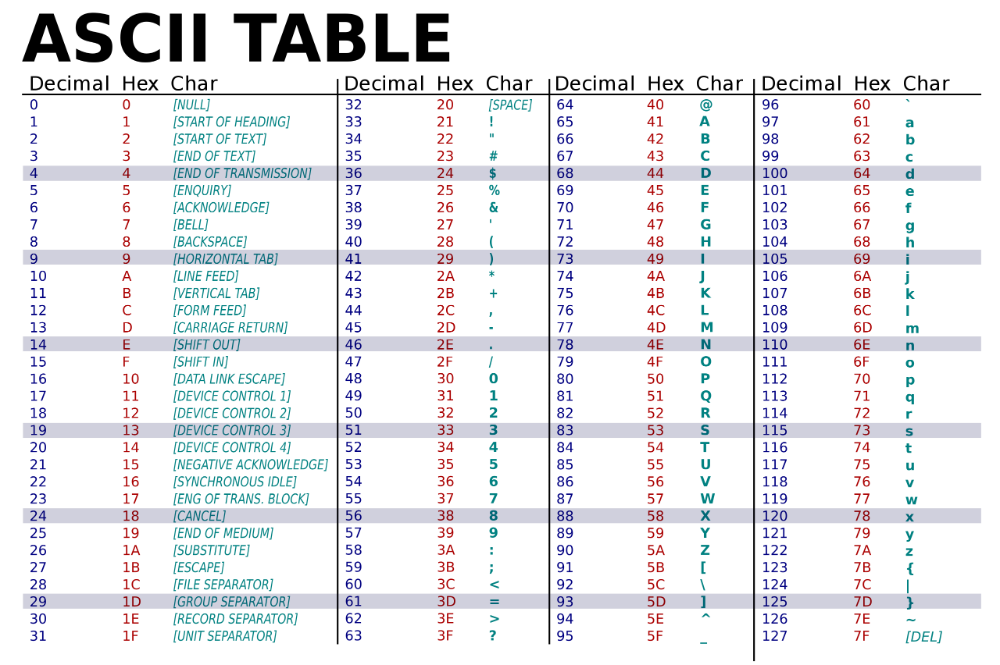
غصه نداره. این جا بود که تصمیم گرفتن به هر حرفی یک عدد در مبنای ۱۰ اختصاص بدن و بعد اون عدد در مبنای ۱۰ رو به مبنای ۲ ببرن تا رایانه بتونه ذخیره کنه. بعد از مدتی آمریکایی ها استاندارد معروف ASCII رو درست کردن که دیگه همه از اون تبعیت کنن. مثلا تو استاندارد ASCII مقداری که برای B در نظر گرفته میشه ۶۶ عه. ASCII خیلی عالی بود و هست ولی مشکل اصلیش اینه که خیلی کاراکتر های کمی رو پوشش میده. صرفا حروف لاتین، ارقام لاتین و چند تا نشانه و یک سری خرت و پرت دیگه. اگه قرار باشه کاراکتر های پیچیده تری مثل غ و 的 و حتی emoji هایی مثل ? رو بخایم ذخیره کنیم چی؟
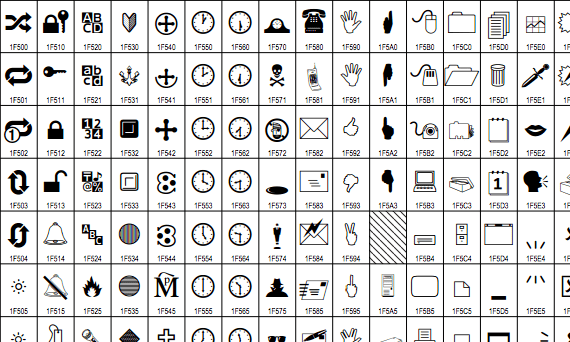
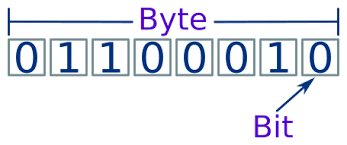
خوب این طوری باید برای غ و 的 و امثالهم نیز یک عدد در مبنای ۱۰ در نظر بگیریم و همون داستان قبلی رو تکرار کنیم. یعنی یک جورایی ASCII رو توسعه اش بدیم. این جا بود که اومدن و استاندارد Unicode رو درست کردن. یک استاندارد بین المللی که برای هر کاراکتر در هر زبانی و کلی چیزای دیگه عدد استاندارد معرفی میکنه. همون طوری که میدونی تو رایانه واحد ذخیره اطلاعات Byte هست که هر Byte از ۸ تا bit درست شده. به عبارتی در هر Byte نهایتا تا عدد ۲۵۵ رو می تونیم ذخیره کنیم (یعنی 2 به توان ۸ منفی ۱ چون ۰ هم در نظر گرفتیم). بذار این طوری بگم رایانه دوست داره برای هر کاراکتر یک Byte در نظر بگیره (یعنی ۸ بیت)
با اعداد ۰ تا ۲۵۵ اکثر کاراکتر های اصلی و یه سری چیزای دیگه رو میشه پوشش داد. ولی باز هم به بازه وسیع تری نیاز داریم تا بتونیم مثلا کاراکتر های چینی رو هم کد کنیم (یعنی عدد استاندارد در مبنای ۱۰ بهشون اختصاص بدیم). این جاست که گفتن خوب ایرادی نداره UTF-32 رو بیاریم. یعنی چی؟ یعنی این که از ۰ تا ۲ به توان ۳۲ منفی ۱ بازه در نظر بگیریم و هر کاراکتر ممکنی در جهان رو برابر یک عدد در نظر بگیریم. ولی آخه اینم مشکل داره! میگی چطوری؟ وقتی اکثر قریب به اتفاق اینترنت و Data و زبان های برنامه نویسی و خلاصه هر چه و هر چه به زبان انگلیسی عه (که توی همون ASCII هم حتی جا میشد) چرا بیایم و ۳۲ تا bit رو اشغال کنیم برای B که میشه ۶۶ و همون ۸ تا بیت هم براش زیاده!؟ یعنی اگه قرار باشه از UTF-32 استفاده کنیم همه کاراکتر ها رو میشه کد کرد ولی حافظه خیلی زیادی الکی مصرف میشه در حالی که اکثر اوقات اصلا نیازی به ۳۲ تا خونه نیست و از طرف دیگری اگه از همون ۸ تا بیت معمولی خودمون استفاده کنیم مصرف حافظه به شدت کم میشه ولی دیگه نمیشه همه چی رو کد کرد!
واسه همین اومدن گفتن که واحد ذخیره مون ۱۶ تا بیت باشه و اگه کاراکتری کدش بیشتر از ۲ به توان ۱۶ منفی ۱ بود تقسیمش کنیم به ۲ تا عدد جدا که مجموعشون بشه همون عدد اولی و هر کدوم از اون عدد کوچیک ها رو توی همون واحد های ۱۶ بیتی ذخیره کنیم و بعدش بچسبونیم به هم. این شد که UTF-16 معرفی شد. ولی هنوزم UTF-16 اصراف حافظه بود. به همون دلیل قبلی. واسه همین رفتن سمت UTF-8!
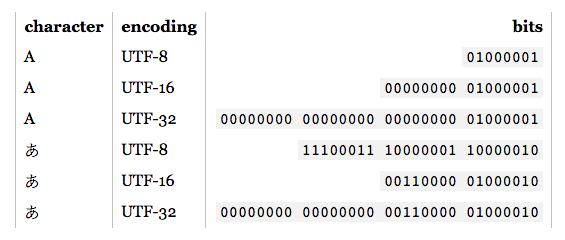
قصه ما به سر رسید. گفتن که با توجه به این که کد نویسی ها به زبان انگلیسی صورت می گیره و مثلا کل تگ های HTML کاراکتر انگلیسی داره و یک سری دلیل دیگه همون ۸ تا bit کافی مونه و اگر هم کاراکتری کدش بیشتر از ۲۵۵ بود می شکونیمش به ۲ تا واحد ۸ بیتی یا ۴ تا واحد ۸ بیتی (اگه دیگه خیلی خیلی بزرگ بود) که بعدا می چسبونیمشون به هم. در نتیجه UTF-8 به طور میانگین ۱ تا ۴ بایت (یعنی ۸ تا ۳۲ بیت) جافظه رو مصرف میکنه و از همه بهینه تره.
خیلی ساده شده و خلاصه گفتم (تازه این خلاصه بود؟؟؟؟؟!!!!). داستانش به همین راحتی ها هم نیست. ولی در هر صورت متوجه شدیم که Unicode و UTF-8 دقیقا یکی نیستن. Unicode تا قیامت کاراکتر ها رو عدد گذاری کرده و امثال UTF-8 و UTF-16 و UTF-32 روش هایی برای تفسیر Unicode هستن.

