
ایجنتهای کدنویسی مسیر طولانیای را طی کردهاند و بهترین روشهای کار با آنها هم با سرعت زیادی در حال تغییر است. کارهایی که قبلاً به هدایت مداوم، دستورالعملهای مفصل و زیرساختهای کمکی زیادی نیاز داشتند، دیگر لزوماً چنین نیازی ندارند.
اگر طی یک سال گذشته در پروژههایتان از ایجنتها استفاده کرده باشید، احتمالاً بهمرور مجموعه بزرگی از دستورالعملهای حجیم و اضافی ایجاد کردهاید تا مدلها را به سمت نتیجه مطلوب هدایت کنید. با عرضه هر نسل جدید، بازبینی این فرضیات ارزشمند بوده است؛ اما با GPT-6 Astra، این موضوع از همیشه مهمتر شده است.
این دستورالعملها میتوانند شکلهای مختلفی داشته باشند. فایلهای Skills، فایل AGENTS.md و پرامپتهایی که برای هر وظیفه مینویسید، همگی بر نحوه انجام کار توسط مدل تأثیر میگذارند.
یکی از شکلهای این دستورالعملها، فایلهای Skill هستند. این فایلها اساساً پرامپتهایی هستند که در قالب Markdown ذخیره میشوند و گاهی اسکریپتهایی نیز همراهشان قرار دارد.
بهطور کلی، Skillها بیشتر زمانی مفیدند که بخواهید مدل را برای یک گردشکار خاص که فقط در بعضی وظایف لازم است راهنمایی کنید، یا دستورالعمل استفاده از یک پلاگین را در اختیارش قرار دهید.
بسیاری از افراد بهصورت پیشفرض تعداد زیادی Skill را دانلود و وارد پروژههایشان میکنند، اما این کار اشتباه است.
هر Skill دارای یک نام و توضیح است که وارد Context مدل میشود تا مدل متوجه شود چه زمانی باید از آن استفاده کند. بسیاری از این توضیحات بیش از حد طولانی هستند. وقتی تعداد Skillها زیاد شود، Codex برای جا دادن آنها مجبور میشود توضیحاتشان را کوتاه کند.
در نتیجه، مدل بخش کمتری از توضیحات هر Skill را میبیند و تشخیص اینکه برای یک وظیفه مشخص باید کدام Skill را انتخاب کند دشوارتر میشود.
بدتر از آن، ممکن است توضیحات Skillها با یکدیگر تناقض داشته باشند یا بیش از حد حالت «من را انتخاب کن» داشته باشند؛ در نتیجه مدل دستورالعملهایی را بارگذاری میکند که عملاً کمکی به وظیفه فعلی نمیکنند.
اگر تاکنون از Codex خواسته باشید یک Skill ایجاد کند، احتمالاً برای این کار از Skill به نام $skill-creator استفاده کرده است. اخیراً راهنمای این Skill از چند جهت بهروزرسانی شده تا بسیاری از مشکلاتی که در عمل مشاهده کردهایم کاهش پیدا کند.
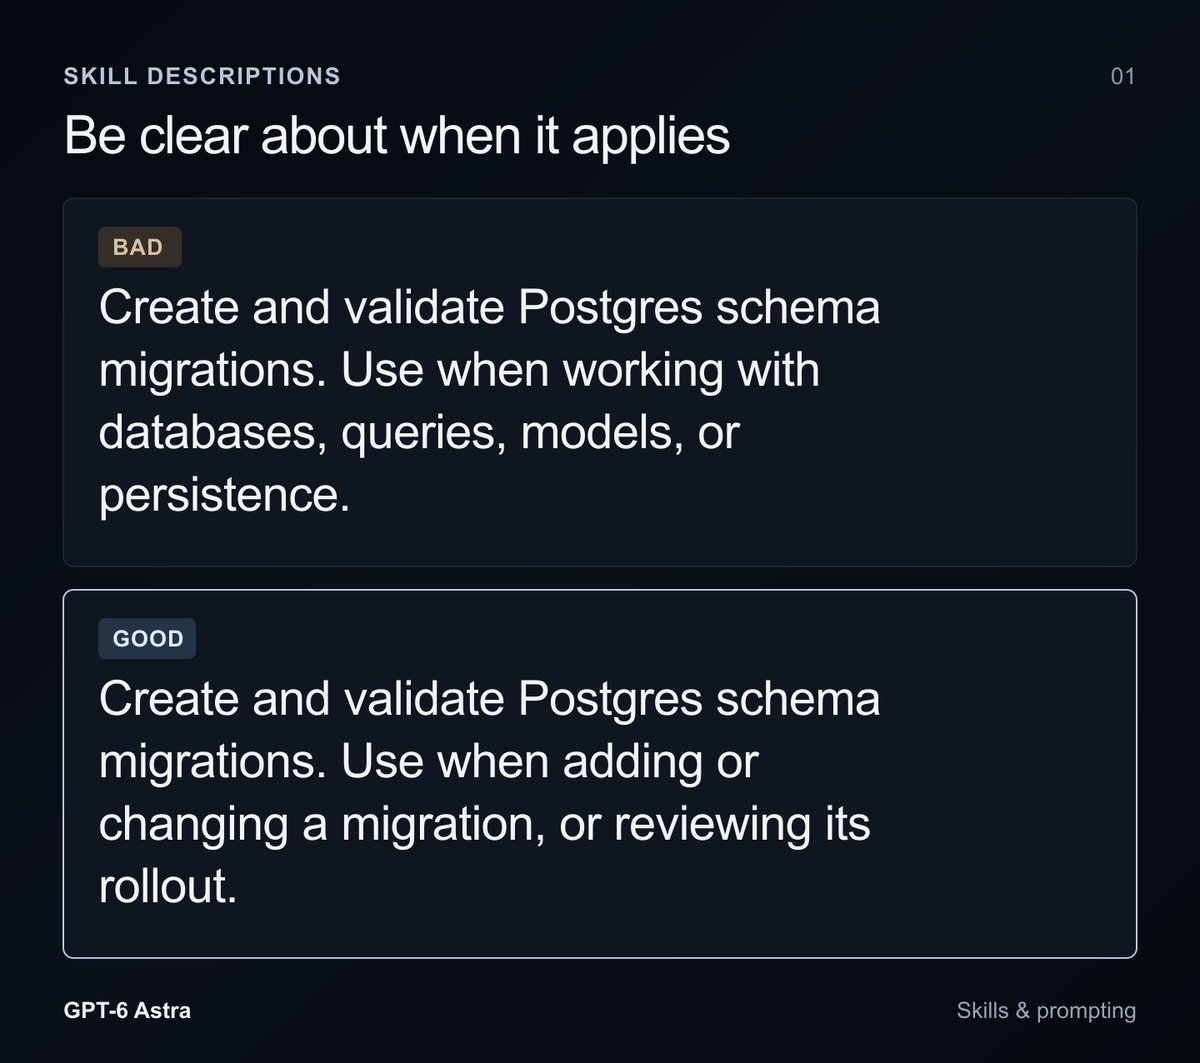
اول اینکه توضیحات Skill باید تا جای ممکن کوتاه باشند، در عین حال بهاندازه کافی روشن باشند تا مدل بداند دقیقاً چه زمانی باید از آن Skill استفاده کند.
برای مثال، یک توضیح بد برای Skill ممکن است مدل را وادار کند هر زمان که کاری مرتبط با دیتابیس انجام میدهد آن Skill را فعال کند، درحالیکه قرار بوده فقط هنگام انجام Migration از آن استفاده شود.
دوم، یکی از مهمترین نشانههای یک Skill خوب، مفهوم «افشای تدریجی» یا Progressive Disclosure است.
خواندن یک Skill بخشی از ظرفیت Context را مصرف میکند، مدل را سریعتر به مرحله Compaction نزدیک میکند و ممکن است دستورالعملهایی وارد Context شوند که اصلاً به وظیفه فعلی ارتباطی ندارند.
اگر یک Skill شامل چند Workflow مختلف است، سند اصلی آن را به یک Router بسیار کوچک و مینیمال تبدیل کنید که مدل را به اسناد و اسکریپتهای پشتیبان هدایت میکند.
فقط بهاندازهای اطلاعات در اختیار مدل قرار دهید که بداند برای پیدا کردن اطلاعات موردنیاز باید کجا برود، بدون اینکه مجبورش کنید مطالبی را بخواند که در آن لحظه هیچ اهمیتی ندارند.
سوم اینکه بسیاری از Skillها در گذشته به شکل دستورالعملهای بسیار مفصل، برنامههای مرحلهبهمرحله یا Recipe نوشته میشدند.
مدلها اکنون در درک ظرافتها و ابهامات بسیار بهتر شدهاند. بنابراین دستورالعملهای بیش از حد دقیق ممکن است امروزه مانع رسیدن به نتیجه بهتر شوند، درحالیکه قبلاً همین دستورالعملها به مدل کمک میکردند.
Skillهایی که داخل Repository قرار میگیرند، ایجنتهای سایر مشارکتکنندگان پروژه را نیز هدایت میکنند و ممکن است آنها از مدلهای متفاوتی استفاده کنند.
دستورالعملی که برای Sol یا Luna مفید است، ممکن است GPT-6 Astra را بیش از حد محدود کند. بنابراین هنگام نوشتن دستورالعملهایی که در Repository باقی میگذارید، در نظر بگیرید چه مدلهایی قرار است در آینده از آنها استفاده کنند.
از آنجا که AGENTS.md هر بار که مدل روی Repository شما کار میکند اعمال میشود، بهتر است تکتک دستورالعملهای آن را دوباره بررسی کنید و از خودتان بپرسید آیا هنوز واقعاً به آنها نیاز دارید یا خیر.
مثلاً الزام مدل به خواندن مجموعهای از اسناد یا بررسی نقشه کامل Repository پیش از هر ویرایش، برای اصلاح یک اشتباه تایپی کاملاً افراطی است.
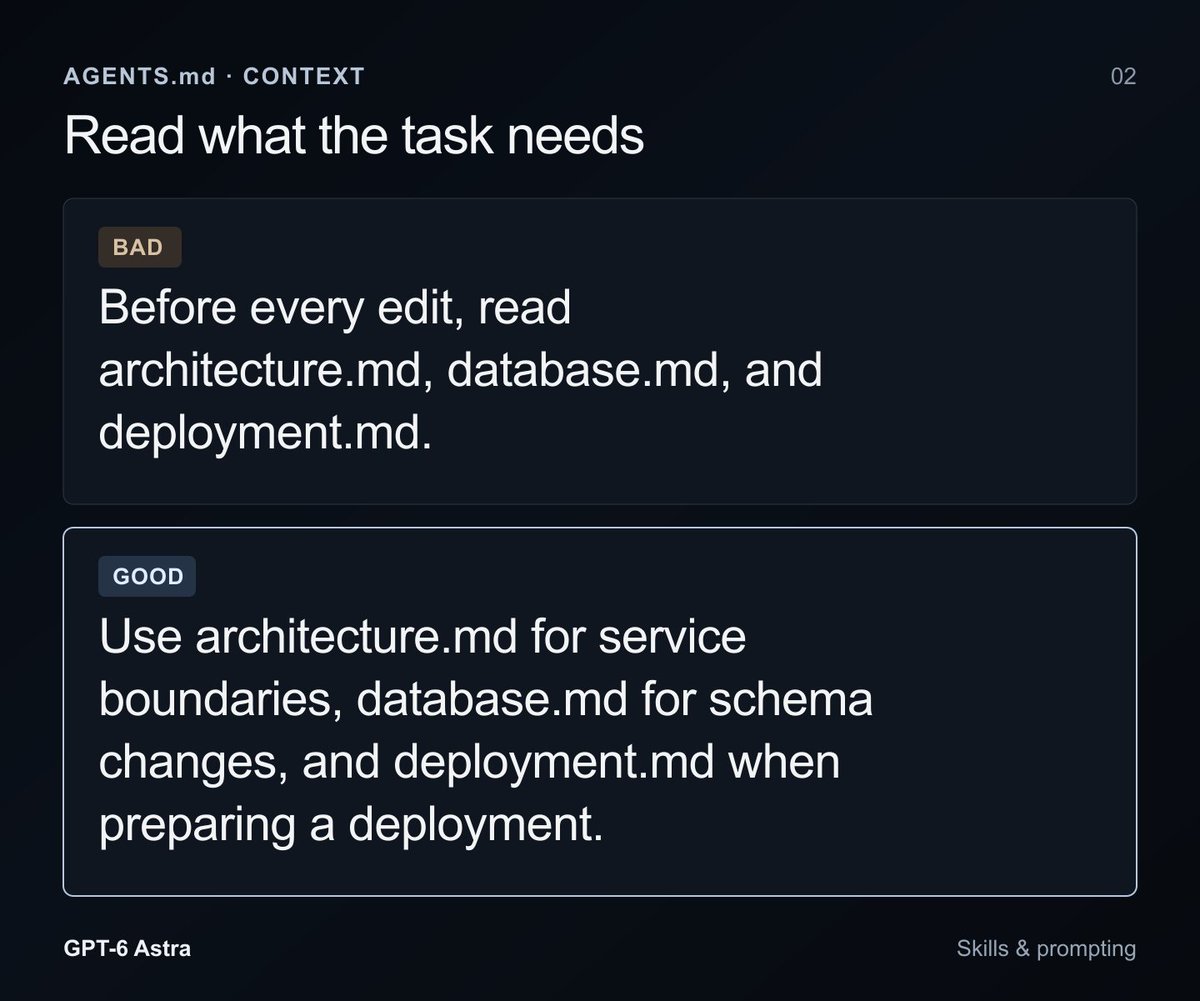
GPT-6 Astra خودش میتواند تشخیص دهد برای انجام یک کار چه فایلها و اطلاعاتی را باید بخواند و نیازی نیست پیش از هر تغییر مجبورش کنید کل پروژه را مرور کند.
وادار کردن مدل به خواندن فایلها پیش از هر ویرایش، راه بسیار خوبی برای مصرف بیهوده Context و کند کردن روند کار است.
البته ارجاع دادن مدل به بعضی اسناد همچنان میتواند مفید باشد، به شرط اینکه این ارجاع متناسب با Context و وظیفه باشد. همچنین مطمئن شوید اسناد پروژه همیشه بهروز هستند.
مدلهای قبلی نیاز داشتند که آنها را به اجرای تستها و بررسی نتیجه کارشان تشویق کنید. GPT-6 Astra این کار را بهصورت خودکار انجام میدهد؛ بنابراین همان دستورالعملهای قدیمی ممکن است باعث اجرای تستهای غیرضروری شوند.
GPT-6 Astra بسیار دقیق و جامع عمل میکند، اما ممکن است درباره اینکه یک وظیفه را تا کجا ادامه دهد کمی محتاطتر باشد. گاهی لازم است کمی به آن اجازه و انگیزه بدهید که کار را ادامه دهد.
برای مثال میتوانید در AGENTS.md برای Workflow مشخصی که میدانید امن است، صریحاً به آن اجازه ادامه کار بدهید؛ مثلاً برای تستهای محلی:
«تستهای محلی از Fixtureهای موقتی استفاده میکنند و هیچ دسترسیای به محیط Production ندارند. آنها را اجرا کن، خطاهایی را که در نتیجه تغییر درخواستشده ایجاد شدهاند برطرف کن و تستهای مرتبط را دوباره اجرا کن؛ بدون اینکه در هر مرحله برای تأیید از من سؤال کنی.»
به نحوه تعریف مرزها بسیار دقت کنید.
اگر مدل قبلی بدون اجازه شما کارهایی انجام میداد، ممکن است در دستورالعملها زبان بسیار سختگیرانهای اضافه کرده باشید تا مدل را مجبور کنید ابتدا از شما اجازه بگیرد.
این کار میتواند مفید باشد، اما GPT-6 Astra قدرت قضاوت بسیار بهتری دارد و بهتر است متناسب با همین توانایی با آن رفتار کنید.
این مدل همچنین مرزهایی را که تعیین میکنید بسیار جدی میگیرد و ممکن است در نقطهای کار را متوقف کند که در واقع شما مشکلی با ادامه دادن آن نداشتید.
اگر عادت کردهاید GPT-5.6 Sol یک درخواست را دریافت کند و برای مدت طولانی بدون توقف روی آن کار کند، GPT-6 Astra ممکن است در تشخیص اینکه چه زمانی باید متوقف شود محتاطتر به نظر برسد.
ممکن است اولین نسخه پیادهسازی را آماده کند و برای بررسی شما برگردد، درحالیکه هنوز بخشهایی از کار باقی مانده است.
اینجاست که تعریف دقیق «شرایط تکمیل کار» پیش از شروع اهمیت پیدا میکند.
اگر وظیفه شامل اجرای Implementation، راهاندازی آن، بررسی نتیجه و برطرف کردن خطاهای احتمالی است، همه این موارد را از ابتدا بخشی از درخواست تعریف کنید.
اگر در دستورالعمل نوشته باشید که مدل باید بعد از اولین Implementation برای Review متوقف شود، طبیعتاً مدل به سمت توقف زودتر هدایت میشود. بنابراین بررسی کنید آیا واقعاً در آن مرحله تصمیمی وجود دارد که نیازمند دخالت شما باشد یا خیر.
اگر میخواهید مدل پس از اولین تلاش همچنان به بررسی و آزمایش ادامه دهد، دقیقاً مشخص کنید چه چیزهایی را باید بررسی کند و در چه نقطهای باید متوقف شود.
عرضه یک مدل جدید فرصت خوبی برای خانهتکانی است.
از GPT-6 Astra بخواهید براساس نکاتی که در این مقاله مطرح شد، دستورالعملها، Skillها و ساختار پروژه شما را Audit کند.
بعد از آن، بروید و چیزی بسازید که قبلاً حتی سراغ ساختنش نمیرفتید!

