
👆 اگر شما هم مانند میلیونها نفر دیگر در دنیای پرمشغله و سریع امروز، فرصت مطالعه ندارید، میتوانید نسخه صوتی این مطلب را که با استفاده از Google NotebookLM تهیه شده است، گوش کنید. 👆
📷 تصاویر این پست با استفاده از Gemini تولید شدهاند؛ اما به جهت احترام به خوانندگان، تلاش شده است محتوایی اصیل تولید شود تا در دوران هوش مصنوعی، همچنان رنگوبویی انسانی، خلاقانه و واقعی داشته باشد.
در بسیاری از سرویس های امروزی وقتی یک سرویس نرمافزاری وارد پروداکشن میشود، مسئله دیگر فقط اجرای یک کد روی یک سرور نیست. مجموعهای از اجزای نرمافزاری و زیرساختی باید در کنار هم کار کنند تا آن سرویس قابل استفاده باقی بماند.
سیستمعامل، شبکه، استوریج، پایگاه داده ها، سرویسهای جانبی، کانفیگ ها و خود اپلیکیشن، همگی بخشی از این محیط محسوب میشوند. هرکدام از این اجزا باید راهاندازی و نگهداری شوند و با تغییر نیازها، نسخهها و شرایط سیستم، در طول زمان بهروزرسانی و مدیریت شوند.
مدل سنتی System Administration برای پاسخ به همین نیاز شکل گرفت. در این مدل، سازمان معمولاً از مجموعهای از نرمافزارها و اجزای موجود استفاده میکند، آنها را در کنار هم قرار میدهد و محیطی میسازد که محصول بتواند روی آن اجرا شود. بعد از راهاندازی، مسئولیت اجرای سرویس و رسیدگی به اتفاقاتی که در محیط عملیاتی رخ میدهد به تیم سیستم ادمین ها یا عملیات سپرده میشود.
بنابراین وقتی از رویکرد Sysadmin صحبت میکنیم، منظور صرفاً یک عنوان شغلی نیست. بحث دربارهی یک مدل مدیریت سرویس است؛ مدلی که در آن توسعهی محصول و اجرای آن در پروداکشن معمولاً به دو حوزهی مسئولیت مجزا تقسیم میشوند.
تیم توسعه نرمافزار را توسعه میدهد و تیم عملیات مسئول اجرای آن است. تغییرات نرمافزار از سمت تیم توسعه ایجاد و بهبود داده میشوند، اما اعمال آنها روی محیط عملیاتی و مدیریت پیامدهای آن تغییرات تا حد زیادی در حوزهی مسئولیت عملیات یا همان Operation قرار میگیرد.
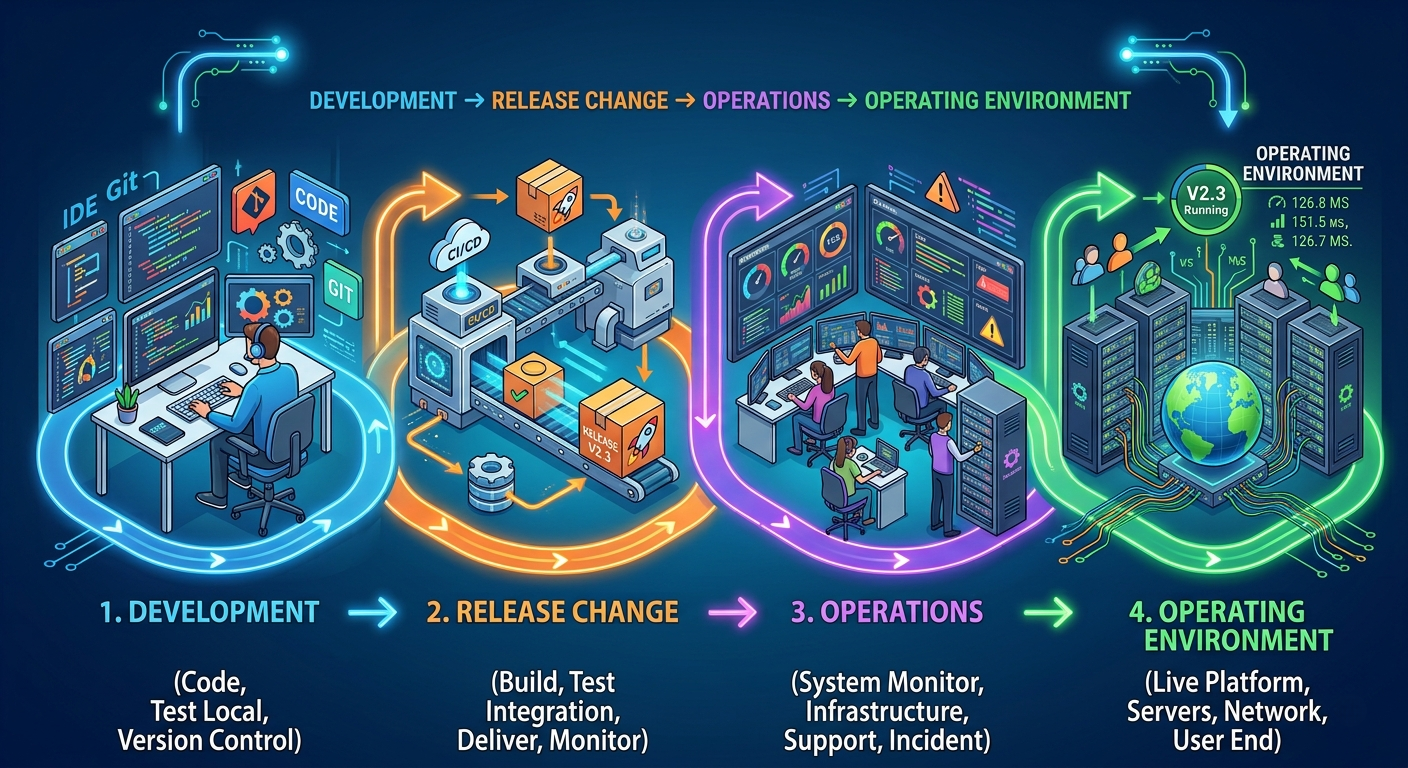
این مدل برای سالها یکی از رایجترین ساختارهای ادارهی سیستمهای نرمافزاری بوده و دلیل آن هم روشن است: راهاندازی آن نسبتاً ساده است، نقشها مشخصاند و سازمان برای شروع مجبور نیست مدل عملیاتی جدیدی اختراع کند.
مشکل اصلی این مدل زمانی مشخص میشود که سرویس شروع به رشد میکند.
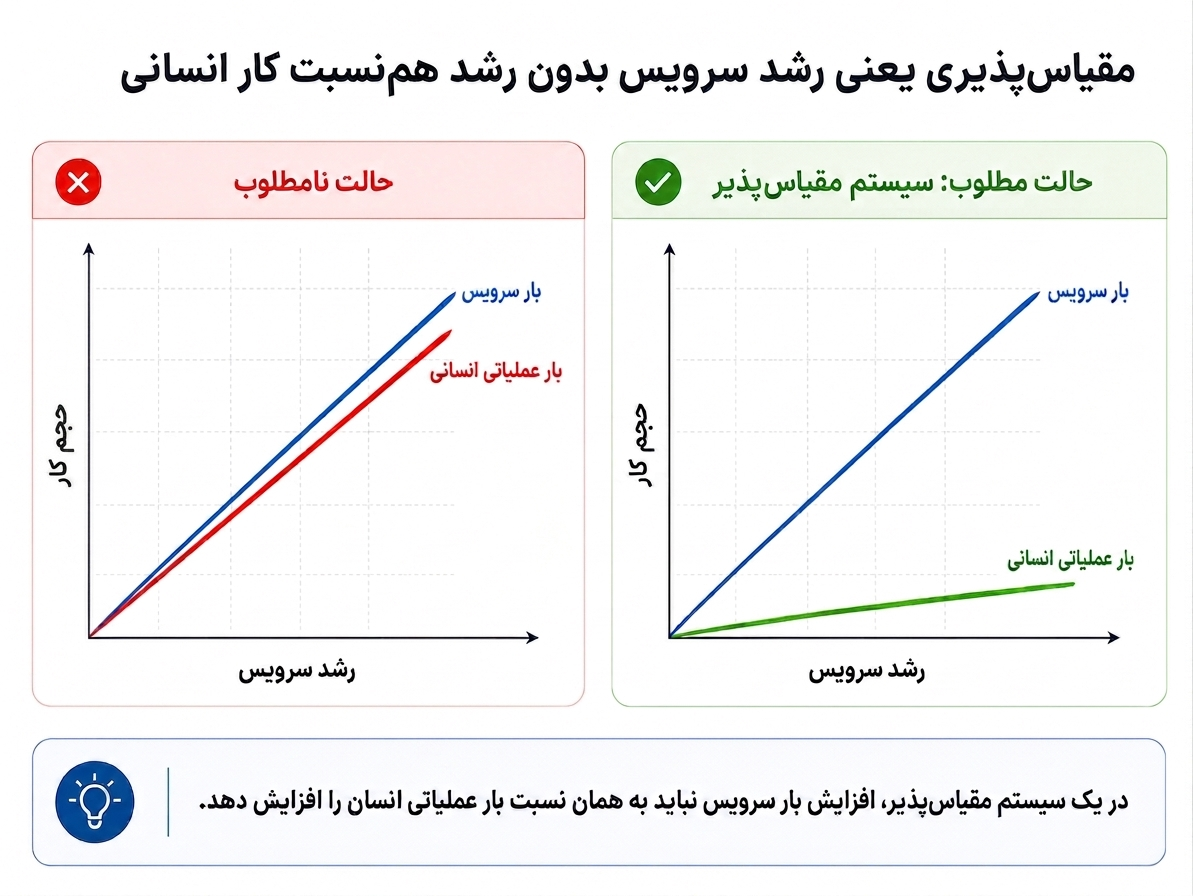
برای بررسی محدودیت مدل Sysadmin باید میان دو مفهوم تفاوت قائل شویم: Service Load و Operational Load.
Service Load همان باری است که خود سیستم پردازش میکند؛ برای مثال افزایش تعداد کاربران، Requestها یا حجم داده های نیازمند ذحیره سازی.
Operational Load کاری است که انسانها برای ادارهی آن سیستم انجام میدهند؛ مانند رسیدگی به رخدادها، مدیریت تغییرات، انجام عملیات دستی و پاسخ به مشکلاتی که در پروداکشن ایجاد میشوند.
این دو الزاماً نباید با نرخ یکسانی رشد کنند.
یک سیستم خوب ممکن است ده برابر ترافیک بیشتری دریافت کند، در حالی که تیمی تقریباً با همان اندازه قبلی بتواند آن را اداره کند. اما اگر طراحی و معماری ایجاد شده توسط تیم عملیات بهشدت به مداخلهی انسانی وابسته باشد، افزایش اندازه و پیچیدگی سرویس معمولاً به افزایش حجم کار Operations منجر میشود.
در مدل سنتی Sysadmin، این مسئله معمولاً از دو مسیر خودش را نشان میدهد: Event Handling و Change Management.
با افزایش اندازه سیستم، تعداد اتفاقاتی که باید بررسی شوند بیشتر میشود. از طرف دیگر، هرچه محصول فعالتر توسعه داده شود، تغییرات بیشتری باید به پروداکشن منتقل شوند. اگر پاسخ به این رخدادها و مدیریت این تغییرات وابسته به عملیات انسانی باشد، تیم عملیات باید حجم بیشتری از کار را جذب کند.
راهحل مستقیم چنین مدلی نیز معمولاً افزایش تعداد افراد تیم است.
این همان نقطهای است که یک محدودیت مهم در معماری عملیاتی سیستم ایجاد میشود. ظرفیت سیستم ممکن است با اضافهکردن سرور، Sharding، Replication یا روشهای دیگر افزایش پیدا کند، اما ظرفیت عملیات همچنان به تعداد افرادی وابسته است که قادرند کارهای لازم را انجام دهند.
در این شرایط، تیم Operations عملاً به بخشی از مسیر Scale شدن سرویس تبدیل میشود.
هرچه سرویس بزرگتر شود، تعداد بیشتری Event ایجاد میشود؛ تعداد تغییرات بالا میرود؛ حجم فعالیتهای عملیاتی افزایش پیدا میکند و سازمان برای حفظ وضعیت موجود به نیروی انسانی بیشتری احتیاج پیدا میکند.
این نوع Scaling از نظر اقتصادی و سازمانی مطلوب نیست، زیرا هزینهی ادارهی سیستم بهصورت مستقیم به حجم کار عملیاتی و نگهداری آن متصل میشود.
مسئله در اینجا تعداد نیرو های Sysadmin نیست. مسئله Manual Intervention بهعنوان بخشی از مدل عملیاتی سیستم است.
تا زمانی که یک فرآیند به تصمیم یا اقدام انسانی نیاز داشته باشد، افزایش دفعات اجرای آن فرآیند مستقیماً ظرفیت تیم را مصرف خواهد کرد.
به همین دلیل تفاوت مهمی میان سیستمی وجود دارد که صرفاً «قابل اداره» است و سیستمی که عملیات آن واقعاً Scalable طراحی شده است.
با وجود این محدودیت، مدل سنتی Sysadmin مزایای عملی مهمی دارد و تحلیل آن بدون درنظرگرفتن این مزایا ناقص خواهد بود.
مهمترین مزیت این مدل، بلوغ آن است.
System Administration یک حوزهی شناختهشده است و سازمانها مجبور نیستند برای راهاندازی یک سرویس، تمام ابزارها و فرآیندهای عملیاتی را خودشان طراحی کنند. مجموعهی بزرگی از نرمافزارهای آماده، ابزارهای مدیریت سیستم و شرکتهای تخصصی وجود دارد که میتوان از آنها استفاده کرد.
از نظر نیروی انسانی نیز سازمان با یک حوزهی کاملاً ناشناخته مواجه نیست. مهارتهای موردنیاز برای مدیریت سیستمها سالهاست در صنعت وجود دارند و تجربیات عملی زیادی در دسترس است.
به همین دلیل، مخصوصاً در مقیاس کوچک، انتخاب این مدل میتواند کاملاً منطقی باشد.
فرض کنید سازمانی تعداد محدودی سرویس دارد و حجم رخدادهای عملیاتی نیز پایین است. در چنین محیطی، هزینهی طراحی یک Automation پیچیده ممکن است از هزینهی انجام دستی همان عملیات بیشتر باشد.
بنابراین مسئله این نیست که Manual Operation همیشه نامناسب است.
مسئله زمانی شروع میشود که عملیاتی که برای مقیاس کوچک طراحی شده، بدون تغییر وارد مقیاس بزرگ شود.
مدلی که برای ده سرور مجازی مناسب است الزاماً برای ده هزار سرور مناسب نیست. همین موضوع دربارهی تعداد کاربران، تعداد سرویسها، تعداد Deploymentها و تعداد تغییرات نیز صدق میکند.
در واقع یکی از اشتباهات رایج این است که معماری نرمافزار برای Scale بازطراحی میشود، اما مدل عملیاتی همان مدل قبلی باقی میماند.
افزایش هزینهی نیروی انسانی را میتوان بهراحتی مشاهده و اندازهگیری کرد. اما یکی از مشکلات مهمتر مدل سنتی Sysadmin از ساختار سازمانی آن ناشی میشود.
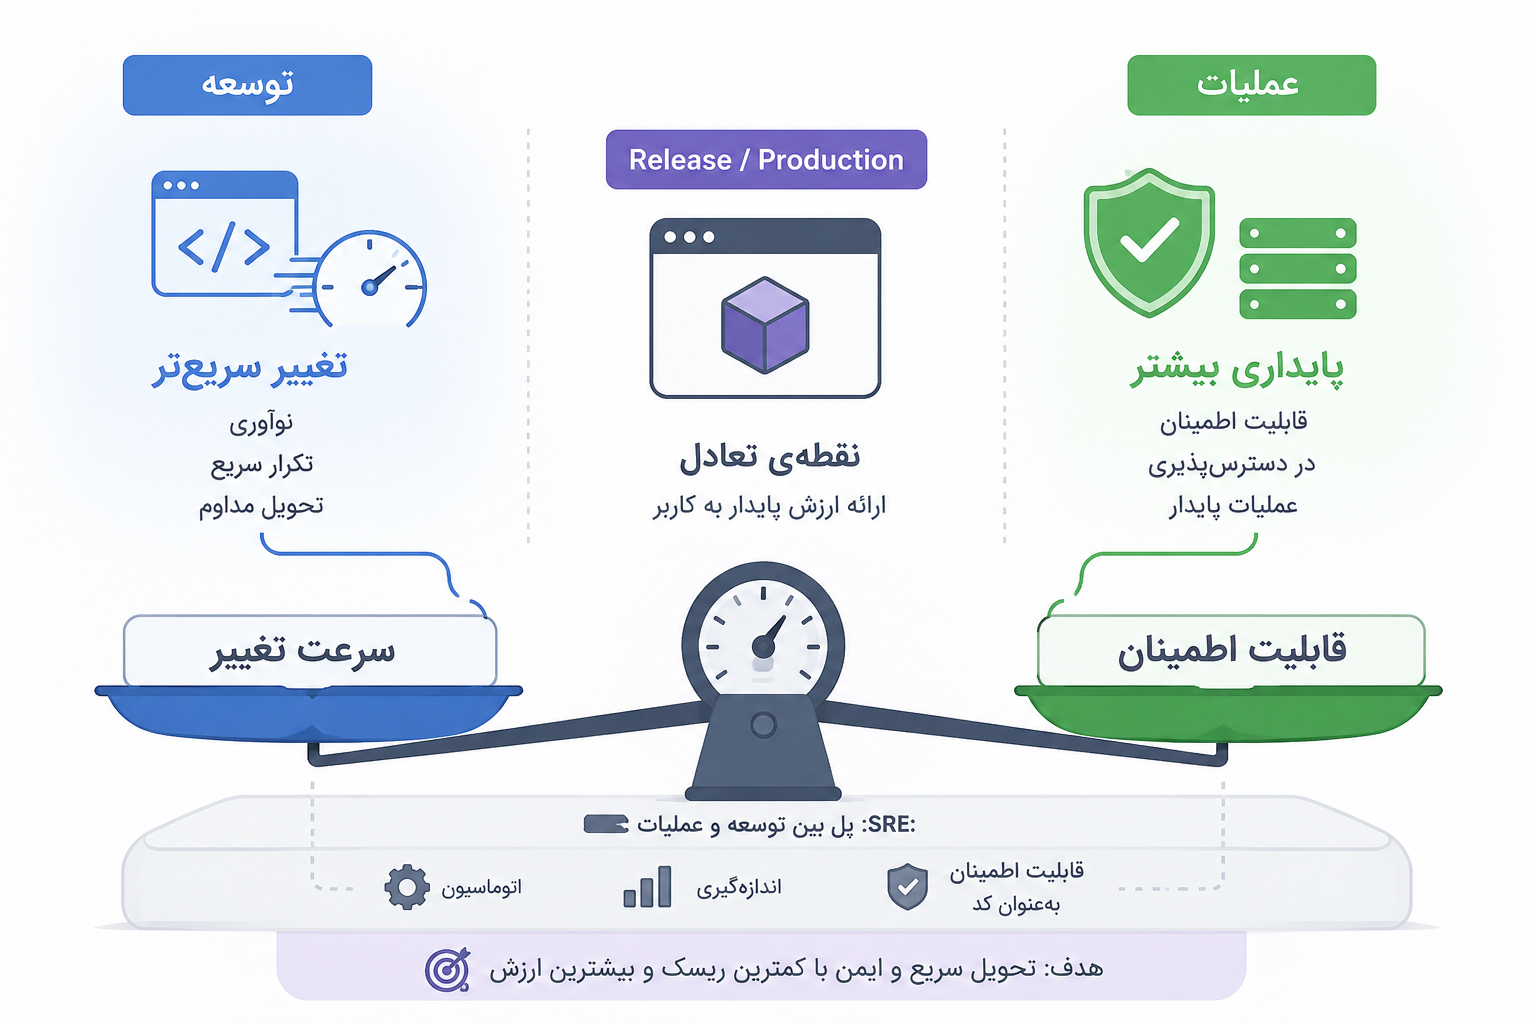
وقتی Development و Operations بهصورت دو تیم مستقل فعالیت میکنند، فقط مسئولیتهای آنها متفاوت نیست. بهتدریج اهداف، معیارهای موفقیت و حتی نحوهی تحلیل ریسک در این دو گروه نیز ممکن است متفاوت شود.
تیم Development برای تغییر نرمافزار ایجاد شده است.
یک تیم توسعه زمانی ارزش ایجاد میکند که محصول را تغییر دهد: ویژگی و فیچر جدید ایجاد کند، رفتارهای قبلی را اصلاح کند، Performance را بهبود دهد یا قابلیتهای تازهای در اختیار کاربران قرار دهد.
در نتیجه سرعت تغییرات برای Development اهمیت دارد.
اما Operations با نتیجهی همین تغییرات در محیط واقعی مواجه میشود.
از دید تیم عملیات، هر تغییر علاوه بر منفعتی که برای محصول ایجاد میکند، یک Failure Mode جدید نیز میتواند وارد سیستم کند. تغییر Configuration، انتشار نسخهی جدید یا تغییر رفتار ترافیک همگی میتوانند وضعیت یک سیستم پایدار را تغییر دهند.
بنابراین Operations بهطور طبیعی نسبت به Change دید محافظهکارانهتری پیدا میکند.
این دو دیدگاه در ظاهر متناقضاند، ولی هر دو از مسئولیتهای سازمانی همان تیم ناشی میشوند.
تیم Development برای افزایش سرعت تغییر بهینه میشود، در حالی که تیم Operations بر کاهش احتمال اختلال تمرکز دارد.
مسئله در اینجا ضعف ارتباطات میان دو تیم نیست. حتی اگر افراد روابط بسیار خوبی با یکدیگر داشته باشند، ساختار مسئولیتها همچنان اهداف متفاوتی ایجاد میکند.
مهندسی که مسئول ارائهی فیچر ها است، بیشتر نگران دیر منتشر شدن آن فیچر است؛ اما مهندسی که مسئول پایداری بر روی پروداکشن است، بیشتر نگران مشکلی است که همان فیچر و Release آن ممکن است ایجاد کند.
بنابراین اختلاف بر سر سرعت انتشار نرمافزار یک اتفاق تصادفی نیست؛ نتیجهی قابل انتظار ساختاری است که مسئولیت ایجاد Change و مسئولیت تحمل ریسک آن Change را میان دو تیم تقسیم کرده است.
یکی از نتایج طبیعی این تعارض، ایجاد کنترلهای بیشتر بر تغییرات پروداکشن است.
فرض کنید یک Release باعث حادثه و Down شدن محصول شده است. واکنش معقول این است که بررسی شود چه چیزی اشتباه بوده و چگونه میتوان از وقوع مجدد آن جلوگیری کرد.
وقتی واکنش سازمان به هر حادثه، اضافهکردن یک تست جدید به پایپ لاین فرآیند انتشار باشد، بهمرور لایهای از Launch Reviewها، تأییدیهها و مراحل کنترلی شکل میگیرد که انتشار هر تغییر را پیچیدهتر و کندتر میکند.
هرکدام از این کنترلها ممکن است در زمان ایجاد خود منطقی بوده باشند، اما در طول زمان هزینهی تجمعی آنها افزایش پیدا میکند.
فرآیند Release کندتر میشود و هر تغییر به هماهنگی بیشتری نیاز پیدا میکند.
از اینجا یک رفتار سازمانی قابل پیشبینی شکل میگیرد.
Operations تلاش میکند سطح بیشتری از کنترل را روی تغییرات پروداکشن اعمال کند، زیرا مسئول Stability سیستم است.
Development نیز تلاش میکند تغییرات را با کمترین اصطکاک ممکن منتشر کند، زیرا مسئول سرعت بهبود محصول است.
نتیجه این است که Change Management بهجای اینکه ابزاری مشترک برای مدیریت ریسک باشد، ممکن است به مرزی میان دو تیم تبدیل شود.
در این مرحله مشکل دیگر صرفاً تکنیکی نیست.
تفاوت در مهارتها، بهمرور باعث شکلگیری زبان و اصطلاحات متفاوت میشود؛ این تفاوت روی شیوهی تحلیل مسائل اثر میگذارد و در نهایت ممکن است حتی تعریف دو تیم از «پایداری کافی» هم با یکدیگر فرق داشته باشد.
وقتی چنین فاصلهای ایجاد شود، تقسیم Dev/Ops دیگر صرفاً تقسیم مسئولیت نیست؛ خودش به یکی از عوامل افزایش هزینهی ادارهی سرویس تبدیل میشود.
محدودیت بنیادی مدل سنتی را میتوان در یک جمله خلاصه کرد:
اگر رشد ظرفیت عملیاتی مستلزم افزایش متناسب تعداد افرادی باشد که عملیات را انجام میدهند، مدل مدیریت سرویس از نظر عملیاتی Scale نمیشود.
این موضوع الزاماً در ابتدای عمر یک سیستم قابل مشاهده نیست.
مشکل در مقیاس پذیری ظاهر میشود.
ممکن است یک فرآیند دستی چند دقیقه زمان ببرد و در یک سرویس کوچک کاملاً قابل قبول باشد. اما هزینهی واقعی آن فرآیند را باید در تعداد دفعاتی که در طول عمر سیستم اجرا خواهد شد اندازهگیری کرد.
همین منطق دربارهی Event Handling نیز وجود دارد.
اگر یک نوع حادثه و خطا برای بازیابی همیشه به مداخلهی انسان احتیاج داشته باشد، افزایش تعداد Instanceها یا افزایش Traffic میتواند تعداد دفعات مواجهه با آن حادثه را بیشتر کند.
در این شرایط، پاسخ مناسب لزوماً بهبود سرعت واکنش تیم نیست و ممکن است مسئله نیازمند تغییر خود سیستم باشد.
اینجا تفاوت میان Operating a System و Engineering Operations مشخص میشود در حالت اول، تیم یاد میگیرد چگونه یک عملیات را با اطمینان انجام دهد و در حالت دوم، تیم بررسی میکند که آیا میتوان نیاز به آن عملیات را کاهش داد یا حذف کرد.
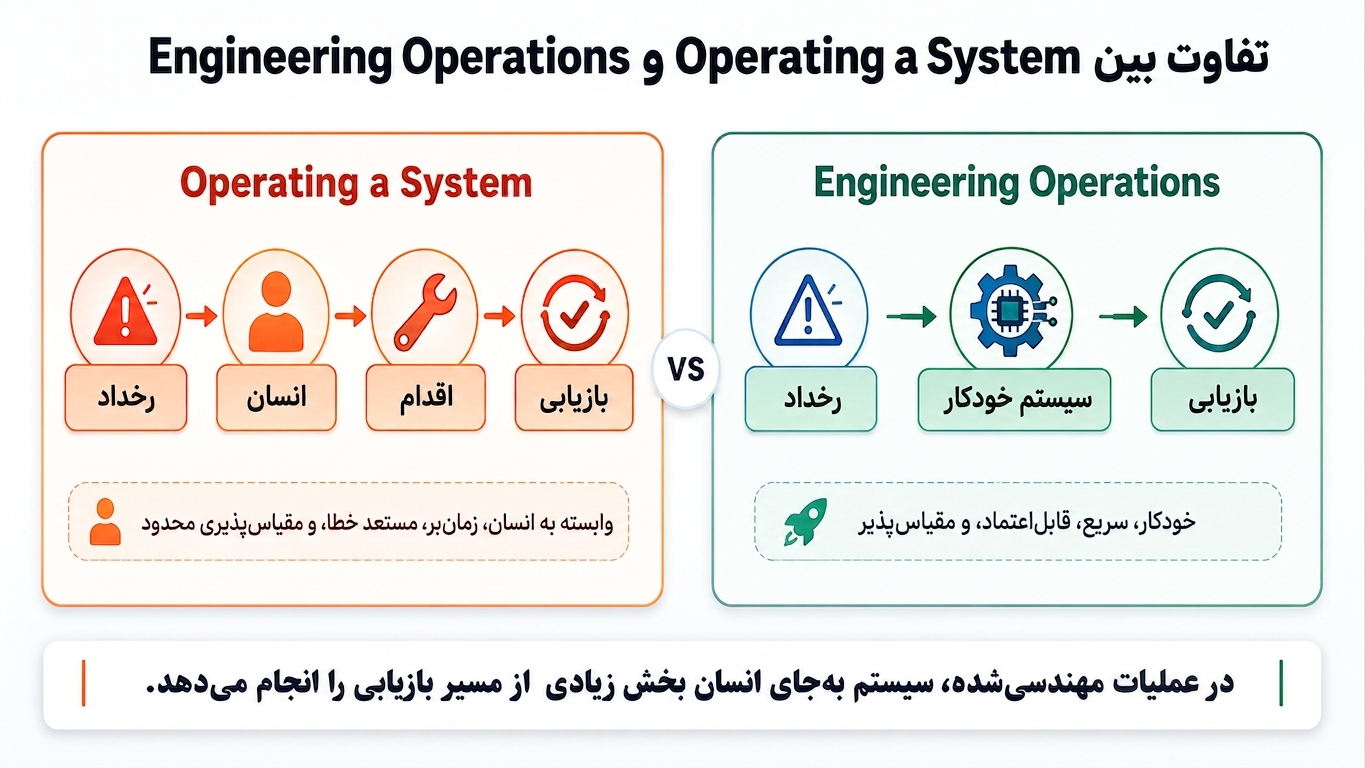
این تفاوت مبنای تغییر بزرگی بود که بعدها در مدلهای مهندسی Reliability مشاهده شد: بهجای اینکه نیروی انسانی بهعنوان ظرفیت اصلی عملیاتی در نظر گرفته شود، بخشی از تلاش مهندس ها صرف ساخت نرمافزاری میشود که کار عملیاتی را از حلقهی انسانی خارج کند.
در نتیجه، مدیریت سنتی سیستمها را نمیتوان مدلی شکستخورده یا منسوخ دانست. این رویکرد سالها پاسخی عملی به نیاز سازمانها برای راهاندازی و نگهداری سرویسهای نرمافزاری بوده و همچنان مزایایی مانند ساختار سازمانی ساده، دسترسی به نیروی متخصص و مجموعهی گستردهای از ابزارها دارد.
محدودیت این مدل زمانی بیشتر دیده میشود که سرویس رشد میکند و حجم کارهای عملیاتی همراه با آن افزایش مییابد، در حالی که بخش زیادی از مدیریت تغییرات و رسیدگی به رخدادها همچنان به مداخلهی مستقیم انسان وابسته است.
در چنین شرایطی، دو مسئله بهطور همزمان شکل میگیرد. از یک طرف، مسئلهی مقیاسپذیری مطرح است؛ هرچه بار عملیاتی بیشتر شود، تیم عملیات نیز باید برای پاسخگویی به آن بزرگتر شود. از طرف دیگر، جدایی میان تیم توسعه و عملیات میتواند به شکلگیری هدفها و انگیزههای متفاوت منجر شود: تیم توسعه میخواهد تغییرات را سریعتر منتشر کند، در حالی که تیم عملیات باید خطر ناشی از همان تغییرات را کنترل کند.
همین دو محدودیت نشان میدهند که در سیستمهای بزرگ، داشتن یک تیم عملیات قوی بهتنهایی کافی نیست. در یک نقطه، خودِ شیوهی اداره و نگهداری محیط عملیاتی باید به یک مسئلهی مهندسی تبدیل شود.
از اینجا به بعد، سؤال اصلی دیگر این نیست که «برای ادارهی این سرویس به چند نیروی عملیاتی نیاز داریم؟» بلکه سؤال مهمتر این است:
چه مقدار از کارهایی که امروز به دخالت انسان وابستهاند، واقعاً باید انسانی باقی بمانند؟
این پرسش، نقطهی ورود ما از مدیریت سنتی سیستمها به مهندسی قابلیت اطمینان سایت است. اما این تغییر رویکرد یک سؤال مهم دیگر را هم پیش روی ما میگذارد: اگر هدف، ساخت سرویسهای قابلاعتمادتر است، آیا باید برای رسیدن به قابلیت اطمینان صددرصدی تلاش کنیم؟
پاسخ برخلاف چیزی است که شاید در نگاه اول به نظر برسد. قابلیت اطمینان بیشتر همیشه به معنای سرویس بهتر نیست و تلاش برای حذف کامل خرابی میتواند هزینهای داشته باشد که مستقیماً سرعت توسعه و انتشار تغییرات را کاهش دهد.
سعی میکنم در مطلب بعدی به همین موضوع بپردازم: چرا هدف یک نیروی SRE رسیدن به قابلیت اطمینان صددرصدی نیست، و چگونه میتوان میان سرعت توسعه و پایداری سرویس تعادل برقرار کرد.

