
لازم به ذکره این دوره نسخه ترجمه شده دوره ماشین لرنینگ سایت SoloLearn هست و من فقط ترجمه اون رو انجام دادم.
این قسمت آشنایی ما با مدل لاجیستیک رگرشن هست و اینکه چطور میتونیم یه مدل با sklearn بسازیم.
برای مشخص کردن بهترین خط ممکن برای جدا کردن دیتامون، باید یه راهی برای امتیازدهی به خطمون داشته باشیم. بیاید به یه دیتاپوینت نگاه کنیم.
به طور آرمانی(ایده آل)، اگر دیتاپوینت ما یه مسافره که زنده مونده، دیتاپوینتش سمت راست خط و دور از خطه، و اگه دیتاپوینت ما مسافری باشه که زنده نمونده، دیتاپوینت ما باید سمت چپ خط و دور از خط باشه. هر چی دیتاپوینت ما دورتر از خط باشه ما با اطمینان بیشتری میگیم که نقطه ما در سمت درستی از خط قرار گرفته.
برای هر دیتاپوینت، ما یه امتیاز داریم که یه مقدار بین 0 و 1 هست. ما میتونیم اون رو به عنوان احتمال بقای مسافر در نظر بگیریم. اگه مقدار به 0 نزدیک باشه اون پوینت سمت چپ و دور از خطه و معنیش اینه که ما با مطمئنیم که اون مسافر مرده. اگه مقدار به 1 نزدیکه یعنی اون پوینت سمت راست و دور از خطه و به این معنیه که ما مطمئنیم که مسافر سالم مونده. اگر مقدار 0.5 باشه به این معنیه که نقطه ما دقیقا روی خط میوفته و ما شک داریم مسافر زنده مونده باشه.
معادله حساب کردن این امتیاز زیر قرار گرفته، اما درک مفهوم این معادله خیلی مهم تر از خودشه.
یادتون باشه که معادله خط ما به فرم 0 = ax+by+c هست( x کرایه، y سن و a b c هم ضریب هستن). عدد e هم یه ثابت ریاضیاتیه که تقریبا میشه 2.71828.
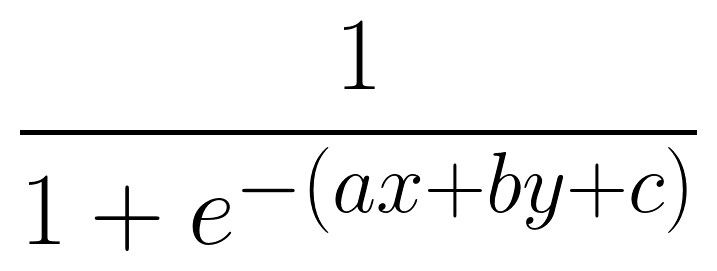
این تابع سیگمویید نام داره (the sigmoid ).
لاجیستیک رگرشن تنها یه پیشبینی نمیده ( بقا یافته یا نه) بلکه یه احتمال به ما میده (80 درصد احتمال بقا وجود داره).
برای محاسبه اینکه خط ما چقدر خوبه، باید ببینیم آیا پیشبینی های ما درست هستن یا نه. به طور آرمانی اگه ما با یه احتمال بسیار زیاد پیشبینی کنیم که یه مسافر زنده میمونه، پس اون مسافر واقعاً زنده میمونه.
پس ما اگر چیزی رو درست پیشبینی کنیم جایزه میگیریم و اگر چیزی رو غلط پیشبینی کنیم جریمه میشیم.
این معادله احتمال پیشامد (likelihood) هست. بازم، مفهوم معادله خیلی مهم تر از خودشه.
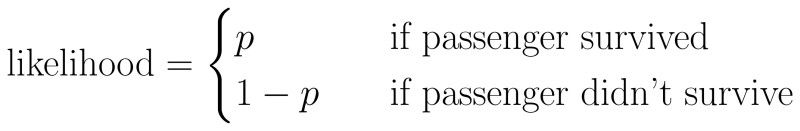
اینجا p احتمال بقای پیشبینی شده از بخش های قبله.
احتمال پیشامد یه عدد بین 0 و 1 هست. هر چی عدد بیشتر، خط بهتر.
بیاید به چند تا احتمال نگاه کنیم.
ما تمام امتیاز های جداگانه برای هر دیتاپوینت رو باهم ضرب میکنیم تا یک امتیاز برای خطمون بدست بیاریم ؛ بنابراین میتونیم خطوط مختلف رو باهم مقایسه کنیم و بهترینش رو پیدا کنیم.
بیاید فرض کنیم برای آسانی محاسبه ما 4 تا دیتاپوینت داریم.
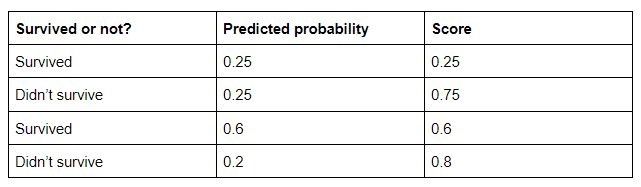
ما امتیاز کل رو با ضرب کردن امتیاز ها توی هم بدست میاریم:
0.25 x 0.75 x 0.6 x 0.8 x = 0.09
مقدار همیشه قراره خیلی کوچیک باشه ازونجایی که این مقدار احتمال درست پیشبینی کردن بی نقص همه چیزه. یه مدل بی نقص احتمال پیشبینی 1 برای همه کیس های مثبت و 0 برای همه کیس های منفی داره.
احتمال پیشامد نحوه امتیازدهی و مقایسه کردن انتخاب های ممکن برای پیدا کردن بهترین خطه
حالا که ما نحوه کارکرد لاجیستیک رگرشن رو متوجه شدیم، بیاید کد بزنیم تا یه مدل بسازیم.
برای این کار ما قراره یه ماژول جدید پایتون به نام scikit-learn رو به شما معرفی کنیم.
این ماژول، که اسمش معمولا به sklearn خلاصه میشه، ابزار علمی ماست.
تمام الگوریتم های ماشین لرنینگ ساده ای که ما کار میکنیم تو sklearn قرار داده شده. خواهید دید که با نوشتن فقط چند خط ما میتونیم چندین مدل قدرتمند بسازیم.
یادتون باشه که scikit-learn پیوسته داره آپدیت میشه. اگه ورژن ماژول شما یکم با مال من فرق بکنه، همچنان همه چیز کار میکنه اما بعضی جاها ممکنه شما مقادیر متفاوتی با من رو ببینید.
آماده کردن دیتا با Pandas
قبل از اینکه ما از sklearnبرای ساخت یه مدل استفاده کنیم، باید دیتا رو با Pandasآماده کنیم.
بیاید برگردیم به دیتاستمون و دستور های Pandas رو یادآوری کنیم.
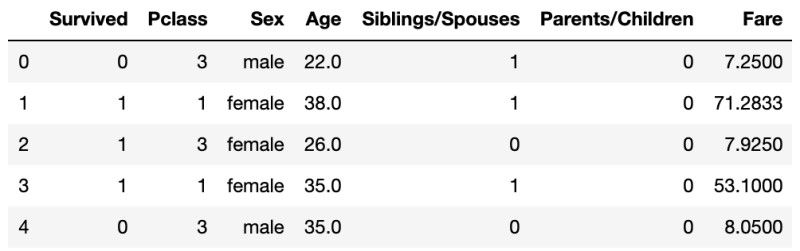
اول، باید تمام ستون هامون رو عددی کنیم. این کارو با عددی کردن ستون Sex انجام میدیم.
df['male'] = df['Sex'] == 'male'
حالا، بیاید تمام فیچر هارو جمع کنیم و یه آرایه numpy به نام x بسازیم. ما اول تمام ستون هایی که مد نظرمون هستن رو انتخاب میکنیم و متود values رو روشون میزنیم تا به آرایه numpy تبدیل بشن.
X = df[['Pclass', 'male', 'Age', 'Siblings/Spouses', 'Parents/Children', 'Fare']].values
حالا بیاید تارگت رو بگیریم و اون رو تو متغیری به نام yذخیره کنیم.
y = df['Survived'].values
کد کامل:
import pandas as pd
df = pd.read_csv('https://sololearn.com/uploads/files/titanic.csv')
df['male'] = df['Sex'] == 'male'
X = df[['Pclass', 'male', 'Age', 'Siblings/Spouses', 'Parents/Children', 'Fare']].values
y = df['Survived'].values
print(X)
print(y)
یه عادت رایج اینه که ما آرایه 2 بعدی فیچر هامون رو x و آرایه 1 بعدی تارگتمون رو y نام گذاری کنیم.
با ایمپورت کردن لاجیستیک رگرشن شروع میکنیم.
from sklearn.linear_model import LogisticRegression
تمام مدل های sklearnبه عنوان کلاس های پایتون ساخته میشن. اول یه ممبر از کلاس میسازیم:
model = LogisticRegression()
حالا ما میتونیم از دیتایی که قبلا آماده کردیم برای train(تمرین دادن) کردن مدلمون استفاده کنیم. متود fit برای ساخت مدل استفاده میشه. 2 آرگیومنت میگیره: X ( که همون فیچر هامون و یه آرایه 2بعدی هست) و y ( که تارگتمون و یه آرایه 1 بعدی هست).
برای سادگی، بیاید اول فرض کنیم ما یه مدل لاجیستیک رگرشن رو فقط بر حسب کرایه و سن میسازیم.
X = df[['Fare', 'Age']].values
y = df['Survived'].values
حالا از متود fit استفاده میکنیم تا مدل رو بسازیم.
model.fit(X, y)
فیت کردن مدل به معنی اینه که ما داریم از دیتا استفاده میکنیم تا بهترین خط رو پیدا کنیم.
میتونیم ضریب هامون رو با اتریبیوت های coef_ و intercept_ببینیم.
print(model.coef_, model.intercept_)
کد کامل:
import pandas as pd
from sklearn.linear_model import LogisticRegression
df = pd.read_csv('https://sololearn.com/uploads/files/titanic.csv')
X = df[['Fare', 'Age']].values
y = df['Survived'].values
model = LogisticRegression()
model.fit(X, y)
print(model.coef_, model.intercept_)
خروجی:
[[ 0.01615949 -0.01549065]] [-0.51037152]
این مقدار به این معنیه که معادله ما به این شکله:
0 = 0.0161594x + -0.01549065y + -0.51037152
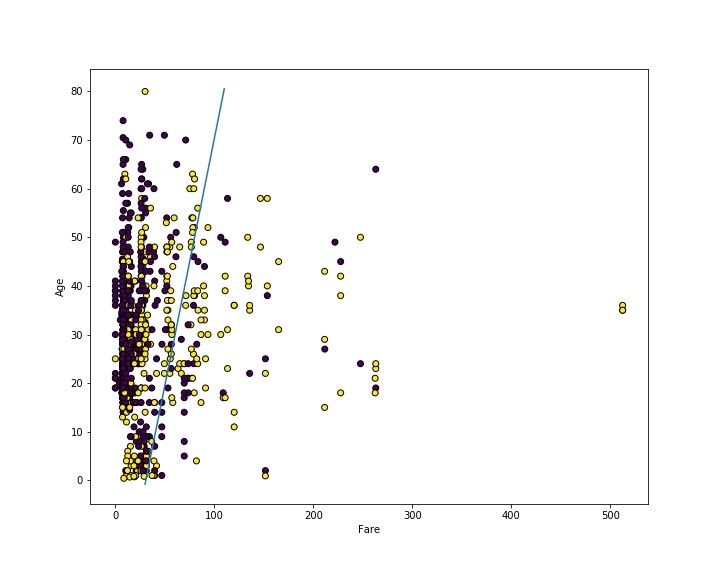
این خطیه که روی گراف کشیده میشه. میتونید ببینید که کارش تو جدا کردن نقاط زرد و بنفش خوبه ( اما عالی نیست).
ما خودمون رو با استفاده کردن از 2تا از فیچرها محدود کردیم، پس در بخش های بعدی از همه فیچر ها استفاده میکنیم.
ممکنه حفظ کردن عبارات import برای هر مدل sklearnسخت باشه، اگه یادتون نمیمونه از داکیومنتیشن scikit-learn استفاده کنید.
ما خودمون رو با استفاده کردن از فقط 2تا از فیچر ها در قسمت قبلی واقعا محدود کردیم. پس بیاید مدلمون رو با به کار بردن همشون دوباره بسازیم.
X = df[['Pclass', 'male', 'Age', 'Siblings/Spouses', 'Parents/Children', 'Fare']].values
y = df['Survived'].values
model = LogisticRegression()
model.fit(X, y)
حالا میتونیم از متود predict استفاده کنیم تا پیشبینی انجام بدیم.
اولین مسافر دیتاست به این شکله:
[3, True, 22.0, 1, 0, 7.25]
این به این معنیه که مسافر در Pclass 3، مذکر، 22ساله، دارای یک همراه(خواهر برادر یا همسر)، 0 والد یا فرزند و 7.25 دلار پرداخت کرده. بیاید ببینیم مدل برای این مسافر چه چیزی پیشبینی میکنه. حواستون باشه که حتی اگر فقط 1 دیتاپوینت هم به مدل بدین متود predict یه آرایه 2بعدی numpy رو میگیره و یه آرایه 1 بعدی برمیگردونه.
print(model.predict([[3, True, 22.0, 1, 0, 7.25]]))
خروجی:
[0]
خروجی ما 0 هست که به این معنیه که مدل پیشبینی میکنه که مسافر زنده نمونده.
بیاید ببینیم مدل ما برای 5 ردیف اول دیتا چی پیشبینی میکنه و با آرایه تارگت مقایسش کنیم.
print(model.predict(X[:5]))
# [0 1 1 1 0]
print(y[:5])
# [0 1 1 1 0]
بنظر میاد همرو درست پیشبینی کردیم!
ما میتونیم با شمردن تعداد دیتاپوینت هایی که درست پیشبینی شدن یه کلیتی از صحت کارکرد مدلمون بدست بیاریم. به این میگن امتیاز دقت ( accuracy score ).
یه آرایه از مقادیر yپیشبینی شده درست میکنیم:
y_pred = model.predict(x)
حالا میتونیم یه آرایه از مقادیر Boolean درست کنیم که نشون بده آیا مقادیر درست پیشبینی شدن یا نه:
y == y_pred
برای گرفتن تعداد این پیشبینی های درست، میتونیم از تابع جمع زدن numpyاستفاده کنیم.
print((y == y_pred).sum())
خروجی:
714
این به این معنیه که از 887 دیتاپوینت، مدل 714 مورد رو درست پیشبینی میکنه.
برای گرفتن درصد صحیح، این مقدار رو تقسیم بر تعداد کل مسافرین میکنیم. تعداد کل مسافرین رو با استفاده از اتریبیوت shape بدست میاریم.
امتیاز دقت ( اکیورسی اسکور) به شکل زیر به دست میاد:
print((y == y_pred).sum() / y.shape[0])
خروجی:
0.8049605411499436
پس دقت مدل ما 80 درصد هست. در واقع، مدل ما درباره 80% دیتاپوینت ها پیشبینی درستی رو ارائه میده.
انجام این محاسبه رایجه اما خود sklearn این فرمول رو برای ما در قالب متود scoreآماده کرده. متود scoreاز مدل برای پیشبینی x استفاده میکنه و درصد تطابق اونهارو با yمیشمره.
print(model.score(X, y))
خروجی:
0.8049605411499436
با این روش جایگزین برای محاسبه دقت، ما همان مقدار، 80٪ را دریافت می کنیم.

