
لازم به ذکره این دوره نسخه ترجمه شده دوره ماشین لرنینگ سایت SoloLearn هست و من فقط ترجمه اون رو انجام دادم.
در این قسمت ما با کتابخونه Pandas آشنا میشیم.
این کورس با زبان پایتون که یکی از پراستفاده ترین زبان ها برای ماشین لرنینگ است نوشته شده.
یکی از دلایل ما اینه که ماژول های مفید متعددی برای کار کردن با دیتا در پایتون وجود داره. اولین ماژولی که ما قراره معرفی کنیم اسمش Pandas هست.
درواقع Pandas یه ماژول پایتونه که به ما کمک میکنه اطلاعات رو بخونیم و دستکاری کنیم. یکی از چیزای باحال راجب Pandas اینه که شما میتونید دیتا رو وارد کنید و به شکل یه جدول (table) ببینیدش که خیلی خوانا تره، ولی همچنین اطلاعات میتونه بصورت عددی تفسیر بشه که بتونید روش یه عالمه محاسبه انجام بدید.
ما به جدول اطلاعات میگیم چارچوب داده(DataFrame / دیتا فریم).
پایتون تمام نیاز های ماشین لرنینگی مارو برآورده میکنه. ما از Pandas برای دستکاری دیتا استفاده میکنیم.
با ایمپورت کردن Pandas شروع میکنیم. یه عادت رایج اینه که Pandas رو با اسم pd ایمپورت کنیم که بعدا بشه راحت تر تایپش کرد.
import pandas as pd
ما با یه دیتاست از مسافران تایتانیک کار خواهیم کرد. درباره هر مسافر ما یک سری اطلاعات به علاوه اینکه آیا از حادثه زنده موندن یا نه داریم.
اطلاعات ما به فرمت CSV ( Comma-Separated values) ذخیره شده. فایل titanic.csv در پایین قرار گرفته. اولین خط هدر (header / سرتیتر) و هر خط بعدیش اطلاعات یه مسافره.
Survived,Pclass,Sex,Age,Siblings/Spouses,Parents/Children,Fare
0,3,male,22.0,1,0,7.25
1,1,female,38.0,1,0,71.2833
1,3,female,26.0,0,0,7.925
1,1,female,35.0,1,0,53.1
ما قراره دیتا رو به Pandas بدیم تا بتونیم به شکل یه دیتافریم ببینیمش.
تابع read_csv یه فایل به فرمت csv رو میگیره و به یه دیتافریم pandas تبدیلش میکنه.
df = pd.read_csv(‘titanic.csv’)
الان dfدیتافریم pandas ماست که دیتاست تایتانیک رو توی خودش داره.
حالا ما میتونیم از متود headاستفاده کنیم تا به دیتامون یه نگاهی بندازیم. متود head 5 ردیف (row) اول دیتافریم رو برمیگردونه.
print(df.head())
خروجی:
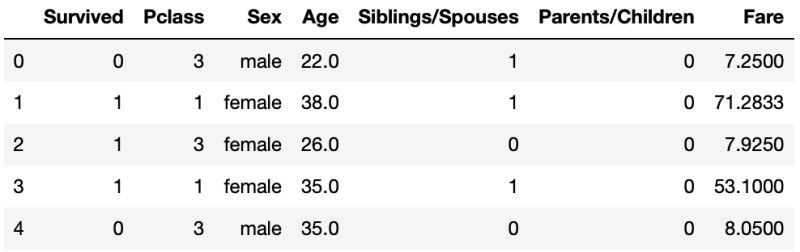
دیتا عموما به صورت فایل های csv ذخیره میشه، که ما میتونیم به آسونی با تابع read_csv اون رو بخونیم. متود head 5ردیف اول رو برمیگردونه.
معمولا، دیتای ما برای اینکه ما همش رو یکجا نمایش بدیم خیلی بزرگه.نگاه کردن به ردیف های اول اولین قدم برای درک کردن دیتامونه، اما، ما بعدش میخوایم که به یه سری آمار خلاصه شده نگاه کنیم.
میتونیم تو pandas از متود describe (توصیف) استفاده کنیم. این متود به ما یه جدول از آمار راجع به ستون ها ( columns ) بر میگردونه.
print(df.describe())
ما همچنین یه خط به کد زیر اضافه میکنیم تا پایتون رو مجبور کنیم هر 6تا ستون رو بهمون نشون بده. بدون این خط کد پایتون نتایج رو خلاصه میکنه.
import pandas as pd
pd.options.display.max_columns = 6
df = pd.read_csv('https://sololearn.com/uploads/files/titanic.csv')
print(df.describe())
خروجی:
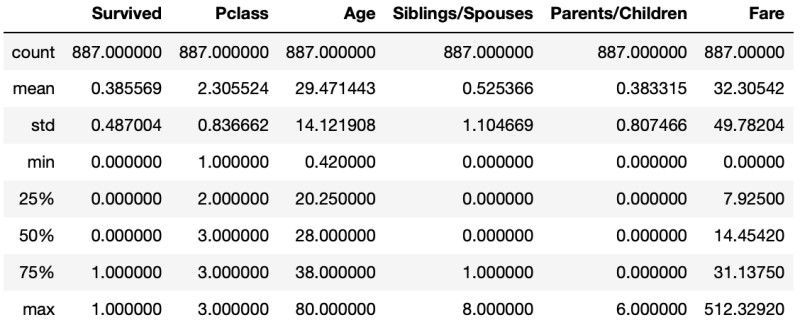
برای هر ستون ما چند آمار میبینیم. حواستون باشه که این آمار فقط برای ستون های عددی هستن.
بیاید مرور کنیم هرکدوم از این آمار چه معنی دارن:
Count -> تعداد ردیف هاییه که مقدار (value) دارن. در این کیس ما ( تایتانیک) همه مسافرا به ازای هر ستون یه مقدار دارن، پس مقادیرمون 887 تان که تعداد کل مسافر هاست.
Mean -> همون میانگین ماست.
Std -> خلاصه شده عبارت standard deviationهست. انحراف معیار یه معیار برای نشون دادن پراکندگی دیتاست.
مینیمم یا Min -> کمترین مقدار
25% -> چارک اول (چارک25)
50% -> چارک دوم (چارک 50) همون میانه.
75% -> چارک سوم ( چارک 75)
ماگزیمم یا Max -> بزرگترین مقدار (ماگزیمم)
ما برای اینکه یه دید اولیه از دیتامون پیدا کنیم از متود describe استفاده میکنیم
ما معمولا فقط با بعضی از ستون هایی که تو دیتاست داریم سر و کله میزنیم. برای اینکه یه ستون رو انتخاب کنیم، از Square Bracket ها و اسم ستون استفاده میکنیم:
در این مثال ما ستونی که اطلاعات کرایه ( Fare ) مسافرین رو داره انتخاب میکنیم
Col = df[‘Fare’]
print(col)
نتیجه کد بالا چیزیه که ما بهش میگیم یه سریِ Pandas (Pandas Series).
یه سری مثل یه دیتافریم میمونه، اما فقط یه ستونه.
“یه سری pandas یه ستون از یه دیتافریم pandas هست"
کد کامل:
import pandas as pd
df = pd.read_csv('https://sololearn.com/uploads/files/titanic.csv')
col = df['Fare']
print(col)
ما همچنین میتونیم چندین ستون از دیتافریم اولیه مون رو انتخاب کنیم و درواقع یه دیتافریم کوچیک تر ایجاد کنیم.
ما قراره فقط ستون های Age ، Sex ، و Survived رو از دیتافریم اصلیمون انتخاب کنیم
ما این مقادیر رو به این شکل توی یه لیست میزاریم:
[‘Age’, ‘Sex’, ‘Survived’]
حالا ما این لیست رو میزاریم بین همون bracket های سابقمون. وقتی یه دیتافریم خیلی واسه نمایش داده شدن بزرگه، میتونید از متود head استفاده کنید تا فقط 5 ردیف اولش رو پرینت کنید:
small_df = df[['Age', 'Sex', 'Survived']]
print(small_df.head())
کد کامل:
import pandas as pd
df = pd.read_csv('https://sololearn.com/uploads/files/titanic.csv')
small_df = df[['Age', 'Sex', 'Survived']]
print(small_df.head())
خروجی:
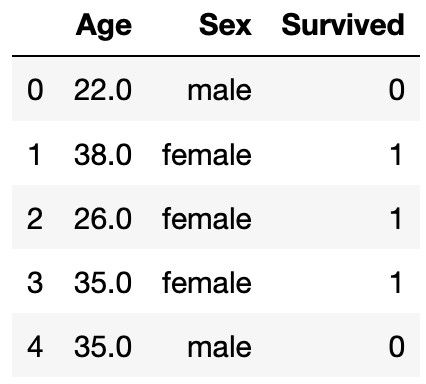
وقتی فقط داریم یه ستون از دیتافریم جدا میکنیم، از یه جفت Square Bracket استفاده میکنیم، اما وقتی چندین ستون رو میخوایم انتخاب و جدا کنیم؛ از 2 جفت Square Bracket استفاده میکنیم.
ما معمولا دیتامون رو به شکل متفاوتی از شکلی که بهمون داده میشه و هست، میخوایم. مثلا دیتای ما جنسیت مسافر رو به شکل یه string ( “male” برای مرد و “female”برای زن) داره. شکلی که الان داره بسیار واسه ما آدما مناسبه و خوندنش راحته؛ اما وقتی ما بعدا بخوایم محاسبات روی دیتامون انجام بدیم؛ ما این ستون جنسیت رو به شکل مقادیر Boolean(True/False) میخوایم.
ما میتونیم به راحتی توی دیتافریمی که داریم ستونی ایجاد کنیم که اگر مسافرمون مرد بود مقدار True و اگر زن بود مقدار False رو داشته باشه.
حالا اول میایم ستون Sex رو انتخاب میکنیم:
df[‘Sex’]
ما یه سری pandas درست میکنیم که قراره یه مجموعه از True ها و False ها باشه (اگر مسافرمون مرد بود مقدار True و اگر زن بود مقدار False)
print(df['Sex'] == 'male')
حالا ما میخوایم با این نتایج یه ستون بسازیم. برای ساختن یه ستون جدید ما از همون سینتکس بِرَکِت دار استفاده میکنیم و این مقدار جدید رو بهش میدیم:
df[‘male’] = df[‘Sex’] == ‘male’
کد کامل:
import pandas as pd
df = pd.read_csv('https://sololearn.com/uploads/files/titanic.csv')
df['male'] = df['Sex'] == 'male'
print(df.head())
دیتافریم ما الان به شکل تصویر زیر هست. به ستون جدید در انتها توجه کنید:
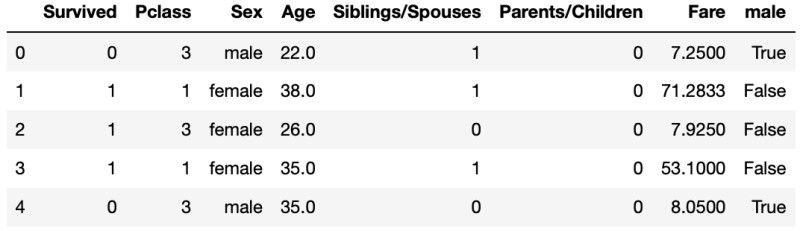
معمولا دیتای ما در فرمت ایده آلی قرار نداره. خوشبختانه pandas ساختن ستون های جدید برحسب اطلاعاتمون رو آسون کرده و واسه همین ما میتونیم دیتامون رو اونطوری که میخوایم بچینیم.

