
در اولین قسمت از این مجموعه در مورد تعریف کلی و مزایا و معایت میکروسرویسها صحبت کردیم. در دومین قسمت به سراغ API Gatewayها، نقش آنها در توسعه میکروسرویس و ویژگیها یک API Gateway رفتیم. سپس در قسمت سوم در مورد ارتباط بین سرویسها و انواع روشهای برقراری ارتباط صحبت کردیم و نهایتا در چهارمین قسمت در مورد تکنولوژیهای توسعه میکروسرویسها صحبت کردیم. سپس در پنجمین قسمت از این مجموعه در مورد Service Discovery مطالبی را بررسی کردیم. در ششمین قسمت از این مجموعه در مورد دادهها و مدیریت گردش اطلاعات در میکروسرویسها مطالبی را بیان کردیم. و در هفتمین قسمت از این مجموعه در مورد نحوه انتشار میکروسرویسها صحبت کردیم. در این مطالب به بررسی نحوه مهاجرت از یک پروژه Monolith به Microservice صحبت خواهیم کرد.
این هشتمین و آخرین مطلب در این سری مقالات هست. امیدوارم مفید بوده باشه و در این قسمت آخر سعی میکنم مطالبی که برای مهاجرت از Monolith به Microservice نیاز هست بیان کنم و در نهایت تاکید میکنم مثل همه موارد دیگر در دنیای نرمافزار، هیچ کدام از این معماریها انتخاب اصلی نیست و برتری مطلق نسبت به دیگری ندارد، بلکه ابزاری هستند در درستان توسعه دهنده باهوش و باتجربه تا پروژه به سرانجام برسد.
1. مقدمه:
مهاجرت از Monolith به Microservice یکی از روشهای مدرنسازی فرایند کاری است که هم در دنیای نرمافزار و هم در زندگی روزمره انجام میشود. حتما همه ما تجربیاتی روی مهاجرت از فریمورکی قدیمی به جدید داشته ایم، یا در زندگی روزمره برای خود ما یا یکی از بستگان فرایند به روز رسانی محیط زندگی اتفاق افتاده، که این به روز رسانی میتواند باز سازی منزل، خرید اسباب جدید یا خرید خانه جدید باشد. به هر حال با توجه به اینکه این یک فرایند تکراری است، احتمالا تجربیات مشترکی نیز در این زمینه وجود دارد که میتوانیم از این تجربهها استفاده کنیم.
قبل از شروع کل مطلب باید به این نکته توجه کنیم که انواع روشهای مهاجرت وجود دارد که یکی از آنها Big Bang است. در این روش شما کل نرمافزار قدیمی را کنار میگذارید و از ابتدا شروع به بازسازی نرمافزار با فریمورک و معماری جدید میکنید. به طور جد تاکید میکنم که از این کار دوری کنید. این روش انجام مهاجرت به شدت ریسک بالایی دارد و احتمال شکست پروژه در این شرایط بسیار بالا میرود. استاد مسلم حوزه نرمافزار مارتین فاولر در این زمینه میگه:"تنها چیزی که در فرایند Big Bang تظمین شده است، Big Bang است." هیچ تضمین دیگری وجود ندارد.
به جای این کار بهتر است این فرایند را یک مهاجرت تدریجی در نظر بگیریم و رفته رفته بخشهایی از نرمافزار خود را به معماری جدید مهاجرت دهیم. در این شرایط تا مدتی بخشهایی از نرمافزار میکروسرویس است و بخشهایی کماکان به صورت Monolith کار میکند و کمکم به بخشهای جدید افزوده میشود و بخشهای قدیمی از بین میروند تا زمانی که کل اپلیکیشن به Microservice مهاجرت میکند و بخشهای قدیمی ناپدید میشوند. اگر مثالی از دنیای واقعی بخواهیم بیاوریم مانند وقتی که خانه را بازسازی میکنیم بهتر است در خانه باشیم و مدتی از این اتاق به آن اتاق برویم تا اینکه یک شبه خانه را خراب کنیم برای بازسازی و تا مدتها برای زندگی جایی نداشته باشیم.
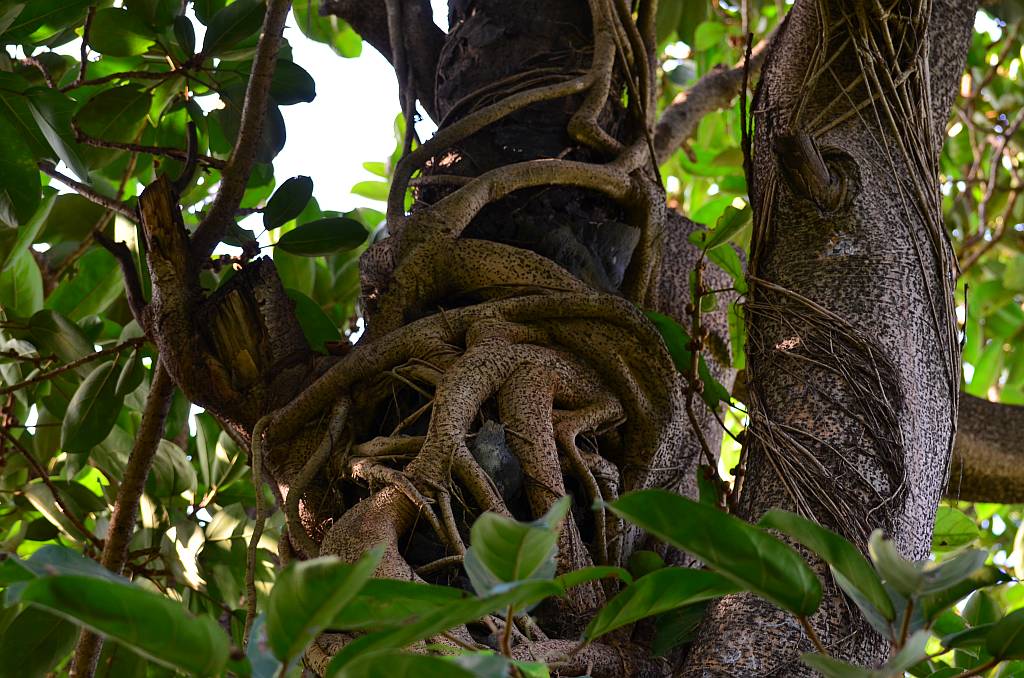
این روش مهاجرت را اصطلاحا اپلیکیشنهای خفهکننده میگویند. این اصطلاح از درختان خفه کننده جنگلهای بارانی گرفته شده است. این گیاهان به پایههای درختان میچسبند و خود را از تنه درختان بالا میکشند تا به روشنایی خورشید برسند و آنقدر رشد میکنند و جلوی نور خورشید را برای درختان میگیرند تا درختان میمیرند و جنگلی از گیاهان خفه کننده ایجاد میشود. ما اینقدر میکروسریسهایمان را روی پایههای Monolith میسازیم تا در نهایت Monolith نابود شود.
حال بیاید انواع روشهای پیاده سازی این روش را بررسی کنیم.
2. روش اول - کار را متوقف کنید:
قانون اول حفرهها به ما میگویند زمانی که در یک چاه گیر افتادید اول از همه کندن را متوقف کنید. اگر نرمافزاری دارید که مدیریت آن برای شما تبدیل به کابوس شده است حتما این نصیحت را بپذیرید و ادامه فرایند را متوقف کنید. در این شرایط هر زمانی که شما ویژگی جدیدی پیاده میکنید نباید آن را به پروژه Monolith خود اضافه کنید. شما باید همه کارهای جدید خود را با معماری جدید ایجاد کنید. در تصویر زیر نحوه انجام این کار را مشاهده میکنید.
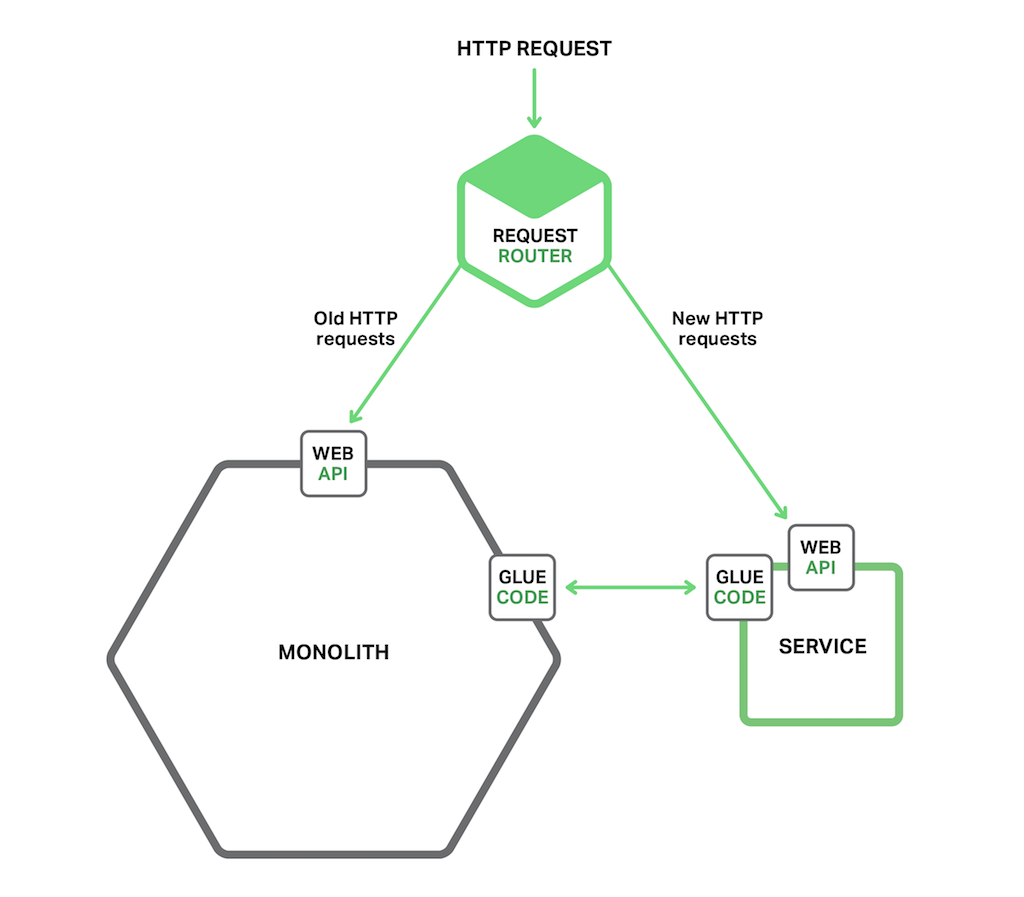
همانطور که در تصویر مشاهده میکنید در کنار بخش Monolith و Microservice دو عنصر دیگر نیز نیاز داریم تا خدمات را به صورت کامل ارائه دهیم. ابتدا به ماژولی به عنوان Request Router نیاز داریم که عملکردی شبیه به API Gateway دارد که در بخشهای قبل مشاهده کردهایم. در این ماژول تصمیم گیری میشود درخواست ورودی به کدام یک از بخشهای برنامه باید ارسال شود. بخش بعدی که اگر با توسعه کامپوننت محور آشنای باشید قطعا با آن آشنا هستید، GLUE CODE است. تا زمانی که دو اپلیکیشن با هم وجود دارند ممکن است که به خدمات یکدیگر نیاز داشته باشند و انجام این خدمات به کمک GLUE CODE انجام میشود که میتواند هم در Microservice و هم در Monolith ما وجود داشته باشد. در این شرایط اگر Microservice مثلا نیاز به دادهای که در اختیار Monolith است داشته باشد، این کار را از طریق GLUE CODEها انجام میدهد. هنگامی که Microservice ما نیاز به این دادهها داشته باشد، به سه روش مختلف میتواند این کار را انجام دهد.
با توجه به اینکه Microservice ما معمولا Domain Model اختصاصی خود را دارد، و GLUE CODE از آلوده شدن این مدل با Domain Model موجود در برنامه Monolith جلوگیری میکند آن Anti-Corruption Layer نیز گفته میشود. عملا GLUE CODE کار ترجمه و تبدیل مدلها به یکدیگر را انجام میدهد.Anti-Corruption Layer اولین بار در کتاب DDD آقای Eric Evans معرفی شد و بعدا در مقاله ای با عنوان DDD Surrounded by Legacy Software تشریح شد و پیشنهاد میکنم اگر علاقه مند به این موضوع هستید این مقاله جذاب را از دست ندهید.
اگر از علاقه مندان به DDD باشید حتما با Anti-Corruption Layer هم آشنا هستید که اولین بار توسط Eric Evans معرفی شد و بعدا در مقاله توضیحات کاملتری در مورد آن ارائه شد. شاید توسعه Anti-Corruption Layer کار سختی به نظر برسد و عدم تعهد به توسعه آن باعث پیچیدگیهای در انجام کار شود، اما باورد کنید اگر میخواهید بدون درد سر بتوانید از این چالش خارج شوید به آن نیاز دارید.
توسعه بخشهای جدید به صورت سرویسهای جدید و سبک مزایایی به همراه دارد که عبارتند از
اگر کمی در این روش دقیق شویم، متوجه میشویم که این روش هیچکدام از معایب Monolithها را به طور مستقیم رفع نمیکند و برای رفع آنها باید کار را با سایر روشها ادامه دهیم.
3. روش دوم - جداسازی Frontend و Backend:
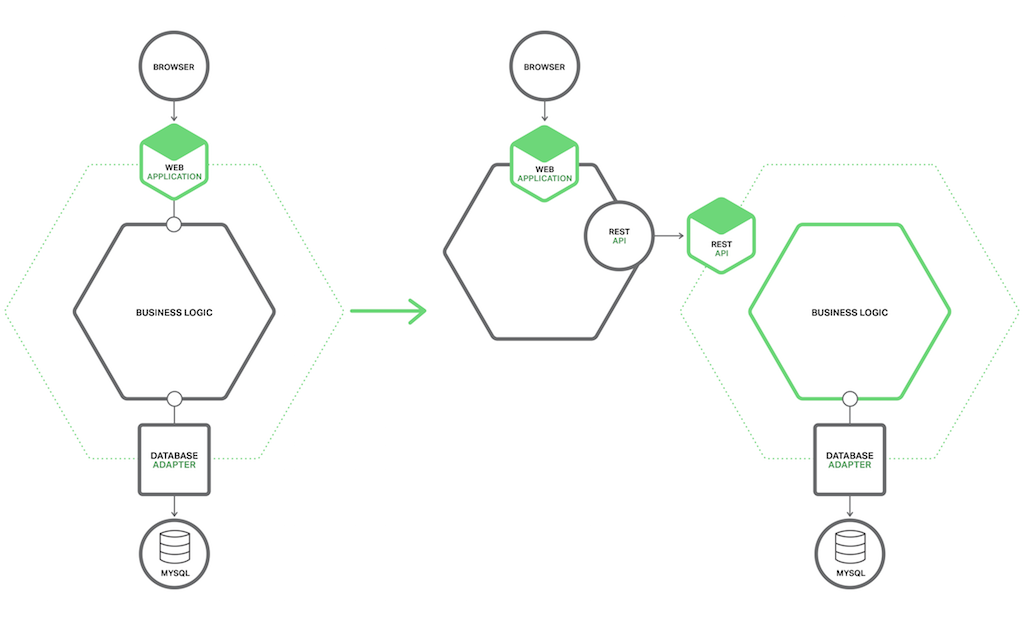
یکی از روشهای خورد کردن یک Monolith جداسازی لایه Frontend از Backend است. اغلب نرمافزارهای Enterprise از سه بخش عمده به شرح ذیل تشکیل شدهاند:
اگر معماری داخلی نرمافزار خوب داشته باشیم، معمولا تفکیک خوبی بین لایه ارائه و لایههای منطق و دادهها وجود دارد. اگر این کار را به خوبی انجام داده باشیم، لایه منطق خدمات خود را از طریق تعدادی سرویس در اختیار لایه ارائه قرار میدهد و این کار باعث میشود بتوانیم یک Monolith را به دو قسمت Frontend و Backend بشکنیم. در یک نرمافزار عملیات مربوط به لایه ارائه انجام میشود و در نرمافزار دیگر لایههای منطق و داده قرار میگیرند. بعد از این جداسازی لایه Frontend میتواند از طریق توابع Remote به عملیات موجود در لایه منطق دسترسی داشته باشد که نحوه انجام این کار را در تصویر پایین مشاهده میکنید.
تقسیم یک نرمافزار به این روش مزایای زیر را به دنبال دارد
هرچند با جدایی این دو قسمت از هم مزایای زیادی به دست میآوریم، اما هنوز مشکلات فراوانی باقی مانده است که برای حل آنها باید به راه خود ادامه دهیم.
4. روش سوم - استخراج سرویس:
سومین کاری که میتوانیم انجام دهیم این است که ماژولهای اصلی سیستم را تشخیص دهیم و هر کدام را به یک سرویس مجزا منتقل کنیم. با جدایی هر ماژول و خارج کردن هر ماژول بخشی از Monolith خورد میشود. بعد از انجام این کار یا به طور کل مشکل Monolith رفع میشود یا صورت مسئله ما به اندازه کافی شکسته شده و سادهتر میتوانیم آن را حل و فصل کنیم.
4.1. اولیت بندی ماژولها برای تبدیل به سرویس:
یک نرمافزار Monolith که سالها در حال توسعه بوده است ممکن است شامل دهها یا صدها ماژول متفاوت باشد که همگی کاندیدای تبدیل شدن به سرویس مجزا هستند. تعیین اولین ماژولی که قرار است تبدیل به سرویس شود همیشه یک چالش بزرگ است. یکی از راهکارهای اولویت بندی ماژولها انتخاب ماژولهای سادهتر برای مهاجرت است. با این روش هم طعم میکروسرویس را میچشیم و هم با فرایند مهاجرت از Monolith به Microservice آشنا میشویم.
بعد از اینکه مدتی بر مبنای سادگی ماژولها را جدا کردیم میتوانیم روش خود را عوض کرده و به سراغ ماژولهایی برویم که ارزشمندی بیشتری برای ما ایجاد میکنند و سادگی یا پیچیدگی کار را در اولویت بعدی قرار دهیم.
در مرحله بعد شاید بهتر باشد باز هم استراتژی خود را تغییر دهیم و برای ادامه کار ماژولهایی را انتخاب کنیم که معمولا تغییرات بیشتری به سمت آنها میآید. با این کار با توجه به اینکه فرایند توسعه و انتشار این سرویسها مستقل از کل اپلیکیشن انجام میشود، تیم توسعه شرایط کاری بهتری را تجربه خواهد کرد.
در ادامه اگر خواستیم استراتژی انتخاب خود را تغییر دهیم میتوانیم به منابع توجه کنیم. ماژولهایی که نیازمندی بسیار متفاوتی از سایرین دارند بهتر است زودتر از سایر بخشها جدا شوند. برای مثلا شاید خوب باشد ماژولی که مصرف حافظه زیادی دارد زودتر جدا کنیم تا بتوانیم آن را روی ماشینی که RAM زیادی دارد به طور مستقل اجرا کنیم. با انجام این روش جدا سازی شما اپلیکیشخود را از نظر مقیاس پذیری بهینه میکنید.
دقت کنید که این ترتیب اولویت بندی صرفا پیشنهاد است و شاید در حوزه کاری که با آن سر کار دارید با توجه به شرایط نیاز باشد اولیت بندی دیگری را در نظر بگیرید.
4.2. چگونگی انتقال ماژولها:
اولین کاری که در این فرایند باید انجام دهیم تعیین واسطی جهت تبادل دادهها بین Monolith و میکروسرویس است. این کار را به این دلیل انجام میدهیم که ماژول های مختلف نیاز به تبادل دادهها دارند این دو نرمافزار Monolith و میکروسرویس به دلایل مختلف ناچار به ارسال و دریافت داده به هم هستند. شاید یکی از سختترین بخشهای کار همین تعیین واسط است، به این خاطر که با توجه به عدم وجود مرزبندی دقیق بعضا دسترسیهای غیر مجازی بین ماژولها ایجاد شده است. در برخی موارد انتخاب روش پیاده سازی لایه منطق نیز ممکن است پیچیدگی این کار را دو چندان کند. شاید مجبور شویم برای از بین بردن وابستگیهای اشتفاه بین ماژولها مقداری کد نویسی کنیم.
بعد از تعیین این واسط و جدا سازی کامل ماژولها وقت آن میرسد که ماژول خود را به یک سرویس کاملا مجزا انتقال دهیم و کمی کد نویسی انجام دهیم تا ارتباط بین Monolith و میکرسرویس ما برقرار شود نرمافزار مانند گذشته به کار خود ادامه دهد. مراحل انجام این کار در تصویر زیر قابل مشاهده است.
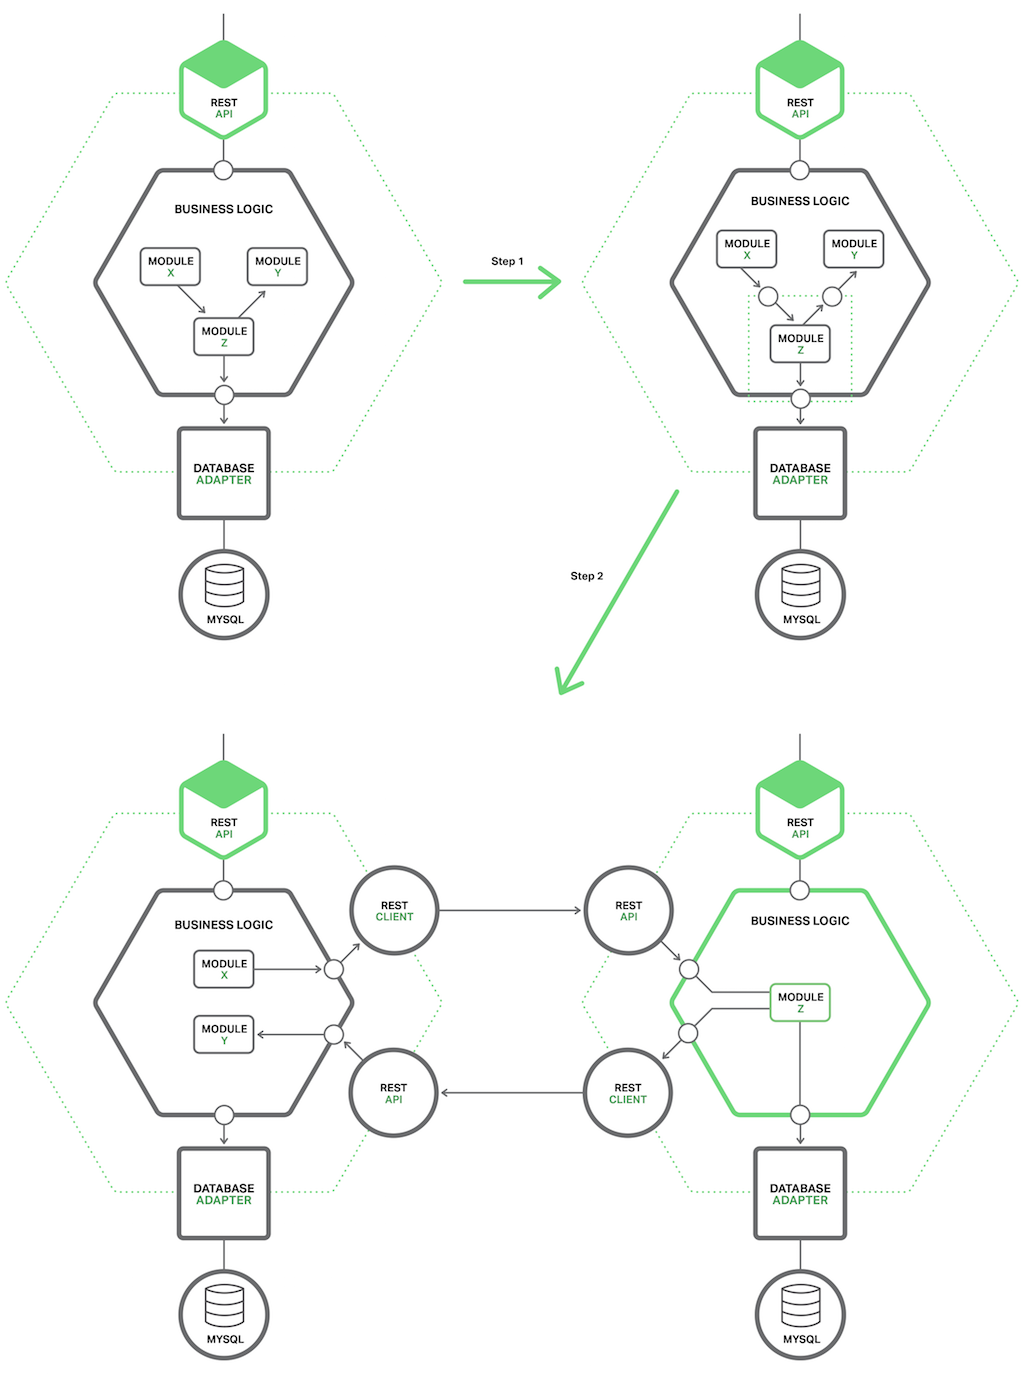
در این تصویر ماژول Z برای انتقال انتخاب میشود. همانطور که مشاهده میکنید این ماژول خدماتی را از Y دریافت میکند و خدماتی نیز به X میدهد و بین این سه ماژول وابستگی وجود دارد. اولین قدم ما تعریف واسطی برای ارتباط بین X,Y و Z است.
بعد از این کار ماژول Z را به سرویسی مجزا تبدیل میکنیم و واسطهایی که برای ارتباط بین ماژولها تعریف شده را به کمک روالهای ارتباطی مختلفی که وجود دارد پیاده سازی میکنیم.
بعد از جدا سازی این ماژول، حال شما یک سرویس کاملا مستقل دارید که میتوانید آن را به تنهایی توسعه دهید و نگهداری کنید. ممکن است تصمیم بگیرید با توجه بهش رایط آن سرویسرا باز نویسی کنید یا اینکه اقدام به Refactor کردن آن سرویس بکنید. اگر تصمیم به باز نویسی سرویس بگیرید واسطی که قبلا طراحی کردهاید میتواند برای شما نقش Anti Corruption Layer را داشته باشد و از تاثیر گذاری روال توسعه قبلی به سرویس جدید جلوگیری کند. با جدا سازی هر ماژول شما قدمی به سمت میکروسرویس شدن Monolith خود برمیدارید و در نهایت آن غول بی شاخ و دم را نابود خواهید کرد.
5. خلاصه:
فرایند تبدیل یک Monolith به میکروسرویس یکی از کارهایی است که باید برای به روزرسانی سیستمها در صورت نیاز انجام دهیم و برای این کار نباید در ابتدای راه، اقدام به دور ریختن کد موجود کنیم. هر چند ممکن است بعد از گذشت مدتی و جدا سازی سرویسها برخی از آنها را کاملا دور بریزیم و از ابتدا باز نویسی کنیم، اما انجام این کار به طور کلی و در ابتدای راه ریسک بالایی را ایجاد خواهد کرد.

