
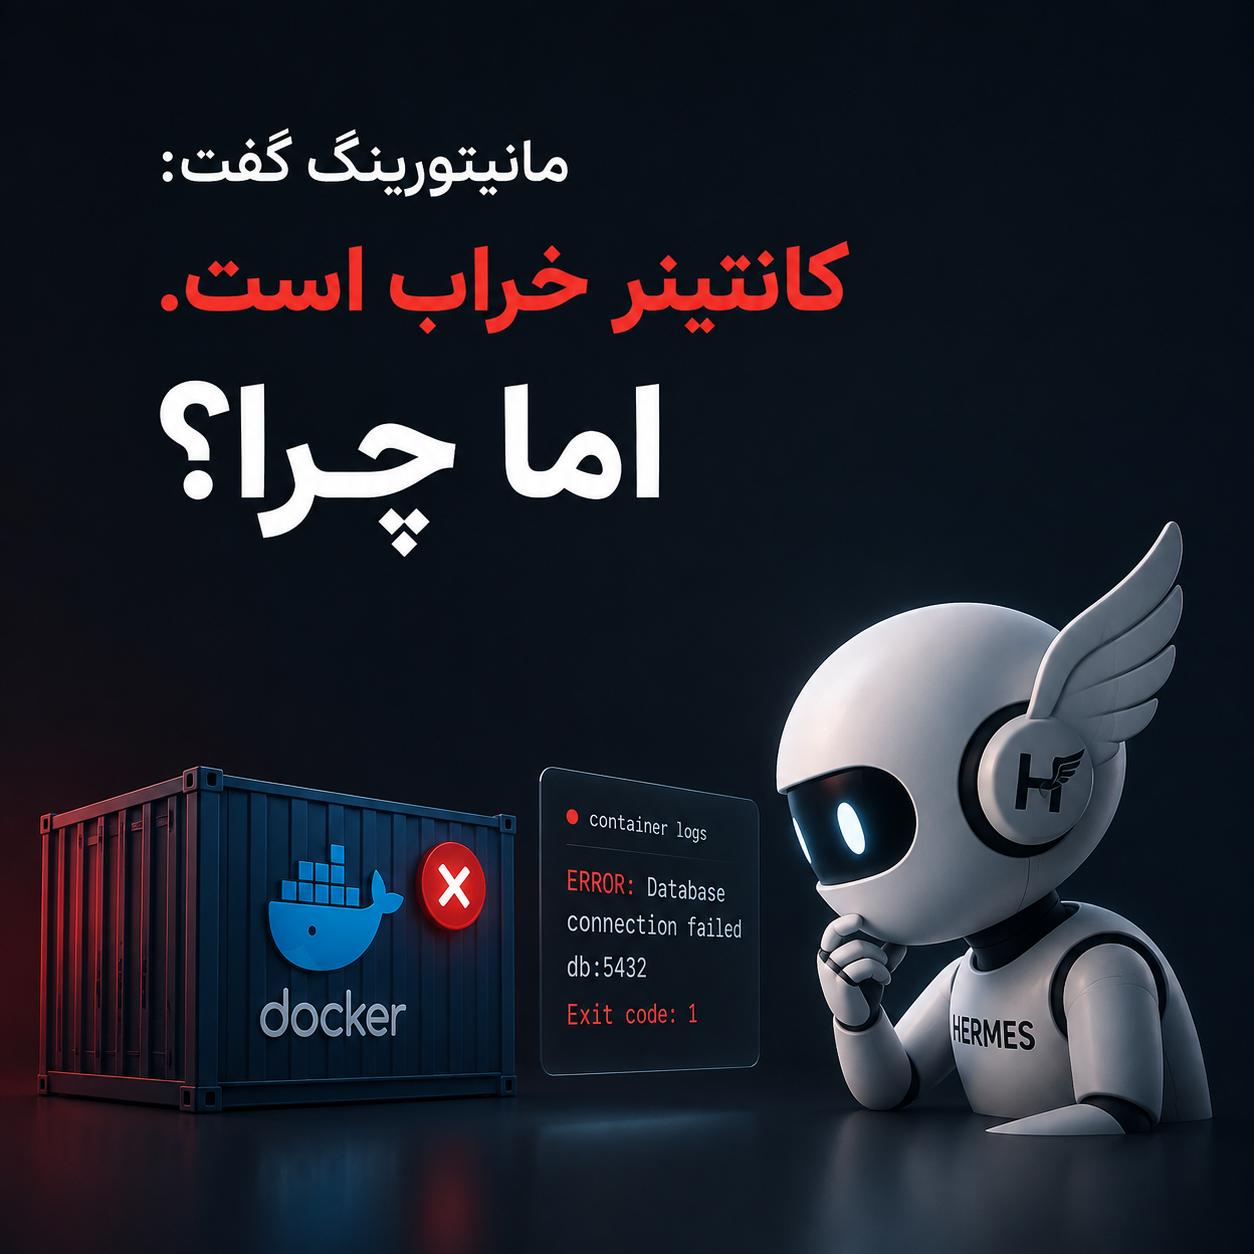
یک سیستم مانیتورینگ ممکن است خیلی سریع به شما بگوید:
Container خراب است.
اما معمولاً سؤال اصلی تازه از همینجا شروع میشود:
چرا خراب شده؟
در این مرحله، مهندس DevOps باید وارد محیط Docker شود، وضعیت Container را بررسی کند، Logها را بخواند و بر اساس اطلاعات موجود، علت احتمالی مشکل را پیدا کند.
من تصمیم گرفتم یک آزمایش ساده انجام دهم:
آیا میتوان این مرحلهی اولیهی بررسی را به یک AI Agent سپرد؟
هدف این آزمایش این نبود که AI جای مهندس DevOps را بگیرد یا خودش مشکل را برطرف کند.
فقط میخواستم ببینم آیا میتواند بعد از شناسایی یک Container مشکلدار، شواهد موجود را بررسی کند و یک تحلیل اولیه ارائه دهد.
فرض کنید در یک محیط Docker چندین سرویس در حال اجرا هستند.
یکی از Containerها Crash میکند.
سیستم مانیتورینگ ممکن است چیزی شبیه این گزارش کند:
Container: payment-service Status: Exited (1)
در اینجا Monitoring کار خودش را انجام داده است.
اما کار مهندس تازه شروع میشود.
معمولاً باید:
Container را پیدا کند.
Status و Exit Code را بررسی کند.
Logها را بخواند.
خطای اصلی را پیدا کند.
Context مربوط به خطا را بررسی کند.
علت احتمالی مشکل را پیدا کند.
تصمیم بگیرد چه اقدامی لازم است.
اگر این اتفاق ساعت ۳ صبح رخ دهد، همین چند دقیقه بررسی اولیه میتواند اهمیت زیادی داشته باشد.
پس سؤال اصلی این است:
آیا بخشی از این Investigation اولیه قابل واگذاری به AI است؟
برای بررسی این موضوع، یک AI Agent را وارد فرآیند کردم.
وظیفه Agent بسیار محدود بود.
قرار نبود:
Container را Restart کند.
Container را Stop یا Remove کند.
چیزی در Infrastructure تغییر دهد.
مشکل را به صورت خودکار برطرف کند.
فقط باید:
Observe → Investigate → Analyze → Report
را انجام میداد.
Workflow آزمایش به این شکل بود:
Docker
   ↓
Container Failure
   ↓
AI Agent
   ↓
Inspect Container
   ↓
Read Logs
   ↓
Analyze
   ↓
Initial Diagnosis
   ↓
Recommended Action
در واقع هدف این بود که Alert سادهی:
Container is Down
به گزارشی با Context بیشتر تبدیل شود.
هدف من ساخت یک سیستم Production-grade Incident Management نبود.
میخواستم یک سؤال مشخص را آزمایش کنم:
آیا یک Agent میتواند یک Container خراب را پیدا کند، Log آن را بخواند و علت احتمالی خرابی را تحلیل کند؟
Docker برای این آزمایش محیط مناسبی بود؛ چون میتوانستیم Failure را به صورت کنترلشده ایجاد کنیم و بعد نتیجهی تحلیل را با اطلاعات واقعی موجود در Log مقایسه کنیم.
برای آزمایش دو Container ساختم.
یکی سالم و دیگری عمداً خراب.
Container خراب طوری تنظیم شد که هنگام اجرا خطایی شبیه این در Log ایجاد کند:
Application starting...
ERROR: Database connection failed
ERROR: Unable to connect to PostgreSQL at db:5432
Application shutting down...
و سپس با:
exit 1
متوقف شود.
در نتیجه یک Failure واقعی در Docker داشتیم، اما محیط کاملاً تحت کنترل بود.
این موضوع مهم بود؛ چون میتوانستیم دقیقاً بدانیم مشکل چیست و بعد بررسی کنیم آیا Agent هم به همان نتیجه میرسد یا خیر.
برای اجرای آزمایش، یک Job زمانبندیشده ایجاد کردم که هر ۵ دقیقه اجرا میشد.
در هر اجرا، Agent باید محیط Docker را بررسی میکرد.
مراحل کار به این صورت بود:
بررسی Containerهای موجود
نادیده گرفتن Containerهای سالم
پیدا کردن Containerهای Exited، Dead یا Unhealthy
بررسی Status و Exit Code
خواندن Log
استخراج خطای احتمالی
تحلیل علت خرابی
مشخص کردن Impact
ارائهی Recommended Action
اما یک محدودیت مهم وجود داشت:
Agent کاملاً Read-only بود.
یعنی اجازه نداشت هیچ تغییری در محیط ایجاد کند.
برای مثال دستورات زیر در اختیار آن نبودند:
docker restart
docker stop
docker rm
همچنین اجازه تغییر در:
Container
Image
Network
Volume
را نداشت.
بنابراین اگر Agent اشتباه میکرد، نمیتوانست با یک تصمیم اشتباه وضعیت سیستم را تغییر دهد.
هدف فقط Investigation بود.
در این آزمایش از MCP استفاده نکردم.
Agent از ابزار Terminal برای اجرای دستورات موردنیاز استفاده کرد و اطلاعات Docker را از همان محیط دریافت کرد.
این تصمیم عمداً ساده نگه داشته شد.
چون هدف آزمایش بررسی قابلیت Investigation بود، نه طراحی یک معماری پیچیده.
به نظرم در یک PoC بهتر است ابتدا کمترین اجزای ممکن را وارد سیستم کنیم.
اگر با همین معماری ساده نتیجه قابل قبول باشد، بعداً میتوان سراغ اجزای پیچیدهتر رفت.
برای جدا کردن Investigation از ارسال گزارش، خروجی تحلیل در یک مرحلهی جداگانه پردازش شد.
ساختار کلی به این شکل بود:
Docker Engine
       ↓
   AI Agent
       ↓
Inspect Containers
       ↓
   Read Logs
       ↓
   AI Analysis
       ↓
 Incident Report
       ↓
 Python Notifier
       ↓
    Telegram
در این ساختار، Agent مسئول پیدا کردن مشکل و تحلیل آن بود.
ارسال نتیجه نیز توسط یک Script جدا انجام میشد.
این جداسازی باعث شد هر بخش مسئولیت مشخصی داشته باشد.
در اولین اجرا، Agent توانست Container خراب را پیدا کند:
poc-broken-app
و وضعیت آن را تشخیص دهد:
Exited (1)
اما قسمت مهمتر زمانی بود که Log را بررسی کرد.
Log شامل این خطا بود:
Database connection failed
Unable to connect to PostgreSQL at db:5432
Agent بر اساس این اطلاعات نتیجه گرفت:
Application هنگام Startup تلاش میکند به PostgreSQL در
db:5432متصل شود، اما ارتباط برقرار نمیشود.
سپس اطلاعات را به این شکل دستهبندی کرد:
Impact:
Application unavailable
Recommended Action:
بررسی وضعیت Database Container و Docker Network مشترک.
اینجا تفاوت بین Monitoring و Investigation مشخص میشود.
Monitoring میگوید:
Container is Down
اما Agent میتواند اطلاعات بیشتری ارائه کند:
Container is Down

Why?

Database connection failed.

Impact?

Application is unavailable.

What should be checked?

Database Container + Docker Network
البته این نتیجه همچنان یک تحلیل احتمالی است، نه یک Root Cause قطعی.
نتیجهی تحلیل برای ارسال به Telegram آماده شد:
📊 گزارش تحلیل وضعیت کانتینرهای Docker ❌ کانتینر دارای مشکل: نام: poc-broken-app وضعیت: Exited (1) ⚠️ خطا: Database connection failed 🔍 تحلیل: اپلیکیشن هنگام اجرا تلاش میکند به PostgreSQL در db:5432 متصل شود اما ارتباط برقرار نمیشود. ⚡ اثر: Application unavailable 🛠 اقدام پیشنهادی: بررسی وضعیت Database Container و Docker Network مشترک
نکته جالب این بود که آزمایش فقط به Container ساختهشده برای PoC محدود نماند.
در محیط واقعی Docker، چند Container دیگر که وضعیت غیرعادی داشتند نیز شناسایی شدند.
البته اینجا یک نکته مهم وجود دارد:
غیرعادی بودن وضعیت یک Container لزوماً به معنی وجود یک Incident واقعی نیست.
ممکن است Container عمداً متوقف شده باشد یا اصلاً دیگر مورد استفاده نباشد.
بنابراین تشخیص Agent باید همیشه با Context واقعی سیستم بررسی شود.
به نظرم این آزمایش بیشتر از اینکه این ایده را تأیید کند، خلاف آن را نشان میدهد.
حداقل در این سناریو، نه.
AI در اینجا جای Engineer را نگرفت.
کاری که انجام داد بخشی از Investigation اولیه بود:
جمعآوری Context → بررسی شواهد → تحلیل اولیه
اما هنوز یک انسان باید تصمیم بگیرد:
آیا تحلیل AI درست است؟
آیا Root Cause واقعاً همین است؟
آیا اطلاعات کافی وجود دارد؟
آیا Recommended Action امن است؟
آیا باید سرویس Restart شود؟
آیا مشکل از Application است یا Infrastructure؟
آیا این Failure بخشی از یک Incident بزرگتر است؟
بنابراین تقسیم کار میتواند چیزی شبیه این باشد:
Monitoring
↓
چه چیزی خراب شده؟
        ↓
AI Agent
↓
احتمالاً چرا خراب شده؟
        ↓
DevOps Engineer
↓
حالا چه کاری باید انجام شود؟
این مدل برای من جالبتر از ایدهی «AI جای DevOps را میگیرد» است.
این آزمایش یک سیستم Production-grade Incident Management نیست.
چند محدودیت مهم وجود دارد:
Root Cause ارائهشده توسط AI قطعی نیست.
Log ناقص میتواند باعث تحلیل اشتباه شود.
False Positive ممکن است اتفاق بیفتد.
Agent در این نسخه Auto-Remediation انجام نمیدهد.
Permissionها در محیط Production باید بسیار دقیق کنترل شوند.
Alert Deduplication وجود ندارد.
Incident Correlation وجود ندارد.
هزینه و Latency مربوط به LLM در مقیاس بزرگ باید بررسی شود.
History و Memory برای تشخیص Patternهای تکرارشونده هنوز وجود ندارد.
بنابراین نباید این PoC را با یک سیستم Self-Healing Infrastructure اشتباه گرفت.
برای من جذابترین قسمت پروژه خود AI نبود.
قسمت جالبتر، قرار گرفتن AI در یک مرحلهی واقعی از فرآیند عملیات بود.
قبل از این:
Monitoring
↓
Alert
↓
Engineer
↓
Investigation
↓
Diagnosis
↓
Action
حالا میتوان یک مرحله را تغییر داد:
Monitoring
↓
Alert
↓
AI Investigation
↓
Initial Diagnosis
↓
Engineer
↓
Action
در نگاه اول این تغییر کوچک است.
اما اگر سیستم بتواند بخش قابل توجهی از بررسیهای تکراری را انجام دهد، Engineer میتواند زمان بیشتری را صرف تحلیل Incident و تصمیمگیری کند.
به نظرم استفاده از AI در Infrastructure بهتر است مرحلهبهمرحله انجام شود.
برای مثال:
Observe
↓
Investigate
↓
Analyze
↓
Explain
↓
Recommend
↓
Human Approval
↓
Remediate
در این آزمایش فعلاً فقط تا مرحلهی:
Analyze → Explain → Recommend
پیش رفتیم.
مرحله بعدی میتواند اضافه کردن اطلاعات بیشتر از منابع مختلف باشد:
Metrics
+
Logs
+
Alerts
+
Container State
و بعد بررسی اینکه آیا Agent میتواند با ترکیب این اطلاعات، تحلیل دقیقتری ارائه دهد یا خیر.
در مراحل بعدی حتی میتوان به سمت Controlled Remediation با تأیید انسان رفت.
اما آن دیگر یک آزمایش متفاوت است.
این آزمایش برای من یک نکته ساده اما مهم داشت:
ارزش AI در DevOps لزوماً در انجام تغییرات خودکار نیست.
گاهی ارزش آن در فاصلهی بین:
«سیستم خراب شده»
و
«بفهمیم چرا خراب شده»
قرار میگیرد.
در این PoC، Agent توانست محیط Docker را بررسی کند، Containerهای غیرعادی را پیدا کند، Log آنها را بخواند و بر اساس شواهد موجود یک تحلیل اولیه و پیشنهاد برای ادامه بررسی ارائه دهد.
اما تصمیم نهایی همچنان با Engineer باقی ماند.
شاید مسیر عملیتر استفاده از AI در DevOps هم همین باشد:
نه حذف مهندس؛ بلکه حذف بخشی از کارهای تکراری مهندس.

