
«استپ وان» یکی از پروژه های آزمایشگاه پردازش زبان طبیعی دانشگاه شهید بهشتی تهران است. دو کاربرد اصلی این ابزار، یکی ریشه یابی (استمینگ) واژه ها است و دیگری قطعه بندی (توکنایز کردن) متن ها. هر دو ابزار برای زبان فارسی کار می کنند. با توجه به کمبود ابزار پردازش زبان فارسی، چنین سیستمی که به رایگان قابل استفاده است و API هم دارد، می تواند خیلی مفید باشد.
این ابزار با زبان C# نوشته شده و علاوه بر دو کاربرد اصلی در هر بار فراخوانی، کارهای دیگری هم می کند. در معرفی این ابزار از دو نسخه ی «قبلی» و «جدید» صحبت شده اما API هر دو یکی هستند. در این معرفی هم از فرم خود سایت (نسخه ی جدید) استفاده می کنم و هم از API. برای ارسال و دریافت اطلاعات از و به API از افزونه ی RESTED Client در مرورگر کروم استفاده می کنم.
بخش ریشه یابی این ابزار برای واژه ها کار می کند. برای مثال بیایید ریشه ی «بگیرید» را پیدا کنیم:
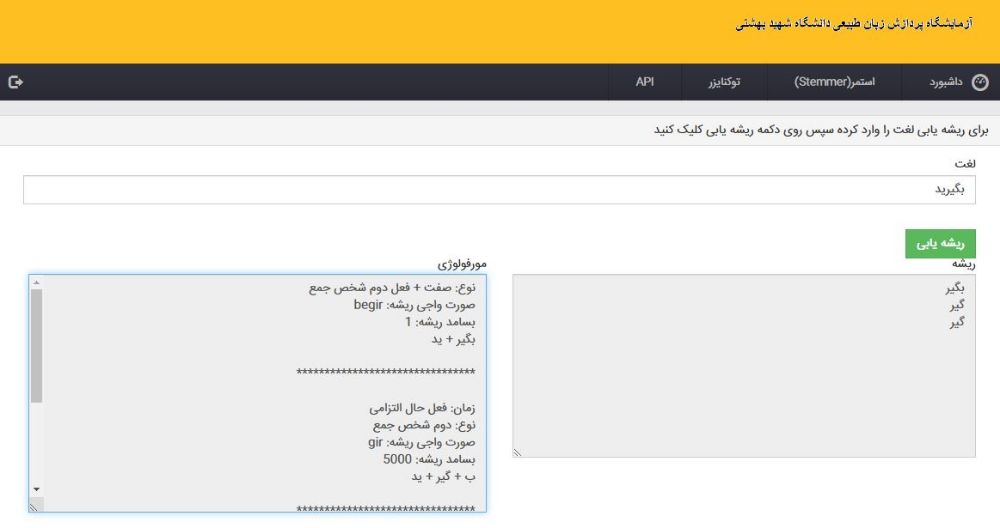
مشخص است که برای این واژه سه حالت پیدا شده است. در یک حالت «بگیر» ریشه تشخیص داده شده و در دو حالت دیگر «گیر». همین کار را با ارسال این واژه به عنوان پارامتر inputString به صورت پست به نشانی http://nlp.sbu.ac.ir:40101/Api/Client/Stem می توان انجام داد.
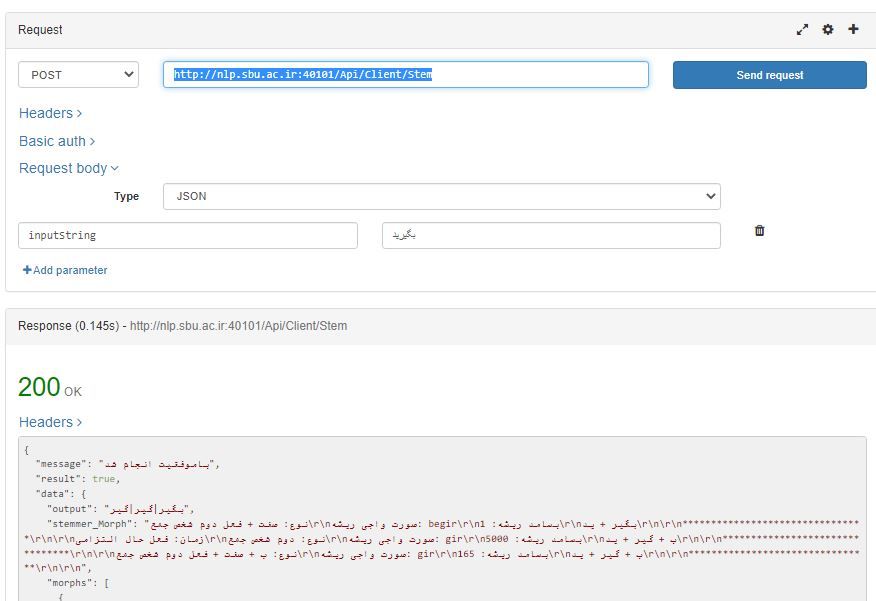
خروجی این تابع به صورت جیسون است و فیلدهای زیادی دارد. به نظر می رسد وبسایت از دو فیلد output و stemmer_Morph استفاده می کند. برای هر حالت پیدا شده، خود واژه، پیشوندها و پسوندها، ریشه، تگ، نوع واژه، زمان دستوری (tense)، بسامد، حالت آوایی (فونتیک)، «داشتن ضمیر مفعولی چسبیده»، «ضمیر مفعولی چسبیده بودن» و شماره برگردانده می شود. در جایی از سایت فهرستی از تگ ها نیافتم و همچنین نمی دانم بسامد هر واژه در چه پیکره ای شمارش شده است. شماره (num) را هم نمی دانم چیست.
{ "message": "باموفقیت انجام شد", "result": true, "data": { "output": "بگیر|گیر|گیر", "stemmer_Morph": "نوع: صفت + فعل دوم شخص جمع\r\nصورت واجی ریشه: begir\r\nبسامد ریشه:1\r\nبگیر + ید\r\n\r\n********************************\r\n\r\nزمان: فعل حال التزامی\r\nنوع: دوم شخص جمع\r\nصورت واجی ریشه: gir\r\nبسامد ریشه: 5000\r\nب + گیر + ید\r\n\r\n********************************\r\n\r\nنوع: ب + صفت + فعل دوم شخص جمع\r\nصورت واجی ریشه: gir\r\nبسامد ریشه: 165\r\nب + گیر + ید\r\n\r\n********************************\r\n\r\n", "morphs": [ { "word": "بگیرید", "prefixs": [], "postfixs": [ "ید" ], "stem": "بگیر", "tag": "A0", "kind": "صفت + فعل دوم شخص جمع", "tense": "", "frequency": 1, "phonetic": "begir", "hasZamir_mafooli_chasbide": false, "zamir_mafooli_chasbide": "", "num": 0 }, { "word": "بگیرید", "prefixs": [ "ب" ], "postfixs": [ "ید" ], "stem": "گیر", "tag": "V1", "kind": "دوم شخص جمع", "tense": "فعل حال التزامی", "frequency": 5000, "phonetic": "gir", "hasZamir_mafooli_chasbide": false, "zamir_mafooli_chasbide": "", "num": 0 }, { "word": "بگیرید", "prefixs": [ "ب" ], "postfixs": [ "ید" ], "stem": "گیر", "tag": "A0", "kind": "ب + صفت + فعل دوم شخص جمع", "tense": "", "frequency": 165, "phonetic": "gir", "hasZamir_mafooli_chasbide": false, "zamir_mafooli_chasbide": "", "num": 0 } ] } }
من واژه های دیگری را هم تست کردم. خیلی از واژه ها به خوبی ریشه یابی شدند. مثلن در جدانویسی «می» در بعضی افعال (استفاده نکردن از نیم فاصله). که در بعضی موارد، ابزار درست عمل نکرد. مثلن:
در بخش قطعه بندی استپ وان می توان یک متن فارسی را توکنایز کرد. من از یک جمله ی ساده («متغیرها از نظر مقیاس هم با هم متفاوتند.») استفاده کردم.
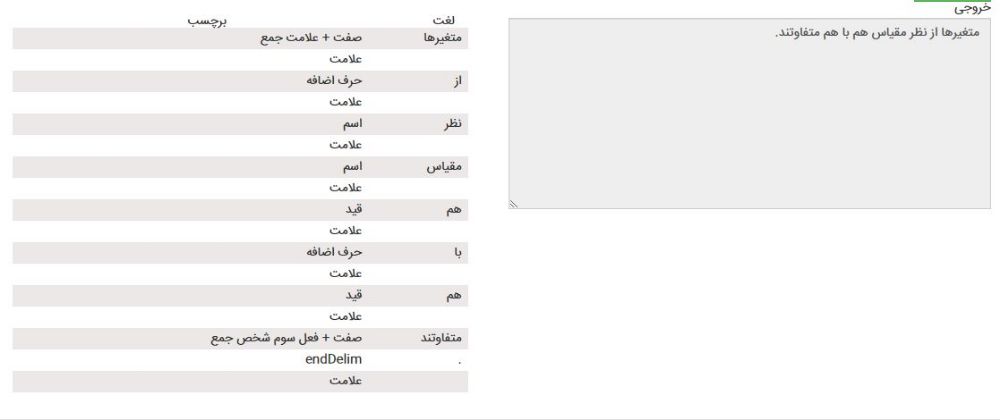
با ارسال این جمله به API با نتیجه ای مشابه زیر روبرو می شویم (بخشی از نتایج را برای کوتاه شدن حذف کردم):
{
  "message": "باموفقیت انجام شد",
  "result": true,
  "data": {
    "inputString": "متغیرها از نظر مقیاس هم با هم متفاوتند.",
    "tokenOutput": "متغیرها از نظر مقیاس هم با هم متفاوتند. ",
    "taggedSubstrings": [
      {
        "kind": "صفت + علامت جمع",
        "prefixs": [],
        "postfixs": [
          "ها"
        ],
        "word": "متغیرها",
        "frequency": 45,
        "phonetic": "motaqayyer",
        "num": 0,
        "stem": "متغیر",
        "tag": "A0",
        "tense": "",
        "zamirMafoliChasbide": ""
      },
      {
        "kind": "قید",
        "prefixs": [],
        "postfixs": [],
        "word": "هم",
        "frequency": 7500,
        "phonetic": "ham",
        "num": 0,
        "stem": "هم",
        "tag": "Ad",
        "tense": "",
        "zamirMafoliChasbide": ""
      },
      {
        "kind": "حرف اضافه",
        "prefixs": [],
        "postfixs": [],
        "word": "با",
        "frequency": 87825,
        "phonetic": "bA",
        "num": 0,
        "stem": "با",
        "tag": "Pr",
        "tense": "",
        "zamirMafoliChasbide": ""
      },
      {
        "kind": "صفت + فعل سوم شخص جمع",
        "prefixs": [],
        "postfixs": [
          "ند"
        ],
        "word": "متفاوتند",
        "frequency": 270,
        "phonetic": "motafAvet",
        "num": 0,
        "stem": "متفاوت",
        "tag": "A0",
        "tense": "",
        "zamirMafoliChasbide": ""
      },
      {
        "kind": "علامت",
        "prefixs": [],
        "postfixs": [],
        "word": " ",
        "frequency": 0,
        "phonetic": "",
        "num": 0,
        "stem": "",
        "tag": "Si",
        "tense": "",
        "zamirMafoliChasbide": ""
      }
    ],
    "sentences": [
      "متغیرها از نظر مقیاس هم با هم متفاوتند.",
      " "
    ],
    "words": [
      "متغیرها",
      " ",
      "از",
      " ",
      "نظر",
      " ",
      "مقیاس",
      " ",
      "هم",
      " ",
      "با",
      " ",
      "هم",
      " ",
      "متفاوتند",
      ".",
      " "
    ]
  }
}
در این جا هم فیلدهای زیادی برگردانده می شوند. فرق inputString و tokenOutput را متوجه نشدم (مشابه بودند). فیلدهای موجود برای هر واژه هم تقریبن مشابه بخش ریشه یابی هستند. نکته ی جالب این است که همه ی فاصله ها هم برچسب می خورند که باعث طولانی شدن نتایج شده است. همچنین به نظر نمی آید محدودیتی از نظر تعداد کاراکتر ارسالی وجود داشته باشد. من یک متن طولانی را در سایت وارد کردم و مشکلی پیش نیامد (به جز زمان طولانی پاسخ گویی).
در این نوشته دو بخش اصلی ابزار استپ وان را که یک ابزار رایگان برای پردازش متون فارسی است بررسی کردیم: ریشه یابیو قطعه بندی. این ابزار برای توسعه ی ابزارهای مرتبط با پردازش زبان فارسی و پیکره های زبانی می تواند بسیار مفید باشد.

